Flux 3 X Mimic: 차세대 비디오-액션 모델
요약
FLUX 3는 이미지, 비디오, 오디오를 통합적으로 학습한 멀티모달 파운데이션 모델입니다. 이 모델은 특히 로봇 제어에 활용되는 '비디오-액션' 예측 능력을 갖추고 있으며, 이는 단순 콘텐츠 생성을 넘어 세상의 물리적 작동 원리를 이해하는 수준에 도달했음을 의미합니다. FLUX 3는 mimic robotics과의 협업을 통해 실제 로봇 구동 환경에서 테스트 및 배포되고 있습니다.
핵심 포인트
- FLUX 3는 이미지-비디오-오디오를 공동 학습한 멀티모달 모델입니다.
- 로봇 제어에 필요한 '액션' 예측 능력을 통합했습니다.
- 모델은 접촉, 움직임, 인과관계 등 물리적 원리를 이해합니다.
- 초기에는 성능 하락이 있었으나 3500 스텝 후 완전한 품질을 회복했습니다.
당사의 새로운 멀티모달 파운데이션 모델인 FLUX 3의 초기 버전이 이제 로봇에서 구동되고 있습니다. 저희는 mimic robotics에 FLUX.3를 조기에 제공했습니다. 로봇 학습 및 배포 분야에서의 mimic의 강점과, 이 모델의 세계 지식, 그리고 BFL의 파운데이션 모델 전문성이 결합하여 FLUX-mimic을 탄생시켰습니다. 이는 차세대 비디오-액션 모델입니다.
FLUX
FLUX 1과 FLUX 2는 이미지를 생성합니다. FLUX 3는 멀티모달리티로 확장되어 오디오-비주얼 콘텐츠를 공동으로 생성하며, 동시에 FLUX-mimic의 기반을 제공합니다. 이는 mimic과의 협력을 통해 개발되었으며, Audi에서 테스트 및 배포된 로봇을 구동하는 비디오-액션 모델입니다.
언뜻 보기에는 설득력 있는 시각적 콘텐츠를 생성하는 것과 로봇을 제어하는 것이 공통점이 없어 보입니다. 전자는 픽셀 생성을 요구하고, 후자는 물리적 세계가 만지고 조작할 때 어떻게 반응하는지에 대한 이해를 요구합니다. 만약 하나의 모델이 이 두 가지를 모두 수행한다면, 그것은 결코 단순히 콘텐츠 생성 모델만은 아닙니다. 그것은 세상이 어떻게 작동하는지에 대한 모델이며, 콘텐츠 생성은 그중 하나일 뿐입니다.
그것이 바로 FLUX 3가 하는 일입니다.
비디오가 가장 어려운 부분입니다
FLUX 3는 이미지, 비디오, 오디오를 아우르는 하나의 모델로 처음부터 공동 학습되었습니다. 이 학습 과정 중 가장 까다로운 부분이 바로 비디오 예측이며, 이는 전체 컴퓨팅 비용의 95% 이상을 차지합니다. 현실적인 비디오를 생성하려면, 모델은 접촉(contact), 움직임(motion), 무게(weight), 인과관계(cause and effect)를 반드시 학습해야 합니다. 이 중 어느 하나라도 잘못되면 결과가 부자연스럽게 보입니다. 세상을 정확하게 렌더링하는 법을 배우는 것은 곧 세상이 어떻게 작동하는지를 배우는 것을 의미합니다.
상대적으로 오디오는 쉬운 모달리티입니다. 비디오보다 차원이 낮고 디테일도 훨씬 적어, 오디오가 포함된 720p 비디오에서 토큰의 0.5% 미만을 차지합니다. 모델이 비디오 이해라는 어려운 작업을 마쳤다면, 비디오와 오디오 사이의 인과관계를 학습하여 입술 움직임에 동기화된 음성 예측과, 그것을 유발하는 물리적 사건에 동기화된 오디오 효과를 예측할 수 있게 됩니다.
액션(Actions)도 같은 형태를 따릅니다: 로봇의 상태에 대한 저차원 표현이며, 시각적 관찰과 긴밀하게 결합되어 있습니다. 액션, 오디오 및 비디오 프레임은 모두 단일한 근본적인 물리적 현실의 부분적인 표현입니다. 모델이 비디오와 오디오 뒤에 숨겨진 물리적 과정을 학습한 후, 액션 예측은 새로운 변화가 아닙니다. 그것은 이미 모델링하고 있는 현실의 또 다른 관점일 뿐입니다.
단일 백본(A single backbone)
만약 이러한 틀이 정확하다면, FLUX 3에게 액션을 예측하도록 가르치는 것이 지속적인 비용을 발생시키지 않아야 합니다. 모델이 액션 공간의 구조를 학습하고 세상에 대한 내부 표현을 그것과 정렬하는 과정에서 일시적인 혼란기가 예상되지만, 이후에는 완전한 성능으로 돌아올 것으로 기대합니다. 실제로 우리가 관찰한 것도 바로 그러했습니다.
대규모 훈련(large-scale training run)을 진행하면서 커리큘럼에 액션 예측을 추가했고, 비디오 생성 품질에 미치는 영향을 관찰했습니다. 모델이 새로운 액션 모달리티를 통합하기 시작했을 때, 텍스트-투-비디오 및 이미지-투-비디오의 인간 평가는 최대 10%까지 하락했습니다. 하지만 3500 스텝(steps) 이후, 모델은 비디오 생성 작업에서 이전의 완전한 품질을 회복하는 동시에 액션도 예측할 수 있게 되었습니다.
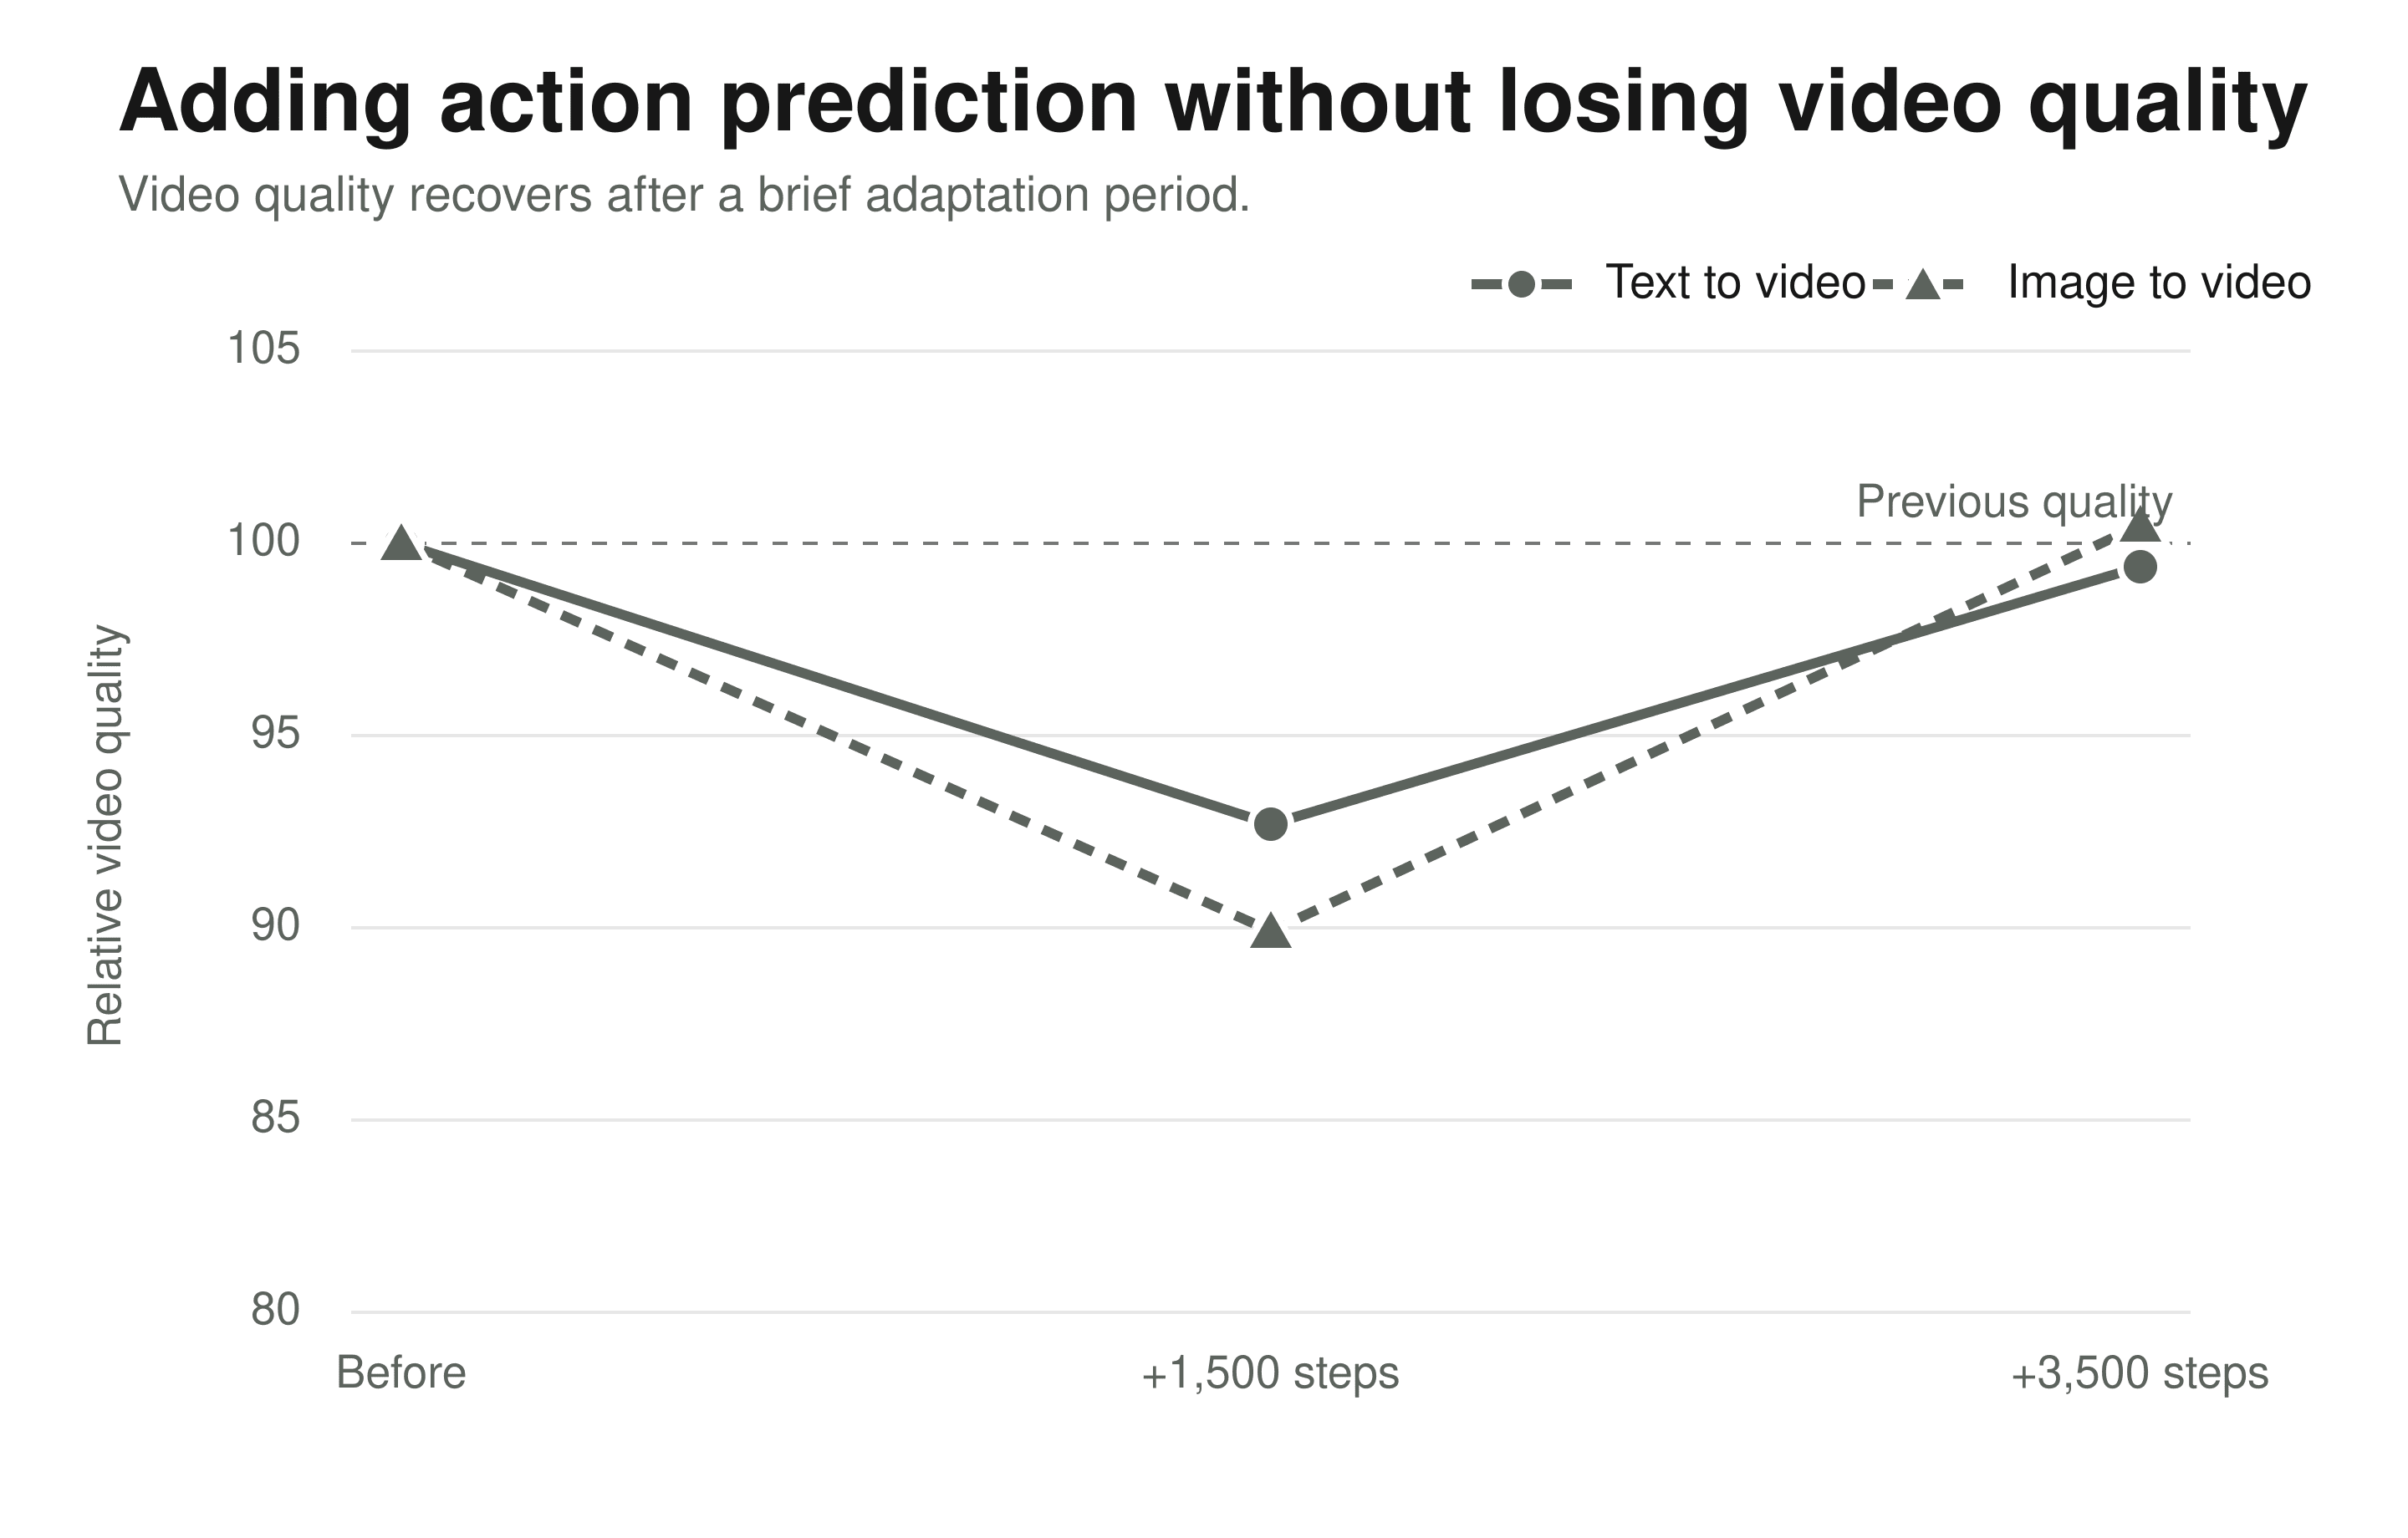
각 시리즈는 액션 예측이 추가되기 전에 자체적인 품질로 정규화되었습니다. 숫자가 높을수록 좋습니다.
모델은 액션을 입력과 출력에 통합해야 했지만, 그렇게 하는 것이 영구적으로 용량을 소모시키지는 않았습니다. 단지 이 새로운 모달리티가 세상에 대한 기존 모델과 어떻게 관련되는지를 학습할 필요가 있었습니다. 이것이 파악되자, 기존 기능에 대한 성능 페널티는 사라졌습니다. 비디오 생성과 액션 예측은 별도의 기반을 필요로 하지 않습니다. 동일한 백본이 둘 다를 담당합니다.
이는 Physical AI가 방향 전환이 아니라 Black Forest Labs의 로드맵에서 자연스러운 확장임을 의미합니다. 콘텐츠 생성은 우리의 멀티모달 FLUX 3 백본(backbone)이 이미지, 비디오, 오디오로 수행하는 작업입니다. Physical AI는 그것을 액션에 적용한 것입니다. 시각 지능을 핵심으로 하는 하나의 파운데이션 모델(foundation model)이 두 가지 애플리케이션 계열을 가능하게 합니다. 우리는 별도의 파운데이션 모델을 구축하지 않았습니다. 우리는 어려운 문제, 즉 세상을 이해하는 모델을 만드는 데 집중했습니다. 그 안에서 행동한다는 것이 바로 그 이해를 가능하게 하는 것입니다.
실험실에서 현실로: FLUX-mimic
FLUX 3 백본을 실제 생산 라인의 자동화 작업에 적용하면 어떤 일이 벌어질까요?
이것이 mimic과 BFL이 FLUX-mimic을 만들어 답하고자 한 질문입니다. mimic은 자체 로봇을 구축하고 로봇 학습, 정교한 조작(dexterous manipulation), 생산 배포 분야의 전문 지식을 가져옵니다. BFL은 시각 파운데이션 모델을 구축하며 멀티모달 훈련 및 모델링 전문 지식을 제공합니다. 우리는 함께 일반 목적 조작을 위한 차세대 모델을 만들었으며, 이는 산업 요구 사항에 맞춰 조정되었고 mimic의 풀스택(full-stack) 배포 시스템에 통합되었습니다. FLUX-mimic은 FLUX 3 백본을 기반으로 구축된 비디오-액션 모델입니다.
학습된 세계 모델 디코딩하기
우리의 가설은 FLUX 3이 비디오를 생성하려면 세상의 내부 표현(internal representation)을 학습해야 한다는 것입니다. FLUX-mimic은 이 가설을 따라가며, FLUX 백본의 학습된 세계 표현으로부터 액션을 디코드합니다. mimic-video에서 개척된 이 접근 방식은 FLUX의 비디오 예측 경로에서 추출된 중간 특징 위에 경량 액션 디코더(action decoder)를 훈련시킵니다.
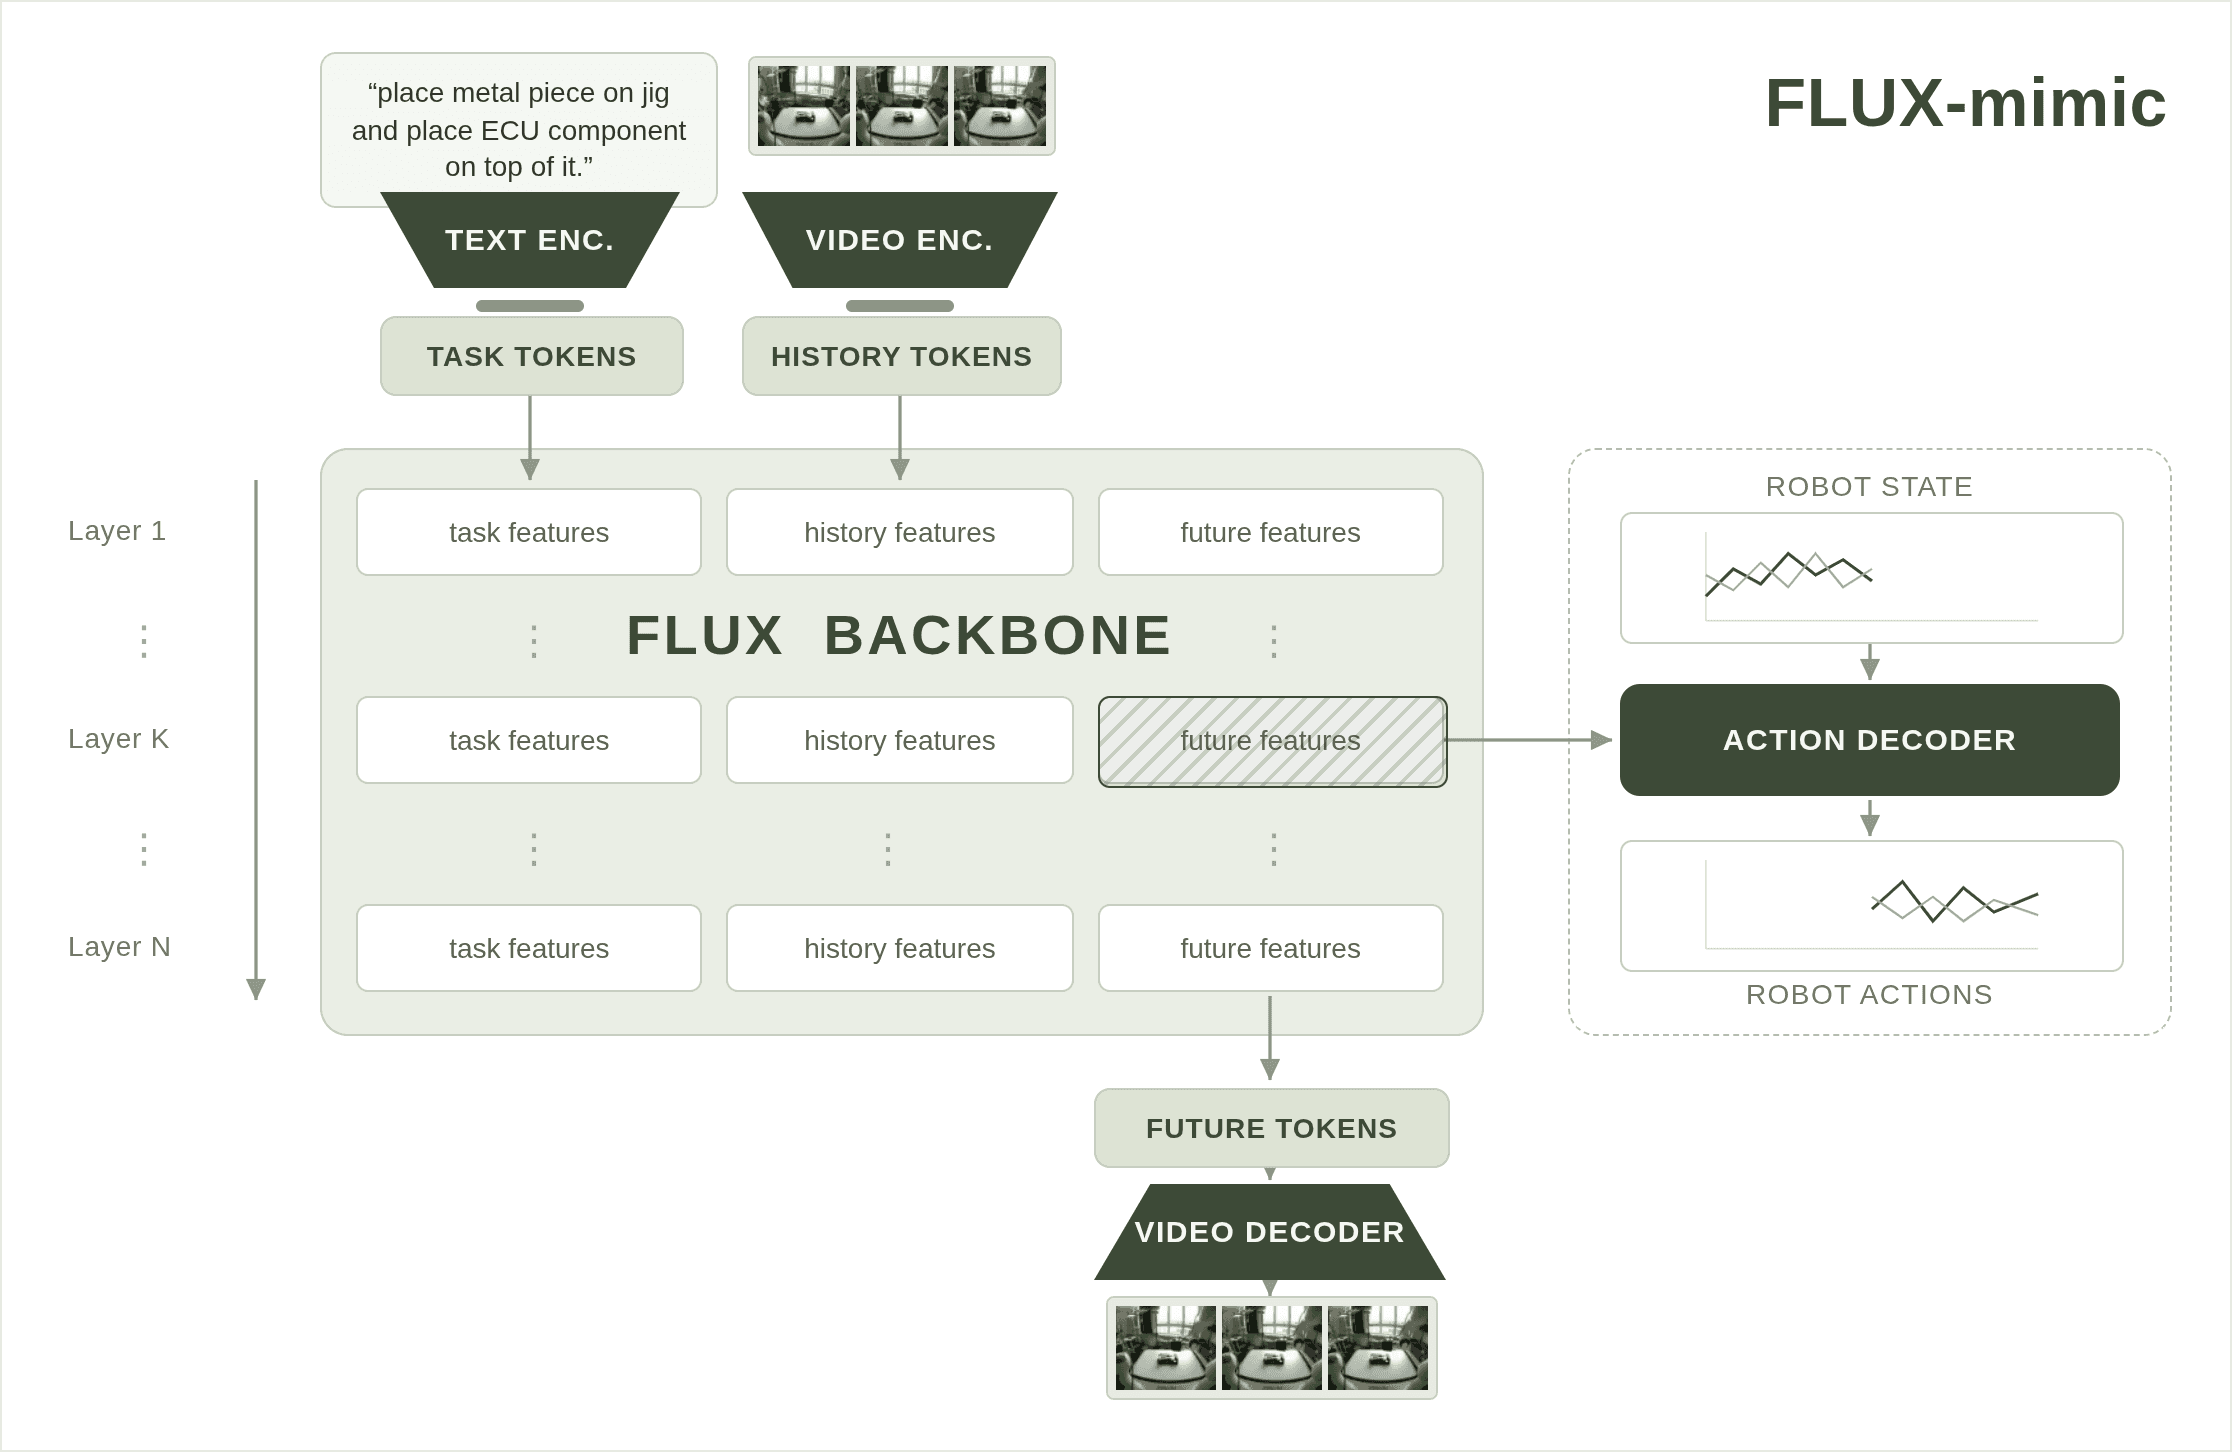
FLUX-mimic이 FLUX 3 위에 구축되는 아키텍처 개요
이 접근 방식의 성공은 두 가지 관련되지만 다른 측면에 달려 있습니다. 바로 FLUX가 학습한 월드 모델(world model)의 품질과 이 월드 모델의 특징 표현(feature representation)의 품질입니다. 월드 모델의 품질은 생성 품질과 직접적으로 관련됩니다. 즉, 모델이 세상이 어떻게 작동하는지 이해하지 못하면 시뮬레이션할 수 없습니다. 하지만 아무리 좋은 월드 모델이라도 접근할 수 없다면 액션 디코더(action decoder)에게는 도움이 되지 않습니다. 만약 특징 공간(feature space)이 모달리티 간의 인과 관계를 비선형적으로 얽히게 유지한다면, 그 관계들을 특징 표현으로부터 이해하는 것은 원시 입력(raw inputs)으로부터 이해하는 것만큼 어렵습니다. 따라서 표현 품질(representation quality)이 중요합니다.
생성 품질과 표현 품질은 오랫동안 서로 분리되어 연구되고 접근해 왔습니다. 생성적 접근 방식은 시뮬레이션을 가능하게 하는 고품질의 월드 모델을 산출하며, 컴퓨팅 투자에 대한 예측 가능한 수익률을 보이는 스케일링 법칙(scaling laws)을 나타냅니다. 하지만 표현 학습을 위한 보다 전문화된 접근 방식과 비교했을 때, 이들은 덜 분리된(disentangled) 표현을 생성하여 세상 이해를 필요로 하는 작업에서의 유용성에 한계를 만듭니다.
생성 모델 자체가 자체적인 특징에 의존하기 때문에, 이러한 표현 품질의 차이는 직관에 반하는 것처럼 보입니다. 생성 모델 내에서 개선된 표현은 월드 모델의 품질을 향상시키고 다운스트림(downstream) 작업에 더 유용하게 만들어야 합니다. 저희의 연구인 Self-Flow에서는 생성 학습과 표현 학습을 단일 프레임워크로 통합하는 방법을 시연했으며, 정확히 이러한 상호 보완적인 개선을 관찰했습니다. 즉, 월드 모델은 비디오, 이미지, 오디오 전반에 걸친 생성 품질로 측정되어 향상되었고, 그 특징 표현의 품질 또한 시뮬레이션 환경에서의 로봇 제어 작업 성공률로 측정되어 향상되었습니다.
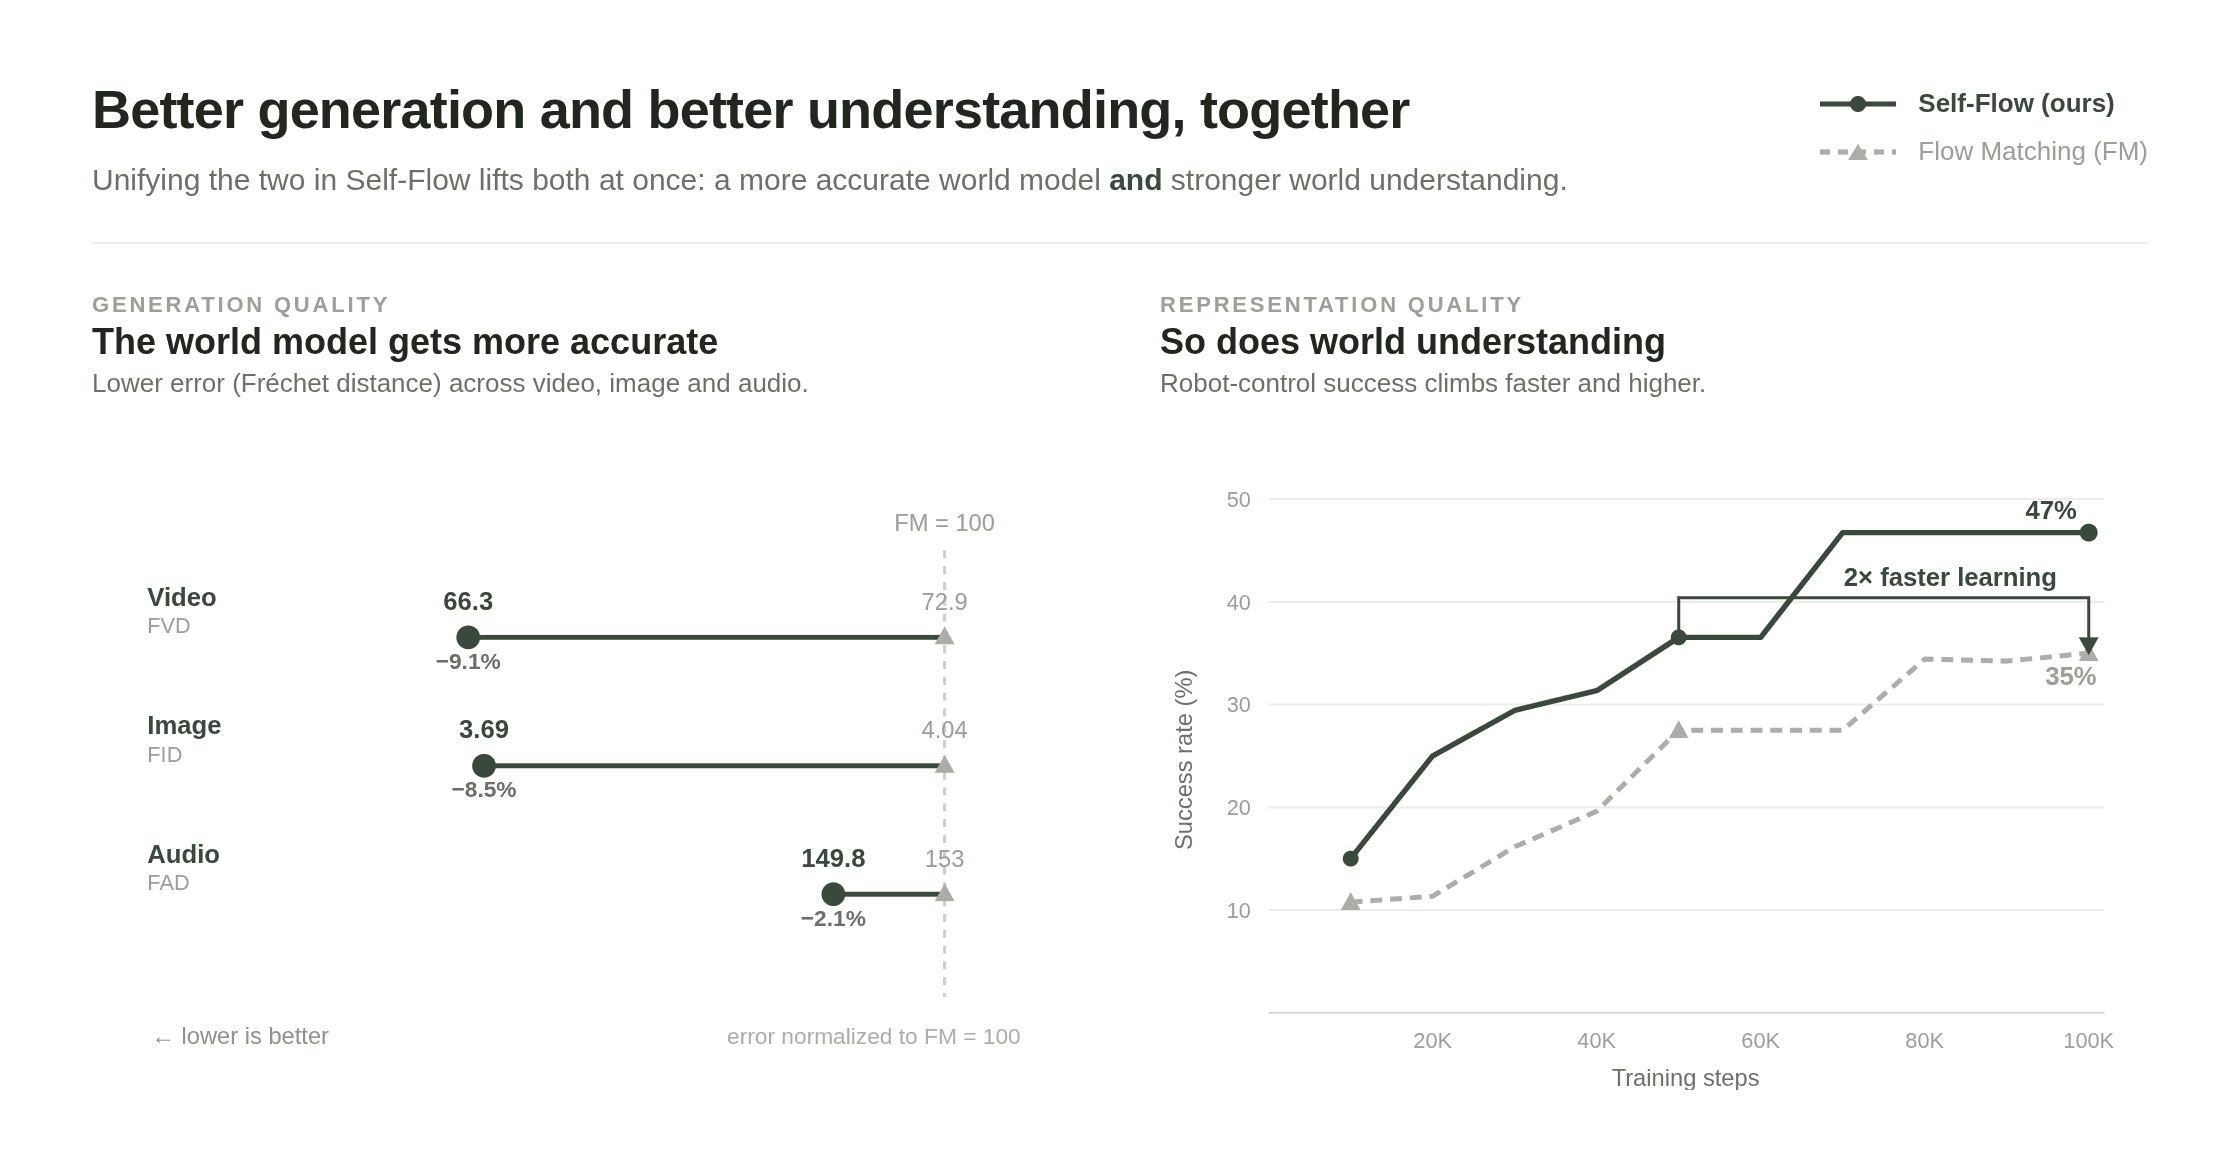
Self-Flow 대 Flow Matching (FM). 왼쪽: 모달리티별 생성 오류(Fréchet distance)를 나타내며, 각각 FM=100으로 정규화되었습니다 (낮을수록 좋음). 오른쪽: 파인튜닝을 거쳐 네 가지 작업 그룹에 걸친 조작 작업의 성공률 평균을 보여줍니다 (높을수록 좋음).
세계 모델 확장(Scaling the world model)
확장 법칙(Scaling laws)은 Self-Flow에서도 여전히 유효하며, FLUX 3는 그 적용 사례입니다. 즉, Self-Flow를 대규모로 확장한 버전입니다. 이 모델은 수천만 시간의 일반 비디오 콘텐츠에서 학습하여 처음부터 가능한 한 광범위하게 세계 역학(world dynamics)을 배우도록 훈련되었으며, 또한 인간 및 로봇 조작 작업에 초점을 맞춘 수십만 시간의 비디오 콘텐츠를 통해 시각 지능을 위한 백본(backbone) 역할을 할 준비를 마쳤습니다. 이러한 확장이 Self-Flow가 실험실에서의 성공을 현실로 전환하는 원동력입니다. mimic은 FLUX-mimic을 실제 공장 사용 사례에 배치하여, 구조화된 트레이에 부품 키팅하기, 좁게 맞는 고정 장치에 전자 제어 장치를 삽입하기, 구성 요소를 조립하기, 그리고 기존 자동화가 다룰 수 없었던 실링(seals)이나 케이블 같은 부드럽고 유연한 재료를 처리하는 일상적인 생산 및 물류 작업 전반을 아우릅니다.
벤치마크는 액션 디코더가 완전히 고정된 FLUX 백본만 사용하더라도 이전의 비전-언어-액션 모델보다 성능이 우수함을 입증합니다. 이는 이전의 비전-언어-액션 모델들이 성공하지 못했던 설정입니다. 이 결과는 확장이 우리에게 세계에 대한 강력한 지식과 그 안에서 행동하는 방법을 제공하며, Self-Flow가 이 지식을 백본의 특징 표현(feature representations)으로부터 쉽게 디코딩할 수 있게 만든다는 것을 강조합니다. 백본과 액션 디코더를 함께 파인튜닝했을 때, FLUX-mimic은 최첨단 성공률을 달성합니다.
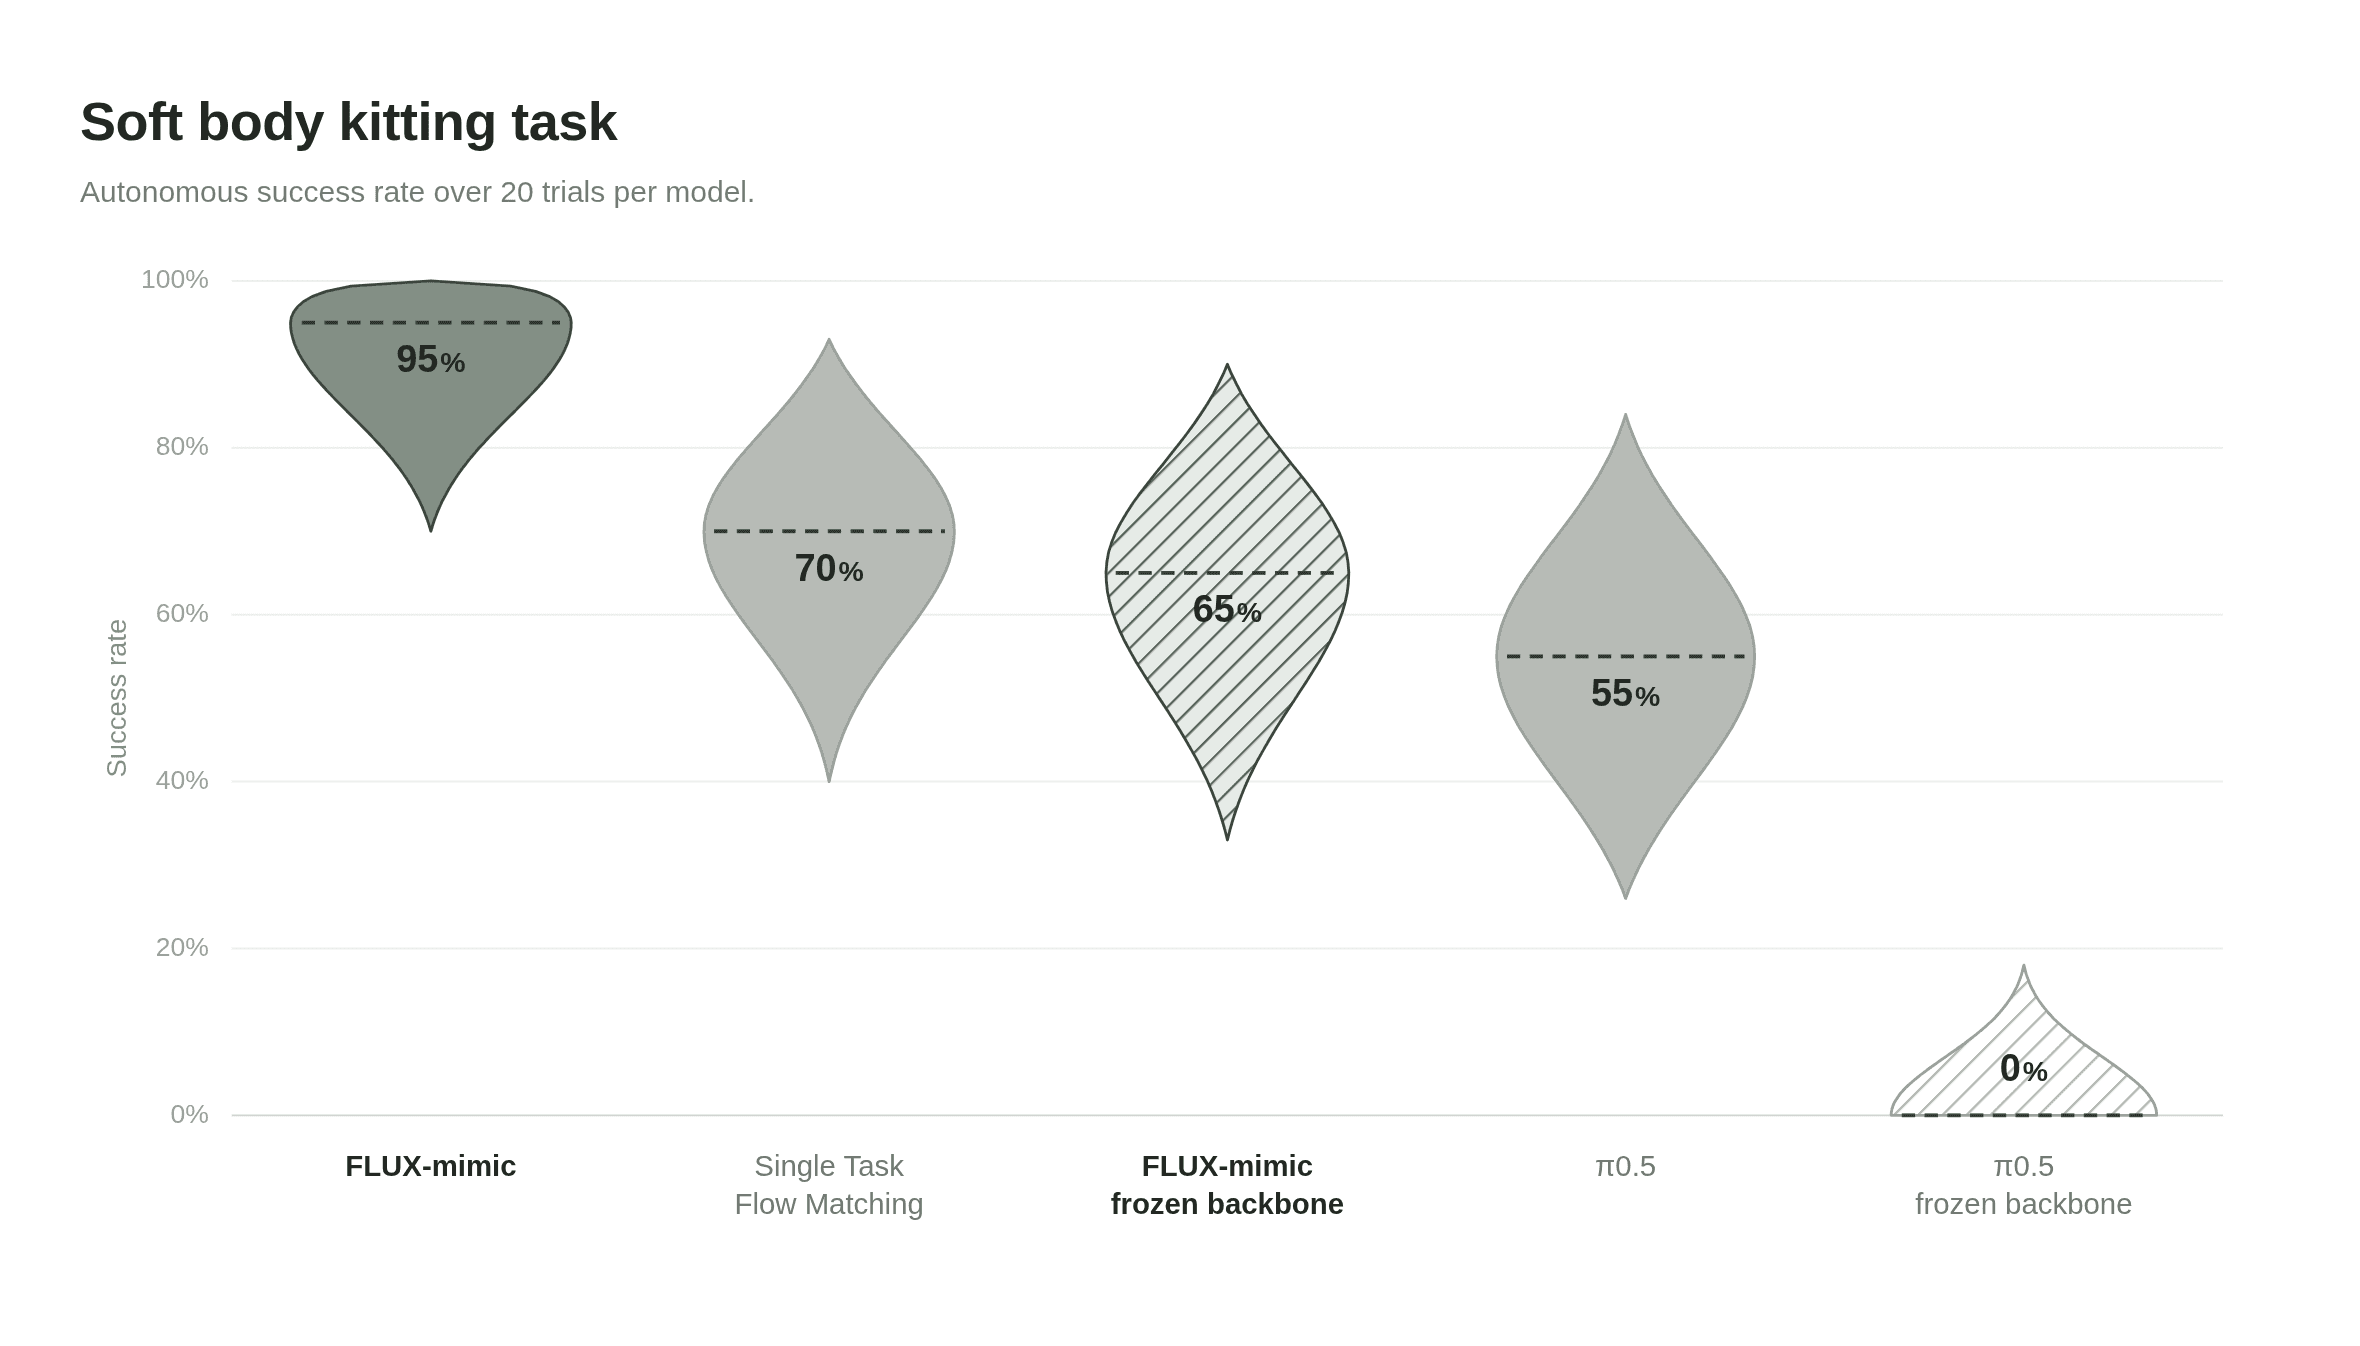
점선은 20회의 자율 테스트에 걸친 각 모델의 중앙값 성공률을 표시합니다. 높을수록 좋습니다.
세계 지식에서 작동하는 작업으로(From world knowledge to a working task)
세계 지식을 디코딩 가능한 표현으로 노출하는 백본(backbone)은 로봇에게 새로운 작업을 가르치는 데 필요한 것을 변화시킵니다. 물리 법칙이 이미 표현 안에 있고 쉽게 접근 가능하다면, 작업에 적응하는 것은 더 이상 모델에게 세상이 어떻게 작동하는지 가르치는 문제가 아닙니다. 단지 이 특정 작업이 모델이 이미 알고 있는 것과 어떻게 매핑되는지만 학습하면 됩니다. 비용이 많이 드는 부분은 로봇이 움직이기 전 이미 완료됩니다.
이는 새로운 작업에 얼마나 많은 시연 데이터(demonstration data)가 필요한지에 직접적으로 나타납니다. 저희의 Self-Flow 실험에서, 액션 예측(action prediction)은 Self-Flow가 없는 비디오 모델과 비교했을 때 절반의 학습 단계 만에 주어진 성공률에 도달했습니다. 더 나은 표현(representation)들이 세상 지식을 추출하기 쉽게 만들어주기 때문에, 동일한 역량에 도달하는 데 필요한 데이터가 적습니다. mimic-video 논문에서는 비전-언어-액션 모델 대비 비디오-액션 모델에서 최대 10배의 샘플 효율성(sample efficiency)을 보고했습니다. FLUX-mimic은 이 두 가지 효과를 결합합니다.
이러한 이점은 행동에서도 나타납니다. FLUX-mimic은 실패로부터 자연스럽게 회복합니다: 물건 잡기를 놓친 로봇이 스스로 교정하고, 다시 잡아 작업을 완료합니다. 어떤 시연 세트도 작업이 잘못될 수 있는 모든 가능한 경우를 다 담을 수는 없습니다. 한 번도 시연되지 않은 복구(recovery)는 다른 곳에서 와야 합니다. 즉, 세상이 어떻게 작동하는지 이미 알고 있는 모델로부터 오는 것입니다.
백본이 예측한 미래(상단), 디코딩된 액션으로부터 로봇이 생성한 롤아웃(rollout)(하단).
행동하기에 충분히 빠름
실제 배포는 엄격한 제약 조건을 설정합니다: 모델은 세상이 움직이는 속도만큼 빠르게 행동해야 합니다. FLUX-mimic의 지배적인 컴퓨팅 비용(compute cost)은 백본에 있습니다. 이것이 모델의 가장 큰 구성 요소이며, mimic의 최적화된 배포 스택에서는 그 레이턴시가 시스템 전체의 상한선을 효과적으로 결정합니다.
이것이 바로 우리의 방법론이 두 번째로 빛을 발하는 지점입니다. 더 나은 표현(representations)은 매개변수당 더 많은 능력을 의미합니다. 잘 구조화된 세계 모델(world model)을 학습한 모델은 그렇지 않은 모델보다 주어진 성능 수준에 도달하기 위해 적은 용량(capacity)이 필요합니다. 배포 측면에서 이는 작게 백본(backbone)을 구동할 수 있다는 것으로 직접 연결되며, 작은 백본은 더 빠른 백본을 의미합니다.
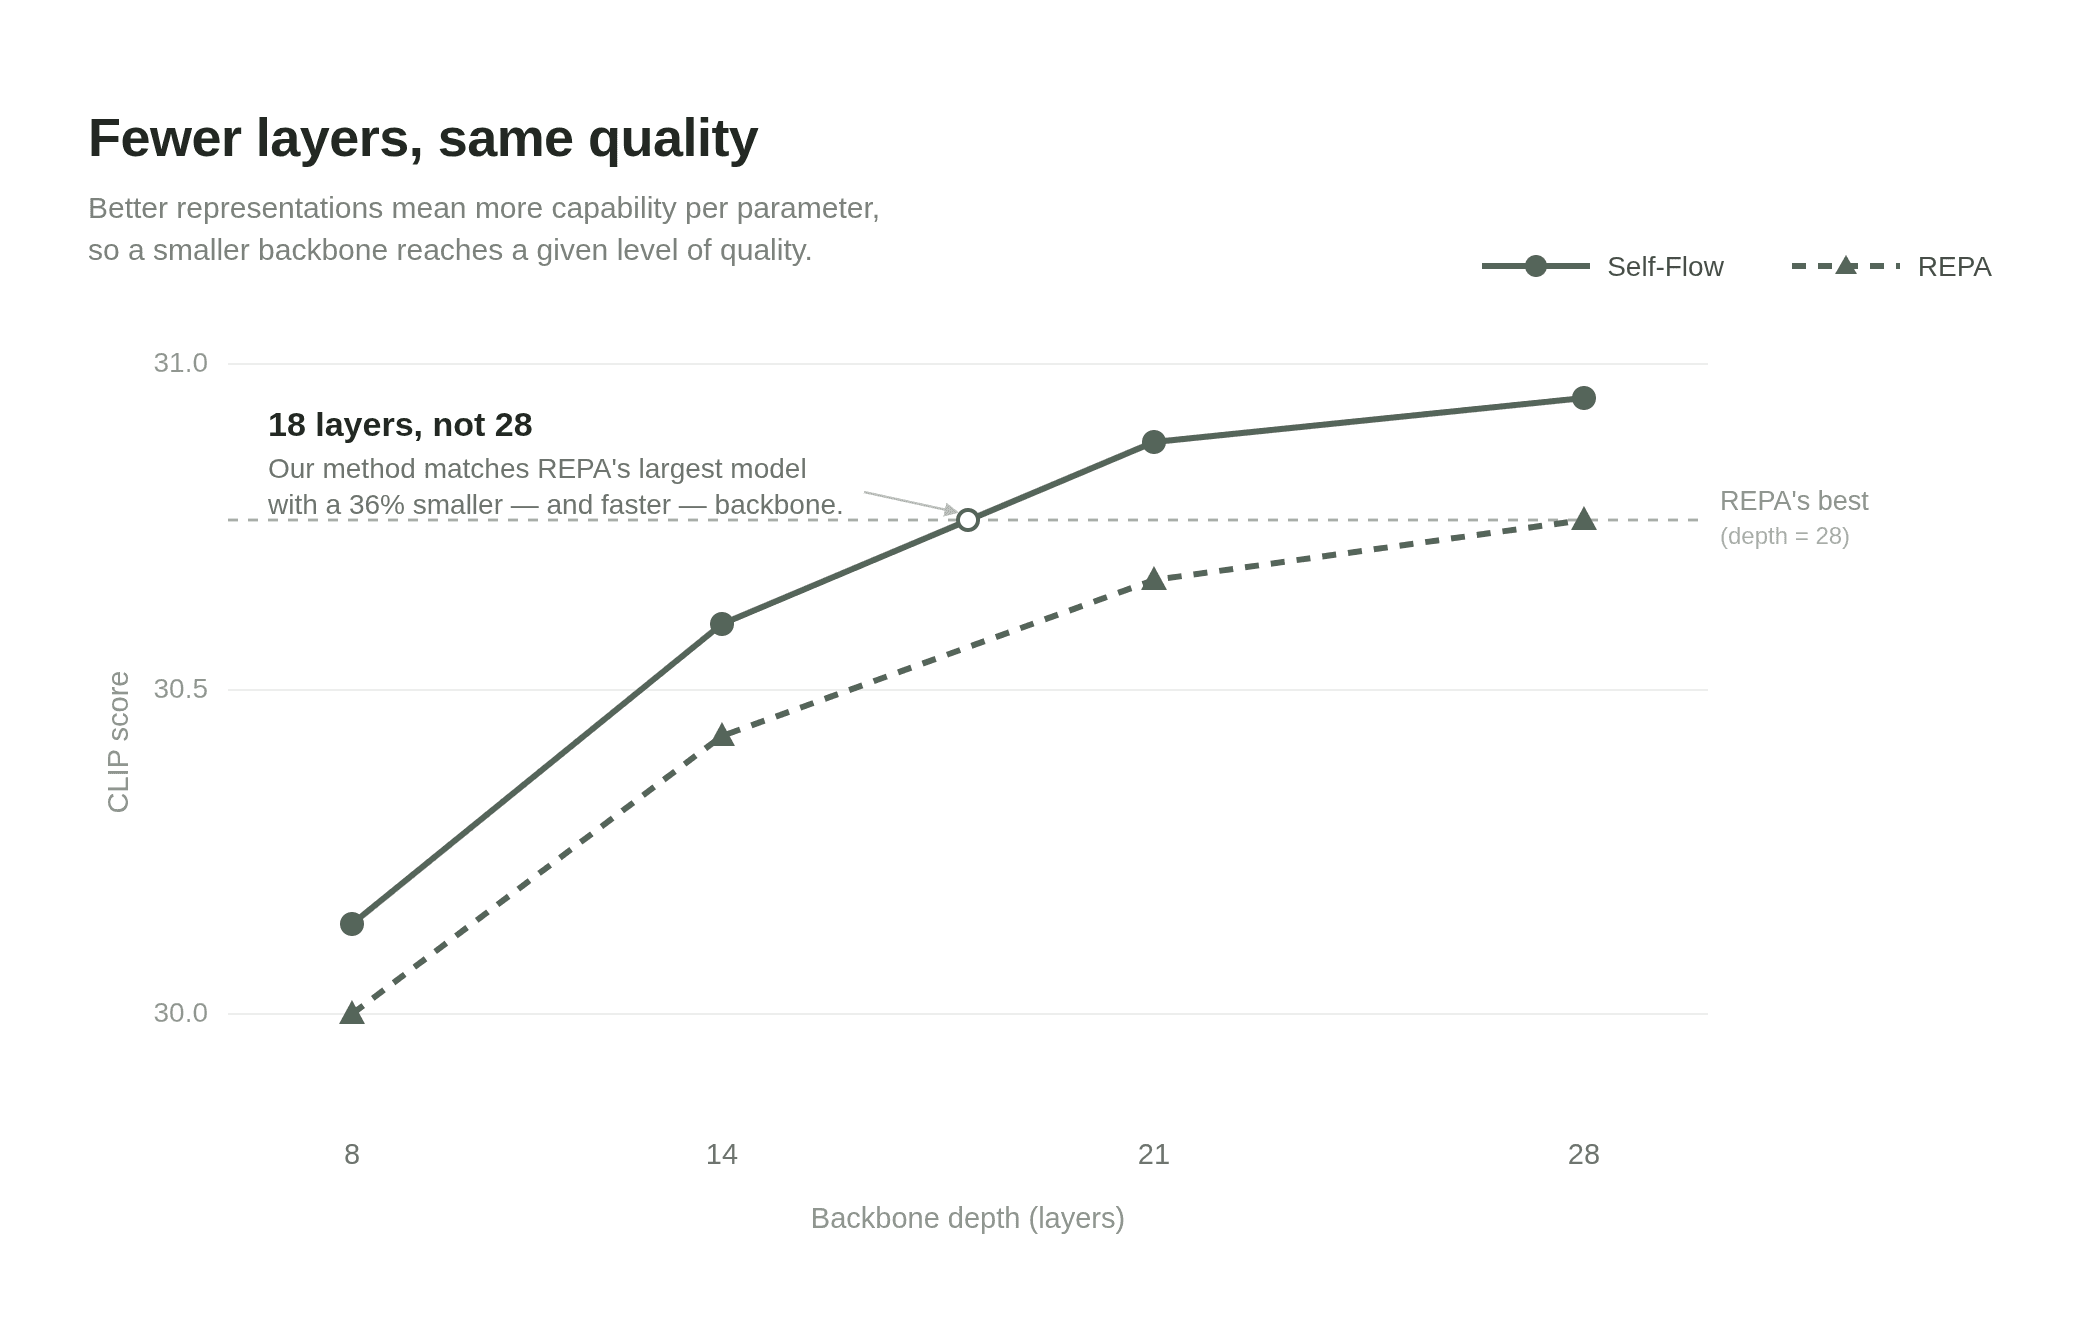
100만 학습 단계에서의 CLIP 점수; 높을수록 좋습니다. 백본의 깊이(depth)가 배포 지연 시간(latency)의 주된 결정 요인이므로, 레이어가 적을수록 더 빠른 모델입니다.
결과적으로, FLUX-mimic의 백본은 단일 NVIDIA RTX 5090 GPU에서 입력부터 세계 표현까지 80ms 미만으로 구동되도록 최적화될 수 있습니다. 이는 인간의 시각 반응 시간과 비슷한 수준에 놓이는 것입니다.
AI 자동 생성 콘텐츠
본 콘텐츠는 HN Design Systems의 원문을 AI가 자동으로 요약·번역·분석한 것입니다. 원 저작권은 원저작자에게 있으며, 정확한 내용은 반드시 원문을 확인해 주세요.
원문 바로가기