FlagPerf란 무엇인가
요약
FlagPerf는 지위안 연구원(智源研究院)이 AI 하드웨어 제조사들과 공동 개발한 통합 AI 하드웨어 평가 엔진입니다. 이 엔진은 단순 소요 시간 측정을 넘어, 성능, 자원 사용, 생태계 적응력 등 다차원적인 지표로 AI 하드웨어를 종합적으로 평가합니다. PyTorch, TensorFlow 외에도 PaddlePaddle, MindSpore 등 다양한 프레임워크와 NVIDIA TensorRT 같은 추론 엔진을 지원하며, 단일 카드부터 다중 머신까지 포괄하는 테스트 환경을 제공합니다.
핵심 포인트
- 단순 속도 측정 아닌 다차원적 성능 지표를 평가
- 30개 이상의 모델과 80개 이상의 학습 샘플 포함
- PyTorch, TensorFlow 외 PaddlePaddle, MindSpore 등 다양한 프레임워크 지원
- 단일 카드부터 다중 머신까지 포괄적인 테스트 환경 제공
FlagPerf란 무엇인가

FlagPerf는 지위안 연구원(智源研究院)이 AI 하드웨어 제조사들과 공동으로 구축한 통합 AI 하드웨어 평가 엔진입니다. 이는 산업 실습을 기반으로 한 지표 체계를 수립하여, 소프트웨어 스택 조합(모델+프레임워크+컴파일러) 하에서 AI 하드웨어가 갖는 실제 능력을 평가하는 것을 목표로 합니다.
📣 FlagPerf 평가 주요 특징
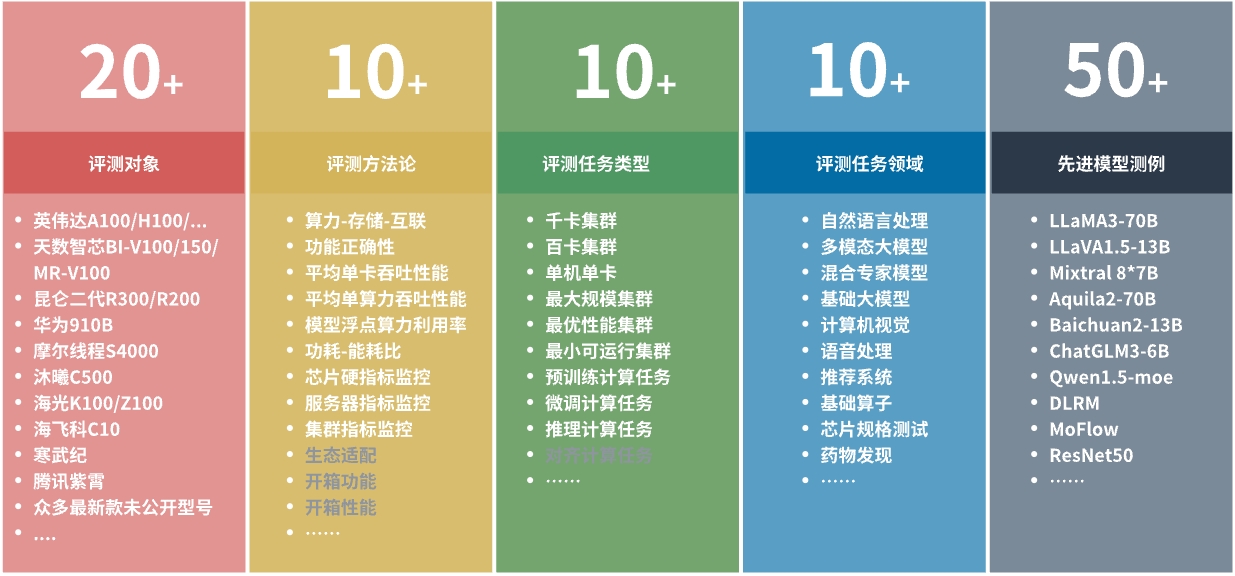
- '소요 시간'에만 집중하지 않는 다차원 평가 지표 체계 구축:
FlagPerf의 지표 체계는 특정 모델 학습을 '칩이 지원할 수 있는지'에 대한 기능적 정확성 지표 외에도, 더 많은 차원의 성능 지표, 자원 사용 지표, 그리고 생태계 적응 능력 지표 등을 포함합니다.
지표 상세 소개는 이 기사를 참고하십시오.
- 다양한 시나리오 및 작업 지원, 대규모 모델 학습 추론 시나리오 포괄:
FlagPerf는 컴퓨터 비전, 자연어 처리(NLP), 음성, 멀티모달 등 분야의 30개 이상의 고전적 모델과 80개 이상의 학습 샘플을 포함하고 있으며, AI 하드웨어의 학습 및 추론 능력을 평가할 뿐만 아니라 대규모 모델 시나리오의 추론 작업까지 평가할 수 있습니다.
- 다양한 학습 프레임워크 및 추론 엔진 지원, AI 하드웨어와 소프트웨어 생태계 유연하게 연결:
학습 작업 시나리오에서는 PyTorch, TensorFlow를 지원하는 것 외에도 FlagPerf는 PaddlePaddle, MindSpore 개발팀과도 긴밀히 협력하고 있습니다. 국내 대표 학습 프레임워크인 Baidu의 Paddle 팀이나 Huawei의 Ascend MindSpore 팀은 Llama, GPT3와 같은 인기 모델들을 FlagPerf 테스트 샘플 세트에 통합하고 있습니다.
추론 작업 시나리오에서는 여러 칩 제조사 및 학습 프레임워크 개발팀의 추론 가속 엔진을 지원하여, AI 하드웨어와 소프트웨어 생태계를 더욱 유연하게 연결하고 평가 범위와 효율성을 확장합니다. 예시로는 NVIDIA TensorRT, Kunlunxin XTCL (XPU Tensor Compilation Library), Tianshu Zhixin IxRT (Iluvatar CoreX RunTime), PyTorch TorchInductor 등이 있습니다.
- 다중 테스트 환경 지원, 단일 카드, 단일 머신, 다중 머신 성능 종합 검토:
국산 AI 칩의 다양성, 확장성, 실제 적용 시뮬레이션 상황을 포괄적으로 평가하기 위해, FlagPerf는 단일 카드(single card), 단일 머신(통상 8카드), 다중 머신 세 가지 테스트 환경을 설정했으며, 각기 다른 테스트 환경에 맞는 테스트 샘플 시나리오와 작업을 매칭했습니다.
참고: 현재 FlagPerf는 테스트 환경 중 칩 외의 다른 조건이 일치한다는 전제 하에, 칩 자체의 오프라인 배치 처리 평가를 수행하며, 클러스터 및 클라이언트 성능 평가는 아직 지원하지 않습니다.
- 참가 코드 엄격 검토, '결과의 공정성'을 넘어 '과정의 공정성'에 주목:
테스트는 지위안 연구원과 다수의 칩 제조사가 공동으로 진행합니다. 기본 원칙은 칩의 범용 성능을 객관적이고 공정하게 평가하는 것이며, 제조사들이 특정 목적에 맞는 맞춤형 최적화를 수행하는 것을 제한합니다. 테스트 모델이 확정된 후, 먼저 칩 제조사가 모델 적응 작업을 수행하며, 이 과정에서는 분산 통신(distributed communication), 배치 데이터 크기(batch size) 등 하드웨어 실행과 강하게 관련된 부분의 코드 수정만 허용됩니다. 다음으로 지위안 연구원은 기준 테스트 플랫폼 FlagPerf를 기반으로 칩 능력을 테스트하고, 테스트 과정이 원활하며 칩 성능과 안정성이 최적으로 발휘되도록 보장합니다. 동시에, 모든 테스트 코드는 오픈 소스로 공개되어 있어 테스트 과정과 데이터가 재현 가능합니다.
🎯 향후 지위안 연구원 및 다수의 AI 하드웨어, 프레임워크 팀들은 클러스터 성능의 전체 평가와 같은 FlagPerf의 평가 시나리오를 공동으로 확장하여, 국내 소프트웨어와 하드웨어를 더욱 포괄적으로 평가할 계획입니다.
News
⚠️ [IMG:N] 형식 토큰은 이미지 placeholder 입니다. 번역하지 말고 원래 위치에 그대로 유지하세요.
- [2024년 6월 4일] 연산자(算子) 평가 섹션 지원. #562
- [2024년 5월 20일] 컨테이너 내에서 FlagPerf 평가 시작 지원. #542
- [2024년 5월 6일] LLaMA3-8B megatron-core 사전 학습 지원. #526
- [2024년 4월 1일] 기본 사양 평가 섹션 지원. #496
- [2024년 1월 15일] megatron-Llama 70B 사전 학습 지원. #389
- [2023년 10월 27일] Torch-llama2 7B 사전 학습 지원, #289
- [2023년 10월 7일] Paddle-GPT3 사전 학습 지원, #233
- [2023년 9월 27일] v1.0 버전 출시. 20여 개 클래식 모델 및 50여 개 학습 샘플 지원, 다수 칩 제조사의 학습 또는 추론 평가 지원 #v1.0
- [2023년 8월 3일] 추론 프레임워크 지원, 일반적인 기본 모델의 오프라인 배치 추론 평가 지원 #136
- [2023년 10월 31일] Torch-Aquila 7B 사전 학습 지원, #299
- [2023년 2월 8일] Tensorflow 프레임워크 지원 #7
- [2023년 2월 6일] 쿤룬신(昆仑芯)이 협력 제조사로 참여하여 공동 구축 생태계에 합류 #6
- [2022년 12월] 톈수즈(天数智芯), 바이두 PaddlePaddle이 초기 버전 공동 개발에 가장 먼저 참여함</details>
지원 목록
기본 사양 목록:
<table border="1" class="dataframe"> <thead> <tr> <th>번호</th> <th>규격명</th> <th>규격 유형</th> <th>NVIDIA</th> <th>沐曦</th> <th>Ascend</th> </tr> </thead> <tbody> <tr> <td>1</td> <td>FP64 연산 능력</td> <td>연산 능력</td> <td><a href="https://github.com/FlagOpen/FlagPerf/tree/main/base/benchmarks/computation-FP64/nvidia/A100">연산자 또는 원시 요소</a>, <br><a href="https://github.com/FlagOpen/FlagPerf/tree/main/base/toolkits/computation-FP64/nvidia/A100">제조사 전용 툴킷</a></td> <td>N/A</td> <td>N/A</td> </tr> <tr> <td>2</td> <td>FP32 연산 능력</td> <td>연산 능력</td> <td><a href="https://github.com/FlagOpen/FlagPerf/tree/main/base/benchmarks/computation-FP32/nvidia/A100">연산자 또는 원시 요소</a>, <br><a href="https://github.com/FlagOpen/FlagPerf/tree/main/base/toolkits/computation-FP32/nvidia/A100">제조사 전용 툴킷</a></td> <td><a href="https://github.com/FlagOpen/FlagPerf/tree/main/base/benchmarks/computation-FP32/metax">연산자 또는 원시 요소</a></td> <td><a href="https://github.com/FlagOpen/FlagPerf/tree/main/base/benchmarks/computation-FP32/ascend">제조사 전용 툴킷</a></td> </tr> <tr> <td>3</td> <td>TF32 연산 능력</td> <td>연산 능력</td> <td><a href="https://github.com/FlagOpen/FlagPerf/tree/main/base/benchmarks/computation-TF32/nvidia/A100">연산자 또는 원시 요소</a>, <br><a href="https://github.com/FlagOpen/FlagPerf/tree/main/base/toolkits/computation-TF32/nvidia/A100">제조사 전용 툴킷</a></td> <td><a href="https://github.com/FlagOpen/FlagPerf/tree/main/base/benchmarks/computation-TF32/metax">연산자 또는 원시 요소</a></td> <td>N/A</td> </tr> <tr> <td>4</td> <td>FP16 연산 능력</td> <td>연산 능력</td> <td><a href="https://github.com/FlagOpen/FlagPerf/tree/main/base/benchmarks/computation-FP16/nvidia/A100">연산자 또는 원시 요소</a>, <br><a href="https://github.com/FlagOpen/FlagPerf/tree/main/base/toolkits/computation-FP16/nvidia/A100">제조사 전용 툴킷</a></td> </tr> </tbody> </table> <table> <thead> <tr> <th></th> <th>메모리 유형</th> <th>측정 항목</th> <th>NVIDIA A100</th> <th>MetaX</th> <th>Ascend</th> </tr> </thead> <tbody> <tr> <td></td> <td>FP16 연산 능력</td> <td>연산 능력</td> <td><a href="https://github.com/FlagOpen/FlagPerf/tree/main/base/benchmarks/computation-FP16/metax">연산자 또는 원시 기능</a></td> <td><a href="https://github.com/FlagOpen/FlagPerf/tree/main/base/benchmarks/computation-FP16/ascend">제조사 전용 툴</a></td> </tr> <tr> <td>5</td> <td>BF16 연산 능력</td> <td>연산 능력</td> <td><a href="https://github.com/FlagOpen/FlagPerf/tree/main/base/benchmarks/computation-BF16/nvidia/A100">연산자 또는 원시 기능</a>,<br><a href="https://github.com/FlagOpen/FlagPerf/tree/main/base/toolkits/computation-BF16/nvidia/A100">제조사 전용 툴</a></td> <td><a href="https://github.com/FlagOpen/FlagPerf/tree/main/base/benchmarks/computation-BF16/metax">연산자 또는 원시 기능</a></td> <td><a href="https://github.com/FlagOpen/FlagPerf/tree/main/base/benchmarks/computation-BF16/ascend">제조사 전용 툴</a></td> </tr> <tr> <td>6</td> <td>INT8 연산 능력</td> <td>연산 능력</td> <td><a href="https://github.com/FlagOpen/FlagPerf/tree/main/base/toolkits/computation-INT8/nvidia/A100">제조사 전용 툴</a></td> <td><a href="https://github.com/FlagOpen/FlagPerf/tree/main/base/toolkits/computation-INT8/metax">제조사 전용 툴</a></td> <td><a href="https://github.com/FlagOpen/FlagPerf/tree/main/base/benchmarks/computation-INT8/ascend">제조사 전용 툴</a></td> </tr> <tr> <td>7</td> <td>주 메모리 대역폭</td> <td>저장 공간</td> <td><a href="https://github.com/FlagOpen/FlagPerf/tree/main/base/benchmarks/main_memory-bandwidth/nvidia/A100">연산자 또는 원시 기능</a>,<br><a href="https://github.com/FlagOpen/FlagPerf/tree/main/base/toolkits/main_memory-bandwidth/nvidia/A100">제조사 전용 툴</a></td> <td><a href="https://github.com/FlagOpen/FlagPerf/tree/main/base/benchmarks/main_memory-bandwidth/metax">연산자 또는 원시 기능</a></td> <td>N/A</td> </tr> <tr> <td>8</td> <td>주 메모리 용량</td> <td>저장 공간</td> </tr> </tbody> </table> <table> <thead> <tr> <th></th> <th>功能/场景</th> <th>类别</th> <th>NVIDIA A100</th> <th></th> <th>Ascend</th> </tr> </thead> <tbody> <tr > <td></td> <td>主 메모리 용량 (Main Memory Capacity)</td> <td>용량</td> <td><a href="https://github.com/FlagOpen/FlagPerf/tree/main/base/benchmarks/main_memory-capacity/nvidia/A100">연산자 또는 원시 요소</a>,<br>전용 벤더 도구</td> <td><a href="https://github.com/FlagOpen/FlagPerf/tree/main/base/benchmarks/main_memory-capacity/metax">연산자 또는 원시 요소</a></td> <td>N/A</td> </tr> <tr> <td>9</td> <td>CPU-칩 상호 연결 (Chip Interconnect)</td> <td>상호 연결</td> <td><a href="https://github.com/FlagOpen/FlagPerf/tree/main/base/benchmarks/interconnect-h2d/nvidia/A100">연산자 또는 원시 요소</a>,<br>전용 벤더 도구</td> <td>N/A</td> <td><a href="https://github.com/FlagOpen/FlagPerf/tree/main/base/toolkits/interconnect-h2d/ascend">전용 벤더 도구</a></td> </tr> <tr> <td>10</td> <td>서버 내 P2P 직결 (Intraserver P2P)</td> <td>상호 연결</td> <td><a href="https://github.com/FlagOpen/FlagPerf/tree/main/base/benchmarks/interconnect-P2P_intraserver/nvidia/A100">연산자 또는 원시 요소</a>,<br>전용 벤더 도구</td> <td>N/A</td> <td><a href="https://github.com/FlagOpen/FlagPerf/tree/main/base/toolkits/interconnect-P2P_intraserver/ascend">전용 벤더 도구</a></td> </tr> <tr> <td>11</td> <td>서버 내 MPI 직결 (Intraserver MPI)</td> <td>상호 연결</td> <td><a href="https://github.com/FlagOpen/FlagPerf/tree/main/base/benchmarks/interconnect-MPI_intraserver/nvidia/A100">연산자 또는 원시 요소</a>,<br>전용 벤더 도구</td> <td>N/A</td> <td>N/A</td> </tr> <tr> <td>12</td> <td>서버 간 P2P 직결 (Cross-server P2P)</td> <td>상호 연결</td> <td></td> <td>N/A</td> <td></td> </tr> </tbody> </table> <td><a href="https://github.com/FlagOpen/FlagPerf/tree/main/base/benchmarks/interconnect-P2P_interserver/nvidia/A100">연산자 또는 원시 요소</a>, <a href="https://github.com/FlagOpen/FlagPerf/tree/main/base/toolkits/interconnect-P2P_interserver/nvidia/A100">제조사 전용 툴킷</a></td> <td>N/A</td> <td>N/A</td> </tr> <tr> <td>13</td> <td>서버 간 MPI 직접 연결</td> <td>상호연결(Interconnect)</td> <td><a href="https://github.com/FlagOpen/FlagPerf/tree/main/base/benchmarks/interconnect-MPI_interserver/nvidia/A100">연산자 또는 원시 요소</a>, <a href="https://github.com/FlagOpen/FlagPerf/tree/main/base/toolkits/interconnect-MPI_interserver/nvidia/A100">제조사 전용 툴킷</a></td> <td>N/A</td> <td>N/A</td> </tr> </tbody> </table>연산자 목록:
<table border="1" class="dataframe"> <thead> <tr> <th>번호</th> <th>규격 이름</th> <th>연산자 라이브러리</th> <th>NVIDIA</th> </tr> </thead> <tbody> <tr> <td>1</td> <td>mm-FP16</td> <td>nativetorch<br>flaggems</td> <td><a href="https://github.com/FlagOpen/FlagPerf/tree/main/operation/benchmarks/mm/nvidia">A100_40_SXM</a></td> </tr> <tr> <td>2</td> <td>sum-FP32</td> <td>nativetorch<br>flaggems</td> <td><a href="https://github.com/FlagOpen/FlagPerf/tree/main/operation/benchmarks/sum/nvidia">A100_40_SXM</a></td> </tr> <tr> <td>3</td> <td>linear-FP16</td> <td>nativetorch<br>flaggems</td> <td><a href="https://github.com/FlagOpen/FlagPerf/tree/main/operation/benchmarks/linear/nvidia">A100_40_SXM</a></td> </tr> <tr> <td>...</td> <td>...</td> <td>...</td> <td>...</td> </tr> </tbody> </table>훈련 목록:
[!TIP]
표 아래로 오른쪽으로 스크롤하여 더 많은 제조사 확인
AI 자동 생성 콘텐츠
본 콘텐츠는 GitHub ML Hardware의 원문을 AI가 자동으로 요약·번역·분석한 것입니다. 원 저작권은 원저작자에게 있으며, 정확한 내용은 반드시 원문을 확인해 주세요.
원문 바로가기