Environmental Impact Tracker
v1.5.0
A Claude Code skill로, AI 상호작용의 환경 발자국을 계산하고 표시합니다. 추상적인 토큰 사용량을 에너지 소비량(Wh), 물 사용량(mL) 및 실생활 비교와 같은 형태로 변환하여 보여줍니다.
기능 설명 (What it does)
모든 Claude 응답의 에너지 및 물 사용량을 백그라운드에서 추적한 다음, 이 기록을 주간, 월간, 분기별, 연간 보고서로 만듭니다.
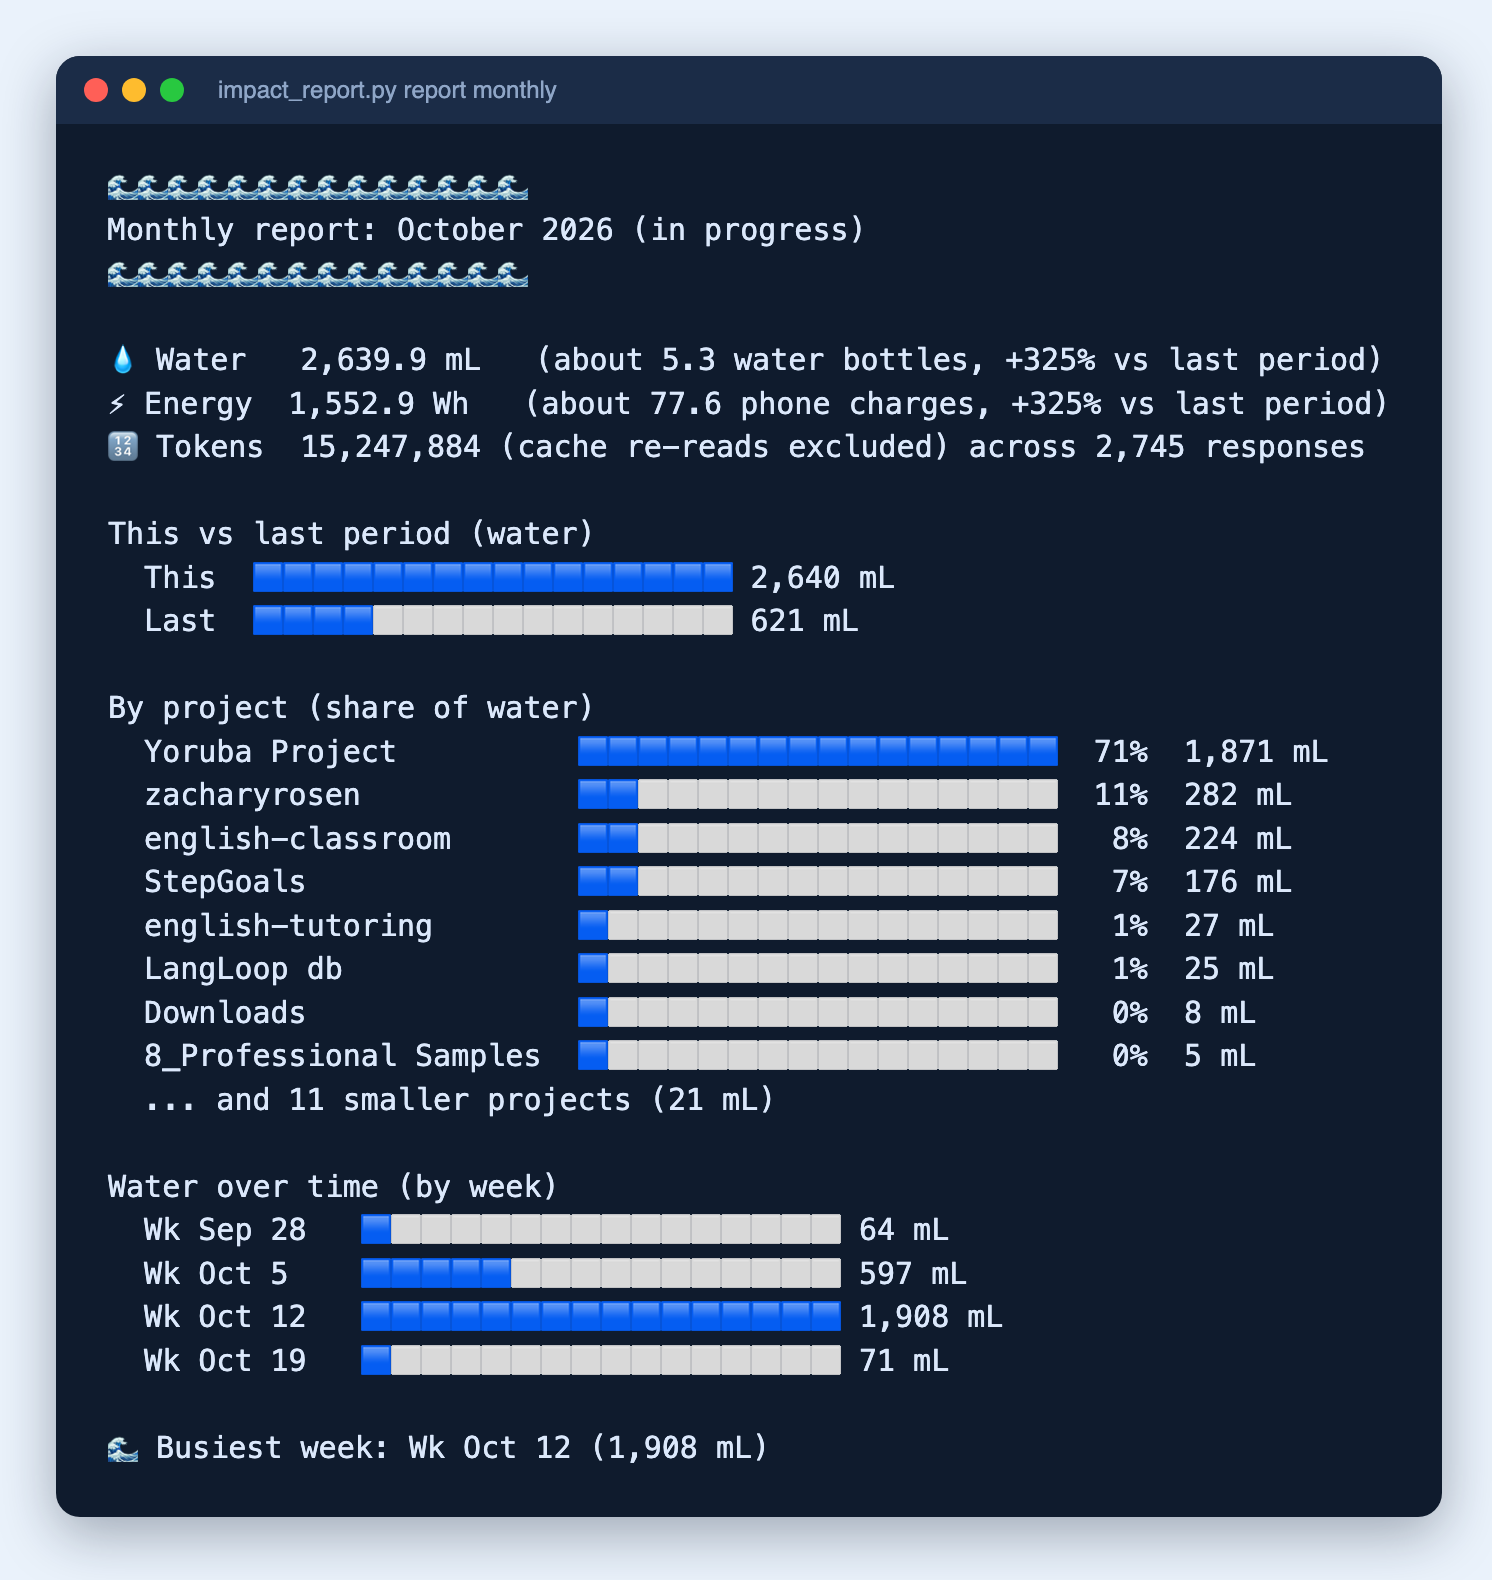
Monthly impact report
월간 보고서에는 다음과 같은 내용이 포함됩니다: 이번 기간 대비 지난 기간 비교, 프로젝트별 물 사용량 비중, 시간 경과에 따른 물 사용량. 각 수치는 기록된 응답의 정확한 토큰 수를 기반으로 계산됩니다.
주요 기능 (Features):
- 모든 것 추적: Stop hook은 모든 응답(subagents 포함)을 기록하므로, Claude가 직접 로그를 남기는 것에 의존하지 않습니다.
- 기간별 보고서: 이전 기간 대비 변화량과 프로젝트별 세부 내역, 트렌드 차트를 포함한 주간, 월간, 분기별, 연간 총계
- 네 가지 모드: 보고서만 표시, 대규모 응답 후 표시, 둘 다 표시, 또는 비활성화
- 히스토리 백필 (History backfill): Claude Code 자체 세션 기록에서 과거 사용량을 재구성합니다.
- 요청 시 턴별 표시 (Per-turn display on request): 모델 효율성 비교 및 subagent 총계를 포함하여 모든 교환에 대한 에너지와 물 사용량 제공 (아래 예시)
- 공유 로그 하나:
~/.claude/environmental-impact-log.json 파일이 모든 프로젝트를 포괄합니다.
per-response 모드에서는 hook이 대규모 응답(5,000개 이상의 새로운 토큰 또는 모든 subagent 응답) 후 한 줄을 출력합니다:
🌍 Impact this turn: 5.04 Wh · 8.6 mL · 94,786 tokens · 12 subagent responses
Claude에게 어떤 교환에 대한 더 긴 표시를 요청하면 다음과 같은 내용을 얻을 수 있습니다:
🌍 Environmental Impact of This Response

Energy: 58.07 Wh (about 3 phone charges)
...
설치 (Installation)
Claude Code
이 리포지토리의 내용물(SKILL.md, scripts/, references/)을 사용자의 Claude Code skills 디렉터리에 복사합니다:
~/.claude/skills/environmental-impact-tracker/
hook과 보고서에는 Python 3이 필요합니다.
수동 설치 (Manual) (모든 Claude 환경)</content>{
SKILL.md의 내용을 시스템 프롬프트나 프로젝트 지침에 붙여넣으세요. 자동 추적 및 보고서는 Claude Code가 필요합니다. 이는 Claude Code의 훅(hooks)과 세션 트랜스크립트에 의존하기 때문입니다.
설정 (Setup)
스킬만 설치한다고 해서 추적이 시작되는 것은 아닙니다. 설정은 몇 가지 일회성 단계이며, Claude는 이 스킬을 처음 사용할 때 사용자에게 안내할 수 있습니다:
- 모드 선택 (아래 Modes 참고). Claude는 사용자의 선택을
~/.claude/environmental-impact-tracker.state에 기록합니다. reports가 권장됩니다.
echo "reports" > ~/.claude/environmental-impact-tracker.state
- Stop 훅 추가를
~/.claude/settings.json의 hooks.Stop 아래에 수행하세요:
{ "hooks": [ { "type": "command", "command": "python3 -I ~/.claude/skills/environmental-impact-tracker/scripts/impact_hook.py", "timeout": 30 } ] }
- **히스토리 백필(Backfill)**을 한 번 수행하세요:
python3 -I ~/.claude/skills/environmental-impact-tracker/scripts/impact_hook.py --backfill
이 명령어는 Claude Code가 가지고 있는 모든 세션 트랜스크립트를 가져옵니다. 오래된 트랜스크립트는 시간이 지남에 따라 정리되므로, 로그가 유일한 영구 기록입니다.
~/.claude/CLAUDE.md에 다음 규칙을 추가하여 Claude가 훅(hook)에게 표시 권한을 넘기도록 하세요:
## Environmental Impact
Impact tracking is automatic (a Stop hook logs every response). Do not display impact on your own. When the user asks for an impact report, a total, or to change the tracking mode, use the `environmental-impact-tracker` skill.
이전 버전에서 프로젝트별로 .environmental-impact-log.json 파일을 가지고 있나요? 있다면 python3 -I scripts/impact_report.py migrate <project-dir>를 사용하여 가져올 수 있습니다. 항목은 디렉터리 이름으로 태그가 지정되며 중복된 항목은 건너뜁니다.
모드 (Modes)
모드가 off가 아닌 한 추적은 항상 실행됩니다. 이 모드는 ~/.claude/environmental-impact-tracker.state에 단어 하나로 기록됩니다.
| 모드 | 추적(Tracking) | 대규모 응답 후 줄 바꿈 | 요청 시 보고서 생성 |
|---|
reports (권장) | 예 | 아니요 | 예 |
| ... | | | |
Claude에게 전환을 요청하거나("only reports", "show me after big responses", "turn it off") 직접 파일을 편집하도록 요청하세요. both는 per-response와 동일하게 작동하며, 레거시 값인 on 역시 per-response를 의미합니다. 상태 파일이 누락된 경우 추적은 조용히 유지되며 Claude가 모드를 선택하도록 요청합니다. 모드를 off로 설정하면 로깅과 표시 모두 중지됩니다.
보고서 (Reports)
"주간 보고서(weekly report)", "월별 영향 보고서(monthly impact report)", "3분기 환경 보고서(Q3 environmental report)", 또는 "지난달 발자국(last month's footprint)"을 요청하거나, 스크립트를 직접 실행하세요.
python3 -I ~/.claude/skills/environmental-impact-tracker/scripts/impact_report.py report <weekly|monthly|quarterly|annual> [--back N]
--back N은 N 기간 전의 보고서를 생성하므로, "지난달"은 monthly --back 1입니다. 주(Week)는 월요일부터 일요일까지 진행되며, 월(Month), 분기(Quarter), 연(Year)은 달력 기반(UTC)입니다. 현재 기간은 "진행 중(in progress)"으로 표시되므로, 이전 전체 기간과 비교했을 때 수치가 낮게 보일 수 있습니다.
각 보고서는 총 물 및 에너지 사용량과 이전 기간 대비 변화량, 이번 vs 지난 막대 그래프, 프로젝트별 물 사용량 비중, 그리고 일별(주간), 주별(월간), 또는 월별(분기/연간) 시간 경과에 따른 물 사용량을 보여줍니다. 블록은 이모지로 되어 있어 텍스트가 표시되는 모든 곳에서 출력됩니다.
사용법 (Usage)
추적 및 응답별 줄 바꿈 기능은 프롬프트할 필요가 없습니다. 후크(hook)가 두 가지를 모두 처리합니다. 그 외의 모든 경우에는 명시적으로 요청해야 합니다. 새로운 Claude 인스턴스를 대상으로 테스트한 결과, "이번 주 영향량을 보여줘"와 같은 모호한 구문은 스킬을 안정적으로 트리거하지 못하며, 특정 Wh/mL 수치가 조작된 정밀도처럼 보인다고 Claude가 우려할 경우 해당 스킬 설명과 유사한 문구는 거부될 수 있습니다. 효과적인 방법:
- 기간과 단어 '보고서(report)'로 명명하기: "나의 월간 환경 영향 보고서를 보여줘."
- 문구가 적절하지 않을 때 기술 이름 지정하기: "환경 영향 추적기(environmental-impact-tracker) 기술을 사용해서 분기별 보고서를 보여줘."
- 또는 스크립트 실행하기: 이는 Claude가 행동할지 여부에 전혀 의존하지 않습니다.
작동 방식
추적 (Tracking)
Claude Code는 모든 응답에 대한 토큰 수를 세션 기록(transcripts)에 작성합니다. scripts/impact_hook.py는 각 응답 후 Stop 훅(Stop hook)으로 실행되며, 이 토큰 수들을 아래 비율을 사용하여 에너지와 물로 변환하고, 응답마다 하나의 항목을 공유 로그에 추가합니다.
- 응답별 계산: 장문 컨텍스트 계층은 각 응답의 총 토큰 수, 캐시 읽기 횟수(입력률의 10%로 계산), 그리고 모든 응답(서브 에이전트 포함)이 모델의 고정 오버헤드 비용을 지불하는 것으로 결정됩니다.
- 프로젝트: 응답은 작업 디렉토리(working directory)에 카운트되며, 만약 Git 저장소(git repo)가 있다면 해당 저장소로 통합되어 계산됩니다.
- 설계상 안전함 (Safe by design): 이 훅은 세션을 절대 차단하지 않습니다. 오류가 발생하면 표준 에러 스트림(stderr)에 기록하고 깨끗하게 종료합니다.
에너지 모델 (Energy model)
각 질의는 고정된 질의당 오버헤드 (라우팅/모델 로드, 길이에 무관함)와 **한계 토큰당 비율(marginal per-token rate)**을 지불합니다. 장문 컨텍스트 턴 (>50,000 총 토큰)은 별도의 낮은 한계 비율로 전환됩니다. 실제 세계의 장문 컨텍스트 추론은 짧은 채팅 턴보다 토큰당 의미 있게 더 효율적이며, 단일한 고정 비율로는 이 둘을 모두 나타낼 수 없습니다.
| Model | Fixed overhead (Wh/query) | Marginal Input (Wh/MTok) | Marginal Output (Wh/MTok) | Long-context Marginal Blended (Wh/MTok) |
|---|
| Claude Fable 5 | 0.531 | 270 | 1,341 | 35 |
| ... | | | | |
| These are 중간 수준의 추정치입니다. 일반적인 등급의 요금은 Joule이 최적화된 서빙 데이터가 암시하는 값보다 3배 높으며, 이는 해당 도출값과 측정된 Claude 벤치마크(약 9~13배 더 높은 수준) 사이에 위치합니다. 중간 길이 프롬프트(입력 1,000 / 출력 1,000)의 경우 Sonnet은 약 0.64 Wh로 계산되며, 이는 최적화된 도출값인 0.2 Wh와 Claude 3.7 Sonnet에서 측정된 2.78 Wh 사이입니다. 장문 컨텍스트 요율은 변하지 않습니다. Anthropic은 에너지 수치나 출처를 공개하지 않으며, Claude 5 시리즈에 대한 자료도 없으므로 모든 숫자는 추정치로 간주해야 합니다. | | | | |
물 사용량: Wh당 1.7 mL (평균 데이터 센터 냉각 + 전력 생산).
고정 오버헤드/한계 요율 분리는 동료 검토를 거친 2026년 Joule 논문의 자체 테스트 시간 스케일링 데이터를 기반으로 합니다(쿼리가 15배 길어지면 에너지 비용은 단지 13배만 증가함. 이는 길이와 함께 희석되는 고정 비용을 의미). 이 데이터는 보조적인 2026년 벤치마킹 논문의 '중간' 쿼리 길이 정의(입력 1,000 / 출력 1,000)에 기반합니다. 장문 컨텍스트 요율은 별도로 실제 장문 컨텍스트 추정치를 기준으로 삼았는데, 짧거나 중간 길이의 쿼리 요율을 매우 큰 컨텍스트까지 외삽하면 약 10배 과대평가되기 때문입니다. 전체 도출 과정 및 신뢰도 참고 사항: references/sources.md.
예시 계산
위 샘플 출력을 사용하여: Claude Sonnet 5, 메인 턴에서 입력 25,000 + 출력 6,000 + 스킬 로드 토큰 2,500을 사용하고, 여기에 각기 34,000 토큰의 4개 서브 에이전트가 추가되었으며, 모든 것이 50,000 토큰 장문 컨텍스트 임계값 아래에 있습니다. 따라서 모든 구성 요소는 일반적인 등급 요율(고정 오버헤드 0.159 Wh, 한계 입력 81 Wh/MTok, 한계 출력 402 Wh/MTok, 한계 혼합 387 Wh/MTok)을 사용합니다:
메인 쿼리:
Energy_input  = 25,000 × 81  / 1,000,000 = 2.0250 Wh
Energy_output =  6,000 × 402 / 1,000,000 = 2.4120 Wh
Energy_skill  =  2,500 × 81  / 1,000,000 = 0.2025 Wh
...```

**각 서브 에이전트** (고유 고정 오버헤드, 티어 확인: 34,000 토큰은 50,000 토큰 미만이므로 일반적인 티어 혼합 요율 적용):
Energy_agent = 0.159 + (34,000 × 387 / 1,000,000) = 0.159 + 13.158 = 13.32 Wh
서브 에이전트 4개: `4 × 13.32 = 53.27 Wh`

**총합:**
Total_energy = 4.80 (쿼리) + 53.27 (에이전트) = 58.07 Wh
Total_water = 58.07 × 1.7 = 98.7 mL
여기서 비용의 대부분은 메인 턴(main turn)이 아니라 네 개의 서브 에이전트에서 발생한다는 점에 주목하십시오. 각 에이전트는 마진 토큰 비용 외에도 자체적으로 0.159 Wh 고정 오버헤드를 지불하며, 이는 이전 평준화된 요율 모델로는 표현할 수 없었던 정확한 동작입니다. 즉, 네 개의 별도 모델 호출을 실행하는 것은 네 배의 토큰을 처리하는 단일 호출과는 실제적이고 구별되는 비용이 발생합니다.

> **참고:** 이 수치들은 공식 Anthropic 에너지 수치가 아닌 공개 벤치마크 및 가격 신호에서 파생된 추정치입니다. 실제 소비량은 데이터 센터 위치, 냉각 방식, 그리드 에너지 혼합에 따라 달라집니다.

## 최신 상태 유지하기 (Keeping it up to date)

이 저장소는 일회성 배포가 아니라 지속적으로 관리됩니다. 요율은 주요 Claude 모델이 출시되거나 LLM 추론(inference)의 에너지/물 사용에 대한 새로운 동료 검토 연구가 발표될 때마다 업데이트됩니다. 변경된 내용과 이유에 대한 전체 기록은 `references/sources.md`의 업데이트 로그를 참조하고, 해당 문서에 있는 지침을 따라 업데이트하십시오.

## 변경 로그 (Changelog)

**1.5.0** (2026-10-19)
- 측정된 Claude 벤치마크 및 기타 발표된 추정치가 이전 수치를 훨씬 초과하여 나타나기 때문에, 일반적인 티어 요율을 중간 수준의 추정치(이전 최적화 서비스 값의 3배)로 이동했습니다. 대규모 컨텍스트(large-context) 요율은 변경되지 않았습니다. 보고서가 1.4.0 이전보다 더 높게 나타나며, 이는 대부분 짧은 응답 작업에 해당합니다.
- `references/sources.md`에 새로운 출처를 추가했습니다: Google의 Gemini 공개 자료, 측정된 Claude 3.7 Sonnet 결과, 그리고 두 가지 Claude Code 분석. Anthropic은 여전히 모든 Claude 모델에 대한 수치를 발표하고 있지 않습니다.

**1.4.0** (2026-10-19)
- 추적(Tracking)이 자동화되었습니다: Stop hook은 Claude Code의 기록(transcript)에서 모든 응답(subagents 포함)을 로깅하며, 더 이상 Claude가 임팩트를 표시할지 여부에 의존하지 않습니다. 이로써 과소 계산을 방지합니다.
- 네 가지 모드(`reports`, `per-response`, `both`, `off`)가 추가되었습니다. 해당 스킬은 첫 사용 시 모드를 요청하며 `reports`를 권장합니다.
- 기존 기록에서 히스토리를 재구축하기 위해 `scripts/impact_hook.py --backfill`이 추가되었습니다.
- `CLAUDE.md`의 표시 규칙을, 이제는 hook에 표시를 맡기는 방식으로 변경했습니다.
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21