
ElevenLabs의 Instant Voice Cloning(IVC)은 본인 목소리와 얼마나 유사할까
요약
본 기사는 ElevenLabs의 Instant Voice Cloning (IVC) 기능을 활용하여 생성된 음성의 화자 유사도를 측정했습니다. 10초 분량의 본인 목소리를 기반으로 다양한 문장과 언어에서 오디오를 생성하고, resemblyzer 코사인 유사도와 F0 mean 분석을 통해 그 결과를 제시합니다. 결과적으로 IVC는 높은 일관성을 보였으나, 참조 음성과의 유사도는 83~85% 수준이었습니다.
핵심 포인트
- IVC는 동일 문장/문장 간 높은 일관성(평균 0.96 이상)을 유지했습니다.
- 참조 음성과의 화자 유사도(0.84~0.85)는 타인 목소리 대비 월등히 높았습니다.
- 생성된 음성은 참조 음성보다 F0 mean이 높아져 목소리가 다소 높아지는 경향을 보였습니다.
- 권장 녹음 시간(1~2분)에 맞춰 진행하면 유사도가 더 높아질 가능성이 있습니다.
ElevenLabs에는 두 가지 종류의 음성 클로닝이 있습니다. Professional Voice Cloning (PVC)은 30분 이상의 녹음으로 만드는 고품질 버전이지만, 공식 FAQ에 '동의가 있더라도 타인의 목소리는 클론할 수 없다'고 명시되어 있어 본인 목소리만 만들 수 있습니다. 다른 사람의 목소리를 다루려면 실질적으로 IVC를 선택해야 합니다.
그렇다면 IVC로 만든 목소리는 본인과 얼마나 유사할까요? ElevenLabs에 대한 이전 비교 기사에서는 읽어주는 내용의 정확도(CER)만을 측정했을 뿐, 음성 유사도는 측정한 적이 없습니다. 그래서 제 자신의 목소리 10초를 이용해 IVC를 만들고, eleven_v4 모델로 동일 문장, 다른 문장, 그리고 7개 언어 총 17개의 오디오를 생성한 뒤, resemblyzer의 화자 임베딩(speaker embedding) 코사인 유사도로 측정했습니다. 참조 음성과 생성된 텍스트는 이전 기사에서 사용했던 자료를 빌려왔습니다.
결론
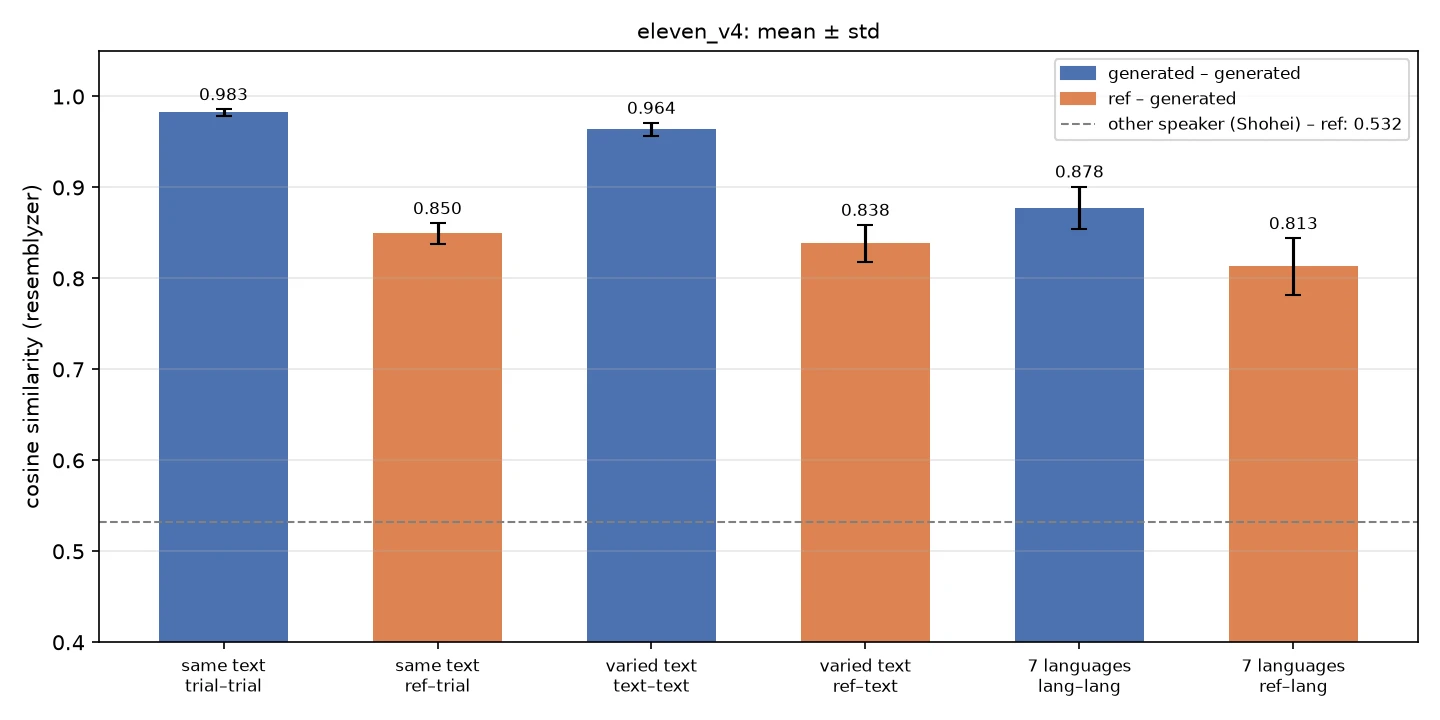
- 시도 간/문장 간 일관성이 높다. 동일 문장 5회 시도의 평균 유사도는 0.9825 ± 0.0035로, 10 쌍의 최소값만 해도 0.9781입니다. 문장을 바꾼 5개 사이에서도 0.9639 ± 0.0071을 보였습니다.
- 참조 음성(본인)과의 유사도는 동일 문장에서 0.8495 ± 0.0112, 다른 문장에서는 0.8384 ± 0.0204를 기록했습니다. 생성된 결과물끼리의 유사도보다는 확실히 낮습니다.
- 같은 문장을 클로닝이 아닌 타인의 목소리(ElevenLabs 라이브러리 음성, 일본어 남성)로 읽게 했을 경우, 참조 음성과의 유사도는 0.5317이었습니다. IVC의 0.84~0.85는 이보다 훨씬 본인에게 가깝습니다.
- 목소리가 높아진다. F0 mean은 참조 음성의 104.38 Hz에 비해, 동일 문장 5회에서는 124.86~131.92 Hz를 기록했습니다. 이는 반음으로 환산했을 때 약 3.5개 정도 높은 수준입니다.
- 일본어 참조 음성으로 7개 언어를 생성했을 경우, 언어 간 유사도는 0.8778 ± 0.0232, 참조 음성과의 유사도는 0.8132 ± 0.0310을 기록했습니다. 언어 판별은 7/7로 지정한 대로 성공적이었습니다.
- 청취 인상으로도 목소리 동일성은 비교적 잘 유지되었습니다. 다른 점은 감정(억양) 처리 방식뿐이었습니다. 동일 문장 5회에서 F0 mean이 124.86~131.92 Hz 범위로 변동하는 것과 일치합니다.
- 참조 음성은 10초 분량이고, IVC의 공식 권장 시간(1~2분)보다 짧습니다. 권장 시간에 맞춰 녹음한다면 참조 음성과의 유사도가 높아질 가능성이 있습니다. 또한 수치 측정은 resemblyzer라는 단일 지표만을 사용했으며, 청감적 평가는 필자 본인의 인상입니다.
방법론
- 참조 음성: 자신의 목소리 약 10초 (24kHz 모노). 08-26 기사와 동일한 파일입니다.
- IVC: API (
POST /v1/voices/add)를 사용하여 참조 음성 1개로부터 1개를 생성했습니다.remove_background_noise=false로 설정했습니다. IVC API에는 전사(transcription) 항목이 없기 때문에, 전사는 전달하지 않았고 측정 후에 삭제했습니다. - 모델: 공식 models 페이지에서 최신 플래그십으로 제시하는eleven_v4를 사용했습니다. - 생성:
output_format=wav_24000을 사용했으며,voice_settings는 전송하지 않고 기본값(stability 0.5, similarity_boost 0.75, speaker boost on)을 사용했습니다. 또한seed도 지정하지 않았습니다. - 텍스트: 동일 문장 ×5, 다른 문장 ×5, 7개 언어 ×1의 총 17개입니다 (08-26 기사의 실험 1, 실험 2, 실험 5와 같은 문장들). 모든 건이 성공했습니다.
- 화자 유사도: resemblyzer의
VoiceEncoder에서 추출한 256차원 발화 임베딩(utterance embedding) 간 코사인 유사도를 사용했습니다. F0는 librosa의pyin을 사용했습니다. 언어 판별은 faster-whisper (small)를 사용했습니다. - 기준: ElevenLabs 라이브러리 음성인 Shohei(일본어 남성, 클로닝 아님)로 동일 문장을 1개 생성하여 참조 음성과 유사도를 측정했습니다.
측정 코드와 생성된 오디오는 blog-examples에 있습니다.
전체
실험1: 동일한 문장을 5회 생성하기
| 그룹 | 조건 | n | 평균 | 표준편차 | 최소 | 최대 |
|---|---|---|---|---|---|---|
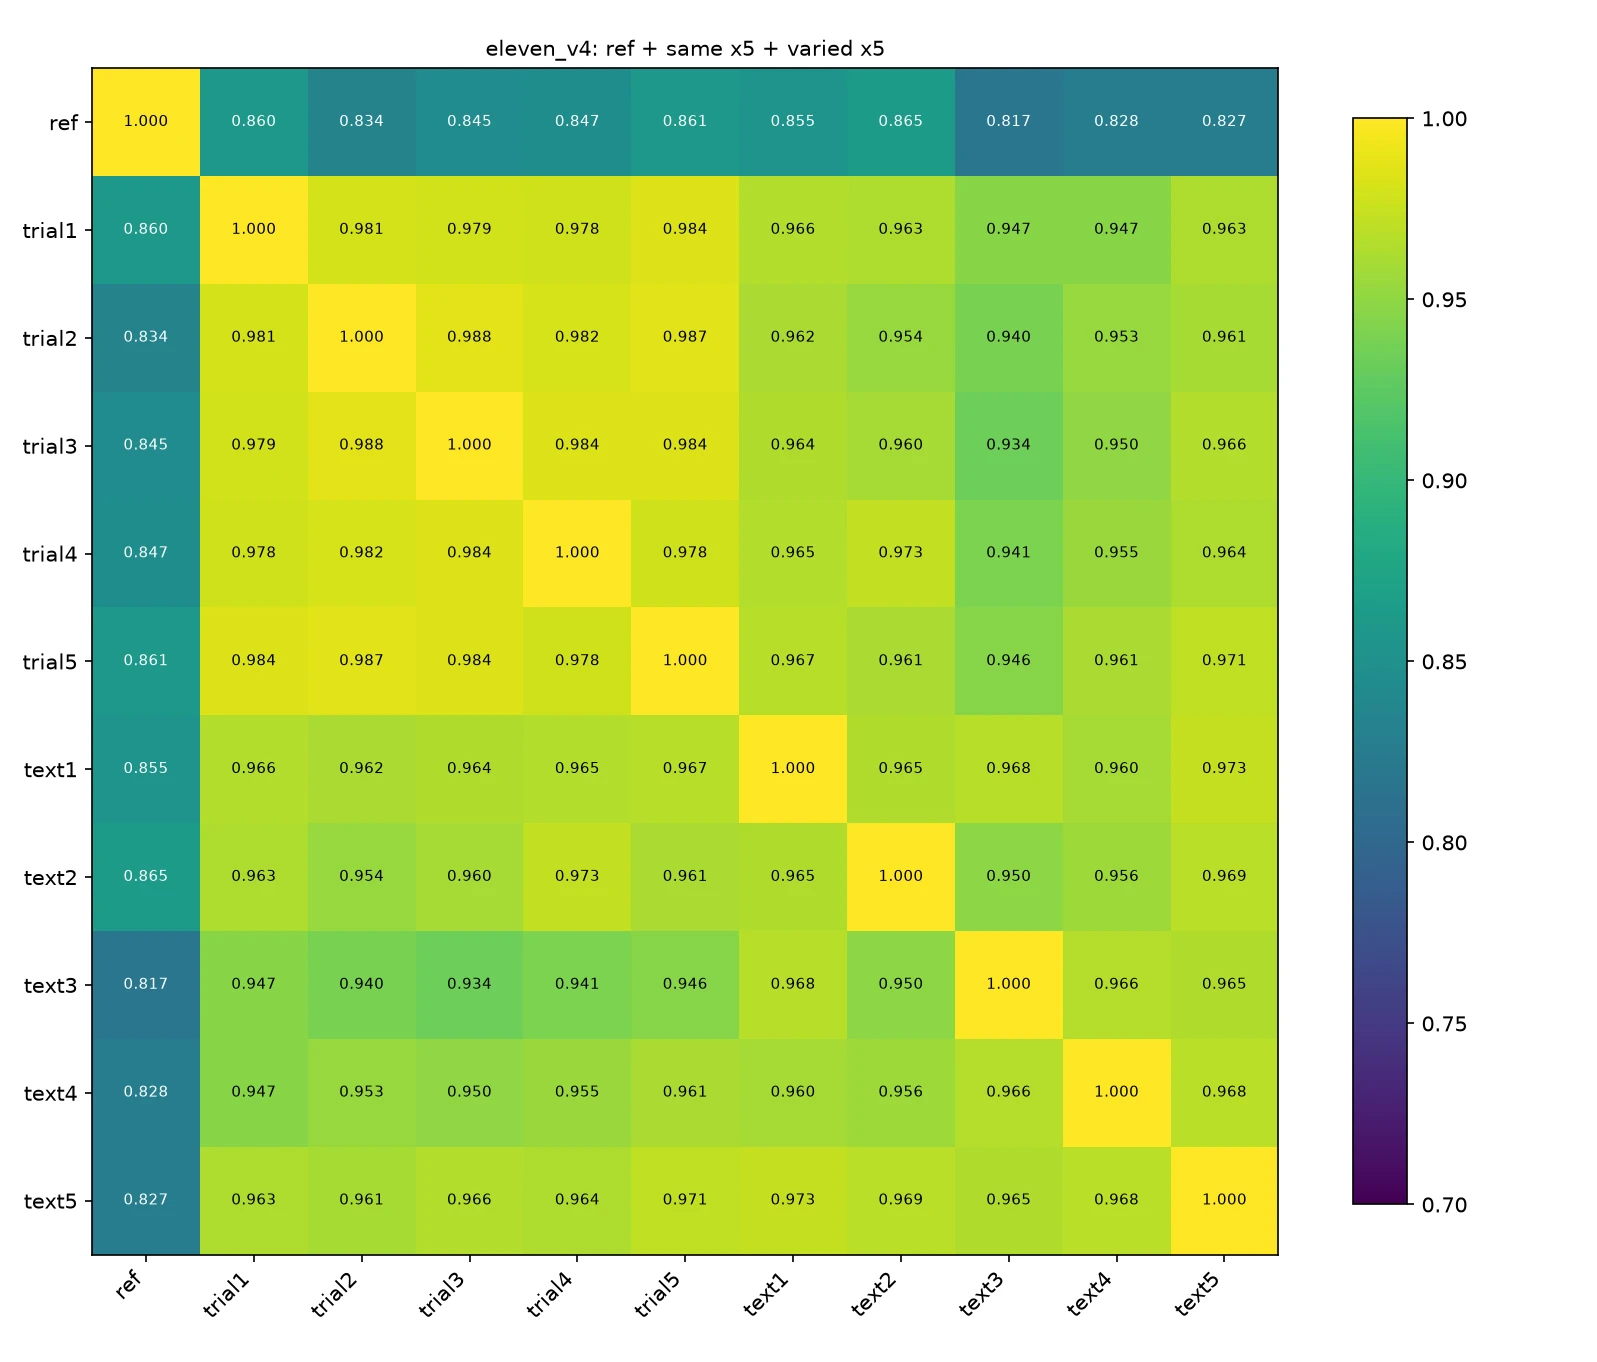
| 시도 간 | 동일 문장끼리 | 10 | 0.9825 | 0.0035 | 0.9781 | 0.9880 |
| 참조 음성–시도 | 5 | 0.8495 | 0.0112 | 0.8341 | 0.8613 |
5회의 시도는 거의 같은 목소리로, 10쌍의 최소값만 해도 0.9781입니다. seed를 지정하지 않았기 때문에 생성할 때마다 난수가 바뀌었을 것이지만, 이 지표에서는 목소리의 떨림이 거의 보이지 않습니다. 길이도 12.72~13.04초 (표준편차 0.13초)로 일정했습니다.
실제로 5개를 들어 비교해도 목소리 동일성은 상당히 유지되었으며, 다른 점은 감정(억양)을 넣는 방식뿐이었습니다. 수치로 봐도 길이는 일정한 반면 F0 평균값은 124.86~131.92 Hz 범위에서 움직이고 있으며, 이는 억양의 차이가 음높이에 나타나고 있음을 보여줍니다.
반면 참조 음성과의 유사도는 0.83~0.86으로, 시도 간보다 약 0.13 정도 낮은 위치에 있습니다. 매번 같은 목소리가 나오지만, 그 목소리는 본인으로부터 약간 벗어난 곳에 있습니다. 참조 음성은 어떤 생성물과도 문장이 다르기 때문에, 이 차이에는 음소 내용의 차이도 포함됩니다 (지표의 한계 참고).
trial1입니다. 참조 음성 자체는 공개하지 않았습니다.
참고로 Zenn에서는 음성을 인라인으로 재생할 수 없으므로, 음성은 링크(별도의 탭)에서 재생됩니다. 인라인으로 비교하고 싶다면 블로그 버전을 이용해 주세요.
실험2: 문장을 바꿔서 5회 생성하기
| 그룹 | 조건 | n | 평균 | 표준편차 | 최소 | 최대 |
|---|---|---|---|---|---|---|
| 문장 간 | 다른 문장끼리 | 10 | 0.9639 | 0.0071 | 0.9495 | 0.9731 |
| ... | ||||||
| 문장을 바꿔도 5개 사이는 0.96대로 일정합니다. 동일 문장의 시도 간(0.9825)보다는 약간 낮지만, 다른 문장 쌍에는 음소 내용의 차이가 포함되므로 이 차이를 목소리 변화라고 해석할 수는 없습니다. 참조 음성과의 유사도는 실험1과 거의 같은 수준(0.8384)으로, 문장에 따라 본인에게서 멀어지는 모습은 보이지 않습니다. |
text1입니다.
F0: 목소리가 높아짐
| F0 평균 | |
|---|---|
| 참조 음성 | 104.38 Hz |
| ... | |
| 모든 생성물은 참조 음성보다 20~37 Hz 높은 대역에 나왔습니다. 동일 문장 5개의 평균인 128.28 Hz는 참조 음성보다 반음 약 3.5개 정도 높습니다. pyin의 추정 오류인지 다른 추정법(librosa의 yin, 음량이 큰 절반 프레임의 중앙값)으로 확인했지만, 참조 음성 104.64 Hz에 대해 trial1 130.81 Hz와 같은 방향의 차이가 나타납니다. 언어를 바꿔도 높은 쪽에 치우친 상태를 유지합니다. |
참조 음성과의 유사도가 생성물들끼리보다 낮은 이유의 후보로 이 목소리의 높이 차이가 고려될 수 있습니다. 다만, resemblyzer의 embedding이 목소리의 높이에 얼마나 반응하는지는 이번 측정만으로는 구분할 수 없으므로 인과관계까지는 말할 수 없습니다.
실험3: 언어를 바꾸기
| 그룹 | 조건 | n | 평균 | 표준편차 | 최소 | 최대 |
|---|---|---|---|---|---|---|
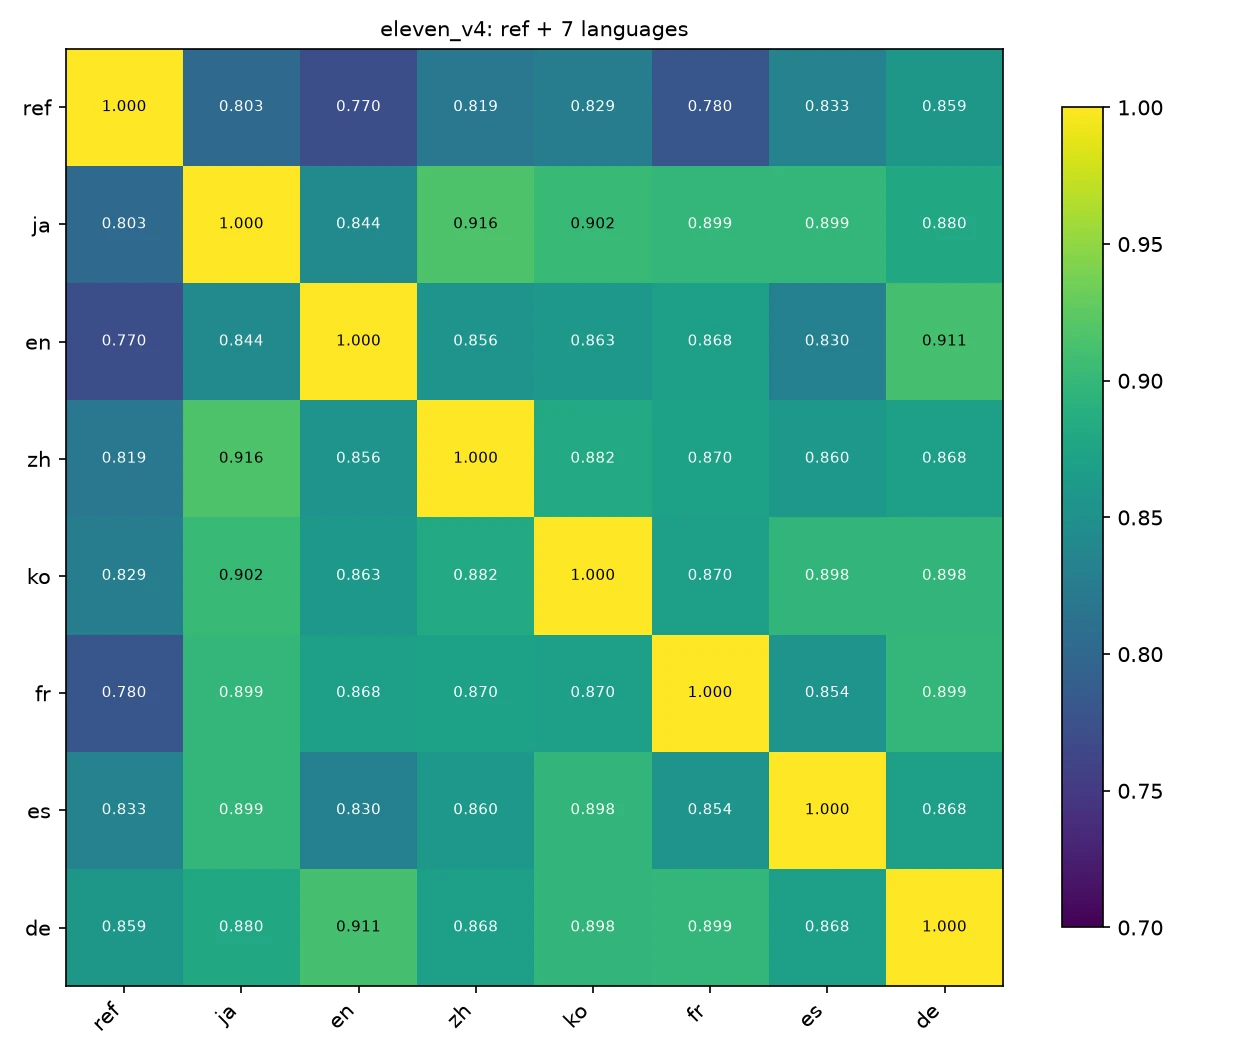
| 참조 음성–언어 | 7개 언어 | 7 | 0.8132 | 0.0310 | 0.7703 | 0.8587 |
| ... | ||||||
| 언어 판별은 faster-whisper (small)로 7/7이 지정된 대로의 언어였고, 전사 역시 생성 텍스트와 거의 일치했습니다. |
언어 간 유사도는 약 0.88 수준으로, 일본어 내의 이문(異文) (0.9639) 보다 낮습니다. 이러한 저하에는 목소리 변화 외에도 음소 체계의 차이와 resemblyzer의 언어 편향(language bias)이 복합적으로 작용합니다. 참조 음성과의 유사도는 일본어 실험보다 더 떨어지며, 가장 낮은 것은 en (0.7703)과 fr (0.7802)였고, 가장 높은 것은 de (0.8587)였습니다. ja도 0.8030으로, 동일한 일본어 실험 1・2 (0.840.85)보다 낮게 나왔습니다. 또한, 7개 언어의 문장은 실험 1・2보다 짧기(4.886.56초) 때문에, 짧은 음성에서는 임베딩이 안정화되기 어려운 것도 영향을 미쳤을 수 있습니다.
en입니다.
지표의 한계
- 참조 음성은 10초로, IVC의 공식 권장 시간(1~2분)보다 짧습니다. 권장 시간에 맞춰 만든 IVC는 측정하지 않았습니다.
voice_settings는 기본값(similarity_boost 0.75 등)만 측정했습니다. similarity_boost를 높였을 때의 변화는 보지 못했습니다. 지표는 resemblyzer의 utterance embedding 중 하나일 뿐입니다. 주로 화자성(speaker identity)을 포착하지만, 음소 내용(무엇을 말하는가)의 영향을 완전히 배제할 수는 없습니다. 참조 음성은 어떤 생성물과도 문장이 다르기 때문에, 참조 음성과의 유사도는 항상 음소 내용의 차이를 포함합니다.- resemblyzer의 VoiceEncoder는 영어 중심 데이터(VoxCeleb 계열)로 학습되었기 때문에, 다국어 유사도에는 인코더의 언어 편향이 혼재됩니다.
- 다른 사람을 기준으로 삼은 것은 ElevenLabs의 라이브러리 음성 1인분만입니다. 화자를 늘린 분포는 측정하지 않았습니다.
- 각 조건별로 5~7개, 하루에 한 번씩 측정했습니다. 청감적 평가는 필자 본인이 들은 인상이며, 다수 평가를 거치지는 않았습니다.
요약
ElevenLabs의 Instant Voice Clone을 eleven_v4로 읽게 하자, 시도나 문장을 바꿔도 목소리가 잘 유지되었습니다. 동일 문장 내의 시도 간 유사도는 0.98, 다른 문장 사이에서도 0.96입니다. 들어봐도 목소리의 동일성은 비교적 잘 유지되었고, 달랐던 부분은 감정(억양)을 입히는 방식뿐이었습니다. 참조 음성(본인)과의 유사도는 0.84~0.85로, 다른 사람의 목소리(0.53)보다는 훨씬 본인에게 가깝지만, 생성물끼리의 유사도만큼 가깝지는 않았습니다. 목소리 높낮이 또한 참조 음성보다 반음 약 3.5개 정도 더 높게 나왔습니다.
다른 사람의 목소리를 IVC로 만들 용도의 경우, '매번 같은 목소리가 나올지'에 대한 걱정은 적고, '본인에게 얼마나 근접하게 할 수 있는지'가 논점이 됩니다. 공식 권장 시간인 1~2분 길이의 참조 음성이나, similarity_boost를 높인 설정에서 본인과의 근접도가 달라지는지는 아직 측정하지 못했습니다.
참고
Discussion

AI 자동 생성 콘텐츠
본 콘텐츠는 Zenn AI의 원문을 AI가 자동으로 요약·번역·분석한 것입니다. 원 저작권은 원저작자에게 있으며, 정확한 내용은 반드시 원문을 확인해 주세요.
원문 바로가기