
DiffusionGemma: 4배 빠른 텍스트 생성
요약
DiffusionGemma는 텍스트 확산(text diffusion)을 활용하여 기존 자기회귀적 LLM의 순차적 토큰 생성 방식을 넘어선 실험적인 오픈 모델입니다. 이 26B MoE 모델은 전체 텍스트 블록을 동시에 생성함으로써, GPU 환경에서 최대 4배 빠른 텍스트 생성을 제공합니다. 주로 속도가 중요한 로컬 워크플로우(인라인 편집, 코드 채우기 등)에 적합하며, 높은 품질의 프로덕션 출력이 필요할 때는 표준 Gemma 4 사용이 권장됩니다.
핵심 포인트
- 전체 텍스트 블록 동시 생성으로 최대 4배 빠른 속도 구현
- 26B MoE 구조로 소비자 GPU(18GB VRAM)에서도 구동 가능
- 인라인 편집, 코드 채우기 등 비선형 작업에 강점 보유
- 최고 품질 출력이 필요하면 표준 Gemma 4 사용 권장
DiffusionGemma: 4배 빠른 텍스트 생성
오늘 저희는 텍스트 확산(text diffusion)을 탐구하는 실험적인 오픈 모델인 DiffusionGemma를 소개합니다. 이는 텍스트 생성을 위한 매우 빠른 접근 방식입니다. Apache 2.0 라이선스로 공개된 이 26B Mixture of Experts (MoE) 모델은 일반적인 자기회귀적 대규모 언어 모델(LLMs)의 순차적인 토큰별 처리 방식을 넘어섭니다. 대신, 전체 텍스트 블록을 동시에 생성하여 GPU에서 최대 4배 빠른 텍스트 생성을 제공합니다.
업계 최고 수준의 매개변수당 지능(intelligence-per-parameter)을 자랑하는 Gemma 4 제품군과 최첨단 Gemini Diffusion 연구를 기반으로, DiffusionGemma는 생성 속도를 극대화하도록 설계된 새로운 확산 헤드(diffusion head)를 통합했습니다. 자기회귀적 Gemma 4 모델이 여전히 높은 품질의 프로덕션 출력을 위한 표준인 반면, DiffusionGemma는 인라인 편집, 빠른 반복 작업, 비선형적인 텍스트 구조 생성과 같이 속도가 중요한 상호작용 로컬 워크플로우를 탐구하는 연구원 및 개발자를 위해 설계되었습니다.
개발자를 위한 새로운 가치 해제
실시간 상호작용 AI 애플리케이션을 구축하는 개발자들은 종종 로컬 추론의 지연 시간 병목 현상(latency bottlenecks)에 어려움을 겪습니다. DiffusionGemma는 이러한 과제들을 직접적으로 해결하며, 몇 가지 주요 트레이드오프가 있습니다:
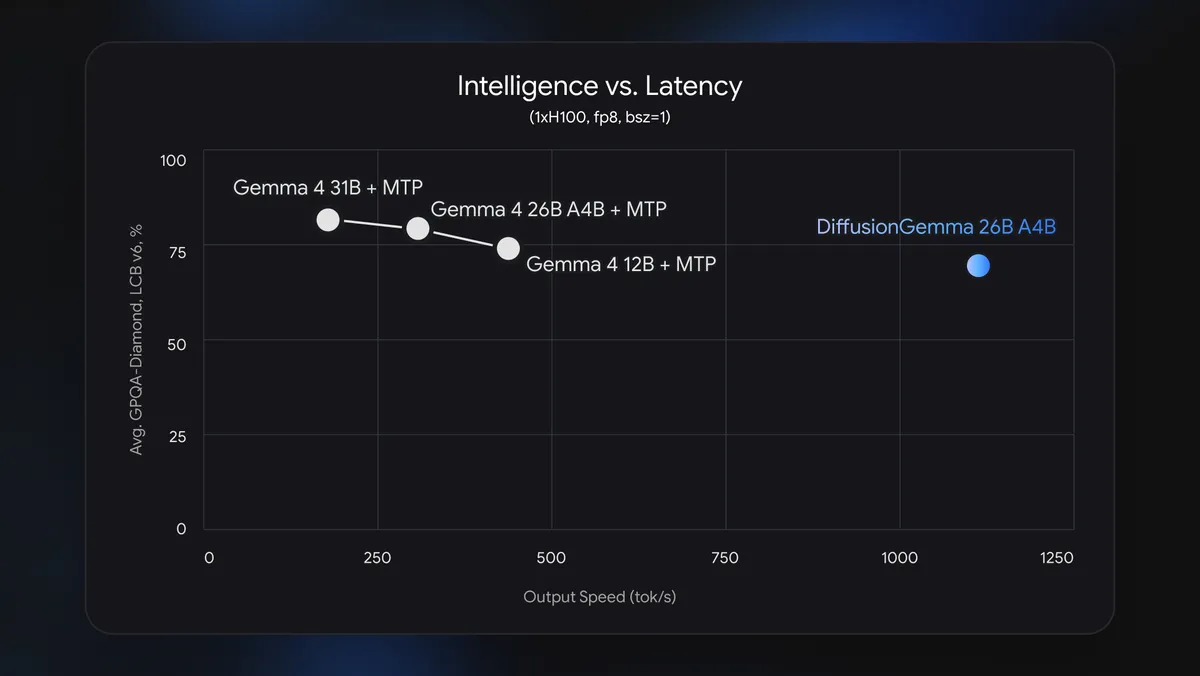
놀라운 추론 속도: 디코딩 병목 현상을 메모리 대역폭(memory-bandwidth)에서 컴퓨팅(compute)으로 전환함으로써, DiffusionGemma는 전용 GPU에서 최대 4배 빠른 토큰 출력을 생성합니다. (단일 NVIDIA H100에서 초당 1000개 이상의 토큰, NVIDIA GeForce RTX 5090에서 초당 700개 이상).¹ 접근 가능한 하드웨어 사용량: 추론 과정에서 38억 개의 파라미터만 활성화하는 총 26B의 Mixture of Experts (MoE) 모델로 작동하기 때문에, 양자화(quantized)했을 때 고성능 전용 소비자 GPU의 18GB VRAM 제한 내에 편안하게 들어맞습니다. 양방향 어텐션 (Bi-directional attention): 한 번의 순전파(forward pass)로 256개의 토큰을 병렬로 생성할 수 있어, 모든 토큰이 서로에게 주의를 기울일 수 있게 합니다. 이는 인라인 편집(in-line editing), 코드 채우기(code infilling), 아미노산 서열 또는 수학적 그래프와 같은 비선형 영역에서 상당한 이점을 제공합니다. 지능적인 자체 교정: 모델은 자신의 출력을 반복적으로 개선하여, 전체 텍스트 블록을 한 번에 평가하고 실시간으로 오류를 수정할 수 있게 합니다. 실험 단계 및 프로덕션 권장 사항: DiffusionGemma는 속도와 병렬 레이아웃 생성에 중점을 두기 때문에, 전반적인 출력 품질은 표준 Gemma 4보다 낮습니다. 최대 품질이 요구되는 애플리케이션의 경우, 표준 Gemma 4 배포를 권장합니다. 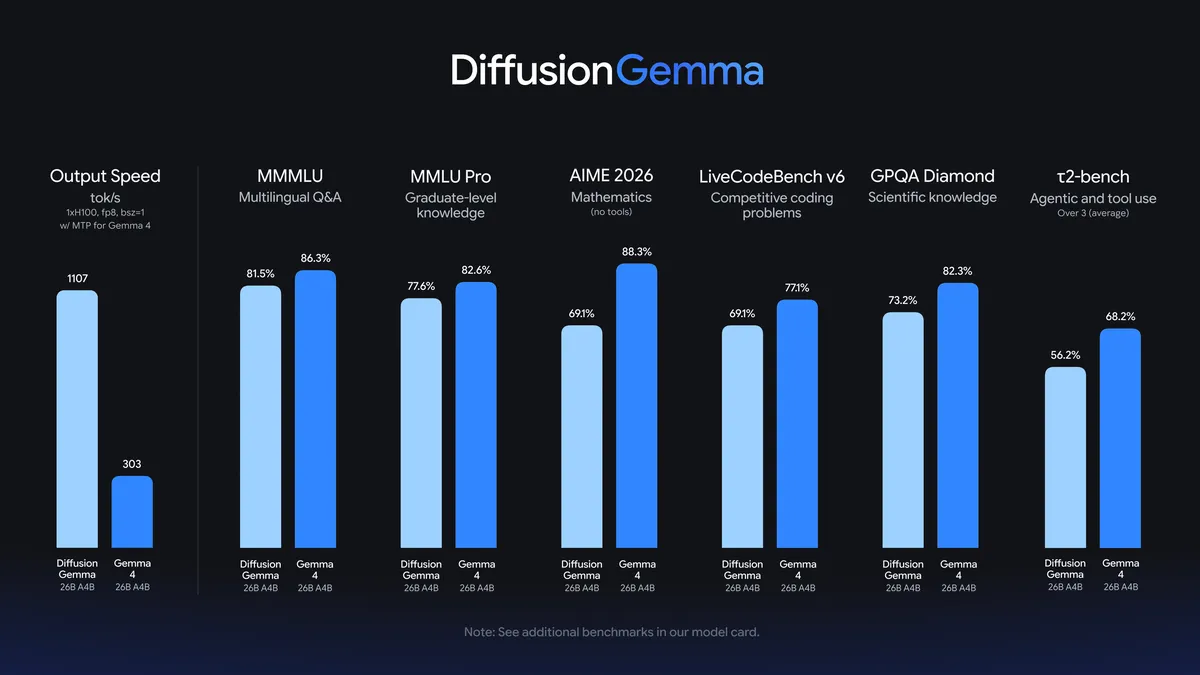

대부분의 언어 모델은 타자기처럼 작동하여 왼쪽에서 오른쪽으로 토큰을 하나씩 생성합니다. 클라우드 환경에서는 서버가 수천 개의 사용자 요청을 묶어서(batch) 하드웨어 부하를 공유할 수 있기 때문에 효율적입니다. 하지만 단일 사용자를 위해 로컬에서 실행될 때는, 이 단어별 과정이 전용 GPU나 TPU를 활용하지 못하게 만듭니다. 대부분의 시간을 다음 '키 입력'을 기다리며 보내게 됩니다.
DiffusionGemma는 이러한 비효율성을 역전시킵니다. 단어를 순차적으로 예측하는 대신, 전체 256개 토큰 분량의 문단을 한 번에 초안합니다. 컴퓨터 프로세서에게 더 큰 작업량을 한 번에 제공함으로써, DiffusionGemma는 하드웨어를 최대 잠재력으로 활용합니다. 모델 추론(inference)을 단일한 순차적 타자기에서 전체 텍스트 블록을 동시에 찍어내는 거대한 인쇄기 수준으로 업그레이드하는 것입니다.
DiffusionGemma text-to-3D SVG 데모 (Hugging Face). 단계별 생성 과정입니다.
이는 DiffusionGemma의 속도 향상이 로컬 및 낮은 동시성(low-concurrency) 추론을 위해 설계되었음을 의미합니다. 높은 QPS 클라우드 서비스 환경에서는 자기회귀 모델(autoregressive models)이 컴퓨팅 자원을 효율적으로 포화시키도록 배포될 수 있으므로, DiffusionGemma의 병렬 디코딩은 체감 효과가 줄어들고 더 높은 서비스 비용을 초래할 수 있습니다. 처리량 이점은 단일 가속기에서 낮은~중간 배치 크기(batch sizes)일 때 가장 강력합니다.
텍스트 확산 방식 (How text diffusion works)
시각적 노이즈(visual static)로 시작하여 점진적으로 선명한 그림으로 다듬어 나가는 AI 이미지 생성기와 유사하게, DiffusionGemma는 이 방식을 텍스트에 적용합니다:
캔버스: 모델은 무작위 자리 표시자 토큰들로 구성된 캔버스로 시작합니다.
반복적 정제: 모델은 여러 번의 패스를 거치며 정확한 토큰들을 고정하고, 이를 문맥 단서(context clues)로 사용하여 나머지 부분을 다듬습니다.
최종 완성: 텍스트는 높은 품질의 결과물로 수렴됩니다.
모델이 생성하는 동안 전체 문단을 처리할 수 있기 때문에, 복잡한 마크다운 형식(markdown formatting)을 완벽하게 닫거나 코드를 거의 실시간으로 생성하고 렌더링하는 것과 같은 새로운 모델 동작 패턴을 구현합니다.
지금 시작하기
가중치 다운로드: 실험적인 모델 가중치(관대한 Apache 2.0 라이선스 하에 공개됨)를 Hugging Face에서 지금 바로 액세스하세요.통합 및 학습: DiffusionGemma 개발자 가이드를 통해 더 많은 것을 배우거나, A Visual Guide to DiffusionGemma를 깊이 파고들어 내부 작동 방식을 이해해 보세요.좋아하는 개발 도구 사용하기: MLX, vLLM(Red Hat의 통합 지원), Hugging Face Transformers를 사용하여 모델을 효율적으로 서비스하세요. 빠른 실험을 위해 모듈식 JAX 툴박스인 Hackable Diffusion을 사용한 미세 조정 튜토리얼도 공개합니다. 또한 Unsloth 및 NVIDIA NeMo를 이용한 미세 조정도 탐색할 수 있습니다. 추가로, llama.cpp에 대한 공식 지원이 곧 도착합니다.최적화된 성능 경험하기: 우리는 NVIDIA와 협력하여 그들의 하드웨어 스택 전반에 걸쳐 최적화를 진행했으며, 소비자용 설정(GeForce RTX 5090 및 4090 GPU용 양자화)과의 호환성을 보장하는 동시에 엔터프라이즈 시스템(NVIDIA DGX Spark 및 DGX Station을 포함한 Hopper 및 Blackwell 사용, 고급 NVFP4 커널 활용)에서도 높은 성능을 유지합니다. AI 전문가를 위한 RTX PRO도 지원됩니다. NVFP4(4비트 부동 소수점)에 대한 네이티브 지원은 컴퓨팅 처리량을 가속화하여 거의 손실 없는 정확도로 모델이 더 빠른 속도로 실행되도록 합니다.직접 시도해 보기: 데스크톱 전용 GPU 또는 Gemini Enterprise Agent Platform Model Garden이나 NVIDIA NIM을 통해 클라우드에서 실행해 보세요.
AI 자동 생성 콘텐츠
본 콘텐츠는 Google DeepMind의 원문을 AI가 자동으로 요약·번역·분석한 것입니다. 원 저작권은 원저작자에게 있으며, 정확한 내용은 반드시 원문을 확인해 주세요.
원문 바로가기