
에이전트 환경 및 태스크 구축 방법
요약
본 글은 에이전트의 신뢰성 있는 개선을 위한 합성 환경 및 태스크를 구축하는 실용적인 가이드입니다. 핵심은 트레이스, 코드, 사용자 입력을 받아 상세한 사양(spec)을 만들고, 이를 바탕으로 평가 태스크와 환경을 생성하는 2단계 파이프라인을 구축하는 것입니다.
핵심 포인트
- 에이전트의 신뢰성 개선을 위해 좋은 벤치마크가 필수적입니다.
- 태스크는 입력, 환경, 테스트 스크립트로 구성되어야 합니다.
- 최종 목표는 에이전트 평가 및 개선에 사용될 고품질 검증 태스크 데이터셋 구축입니다.
- 효율적인 태스크 생성을 위해 체계적인 파이프라인 구축이 중요합니다.
요약: 이 글은 합성 에이전트 환경과 태스크를 만드는 실용적인 가이드입니다. 마지막에는 두 단계의 파이프라인을 갖게 됩니다. 첫 번째 단계는 트레이스(traces), 코드, 그리고/또는 사용자 입력을 받아 상세한 사양(spec)을 구축합니다. 두 번째 단계는 이 사양을 받아 평가 태스크와 해당 태스크를 위한 환경을 생성합니다. 이를 위해 공유 지식, 스크립트, 중요한 정의를 담는 '월드 사양(world spec)'을 만듭니다. 이 과정은 매우 반복적입니다. 저희는 이 과정을 업데이트된 eval-engineering 스킬로 패키징하여 모든 팀이 자신만의 흐름으로 소유할 수 있게 했습니다.
용어집:
에이전트(Agent): LLM을 사용하여 애플리케이션의 제어 흐름을 결정하는 시스템
환경(Environment): 에이전트가 실행되는 곳
루브릭(Rubric): 에이전트 실행 결과를 판단하기 위한 일련의 기준
태스크(Task): 입력, 환경, 그리고 테스트 스크립트로 구성됩니다. 에이전트는 이 지침들을 환경 내부에서 실행하여 출력을 생성하고, 이는 테스트 스크립트에 의해 점수가 매겨집니다.
데이터셋(Dataset): 태스크들의 모음이며, 벤치마크라고도 불립니다.
평가(Evaluation): 데이터셋 위에서 에이전트를 실행하여 점수를 얻는 것
하버(Harbor): 태스크와 데이터셋을 정의하고 평가를 실행하기 위한 프레임워크
트레이스(Traces): 에이전트의 입력과 궤적에 대한 상세한 실행 정보
태스크 사양(Task Spec): 태스크(입력, 환경, 테스트 스크립트)에 대해 상세하게 설명하는 자연어 설명으로, 태스크를 생성하는 데 사용될 수 있습니다.
*월드 사양(World Spec): 프로젝트별 정보, 스크립트, 헬퍼 함수 또는 기타 아티팩트로, 사양을 만드는 것을 돕거나 사양을 태스크로 변환하는 데 사용될 수 있습니다.
벤치마크 생성하기
에이전트를 신뢰성 있게 개선하려면 에이전트를 실행할 좋은 벤치마크가 필요합니다. 이는 회귀(regression)를 식별하고, 개선할 영역을 찾으며, 일반적으로 실제 메트릭을 기반으로 에이전트에 대해 반복 작업을 수행할 수 있도록 보장하는 데 도움이 됩니다.
좋은 벤치마크를 구축하는 것은 어렵습니다. 벤치마크의 각 태스크는 대표적인 입력값, 실제 세계와 밀접하게 일치하는 환경(environment), 그리고 결과를 채점할 수 있는 정렬된 루브릭(rubric)을 갖추어야 합니다. 단일 태스크 하나를 만드는 데도 많은 시간과 노력, 인간의 조정 작업이 필요하며, 하물며 전체 데이터셋은 더더욱 그렇습니다.
저희는 어떻게 하면 더 나은 평가(evals)를 만들 수 있을지 많이 고민해 왔으며, 대표적인 벤치마크를 보다 신뢰성 있고 효율적으로 생성할 수 있는 것이 그 핵심 부분입니다. 지난 몇 달 동안 저희는 이를 지원하기 위한 프로세스를 반복 개선해 왔습니다.
이상적인 최종 상태란 무엇인가?
저희가 목표로 하는 최종 상태는 고품질의 검증된 태스크 데이터셋입니다. 이 태스크들은 나중에 에이전트를 평가하거나, 언덕 오르기(hill-climb) 방식으로 개선하거나, 사후 훈련(post-train)하는 데 사용될 수 있습니다.
LangChain에서 내부적으로 생성하는 태스크의 예시는 다음과 같습니다:
- 회사 연구 및 고객 테이블 전반에 걸쳐 누락된 데이터와 항목에도 불구하고 개인을 찾는 것과 같은 GTM 엔지니어링 테스트 역량용 태스크
- 에이전트가 평가되는 프롬프트 최적화(prompt optimization)용 태스크
- 실제 병합된 PR(Pull Request)의 데이터를 사용하여 제공되는 코드 리뷰용 태스크
- 대규모 트레이스 데이터(trace data)에 소수의 이슈가 존재하는 경우를 위한 트레이스 마이닝(trace mining)용 태스크
태스크 생성 파이프라인
이러한 많은 수의 태스크를 생성하기 위해서는, 이러한 태스크들을 생산할 파이프라인을 구축하는 것이 가장 효율적이라는 것을 알게 되었습니다. 저희가 이 파이프라인을 만드는 핵심 요소라고 생각하는 것은 바로 '사양서(spec)'라는 개념입니다.
사양서는 자연어(natural language)로 해당 태스크(입력값, 환경, 채점자/grader)가 어떻게 생겼는지를 설명하는 마크다운 파일입니다. 구축하려는 데이터셋에 따라 필요한 섹션이나 정보가 다를 수 있습니다.
이러한 사양서 개념을 갖는 것의 이점은 다음 두 가지를 분리한다는 것입니다:
- 각 태스크가 어떤 모습이어야 하는지 파악하는 것
- 태스크를 구축하는 것
첫 번째 단계, 즉 “태스크가 어떤 모습이어야 하는지 파악하는 것”은 여러 방식으로 수행될 수 있으며, 팀과 사용자에게 중요한 것이 무엇인지 합의하기 위해 종종 인간의 반복적인 작업(iteration)이 필요합니다. 두 번째 단계인 “태스크를 구축하는 것”은 이상적으로 에이전트를 통해 더 자동화할 수 있습니다. 이러한 분리는 다양한 사양(spec)을 만들고, 인간 검토 과정을 그곳에 중앙 집중화하며, 이후 이를 병렬로 구축할 수 있도록 합니다.
사양(Spec)은 인간과 에이전트의 협업 및 편집에 좋은 매체입니다. 사람이 태스크의 원시 코드와 데이터를 검토하는 것보다 마크다운 사양을 검토하는 것이 훨씬 쉽습니다. 수정 사항은 코드처럼 버전 관리되고 추적될 수 있으며 팀 전체에서 공유될 수 있습니다.
전반적으로 이상적인 최종 상태는 두 단계로 구성된 파이프라인입니다:
- 사양(Spec) 생성 단계
- Spec2Task 생성 단계
세계 지식 조립하기 (Assembling world knowledge)
위의 두 단계를 잘 수행하려면, 만들고자 하는 일반 데이터셋에 대한 특정 정보를 수집해야 합니다. 우리는 이 정보를 “세계 지식(world knowledge)”이라고 부르며, 이는 “세계 사양(world spec)”에 존재합니다.
이 정보는 단일 태스크에 국한된 것이 아닙니다. 만약 그렇다면 태스크 사양에 존재할 것입니다. 오히려 이는 데이터셋의 모든 잠재적 태스크 전반에 걸친 일반 지식입니다 (즉, “세계”에 대한 지식).
이 지식은 다양한 형식(예: 마크다운 대 Python 스크립트)으로 존재하며 여러 방식으로 사용될 수 있습니다. 예를 들면:
-
세계 사양 생성 중
-
데이터의 크기/모양 등 저장하는 데 도움이 되는 정보에 대한 지침 및
-
트레이스(또는 다른 데이터)를 구문 분석하여 정보를 추출하기 위한 스크립트
-
사양에서 태스크 생성 중
-
이 태스크에 대해 좋은 루브릭을 만드는 방법 (예: 프로그래밍 방식 대 LLM-as-a-judge)
-
환경을 채우기 위해 특정 데이터를 생성하는 스크립트
다음은 당사 내부 벤치마크의 세계 지식 몇 가지 예시입니다:
다음은 당사 내부 벤치마크의 세계 지식 몇 가지 예시입니다:
-
프롬프트 최적화 벤치마크 (Prompt optimization benchmark):
- 사양(spec)에 미리 포함하는 것이 중요한 정보는 무엇인가요? (도메인, 입력 형태, 출력 클래스)
- 좋은 데이터셋을 생성하기 위한 프로세스와 스크립트
- 모든 사용 사례에 사용할 표준 점수 함수
-
GTM 에이전트 벤치마크 (GTM agent benchmark):
- 모킹(mock)해야 하는 특정 백엔드 서비스(Salesforce, Notion)를 위한 API 및 스키마
- 기존 에이전트 추적 기록에서 추출한 사용자들이 자주 묻는 질문들
세계 사양을 생성하는 것이 반복적인 과정인 이유 (Why generating a world spec is an iterative process)
사양(spec)을 생성하거나 사양을 작업으로 변환하려면 '세계 사양(world spec)'이 필요합니다. 이 세계 사양은 어떻게 얻고 유용하게 만들 수 있을까요?
저희는 이 사양을 얻는 가장 좋은 방법은 코딩 에이전트와 협력하여 첫 번째 작업을 생성하고, 그 작업이 과정에서 학습한 일반적인 세계 사양을 작성하도록 하는 것이라고 발견했습니다. 실제로, 세계 사양이 정말로 완전한지 확인하기 위해 처음 두세 개의 작업에 대해서도 이 과정을 수행하는 것을 고려해 볼 수 있습니다.
이를 돕기 위해 저희는 첫 번째 작업을 생성할 뿐만 아니라 그 프로세스를 세계 사양으로 일반화하는 데 도움이 되는 스킬(eval-engineering)을 만들었습니다.
코딩 에이전트는 eval-engineering 스킬을 사용하여 첫 번째 작업을 생성하고 이후 세계 사양을 구축할 때 실제로 어떤 일을 할까요?
코딩 에이전트는 서브에이전트(subagents)를 사용하여 레포지토리를 스캔하며, 에이전트가 상호작용하는 정확한 프롬프트, 도구, 스킬 등을 찾아냅니다.
- 트레이스(traces)를 그룹화하여 사용자들이 에이전트에게 어떤 작업을 요청하는지에 대한 실제 패턴을 찾습니다. 이 그룹들은 잠재적인 작업 유형에 대해 브레인스토밍하는 데 유용합니다.
- 에이전트를 실행하는 데 필요한 자격 증명(credentials)을 매핑합니다. 에이전트가 웹 검색과 같은 API를 통해 라이브 도구를 호출하나요? 이러한 동작을 시뮬레이션해야 할까요, 아니면 작업(Task) 중에 실제로 호출해야 할까요?
- 에이전트가 상호작용하는 모든 서비스와 그 데이터 스키마를 카탈로그화합니다. 에이전트가 상호작용하는 테이블과 스키마를 포함하여 SalesForce나 Gong 같은 시스템들이 해당됩니다.
- 데이터 내의 관계/계층 구조(relationships/hierarchies)를 찾고, 입력 데이터 유형에 따라 합성 데이터 생성(synthetic data generation)을 위한 좋은 접근 방식을 계획합니다.
이러한 지식의 상당 부분은 사용자가 작업을 만들려고 하는 에이전트나 도메인에 특화되어 있습니다. 세계 사양(world spec)을 만드는 핵심 부분은 사용자 피드백을 반복적으로 수집하는 것이기 때문에, 첫 번째 작업을 생성함과 동시에 이 세계 사양을 만드는 것이 매우 유용합니다.
작업 사양(Task Spec)에는 무엇이 포함되나요
단일 작업을 생성하는 과정은 해당 작업에 특화된 모든 구현 세부 사항을 작성해야 하지만, 전반적인 세계 지식(world knowledge)에 의해 정보가 제공됩니다. 우리가 일반적으로 만드는 사양은 다음 세 가지 부분을 다루어야 합니다:
- 에이전트 환경의 모습
- 입력되어야 하는 것들
- 출력물이 점수화되는 방식
이 중 일부는 선택 사항일 수 있습니다. 만약 모든 작업에 동일하고 '세계 사양(world spec)'으로 다룰 수 있다면 말입니다. 예를 들어:
- 일반적인 QA 챗봇의 경우, 환경은 항상 같을 수 있습니다 (변하는 것은 입력/출력만입니다). 이 경우, 환경 정보는 '세계 사양(world spec)'에 통합되어 작업 전반에 걸쳐 공유될 수 있습니다.
- GTM 리서치 작업의 경우, 입력은 고정적일 수 있습니다 ('세계 사양(world spec)'에서 지정되고) 하지만 환경과 따라서 채점 기준표(rubric to grade)는 작업 사양(task spec)의 일부가 됩니다.
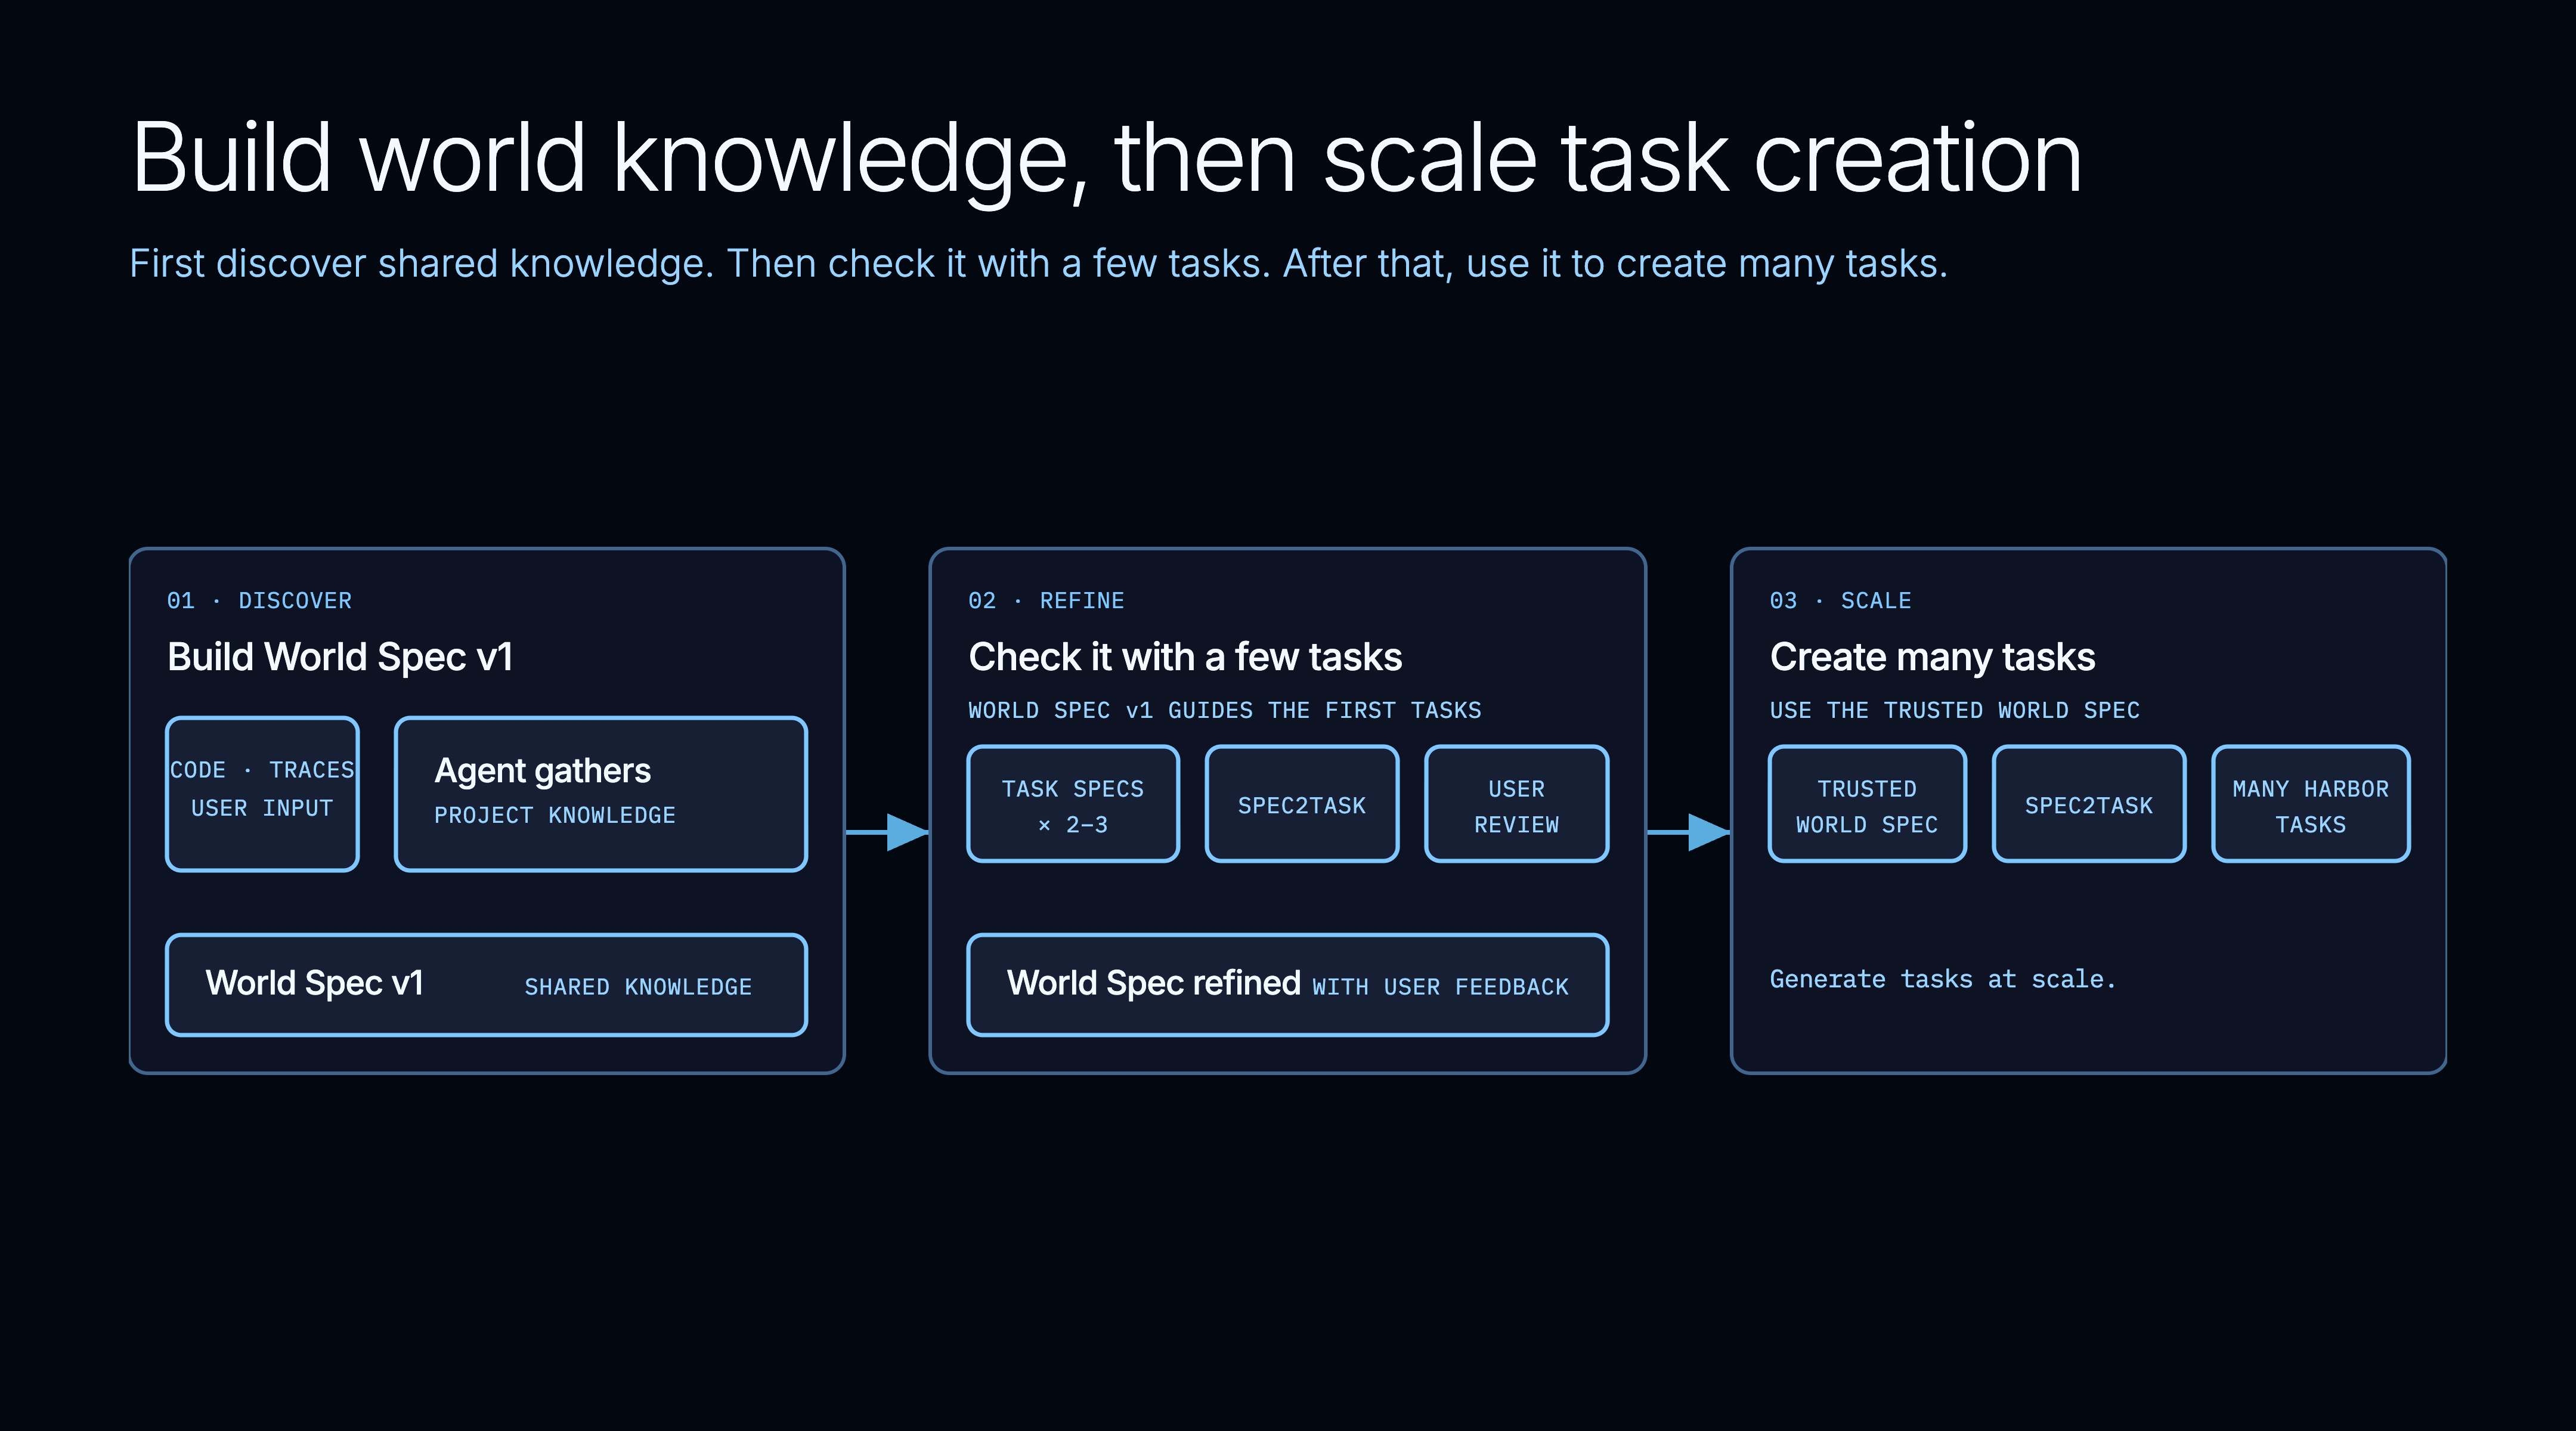
Spec2Task
Spec2Task
Spec-to-task는 사양(spec)을 받아 Harbor 형식의 태스크를 생성하는 파이프라인입니다. 이는 코딩 에이전트(coding agent)를 사용하여 가장 쉽게 수행할 수 있습니다. 이 과정에서 에이전트에게 태스크 사양(task specs), 태스크 생성에 대한 특정 지식을 포함한 “월드 사양(world spec)” 스킬, 그리고 Harbor 형식으로 태스크를 만드는 방법에 대한 일부 안내가 담긴 eval-engineering 스킬을 전달할 수 있습니다.
좋은 Spec2Task를 만드는 과정에서 발견한 몇 가지 학습 사항:
- 파이프라인이 실제 에이전트로 태스크를 실행하고 트랙젝토리(trajectories)를 읽게 하여 태스크를 정제하도록 하십시오. 이는 지나치게 구체적인 지침이나 누수되는 추상화(leaky abstractions)와 같은 환경 설계의 결함을 찾는 데 도움이 됩니다. 예: “Placeholder에 답하기”라고 적힌 부실한 표 항목.
- 태스크의 난이도는 파이프라인이 다양한 티어 모델(예: gpt-5.6-Luna 대 gpt-5.6-Sol)로 각 태스크를 실행하게 함으로써 보정할 수 있습니다. 이는 특정 티어의 모델에게 태스크가 너무 쉽거나 너무 어렵다는 피드백을 제공하거나, 리워드 해킹(reward hack) 때문에 더 강력한 모델에게 태스크가 망가졌는지 여부를 알려줍니다.
- 에이전트는 다양한 유형의 데이터를 생성하는 데 어떤 방법을 사용해야 하는지 아는 데 취약합니다. 따라서 텍스트 데이터에는 루브릭을 사용하는 LLM(대규모 언어 모델)을 사용하고, 표 형식 데이터에는 sqlite와 지정된 스키마를 사용하는 스크립트를 사용한다는 등의 전반적인 안내를 제공합니다.
End to end 프로세스
-
eval-engineering을 사용하여 첫 번째 태스크를 생성합니다.
-
eval-engineering 스킬이 로드되었는지 확인합니다.
-
예시 프롬프트: “
{LangSmith project}의 트레이스와{current repository}를 활용하여{agent}를 위한 평가 태스크(eval Task)를 만드는 데 도움을 주세요.” - 이 과정에는 여러 차례의 상호 작용이 포함되며, 월드 사양에 대한 별도의 스킬을 생성하고 (사용자에게 표시한 후), 합의가 이루어지면 태스크를 생성합니다. -
월드 사양 스킬을 검토하고 필요한 조정 사항을 만듭니다.
-
예시 프롬프트:
{world spec - 삽입된 이름}스킬을 검토해 주시고, 제가 검토할 수 있도록 이것이 담고 있는 핵심 부분을 알려주세요. -
예시 프롬프트: 다음을 검토해 주세요.
-
“world spec”과 eval-engineering을 사용하여 두 번째 태스크를 만드세요.
-
world spec 스킬을 적절하게 검증할 수 있도록 스레드를 전환하세요. world spec 스킬과 eval engineering 스킬이 모두 로드되었는지 확인하세요.
-
예시 프롬프트: “
{world spec}
스킬을 사용하여 새로운 태스크를 만드세요. 이 태스크는…” - 여기에는 여러 차례의 상호 작용이 필요하며,{world spec}스킬을 업데이트할 것입니다. -
2단계를 반복하세요.
-
**예시 프롬프트: “**이 태스크의 고객들이 너무 비슷해 보여요. 다양한 수익액, 총 직원 수, 발송된 이메일 수 등을 가진 더 크고 작은 고객들로 고객 세트를 확장해 주세요.”
-
확신할 때까지 3~4단계를 반복하세요.
-
“world spec”을 가진 코딩 에이전트와 함께 이 과정을 스케일업하여 여러 트레이스(traces)를 보고 스펙을 생성하게 하세요.
-
예시 프롬프트: “
{world spec}
을 사용하여 제가 검토할 10개의 새롭고 다른 태스크 스펙을 만드세요. 지난 10일간의 트레이스를 사용해서 현재 우리의 태스크에서 포착하지 못하고 있는 새로운 패턴들을 찾아주세요.” -
예시 프롬프트: “
{world spec}
과{task spec X}를 사용하여 새 태스크를 만드세요.” -
**예시 프롬프트: “**사용자 판단이 여전히 필요한 영역
eval-engineering 스킬은 에이전트 환경을 구축하기 위한 일반적인 프레임워크를 제공하지만, 이 과정은 완전히 자율적이지 않습니다. 에이전트는 두 가지 영역에서 여전히 인간의 지도가 필요합니다.
첫째, 스펙을 다듬는 작업은 종종 여러 차례의 피드백을 필요로 합니다. 에이전트는 특정 스펙이 실제 도메인, 사용자 행동 및 태스크 요구 사항을 정확하게 반영하는지 판단하는 데 도움이 필요합니다.
둘째, 에이전트는 너무 쉬운 태스크를 만드는 경향이 있습니다. 이는 환경이 작동하는지 검증하는 데 도움을 주지만, 유용한 벤치마크에는 다양한 난이도의 태스크가 필요합니다. 이러한 난이도를 조정하려면 일반적으로 각 태스크를 여러 번 실행하고, 트래젝토리(trajectories)를 검토하며, 에이전트에게 태스크를 더 쉽게 또는 더 어렵게 만들도록 요청해야 합니다.
환경 구축은 에이전트를 개선하는 지속적인 과정입니다
AI 자동 생성 콘텐츠
본 콘텐츠는 LangChain Blog의 원문을 AI가 자동으로 요약·번역·분석한 것입니다. 원 저작권은 원저작자에게 있으며, 정확한 내용은 반드시 원문을 확인해 주세요.
원문 바로가기