CodeShell VSCode Extension
English readme
codeshell-vscode 프로젝트는 CodeShell 대규모 모델을 기반으로 개발된, Visual Studio Code를 지원하는 지능형 코딩 어시스턴트 플러그인입니다. Python, Java, C++/C, JavaScript, Go 등 다양한 프로그래밍 언어를 지원하며, 코드 자동 완성, 코드 설명, 코드 최적화, 주석 생성, 대화 질의응답 등의 기능을 개발자에게 제공하여 지능화된 방식으로 개발자의 코딩 효율성을 높이는 것을 목표로 합니다.
환경 요구 사항
플러그인 컴파일
소스 코드로부터 패키징하려면, node v18 이상의 버전을 설치하고 다음 명령을 실행해야 합니다:
git clone https://github.com/WisdomShell/codeshell-vscode.git
cd codeshell-vscode
npm install
...
이후 codeshell-vscode-${VERSION_NAME}.vsix라는 파일이 생성됩니다.
모델 서비스
llama_cpp_for_codeshell 프로젝트는 CodeShell 대규모 모델의 4비트 양자화된 모델을 제공하며, 모델 이름은 codeshell-chat-q4_0.gguf입니다. 모델 서비스 배포 단계는 다음과 같습니다:
코드 컴파일
git clone https://github.com/WisdomShell/llama_cpp_for_codeshell.git
cd llama_cpp_for_codeshell
make
macOS에서는 기본적으로 Metal이 활성화되어 있습니다. Metal을 활성화하면 모델을 GPU에 로드하여 실행할 수 있으므로 성능이 크게 향상됩니다.

+ Mac(Apple Silicon이 아닌 장치)

  ```bash
git clone https://github.com/WisdomShell/llama_cpp_for_codeshell.git
cd llama_cpp_for_codeshell
LLAMA_NO_METAL=1 make
Apple Silicon이 아닌 Mac 사용자의 경우, 컴파일 시 LLAMA_NO_METAL=1 또는 LLAMA_METAL=OFF의 CMake 옵션을 사용하여 Metal 빌드를 비활성화할 수 있으며, 이를 통해 모델을 정상적으로 실행할 수 있습니다.
모델 다운로드
Hugging Face Hub에서 CodeShell-7B, CodeShell-7B-Chat, CodeShell-7B-Chat-int4 세 가지 다른 모델을 제공합니다. 다음은 모델을 다운로드하는 단계입니다.
git clone https://huggingface.co/WisdomShell/CodeShell-7B-Chat-int4/blob/main/codeshell-chat-q4_0.gguf
git clone https://huggingface.co/WisdomShell/CodeShell-7B-Chat
git clone https://huggingface.co/WisdomShell/CodeShell-7B
모델 로드 (Loading Model)
CodeShell-7B-Chat-int4 모델은 llama_cpp_for_codeshell 프로젝트의 server 명령을 사용하여 API 서비스를 제공할 수 있습니다.
./server -m ./models/codeshell-chat-q4_0.gguf --host 127.0.0.1 --port 8080
주의: 컴파일 시 Metal을 활성화한 경우, 실행 시 예외가 발생할 수 있습니다. 이 경우 명령줄에 -ngl 0 매개변수를 추가하여 Metal GPU 추론을 명시적으로 비활성화하면 모델이 정상적으로 작동합니다.
모델 서비스 (Model Service)[NVIDIA GPU]
NVIDIA GPU를 사용하여 추론하려는 사용자는 text-generation-inference 프로젝트를 사용하여 CodeShell 대규모 모델을 배포할 수 있습니다. 다음은 모델 서비스 배포 단계입니다:
모델 다운로드 (Download Model)
Hugging Face Hub에서 모델을 로컬로 다운로드한 후, 해당 모델을 $HOME/models 폴더 경로에 배치하면 로컬에서 모델을 로드할 수 있습니다.
git clone https://huggingface.co/WisdomShell/CodeShell-7B-Chat
모델 배포 (Deploy Model)
다음 명령어를 사용하여 text-generation-inference로 GPU 가속 추론을 배포할 수 있습니다:
docker run --gpus 'all' --shm-size 1g -p 9090:80 -v $HOME/models:/data \
--env LOG_LEVEL=
VSCode에서 `Install from VSIX...` 명령을 실행하고, `codeshell-vscode-${VERSION_NAME}.vsix`를 선택하여 플러그인을 설치합니다.
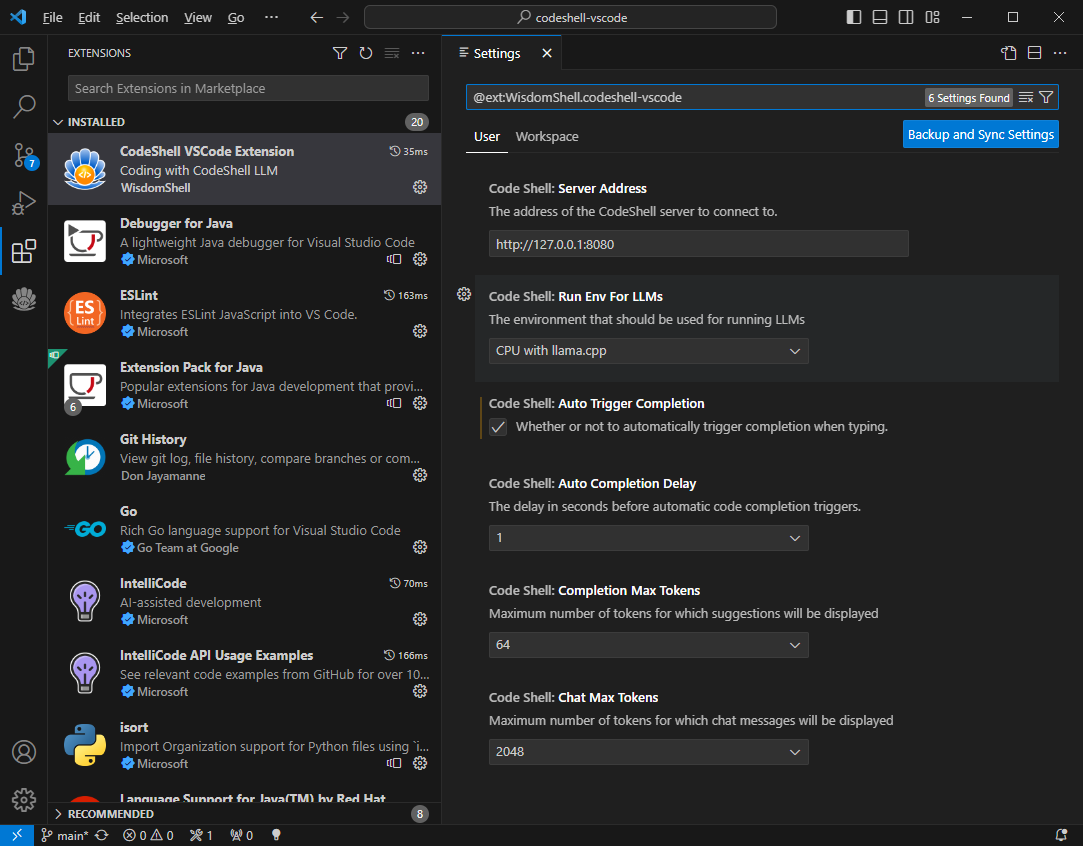
- CodeShell 대규모 언어 모델(LLM) 서비스 주소 설정
- 코드 자동 완성 제안 트리거 여부 구성
- 코드 자동 완성 제안의 시간 지연(Delay) 구성
- 최대 토큰 수(tokens) 구성 (완성)
- 최대 토큰 수(tokens) 구성 (질의응답)
- 모델 실행 환경 구성
주의: 다양한 모델 실행 환경은 플러그인 내에서 설정할 수 있습니다. [CodeShell-7B-Chat-int4](https://huggingface.co/WisdomShell/CodeShell-7B-Chat-int4) 모델의 경우, `Code Shell: Run Env For LLMs` 옵션에서 `CPU with llama.cpp`를 선택할 수 있습니다. 반면, [CodeShell-7B](https://huggingface.co/WisdomShell/CodeShell-7B) 및 [CodeShell-7B-Chat](https://huggingface.co/WisdomShell/CodeShell-7B-Chat) 모델의 경우, `GPU with TGI toolkit` 옵션을 선택해야 합니다.
- 자동 트리거되는 코드 제안
- 단축키를 이용한 코드 제안 트리거
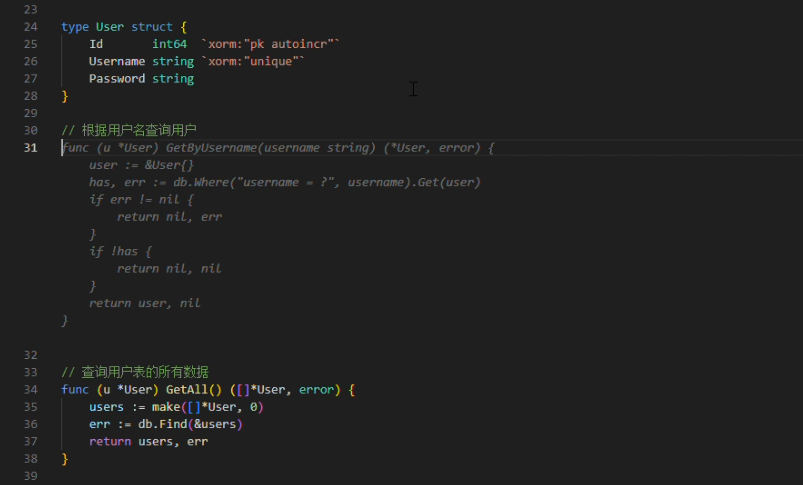
코딩 과정 중 입력을 멈추면, 코드 자동 완성 제안이 자동으로 트리거될 수 있습니다(설정 옵션 `Auto Completion Delay`에서 1~3초로 설정 가능). 또는 단축키 `Alt+\` (Windows용) 또는 `option+\` (Mac용)를 사용하여 능동적으로 코드 자동 완성 제안을 트리거할 수도 있습니다.
플러그인이 코드 제안을 제공하면, 해당 내용은 편집기 커서 위치에 회색으로 표시되며, Tab 키를 눌러 제안을 수락하거나 계속 입력하여 제안을 무시할 수 있습니다.
- 코드 설명/최적화/정리
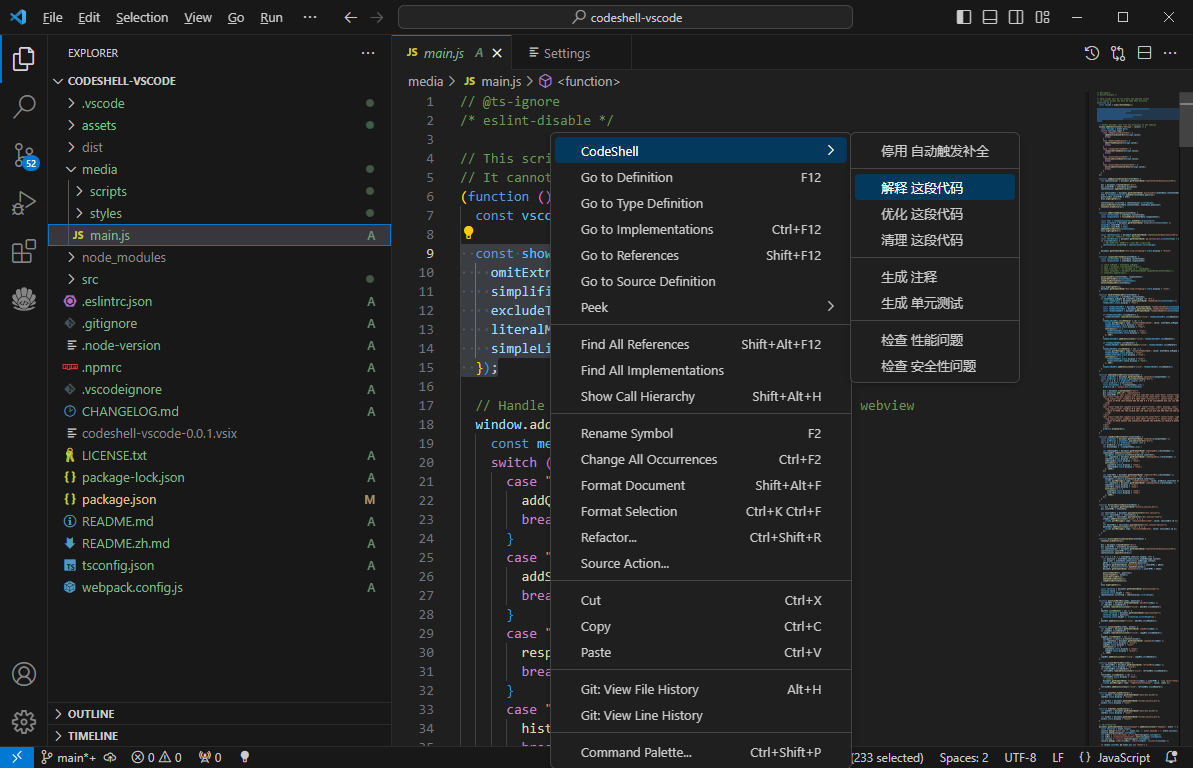
- 코드 주석/단위 테스트 생성
- 코드의 성능/보안 문제 검사
VSCode 사이드바에서 플러그인 질의응답 인터페이스를 열고, 편집기에서 코드를 선택한 후, 마우스 오른쪽 버튼을 클릭하여 CodeShell 메뉴에서 해당 기능 항목을 선택하면, 플러그인이 질의응답 인터페이스에 상응하는 답변을 제공합니다.
- 다중 라운드 대화 지원
- 세션 기록 지원
- 이전 대화를 기반으로 한 다중 라운드 대화
- 질문 편집 및 재질문 가능
- 모든 질문에 대해 답변을 다시 받을 수 있음
- 답변 과정 중 중단 가능
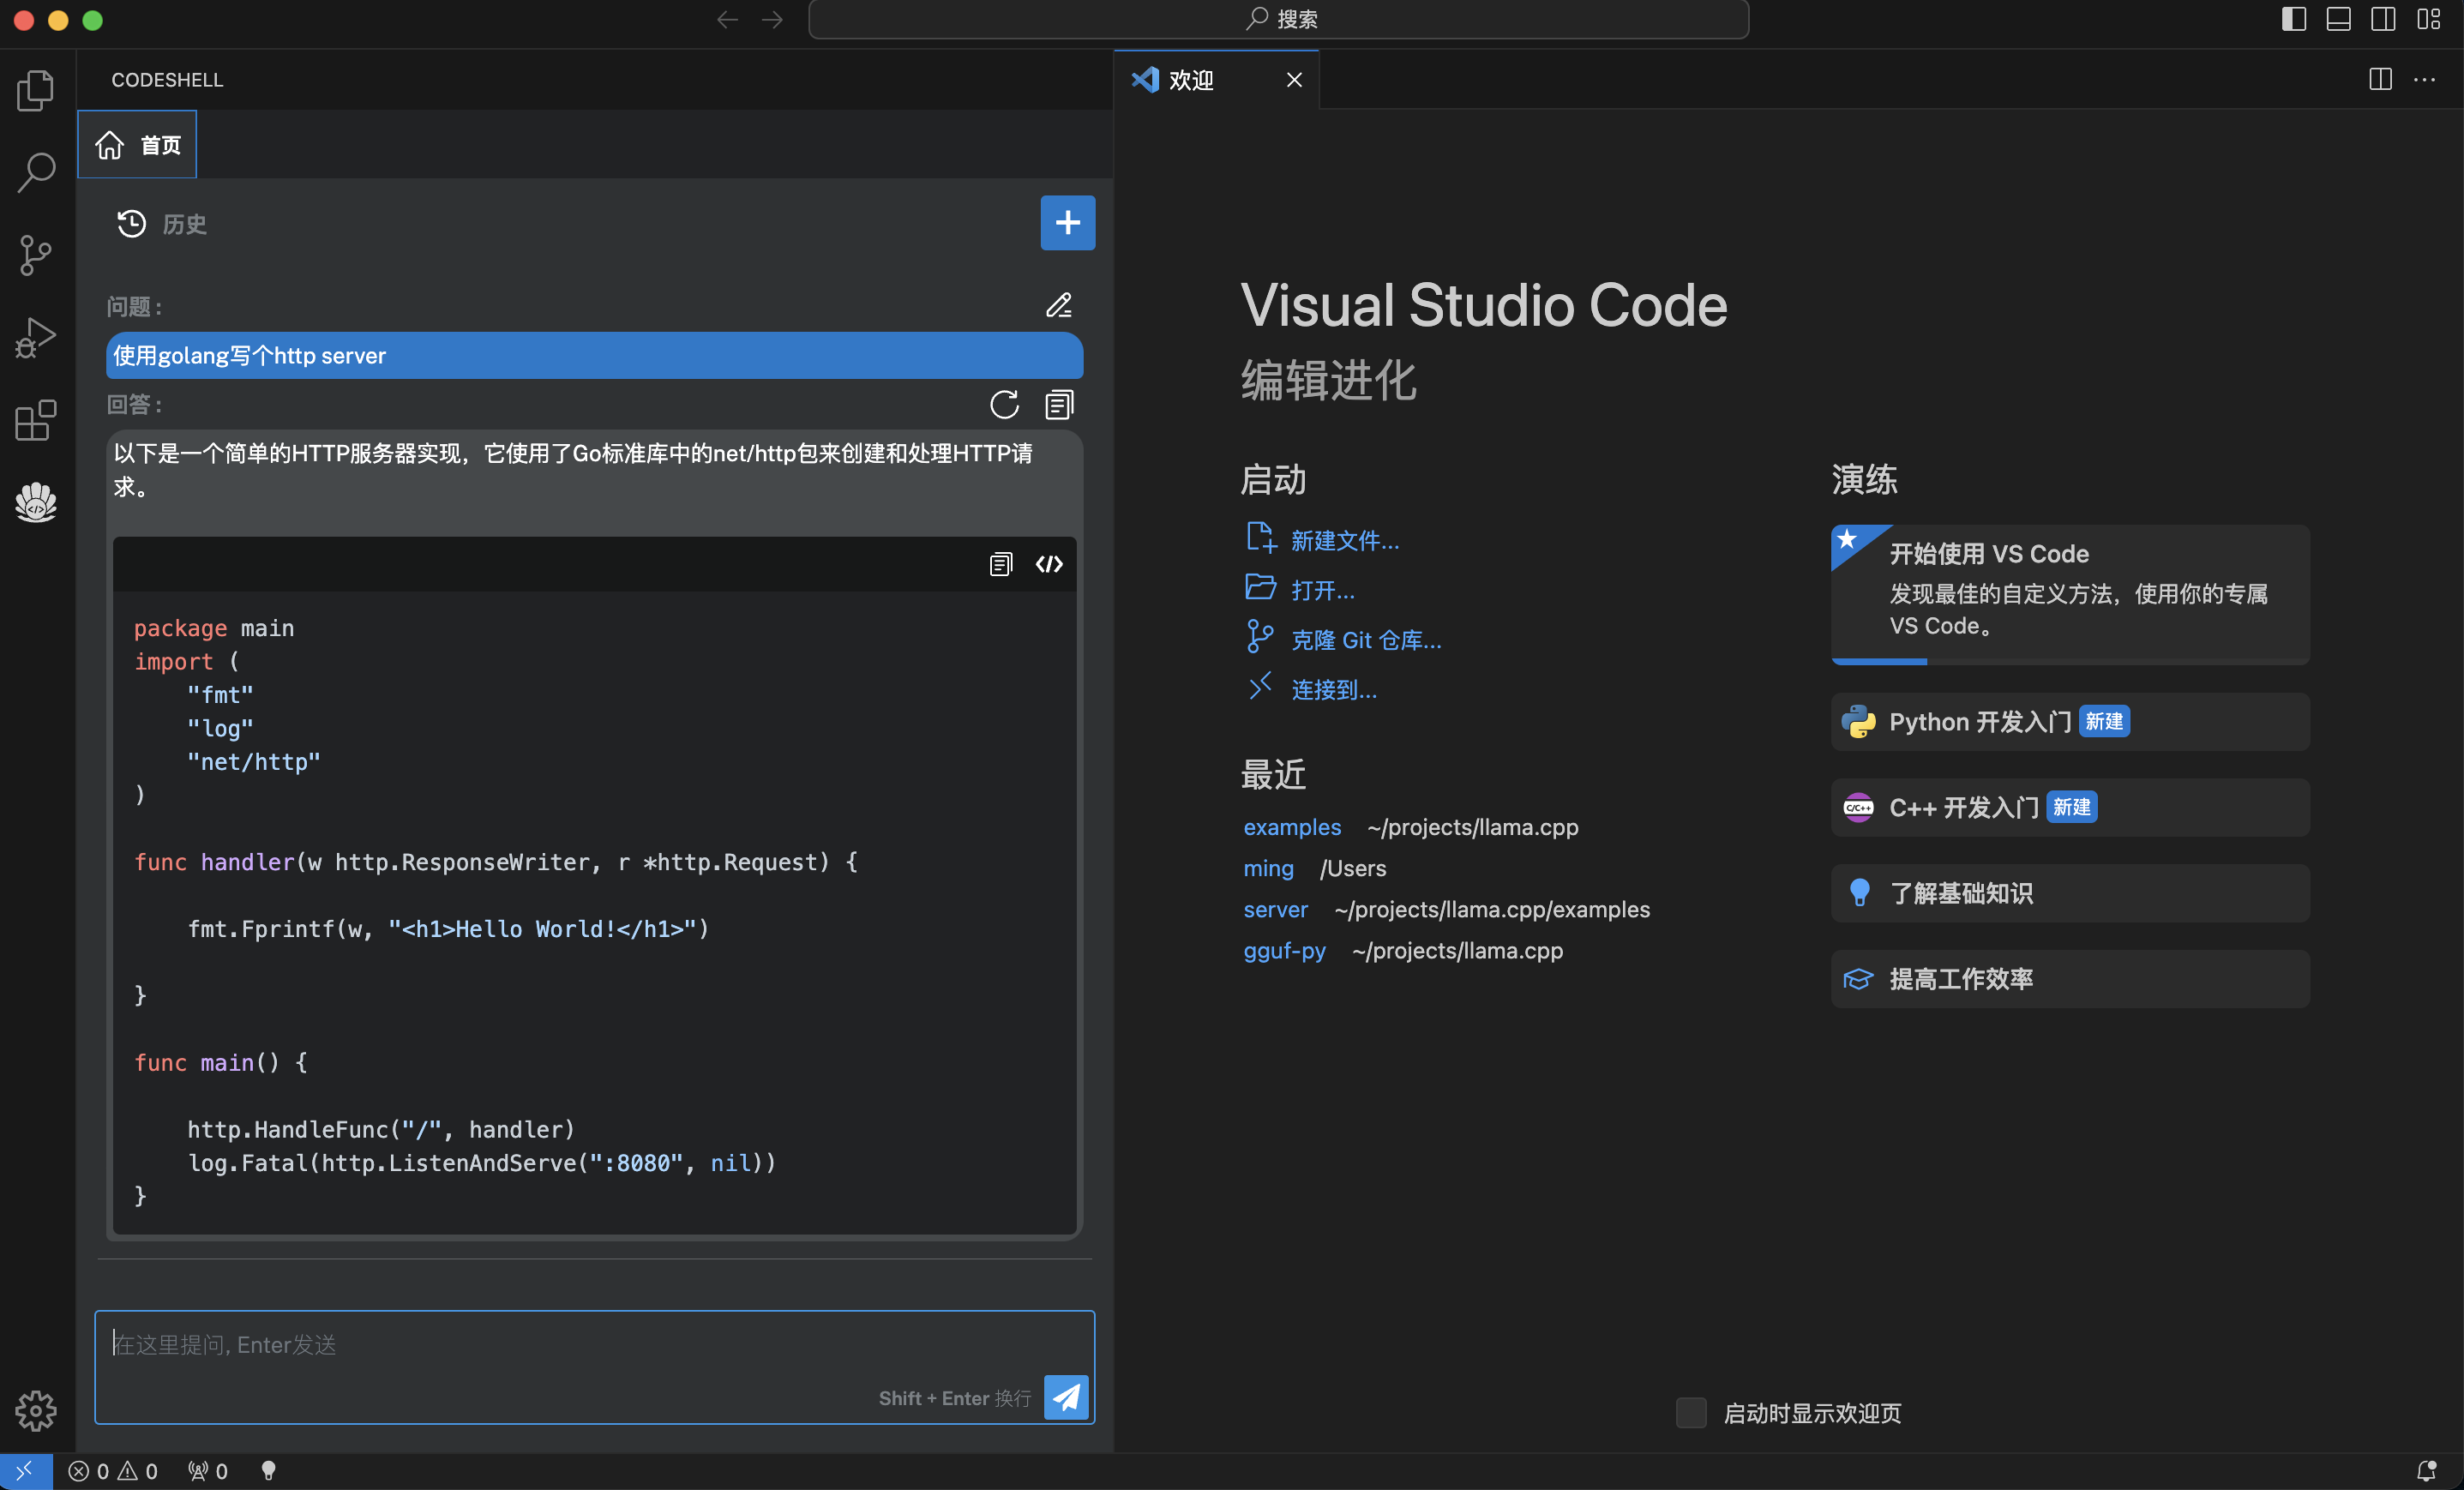
질의응답 인터페이스의 코드 블록에서는 복사 버튼을 클릭하여 해당 코드 블록을 복사할 수 있으며, 붙여넣기(Insert) 버튼을 클릭하면 해당 코드 블록 내용이 편집기 커서 위치에 삽입됩니다.
Apache 2.0
[](https://star-history.com/#WisdomShell/codeshell-vscode&Date)
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60