CleanRL (Clean Implementation of RL Algorithms)
<img src="https://img.shields.io/badge/license-MIT-blue">
tests
docs
<img src="https://img.shields.io/discord/767863440248143916?label=discord">
<img src="https://img.shields.io/youtube/channel/views/UCDdC6BIFRI0jvcwuhi3aI6w?style=social">
Code style: black
Imports: isort
<img src="https://img.shields.io/badge/%F0%9F%A4%97%20Models-Huggingface-F8D521">
Open In Colab
CleanRL은 연구 친화적인 기능을 갖춘 고품질의 단일 파일 구현을 제공하는 Deep Reinforcement Learning 라이브러리입니다. 이 구현체는 깔끔하고 단순하지만, AWS Batch를 사용하여 수천 개의 실험을 실행할 만큼 확장 가능합니다. CleanRL의 주요 특징은 다음과 같습니다:
- 📜 단일 파일 구현 (Single-file implementation)
- 알고리즘 변형에 대한 모든 세부 사항이 하나의 독립적인 파일에 담겨 있습니다.
- 예를 들어, 저희
ppo_atari.py는 코드 라인이 340줄에 불과하지만, Atari 게임에서 PPO가 작동하는 방식에 대한 모든 구현 세부 사항을 포함하고 있어, 전체 모듈식 라이브러리를 읽고 싶지 않은 분들에게 훌륭한 참고 구현체입니다.
- 📊 벤치마크 구현 (https://benchmark.cleanrl.dev에서 7개 이상의 알고리즘 및 34개 이상의 게임)
- 📈 Tensorboard 로깅
- 🪛 시딩(Seeding)을 통한 로컬 재현성 (Local Reproducibility)
- 🎮 게임 플레이 녹화 비디오
- 🧫 Weights and Biases를 사용한 실험 관리
- 💸 docker 및 AWS를 이용한 클라우드 통합
CleanRL에 대한 더 자세한 내용은 저희 JMLR 논문과 문서(documentation)에서 읽어보실 수 있습니다.
주목할 만한 CleanRL 관련 프로젝트:
ℹ️ Gymnasium 지원: Farama-Foundation/Gymnasium는 openai/gym의 차세대 버전으로, 지속적으로 유지보수되고 새로운 기능이 추가될 예정입니다. 자세한 내용은 공지(announcement)를 참조하십시오. 저희는 gymnasium으로 마이그레이션하고 있으며, 진행 상황은 vwxyzjn/cleanrl#277에서 추적할 수 있습니다.
⚠️ 참고: CleanRL은 모듈형 라이브러리(modular library)가 아니므로 임포트하여 사용하도록 만들어지지 않았습니다. 중복 코드가 발생하는 단점을 감수하고, DRL 알고리즘 변형의 모든 구현 세부 사항을 이해하기 쉽게 만들었기 때문에 CleanRL은 고유한 장단점을 가집니다. 따라서 1) 알고리즘 변형의 모든 구현 세부 사항을 이해하고 싶거나 또는 2) 다른 모듈형 DRL 라이브러리가 지원하지 않는 고급 기능을 프로토타이핑하려는 경우에 CleanRL 사용을 고려해야 합니다 (CleanRL은 코드 라인 수가 최소화되어 있어 디버깅 경험이 뛰어나며, 때때로 모듈형 DRL 라이브러리에서 필요한 많은 서브클래싱(subclassing) 작업을 할 필요가 없습니다).
시작하기
사전 요구 사항:
로컬에서 실험을 실행하려면 다음을 시도해 보세요:
git clone https://github.com/vwxyzjn/cleanrl.git && cd cleanrl
uv pip install .

...
wandb를 사용하여 실험 추적(experiment tracking)을 사용하려면 다음을 실행하세요:
wandb login
uv run python cleanrl/ppo.py \
--seed 1 \
...
uv를 사용하지 않는 경우, requirements.txt로 CleanRL을 설치할 수 있습니다:
pip install -r requirements/requirements.txt
...
다른 게임에서 학습 스크립트를 실행하려면:
uv venv

# classic control
...
Gitpod에 호스팅된 사전 구축 개발 환경을 사용할 수도 있습니다:
Open in Gitpod
구현된 알고리즘
| | ppo_atari_multigpu.py, 문서 |
| | ppo_pettingzoo_ma_atari.py, 문서 |
| | ppo_continuous_action_isaacgym.py, 문서 |
| | ppo_trxl.py, 문서 |
| ✅ Deep Q-Learning (DQN) | dqn.py, 문서 |
| | dqn_atari.py, 문서 |
| | dqn_jax.py, 문서 |
| ...
|| | ddpg_continuous_action_jax.py, docs |
| ✅ Twin Delayed Deep Deterministic Policy Gradient (TD3) | td3_continuous_action.py, docs |
| | td3_continuous_action_jax.py, docs |
| ✅ Phasic Policy Gradient (PPG) | ppg_procgen.py, docs |
| ... |
Open RL Benchmark
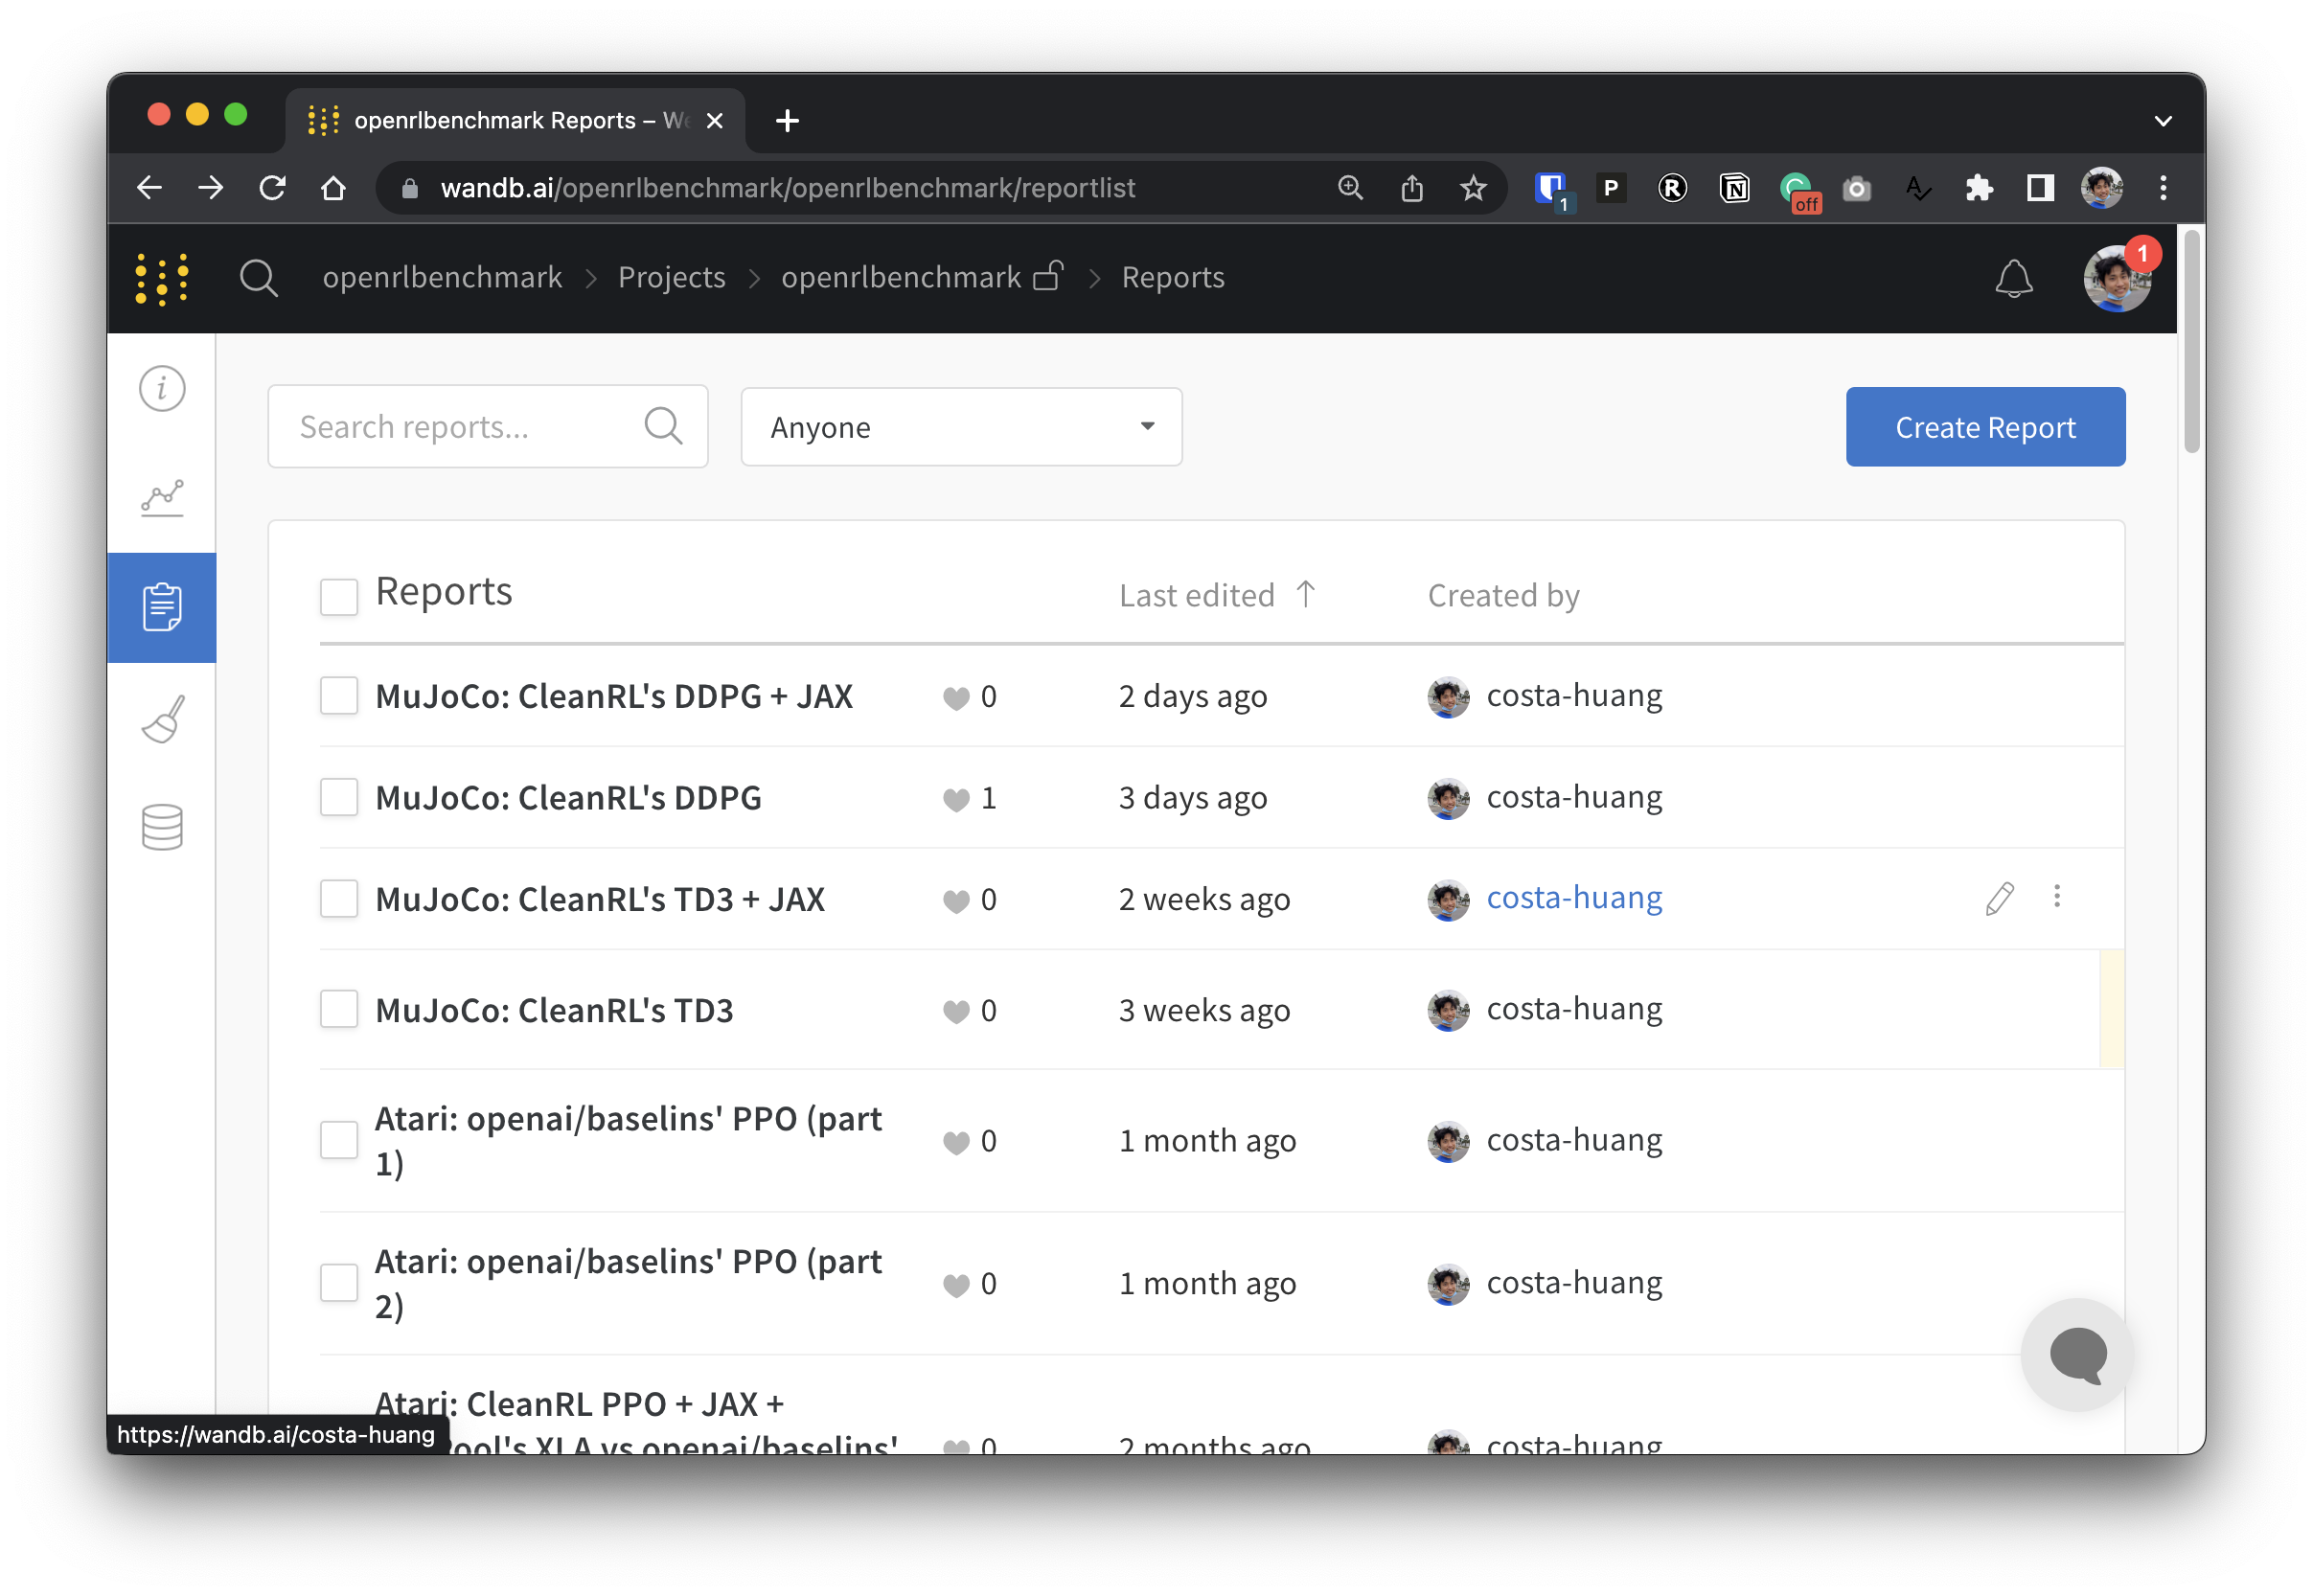
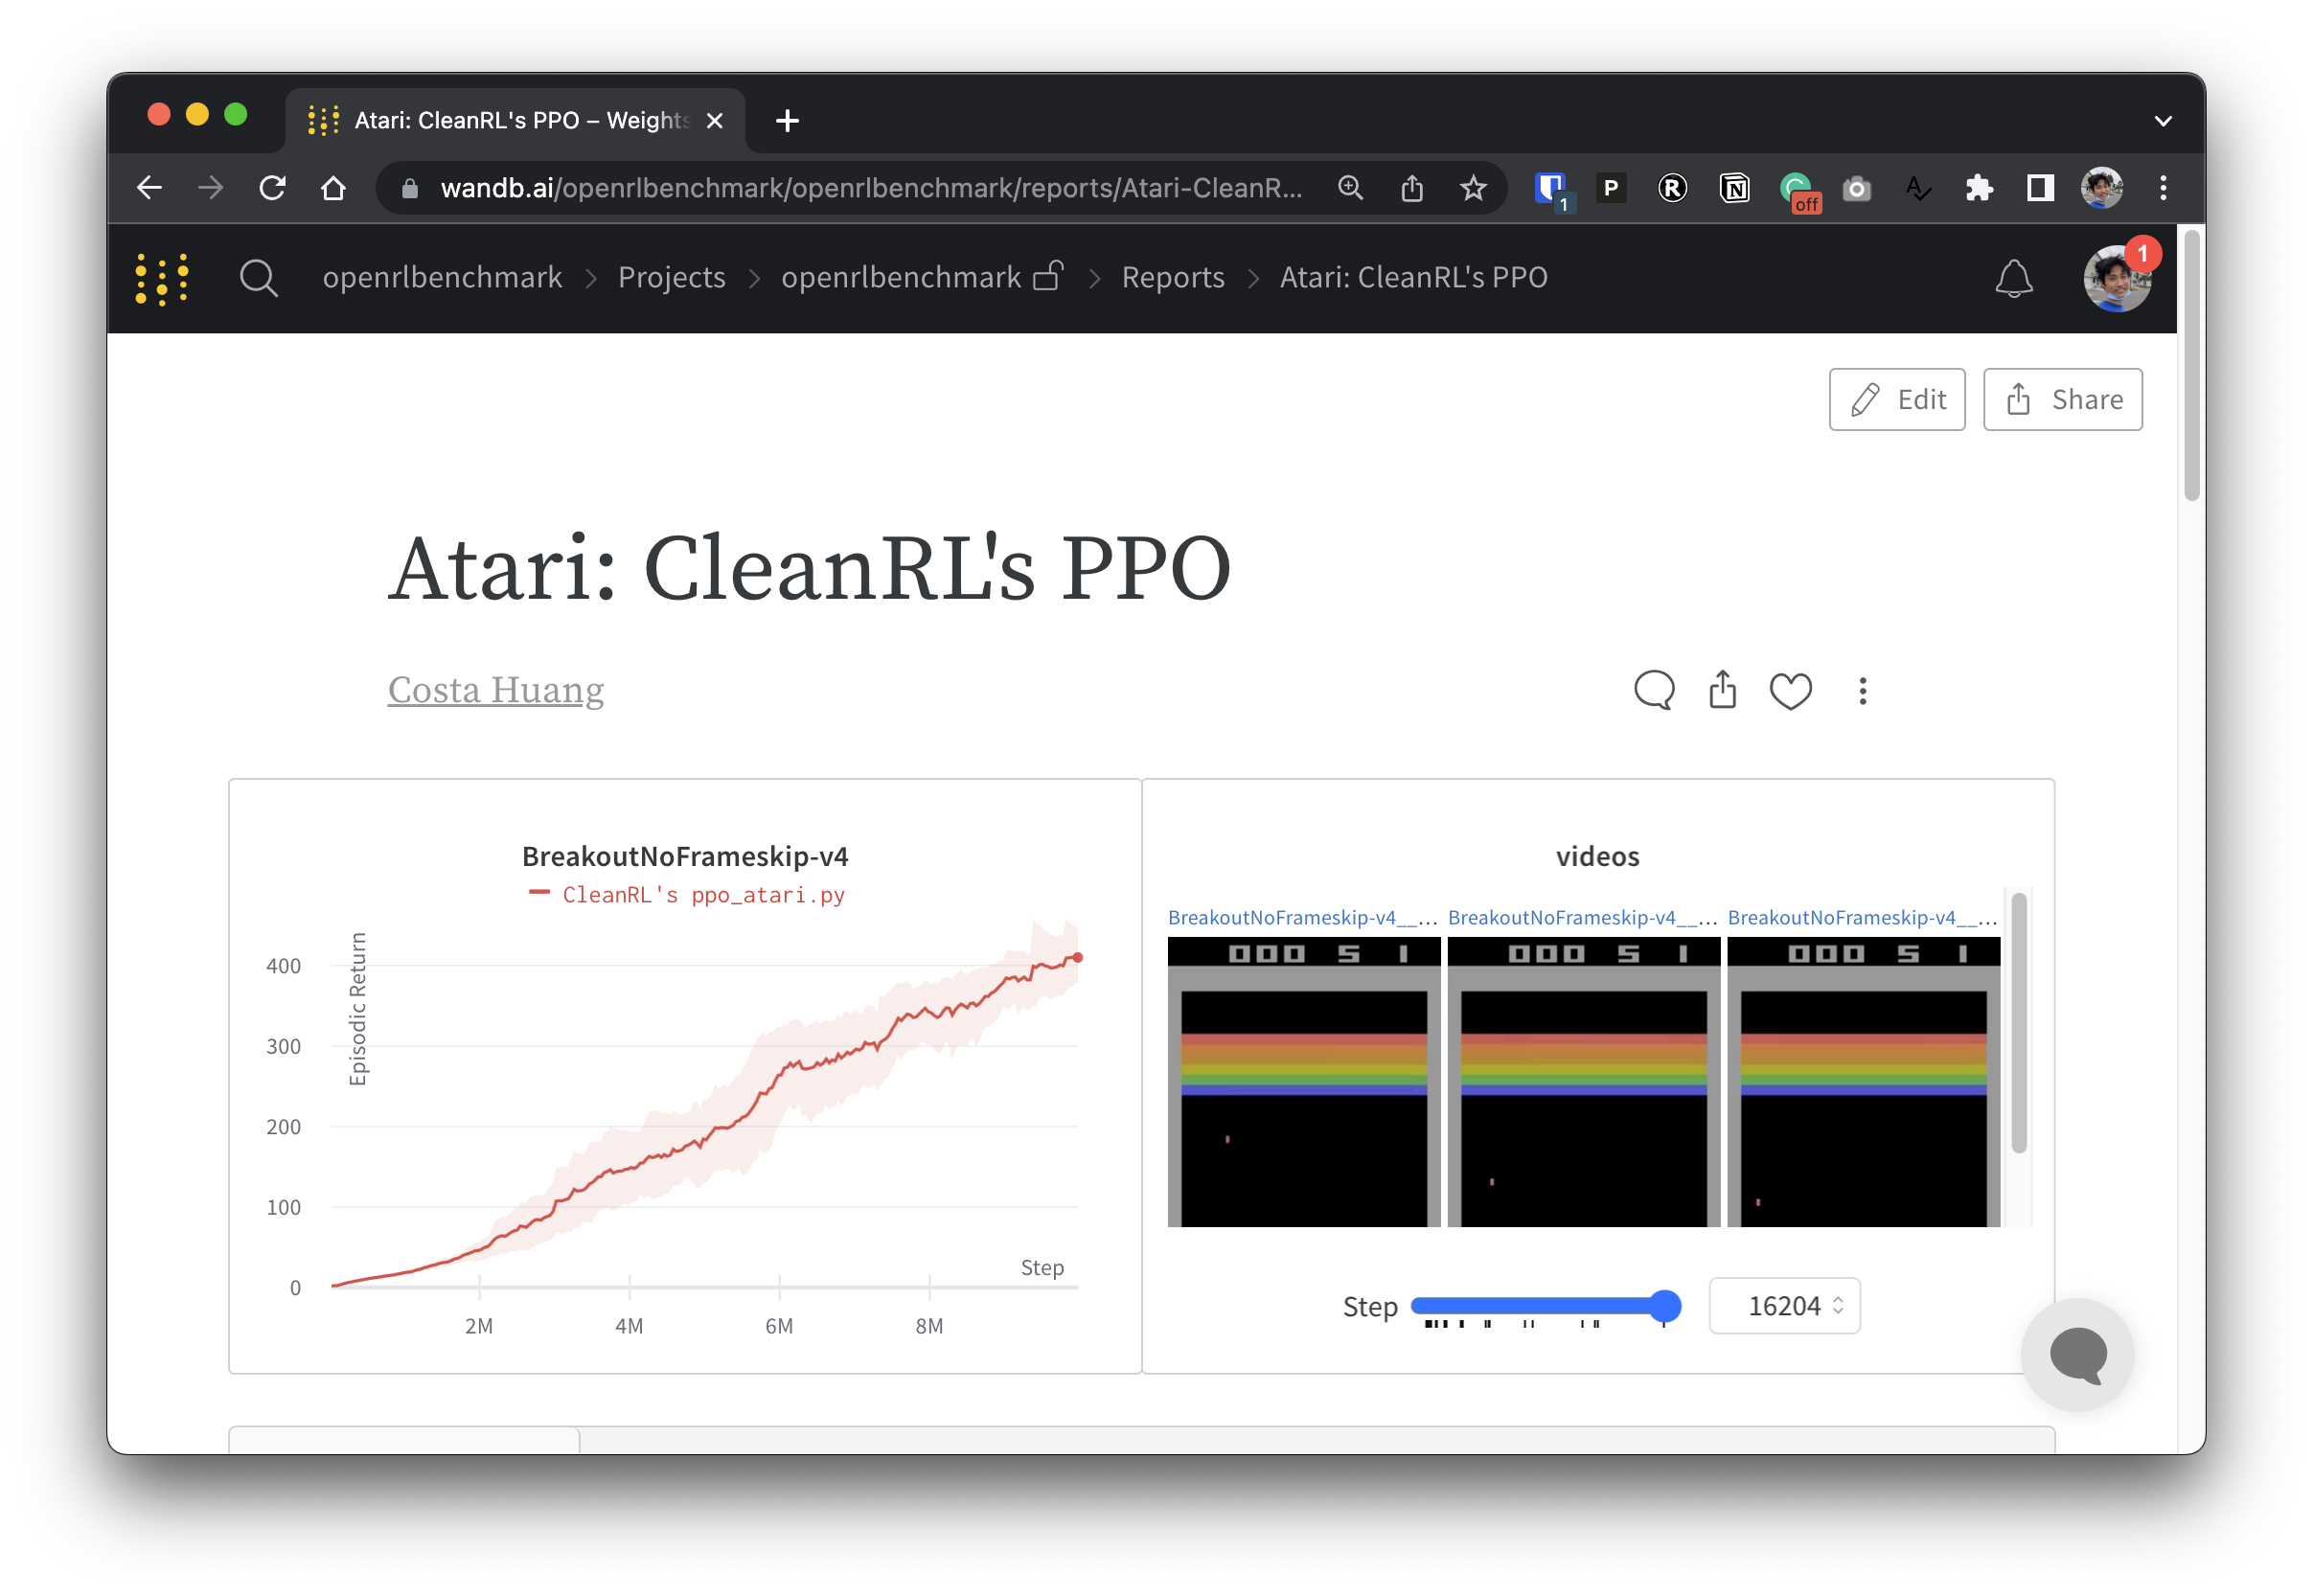
실험 데이터의 투명성을 확보하기 위해 CleanRL은 Open RL Benchmark라는 관련 프로젝트에 참여하고 있습니다. 이 프로젝트에는 저희와 같은 Stable-baselines3, openai/baselines, jaxrl 등 인기 있는 DRL 라이브러리들의 추적된 실험 결과가 포함되어 있습니다.
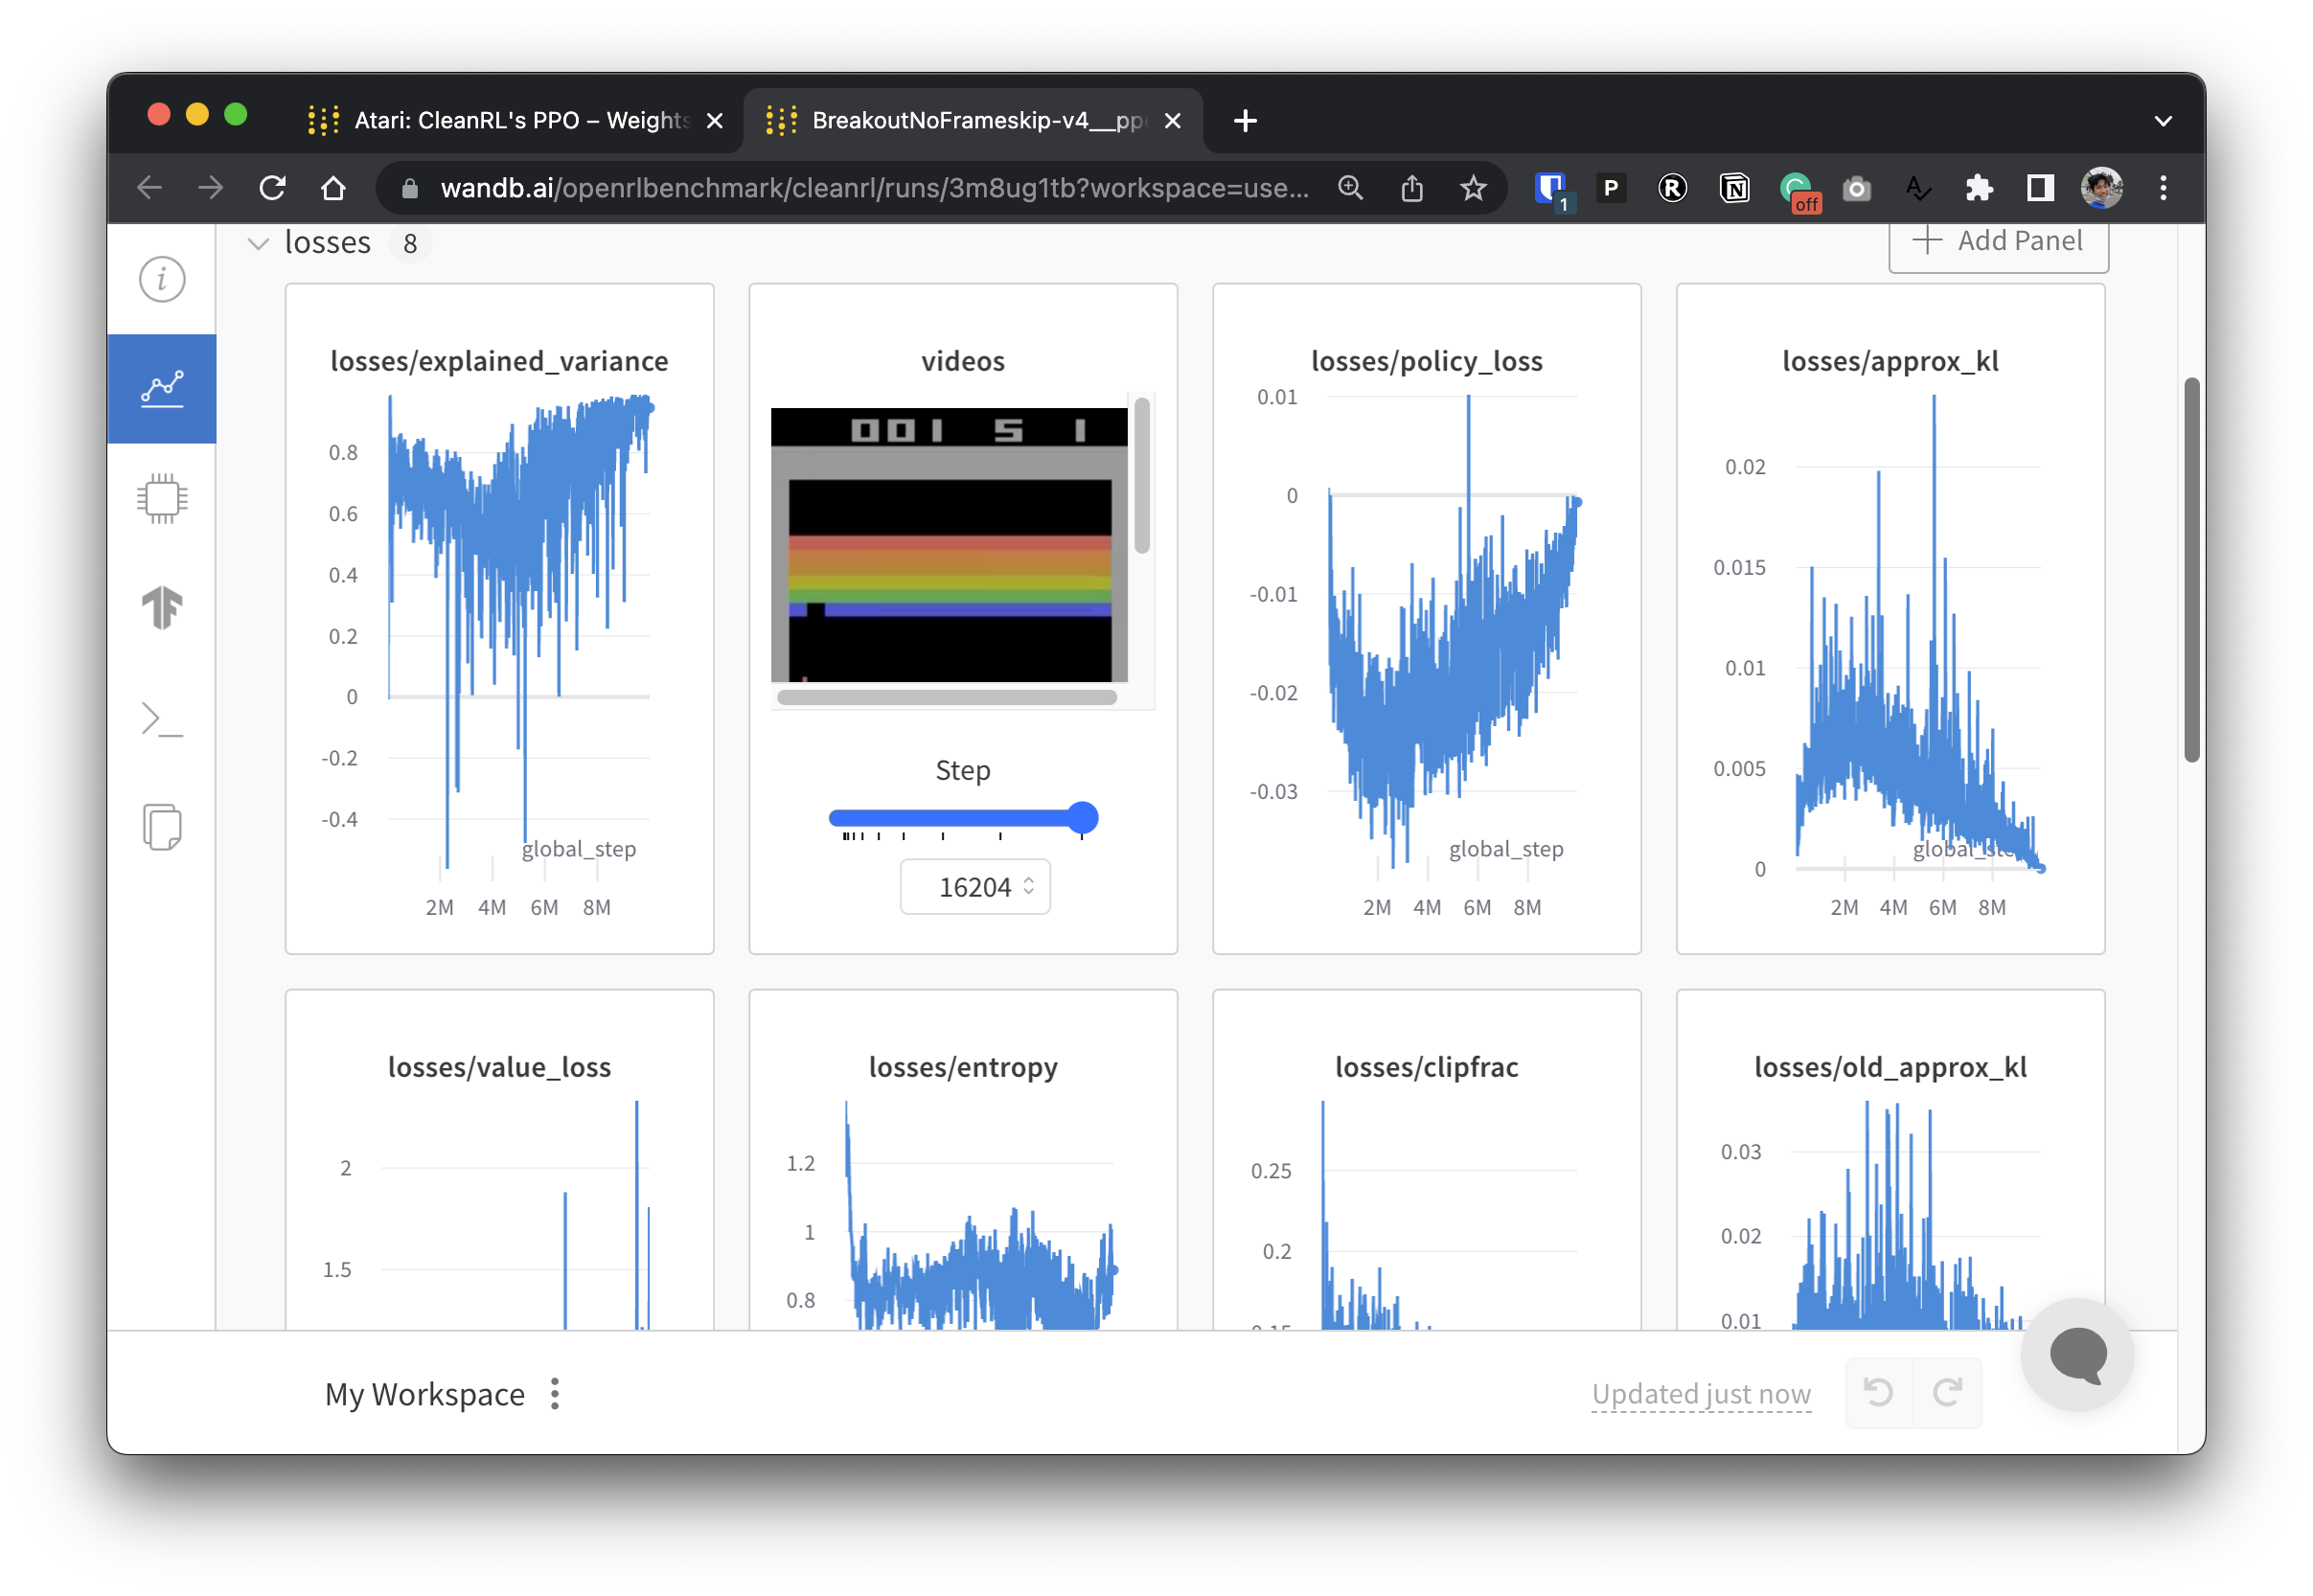
추적된 DRL 실험을 보여주는 Weights and Biases 보고서 모음은 https://benchmark.cleanrl.dev/에서 확인할 수 있습니다. 이 보고서는 인터랙티브하며, 연구원들은 다른 RL 벤치마크에서는 얻기 어려웠던 GPU 활용률이나 에이전트의 플레이 영상 같은 정보를 쉽게 조회할 수 있습니다. 향후 Open RL Benchmark는 연구자들이 데이터를 쉽게 접근할 수 있도록 데이터셋 API를 제공할 가능성이 높습니다 (참조 repo).
지원 관련하여 저희는 Discord 커뮤니티를 운영하고 있습니다. 궁금한 점이 있다면 자유롭게 질문해 주세요. Github Issues에 게시하거나 PR을 제출하는 것도 환영합니다. 또한, 저희의 과거 영상 녹화본은 YouTube에서 확인하실 수 있습니다.
CleanRL 인용하기 (Citing CleanRL)
만약 여러분의 작업에 CleanRL을 사용하신다면, 저희 기술 논문을 인용해 주시기 바랍니다:
@article{huang2022cleanrl,
  author  = {Shengyi Huang and Rousslan Fernand Julien Dossa and Chang Ye and Jeff Braga and Dipam Chakraborty and Kinal Mehta and João G.M. Araújo},
  title   = {CleanRL: High-quality Single-file Implementations of Deep Reinforcement Learning Algorithms},
...
감사의 말씀 (Acknowledgement)
CleanRL은 커뮤니티가 힘을 실어주는 프로젝트이며, 저희 기여자들은 다양한 하드웨어에서 실험을 진행합니다.
- 자체 컴퓨터를 사용하여 실험을 진행해 주신 많은 기여자분들께 감사드립니다.
- TPU 리소스를 제공해 준 Google의 TPU 연구 클라우드에 감사드립니다.
- GPU 리소스를 제공해 준 Hugging Face의 클러스터에 감사드립니다.