embo
spec 기반 Claude Code 워크플로우 —
/embo:prd → /embo:tech-design → /embo:tasks → /embo:impl,
지속적인 코드베이스 인덱스(RLM)와 세션 간 메모리(claude-mem)를 기반으로 합니다.
요약 (TL;DR)
- 카테고리: Claude Code용 spec 기반 개발 워크플로우
- 원칙: 재현 가능한 문서 트리 및 세션 독립성 — 원칙 참조
- 차별점: 지속적인 코드베이스 인덱싱과 세션 간 메모리를 모두 갖춘 유일한 프레임워크
- 설치: Claude Code 내부에서 두 개의 플러그인 설치 필요 — (1)
/plugin install embo@embo, (2) claude-mem 플러그인 설치. 아래 설치 참조.
- 첫 세션:
/embo:init -> /embo:start -> /embo:prd
- 대안 비교: 비교
- 존재 이유: 이유 | 전체 증거: docs/WHY.md
<!-- ARCHITECTURE-DIAGRAM-ANCHOR -->
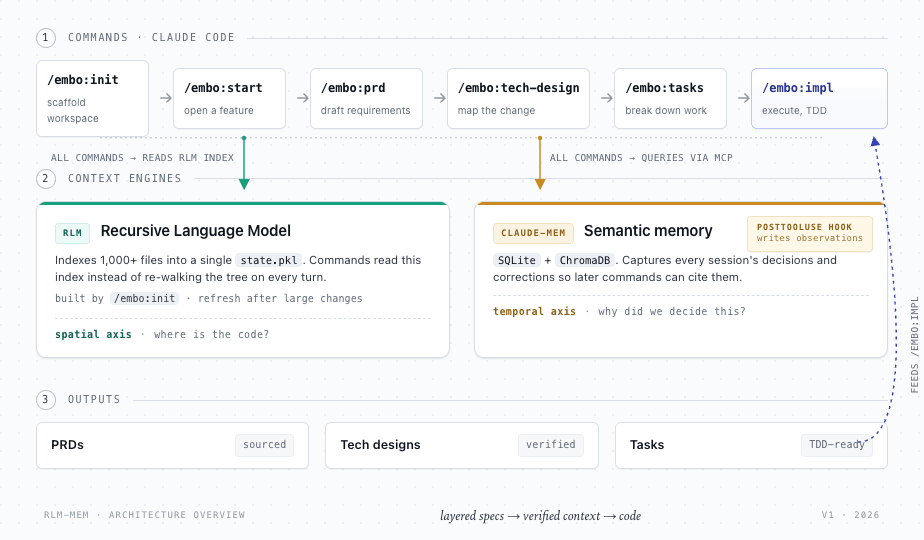
embo architecture: commands, parallel context engines (RLM + claude-mem), and verified outputs feeding /embo:impl
<sub>소스 프롬프트: assets/diagrams/architecture-overview.prompt.md — Claude Design을 통해 재생성.</sub>
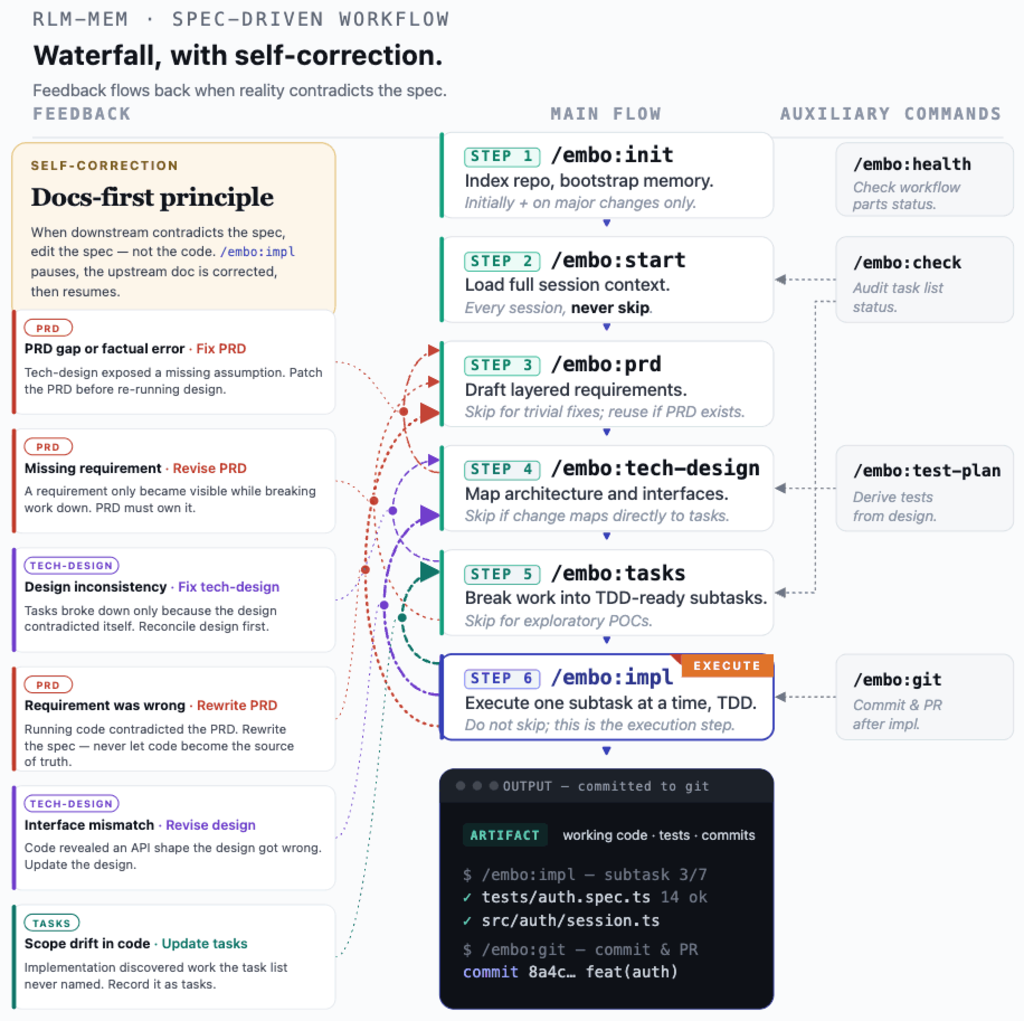
embo workflow sequence: waterfall with self-correction — every downstream command can revise upstream specs when reality contradicts the plan
<sub>소스 프롬프트: assets/diagrams/workflow-sequence.prompt.md — Claude Design을 통해 재생성.</sub>
설치 (Install)
embo는 Claude Code 플러그인으로 설치됩니다. 단계 1~3은 터미널이 아닌 Claude Code 내부에서 입력해야 하며; 단계 0은 시스템 종속성을 얻기 위해 한 번만 터미널에서 실행합니다.
단계 0 — 종속성 (Dependencies) (일회성, 터미널에서)
embo는 Python 3.8–3.12와 **Node.js 20+**가 필요하며; claude-mem은 또한 bun과 uv를 필요로 하고, hooks/statusline은 jq가 필요합니다. 이 모든 것을 한 번에 얻으려면 저장소를 클론하고 종속성 설치 프로그램을 실행하세요 (질문 없이 아무것도 설치하지 않으며, 이미 존재하는 것은 건너뜁니다):
git clone https://github.com/povesma/embo ~/embo
bash ~/embo/install.sh
Python과 Node를 확인하고(둘 중 하나라도 누락된 경우 정확한 설치 명령을 보고합니다—언어 런타임을 대신 설치해주지는 않습니다) 그리고 jq, bun, uv의 설치를 제안합니다. Bun은 claude-mem에 의해 자동 설치되도록 설계되었지만 종종 그렇지 않기 때문에 이 단계에서 직접 설치합니다. 완료되면 출력된 PATH 라인을 셸 프로필에 추가하세요.
[!NOTE]
Windows의 경우, PowerShell 등가 기능을 사용하세요(PowerShell 7 필요 — pwsh): pwsh -ExecutionPolicy Bypass -File .\\\install.ps1. 동일한 두 가지 모드(-Standalone은 수동 설치용)가 있습니다. 자세한 내용은 Reference §Windows를 참조하세요.
1단계 — embo 설치 (Claude Code 내부)
/plugin marketplace add povesma/embo
/plugin install embo@embo
이것은 모든 /embo:* 명령어, 에이전트 및 후크를 등록합니다. install <플러그인-이름>@<마켓플레이스-이름>을 읽어보세요 — 둘 다 embo입니다.
[!TIP]
병합되기 전에 특정 브랜치를 시도하려면, 마켓플레이스를 #ref 접미사로 추가하세요: /plugin marketplace add povesma/embo#some-branch. 로컬에서 개발하려면, 마켓플레이스를 작업 복사본을 가리키도록 설정하세요: /plugin marketplace add /path/to/embo.
[!NOTE]
플러그인 시스템 없이 설치하는 것을 선호하십니까? (예: embo를 클론하여 수정할 경우.) 동일한 스크립트를 --standalone으로 실행하여 embo를 ~/.claude/에 직접 복사하세요: bash ~/embo/install.sh --standalone. 이것은 병렬적인 경로입니다 — 1단계와 함께 사용하는 것이 아니라 대신 사용하세요. 플러그인과 독립형 설치는 동일한 후크와 명령어를 등록하므로 충돌할 수 있습니다. 독립형 설치는 bash ~/embo/uninstall.sh로 제거하세요. claude-mem(2단계)은 여전히 필요합니다.
2단계 — claude-mem 플러그인 설치 (Claude Code 내부) — 필수
/plugin marketplace add thedotmack/claude-mem
/plugin install claude-mem
⚠️ [경고]
thedotmack/claude-mem 마켓플레이스에서 claude-mem이라는 이름의 플러그인을 정확히 설치해야 합니다. claude-mem은 필수적입니다. embo는 런타임에 이를 검증하며, 이것이 없으면 명확한 오류 메시지와 함께 명령어가 실패합니다. (이는 번들된 종속성이 아닌 별도의 플러그인입니다.) /plugin 메뉴에 관련 없는 플러그인(frontend-design, figma, …)이 나열되어 있어도 그것들을 선택하지 마십시오.
3단계 — 검증 (Claude Code 내부)
RLM, claude-mem, 그리고 캡처 후크(capture hook)가 작동하는지 보고해야 합니다.
4단계 — 상태 표시줄 활성화 (선택 사항, Claude Code 내부)
플러그인 자체가 상태 표시줄을 등록할 수는 없으므로, 이 하나의 명령어가 이를 설정합니다 (경로(path), git 브랜치, 모델, 컨텍스트 %, claude-mem 신선도(freshness), 시간). 상태 표시줄을 보려면 Claude Code를 다시 시작하십시오. 자세한 내용은 참조 §Statusline를 참조하십시오.
첫 세션 (Claude Code 내부, 코드 저장소 어느 곳에서든)
/embo:init    # 일회성: 저장소를 인덱싱하고 메모리를 부트스트랩합니다
/embo:start   # 매 세션: 컨텍스트를 로드합니다
/embo:prd     # 기능 사양을 먼저 계획합니다(plan a feature spec-first)
[!참고]
이전 cp-into-~/.claude/ 설치에서 업그레이드하십니까? 플러그인과 이전 파일 모두 동일한 후크를 등록하며 (두 번 실행됨), /dev:*와 /embo:* 명령어를 정의합니다. 한 번 정리하십시오 — 수동 설치에서 마이그레이션을 참조하십시오.
플랫폼별 전체 세부 정보, 수동(플러그인 없음) 설치 방법, 그리고 종속성 버전은 참조에 있습니다.
수동 설치에서 마이그레이션
만약 ~/.claude/ 폴더로 파일을 복사하여 embo를 설치했다면 (오래된 방식), 플러그인을 설치하기 전에 그 수동 설치를 제거하십시오. 이것을 건너뛰면, 이전 파일과 플러그인 모두 동일한 후크를 등록하며 (두 번 실행됨), 명령어(/dev:*가 /embo:*를 섀도잉함)를 정의합니다.
깔끔한 경로는 다음과 같습니다: 이전 설치를 제거하고, 그 다음 플러그인을 설치하십시오.
- 저장소 클론: 아직 없다면 저장소를 복제합니다 (제거 프로그램이 포함되어 있습니다):
git clone https://github.com/povesma/embo ~/embo
- 기존 수동 설치 제거: 한 번에 이전 설정을 제거합니다. 이 과정은 파일을 삭제하므로, 각 파일의 확인을 거치고
settings.json을 먼저 백업합니다:
이 명령어는 기존의 /dev:* 명령어, rlm_repl.py 및 해당 권한 규칙, embo 훅 파일과 중복된 훅 등록을 제거합니다. 대신 ~/.claude/profiles/와 ~/.claude/active-profile.yaml은 유지합니다 (플러그인이 이들을 읽습니다). 또한 claude-mem은 건드리지 않습니다.
3. 플러그인 설치: 설치의 Step 0(종속성)부터 따라 진행한 후, /reload-plugins를 실행합니다.
4. 확인: /embo:health를 실행합니다. RLM, claude-mem, 그리고 캡처 훅 모두 녹색으로 표시되고, Bash 명령어당 [embo-capture] 마커가 하나만 나타나야 합니다 (두 개가 아니어야 함).
비교
embo가 다른 Claude Code 워크플로우 플러그인들과 어떻게 차별화되는지 설명합니다.
스냅샷 2026-09-04; 각 셀의 출처는 tasks/017-.../comparison-data.md에 있습니다.
| 프로젝트 | Spec 단계 | 코드 탐색 | X-세션 메모리 | TDD | 프로필 | 에이전트 모델 | 워크트리 | :---: |
| embo (본 문서) | 예 (yes) | index (RLM) | 예 (yes) | 예 (yes) | 예 (yes) (4) | focused (1+5 test) | 아니오 (no) |
| ... | | | | | | | |
범례: 예(yes) = 내장됨 · 부분적(partial) / 선택적(optional) = 부분적이거나 선택적 · 아니오(no) / 없음(none) = 부재. 코드 탐색: 도구가 코드를 찾는 방식 — 영구적인 index, 실시간 LSP+AST 조회, 일반 grep, 또는 없음. 에이전트 모델: 에이전트 구성의 형태 (집중된 focused 세트, 대규모 swarm, 역할 기반, 또는 단일 single 에이전트) — 품질 점수가 아니며, 에이전트가 많다고 해서 본질적으로 더 좋은 것은 아닙니다.
명시적인 Spec 단계(PRD → 설계 → 작업)는 이제 기본 조건입니다. GitHub의 Spec-Kit을 포함하여 모든 진지한 도구가 이를 갖추고 있습니다. 도구를 차별화하는 것은 맥락 깊이와 병렬성입니다.
embo를 선택해야 하는 경우: 공간적(spatial) 맥락(코드가 어디에 있는지?)과 시간적(temporal) 맥락(왜 2월에 이것을 결정했는지?) 모두가 모든 사양(spec), 설계(design), 구현(impl)에 자동으로 로드되기를 원한다면. 여기에 있는 다른 어떤 도구도 — Spec-Kit조차도 — 지속적인 코드베이스 인덱스와 세션 간 메모리를 모두 가지고 있지 않습니다. embo는 깊은 맥락을 가진, 단일 트랙 방식의 선택지입니다.
다른 것을 선택해야 하는 경우:
- 병렬 에이전트를 위해 **git-worktree 격리(isolation)**가 필요하다면 — Spec-Kit, Superpowers, 또는 OMC (embo는 자체 에이전트를 하나의 작업 트리에서 실행함)
- **최대 에이전트 처리량/병렬 스웜(swarms)**을 원한다면 — OMC 또는 shinpr
- 텍스트 인덱스보다는 LSP/AST "정의로 이동(go-to-definition)" 탐색에 의존한다면 — OMC
- 셀프 루핑 검증(self-looping verification) (통과 신호가 나올 때까지 감사-수정-재시도)을 원한다면 — OMC (
ralph) 또는 shinpr의 품질 게이트
- 가장 큰 생태계와 가장 폭넓은 에이전트 지원을 원한다면 — GitHub Spec-Kit
잘 어울리는 조합: ponytail — 이 플러그인은 에이전트에게 코드를 덜 작성하도록(매 턴 YAGNI 검사 재주입, 그리고 리뷰/감사/부채 명령 추가) 푸시하는 역할을 합니다. 이는 코드 볼륨을 관리하며, embo는 워크플로우를 관리하므로 두 가지는 중복 없이 결합됩니다. Claude Code 내에 설치하세요:
/plugin marketplace add DietrichGebert/ponytail
/plugin install ponytail
그런 다음 /hooks에서 그 기능을 검토하고 신뢰하십시오 (두 개의 Node.js 라이프사이클 훅을 실행하므로 node가 PATH에 있어야 합니다).
이것이 존재하는 이유
동료 심사 또는 업계 리더 출처의, 구조화되지 않은("느낌만으로 하는") AI 코딩에서 측정 가능한 세 가지 실패 사례:
- AI 툴링은 숙련된 개발자의 생산성을 19% 저해했습니다. 통제된 RCT(Randomized Controlled Trial)에서 프롬프팅 및 검토에 드는 오버헤드가 코드 생성 속도 향상분보다 크다는 것이 밝혀졌습니다. (METR study, 2025)
- 실패한 에이전트 시도는 성공적인 경우보다 4배 많은 비용을 초래합니다. 이는 토큰 스노우볼 효과(Token Snowball Effect) 때문인데, 단 한 번의 실패한 루프에 약 8.8M 토큰 / 658초가 소모됩니다. (SWE-Effi, 2025)
- 명세 기반 워크플로우는 이러한 손실을 만회합니다. TDFlow는 사람이 작성한 테스트를 받았을 때 SWE-bench Lite에서 **88.8%**의 점수를 기록했는데, 이는 다음으로 좋은 기준선 대비 27.8 pp의 절대적 향상입니다. (TDFlow, 2025)
embo는 이 두 가지 측면을 모두 제공하는 가장 작은 프레임워크입니다:
강제적인 분해(enforced decomposition)
(/embo:prd → /embo:tech-design → /embo:tasks → /embo:impl)
를 통해 토큰 스노우볼을 피하고, 지속적인 메모리(RLM index + claude-mem)를 제공하여 구조가 매일 아침 초기화되는 대신 세션 전반에 걸쳐 축적되도록 합니다.
-> 전체 증거 및 인용: docs/WHY.md
원칙 (Principles)
모든 embo 명령어는 두 가지 불변성(invariant)을 따릅니다:
- 재현 가능한 문서 트리(Replayable docs tree). 문서 트리란
tasks/ 아래에 있는 작업별 계획 문서를 말하며 (PRD, tech-design, task list), 제품의 현재 상태를 설명합니다. 유지되는 의도(보장이 아닌 목표)는 모든 PRD를 처음부터 재실행하면 동일한 제품이 재구축될 것이라는 것입니다. 따라서 기존 기능에 변경 사항이 생기면 해당 기능을 다루는 문서를 수정하게 되며, 별도의 새 문서가 필요한 경우는 수정만으로는 재현 가능성을 유지할 수 없을 때(FOLD-FIRST 규칙, 액션별 체크리스트로 강제)에 한해서 정당화됩니다.
- 세션 독립성(Session idempotency). 중요한 내용은 대화창 안에만 존재해서는 안 됩니다. 결정 사항, 발견 내용, 진행 상황은 문서 트리 (PRD / tech-design / tasks)에 기록되므로, 다음 세션에서는 채팅의 기억이 아닌 문서를 기반으로 재개됩니다.
/embo:wrapup은 세션 종료 시 추적되지 않은 정보를 감지하고 문서 업데이트를 제안함으로써 이를 강제합니다.
사용 가능한 명령어
| 단계 | 명령어 | 목적 |
|---|
| Discovery | /embo:init | 리포지토리 인덱싱 + claude-mem 부트스트랩 (일회성) |
| ... | | |
| Full per-command reference under Reference. | | |
위임 프롬프트(Delegation prompts)
embo는 에이전트가 메인 대화에서 처리하는 것보다 서브 에이전트에게 작업을 넘기는 것이 더 효율적일 때 이를 수행합니다. 예를 들어, 여러 파일을 읽어야 하는 탐색 작업, 이번 세션에 작성된 내용에 대한 편향되지 않은 비평, 위험한 접근 방식에 대한 독립적인 증명, 한 번에 처리해야 할 여러 개의 독립적인 작업, 또는 노이즈가 많은 문제 해결 루프 등이 있습니다. 다음과 같은 두 가지를 보게 될 것입니다: