CIPHER
CIPHER는 Cybersecurity Intelligent Pentesting Helper for Ethical Researcher의 약자입니다.
이곳은 CIPHER Paper의 공식 레포지토리입니다.
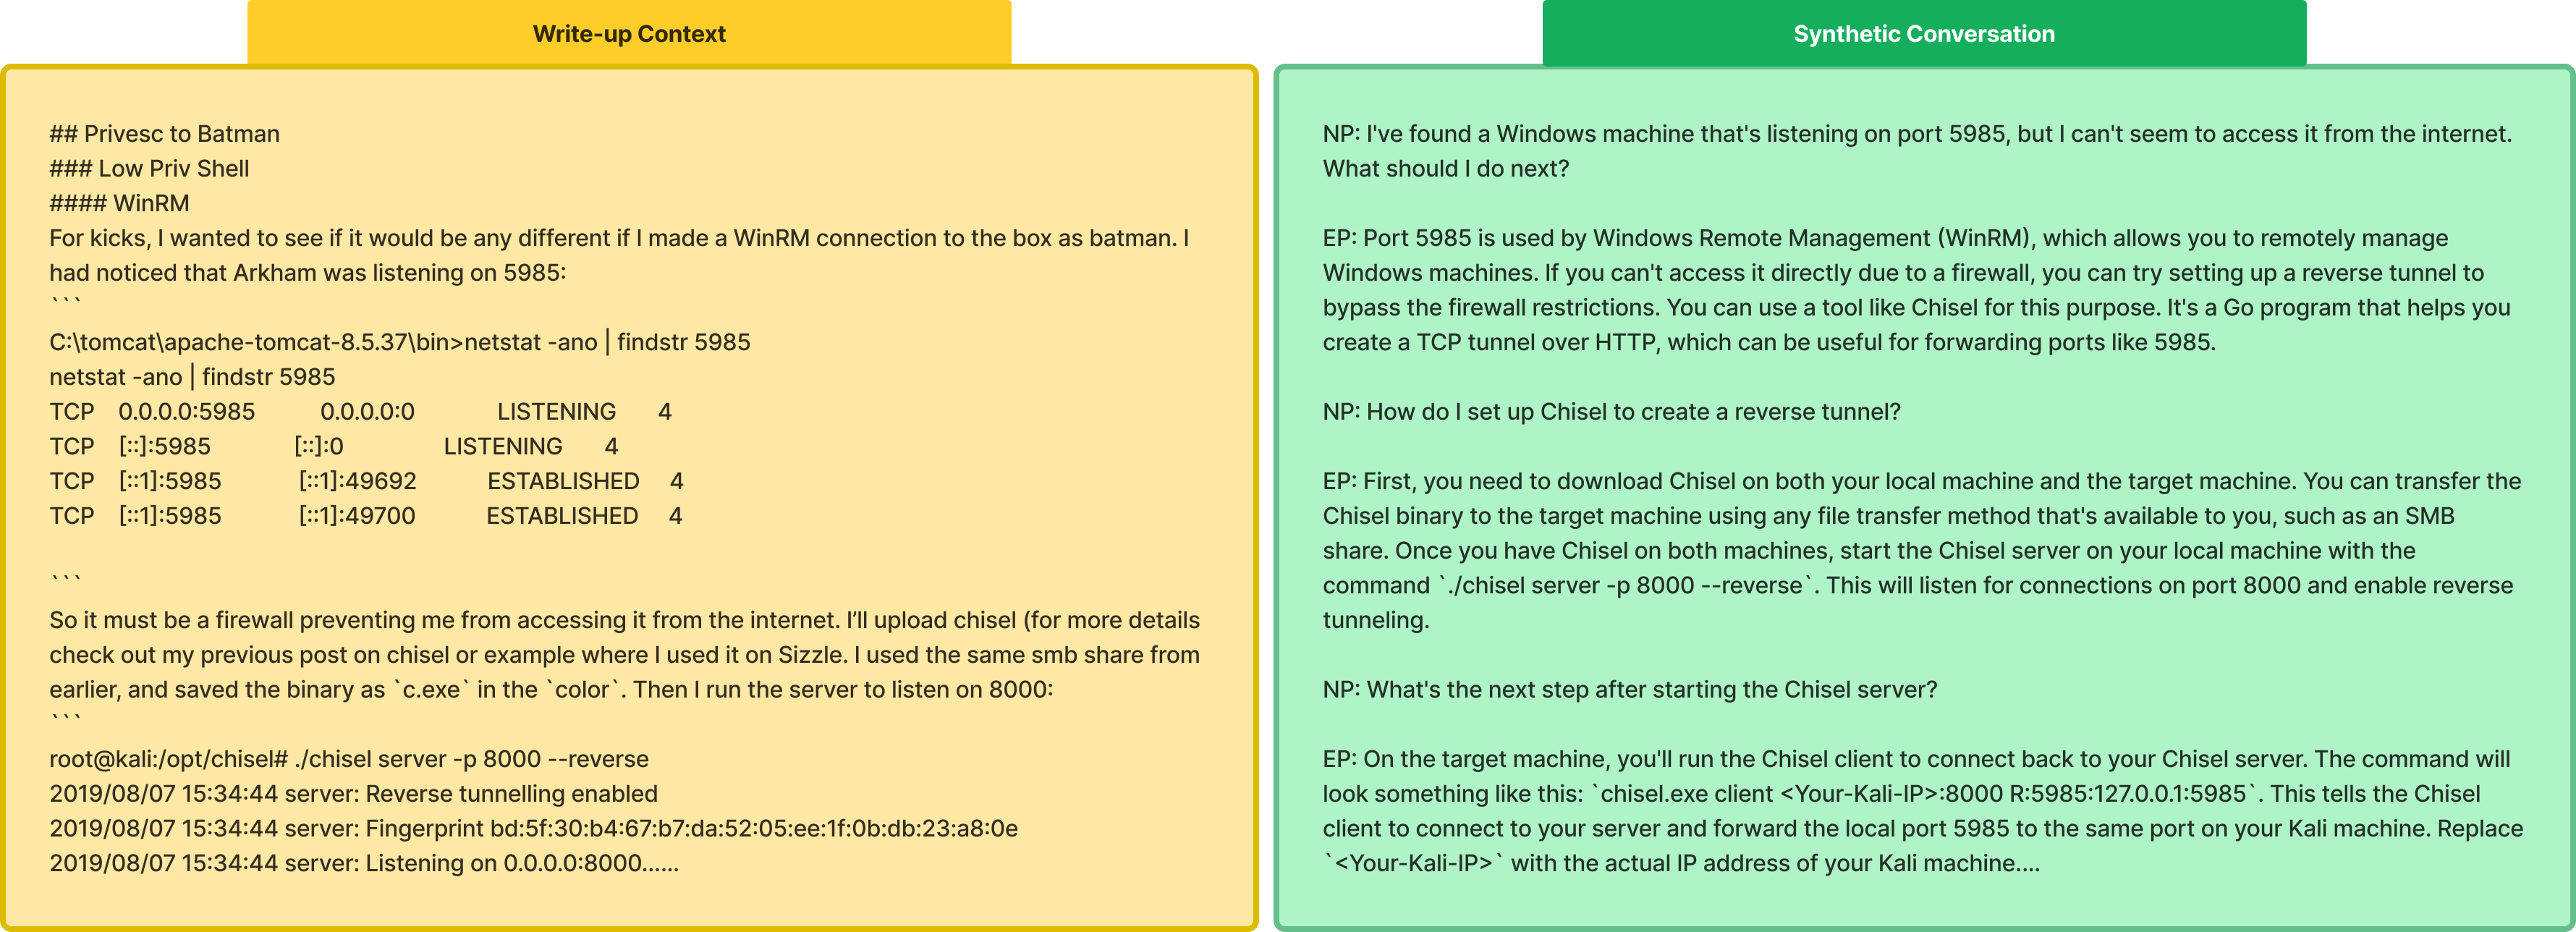
CIPHER는 초보자가 전문가의 추론을 통해 목표 시스템에 침투하는 과정을 안내하도록 특별히 미세 조정된 대규모 언어 모델(LLM)입니다. 침투 테스트는 빠르게 숙달할 수 없는 복잡한 작업입니다. 대부분의 초보자는 다른 사람이나 전문가에게 힌트나 도움을 요청하며 여정을 시작합니다. 이는 그들이 경험을 통해 스스로 독창적인 추론 능력을 개발할 때까지 계속됩니다.
우리는 경험이 최고의 스승이라고 믿으며, 침투 테스트는 책이나 문헌을 읽기만 해서는 숙달될 수 없습니다. 심지어 기술 자체도 Hacktricks, PayloadAllTheThings, ExploitDB 등 여러 출처에 작성되어 있지만, 독창적인 추론 과정은 침투 테스터의 두뇌 내부에서 일어나며, 그들의 Writeup(작성 보고서)을 제외하고는 문서화되어 있지 않습니다. CIPHER가 초점을 맞춘 곳이 바로 이곳입니다. CIPHER는 전문가들이 작성한 Writeup에서 얻은 경험 기반 지식으로 훈련되었습니다.
TLDR: CIPHER는 침투 테스트 가이드를 위해 미세 조정된 LLM입니다. CIPHER의 지식은 전문가 대화에 증강된 Writeup을 기반으로 합니다. 반면, FARR Flow는 기존 Writeup을 활용하여 LLM의 안내 정확도를 측정하는 방법론입니다.
빠른 시작 (Quick Start)
1. 레포지토리 클론:
git clone https://github.com/ibndias/CIPHER.git
2. FARR Flow 생성
저희는 0xdf 블로그의 두 가지 취약한 머신 Writeup 예제, 즉 HTB Aero와 HTB Analytics를 가지고 있습니다. 두 Writeup 모두 마크다운 형식으로 /farr-generation/source/htb-0xdf-small 디렉토리 안에 이미 준비되어 있습니다.
이 Writeup들을 기반으로 FARR Flow를 생성해 보겠습니다:
cd CIPHER/farr-generation
python farr-gen.py full ./source/htb-0xdf-small ./output/htb-0xdf-small-flow
이제 FARR Flows가 생성되어 ./output/htb-0xdf-small-flow-foothold에 저장됩니다.
기본적으로 gpt-4o-mini를 사용하며, 만약 생성기를 커스텀 모델로 변경하고 싶다면, OpenAI 호환 API의 기본 URL을 지정하고 다음과 같이 모델 이름을 전달하면 됩니다:
python farr-gen.py full ./source/htb-0xdf-small ./output/htb-0xdf-small-flow --api-base http://10.125.121.102:1330/v1 --model-chosen meta-llama/Llama-3.3-70B-Instruct
모든 OpenAI 호환 엔드포인트가 지원됩니다.
3. 모델 평가 (Evaluate the model)
FARR Flows를 얻었으니, 이제 모델을 평가하기 시작할 수 있습니다. 이 예시에서는 gpt-4o-mini를 평가자로 사용하여 HTB Aero 및 HTB Analytics 취약 머신에 대한 gpt-3.5-turbo의 성능을 평가할 것입니다.
측정하는 기준은 service입니다. 점수는 service 정확도를 기반으로 모델이 사용자에게 목표 침투를 안내하는 데 얼마나 정확한지를 나타냅니다:
평가 디렉토리로 이동합니다:
gpt-3.5-turbo 응답을 생성합니다:
python farr-eval.py --test-model gpt-3.5-turbo --mode response --flow-dir ../farr-generation/output/htb-0xdf-small-flow-foothold --output-dir ./output-response-small
service 기준에 따라 gpt-4o-mini 모델로 gpt-3.5-turbo 응답을 평가합니다:
python farr-eval.py --test-model gpt-3.5-turbo --mode eval --eval-model gpt-4o-mini --flow-dir ../farr-generation/output/htb-0xdf-small-flow-foothold --response-dir ./output-response-small --output-dir ./output-eval-small-service --criteria service
평균 점수를 얻습니다:
python scoring.py ./output-eval-small-service
이제 service 정확도를 기반으로 두 개의 취약한 머신에 대한 모델 성능 평균 점수를 얻을 수 있습니다. 논문에서는 세 가지 정확도(service, vulnerability, outcome)를 사용합니다. 다양한 기준에 대해 평가하려면 --criteria 인수를 수정할 수 있습니다. 사용자 지정 LLM 추론 엔드포인트를 추가하려면 farr-evaluation/utils/inference.py 파일을 수정하십시오.
데이터셋 증강 (Dataset Augmentation)
TODO: 설명 필요
(궁금하다면 논문을 확인하세요)
전문가 지도 대화 (Expert Guidance Conversation)
expert-conversation
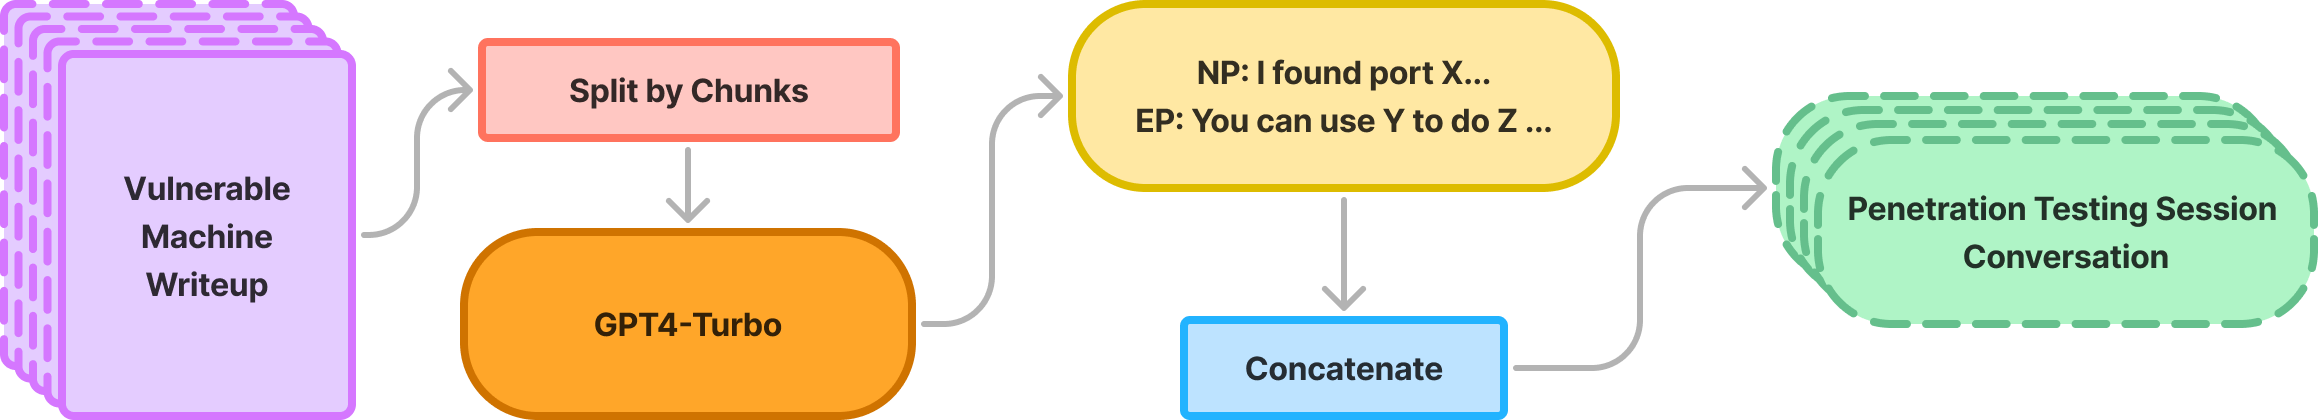
대화 증강 파이프라인 (Conversation Augmentation Pipeline)
expert-conversation-pipeline
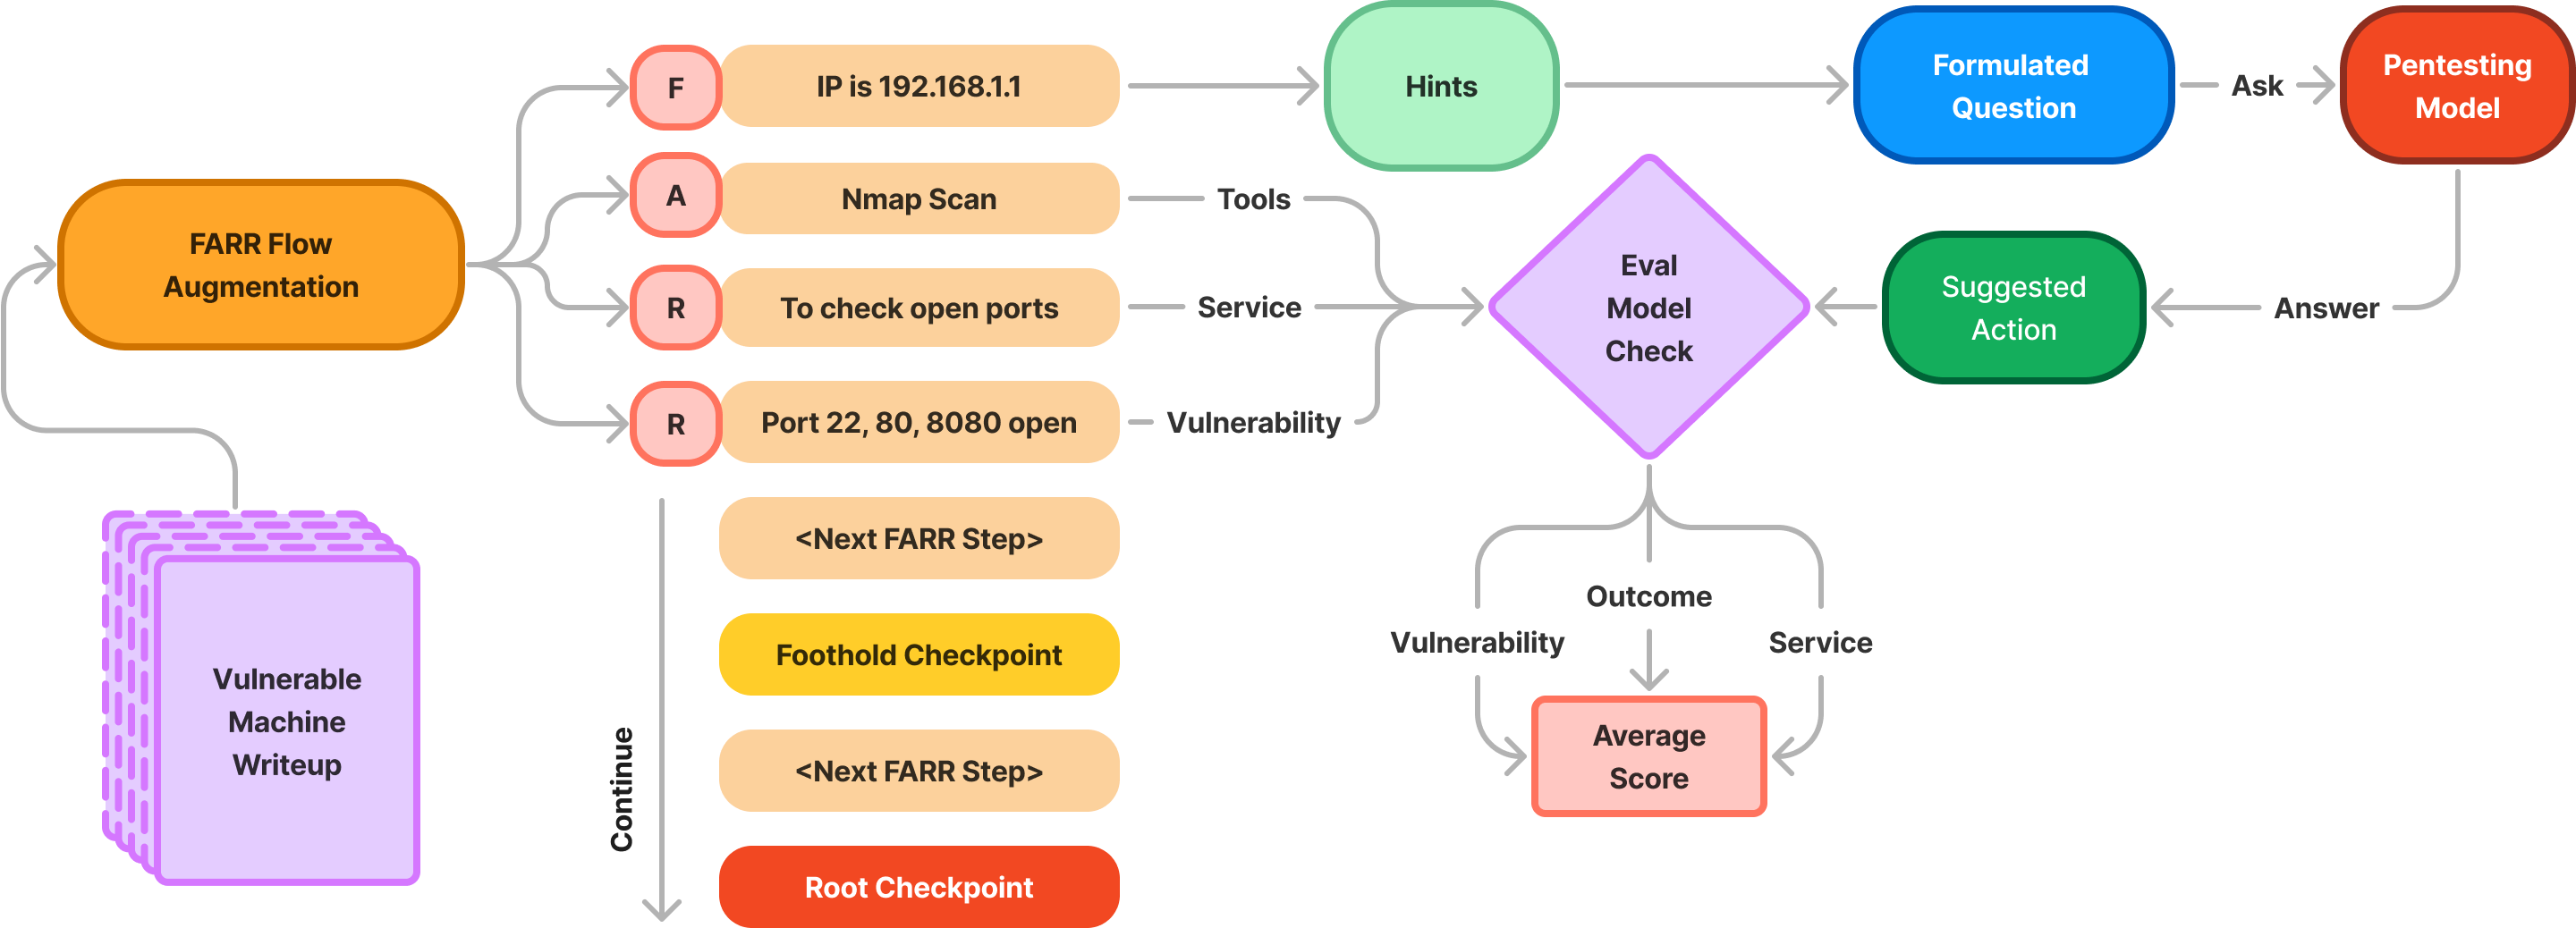
FARR 흐름 (FARR Flow)
Findings, Action, Reasoning, Result (FARR) 흐름은 기존 작성 문서에서 정보를 가능한 한 압축적으로 증강하는 방법론입니다. 대부분의 침투 테스터는 전문가를 포함하여 자신의 진행 상황을 작성 문서에 기록합니다.
파이프라인 (Pipeline)
farr-flow-gen-pipeline
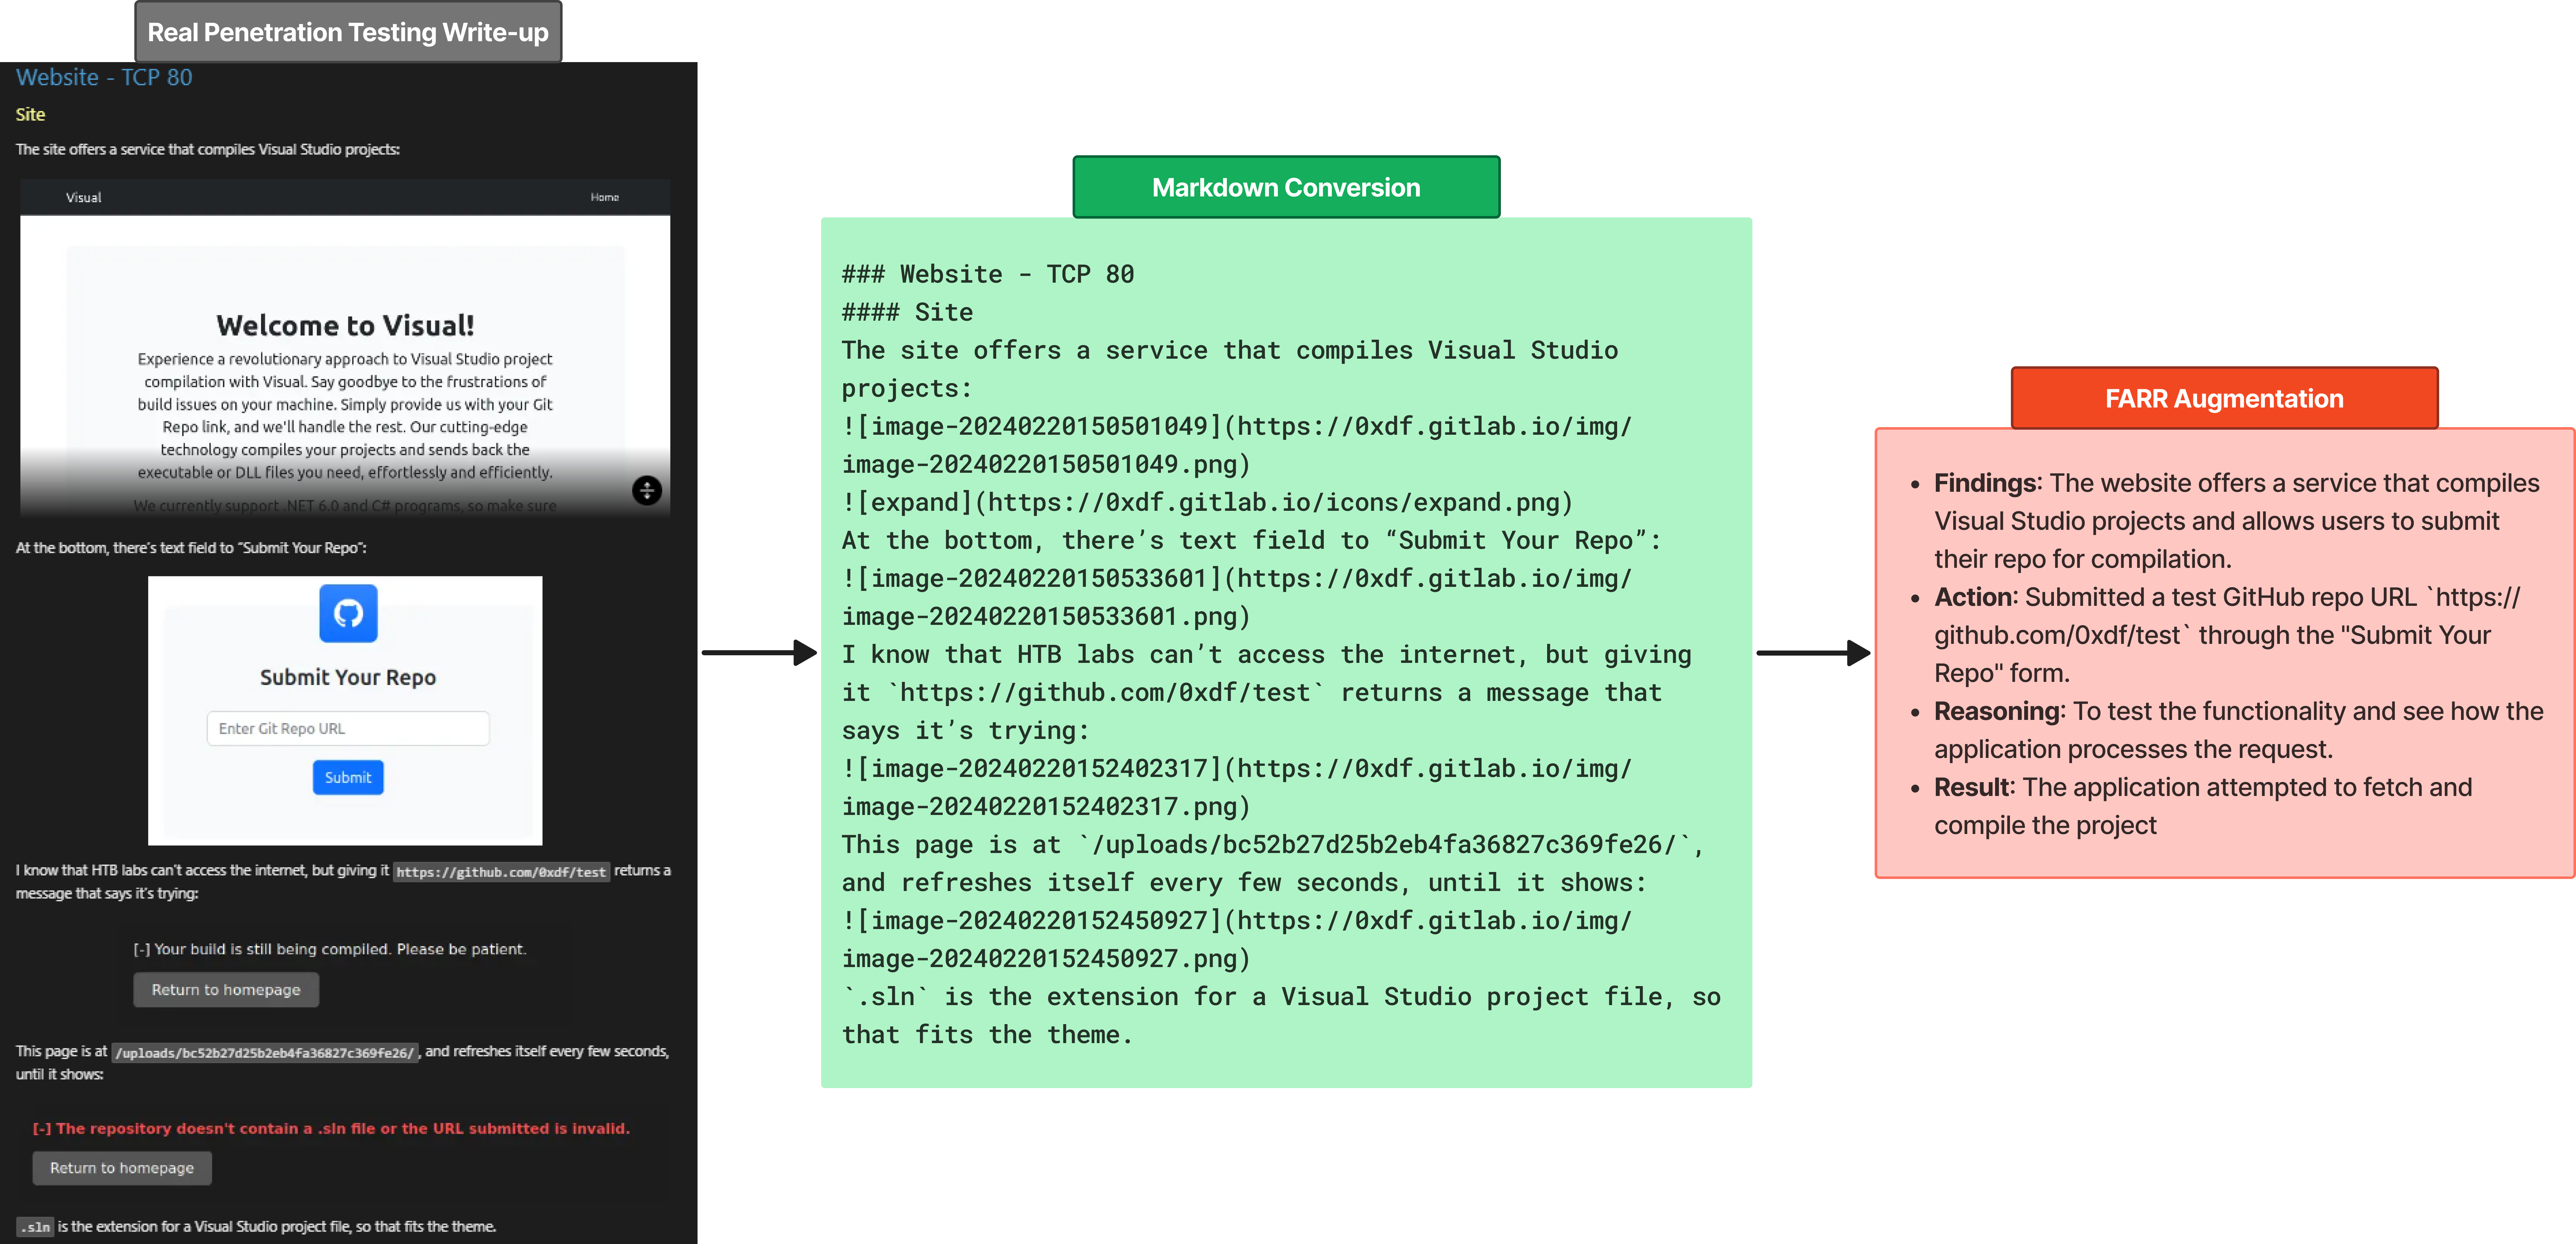
증강 예시 (Augmentation Example)
farr-flow-gen-pipeline-example
하지만 이러한 작성 문서가 어떤 형식으로 되어야 하는지에 대한 표준은 없습니다. 따라서 목표는 침투 테스트 과정에서 수집된 순서화된 동적 정보를 자연어 작성 문서로 포착하는 것입니다.
FARR이란 정확히 무엇인가?
Findings (발견 사항): 침투 테스트 과정에서 발견된 모든 것.Action (조치): Findings가 인지된 후, 그리고 Reasoning을 기반으로 취해진 조치.Reasoning (추론 근거): Action의 배경이 되는 논리적 이유로, 초보자의 지식에서는 주로 결여되는 부분입니다.Result (결과): 수행된 조치의 결과를 요약하며, 성공적인 익스플로잇 및 그 영향 포함.
    python farr-gen.py generate ./source/htb-0xdf ./output/htb-0xdf-flow
    ```
옵션 인자:

- `--api-key`: OpenAI API 키 (기본값: `OPENAI_API_KEY` 환경 변수 사용)
- `--api-base`: OpenAI API 기본 URL (기본값: `https://api.openai.com/v1`)
- `--model-chosen`: 사용할 OpenAI 모델 (기본값: `gpt-4o-mini`)
- `--chunk-size`: 텍스트 분할 청크 크기 (기본값: 8000)
- `--chunk-overlap`: 텍스트 분할 청크 중첩 크기 (기본값: 1000)

2. Flow 파일 구문 분석(Parse Flow Files)
    펜테스팅 흐름 파일을 JSON 형식으로 구문 분석합니다.

```sh
python farr-gen.py parse ./output/htb-0xdf-flow ./output/htb-0xdf-flow-json
- 발판(Footholds) 표시하기(Mark Footholds)
OpenAI API를 사용하여 구문 분석된 흐름 파일에 발판을 표시합니다.
python farr-gen.py mark ./output/htb-0xdf-flow-json ./output/htb-0xdf-flow-json-foothold
옵션 인자:
--api-key: OpenAI API 키 (기본값: OPENAI_API_KEY 환경 변수 사용)--api-base: OpenAI API 기본 URL (기본값: https://api.openai.com/v1)--model-chosen: 사용할 OpenAI 모델 (기본값: gpt-4)
이렇게 하면 서로 다른 형식을 담고 있는 세 개의 디렉터리가 생성됩니다.
./output/htb-0xdf-flow에는 원시(raw) 처리되지 않은 FARR Flow가 포함됩니다../output/htb-0xdf-flow-json에는 구문 분석된 FARR Flow가 포함됩니다../output/htb-0xdf-flow-json-foothold에는 발판과 루트 키(root keys)가 추가된 FARR Flow가 포함되며, 이로써 발판과 루트를 획득한 단계를 알려줍니다. 이는 향후 FARR Flow 평가에서 얼마나 많은 발판과 루트를 획득했는지 측정하는 데 유용합니다.
FARR Flow 평가
FARR Flow는 현재 발견된 정보를 기반으로 모델의 응답을 평가합니다. FARR 단계에서 도출된 개방형 질문(open-ended question)을 사용하여 다음에 취해야 할 올바른 조치를 묻습니다.
질문이 개방형이기 때문에, FARR는 세 가지 측면(취약점(vulnerability), 결과(outcome), 서비스(service))의 관련성과 유사성을 기반으로 모델 답변 품질을 측정하는 세 가지 기준을 사용합니다.
farr-flow-evaluation
FARR Flow JSON 파일을 확보했다면, 아래 평가 단계를 진행하세요:
모델 답변/응답 생성 (Generating Model Answer/Response)
python farr-eval.py --test-model gpt-4o-mini --mode response --flow-dir ../../farr-generation/output/htb-0xdf-flow-foothold --output-dir ./output-response
모델 답변/응답 평가 (Evaluating Model Answer/Response)
python farr-eval.py --test-model gpt-4o-mini --mode eval --eval-model gpt-4o-mini --flow-dir ../../farr-generation/output/htb-0xdf-flow-foothold --response-dir ./output-response --output-dir ./output-eval-service --criteria service
기여 (Contributing)
CIPHER와 그 평가 프레임워크 개선에 대한 기여를 환영합니다. 다음 단계를 따라 기여해 주세요:
- 저장소(repository)를 포크(fork)하세요.
- 기능 추가 또는 버그 수정용 새 브랜치를 만드세요.
- 변경 사항을 커밋(commit)하고 포크에 푸시(push)하세요.
- 변경 사항에 대한 상세 설명을 담아 풀 리퀘스트(pull request)를 생성하세요.
인용 (Citing)
@Article{s24216878,
AUTHOR = {Pratama, Derry and Suryanto, Naufal and Adiputra, Andro Aprila and Le, Thi-Thu-Huong and Kadiptya, Ahmada Yusril and Iqbal, Muhammad and Kim, Howon},
TITLE = {CIPHER: Cybersecurity Intelligent Penetration-Testing Helper for Ethical Researcher},
...
질문이나 문의 사항이 있으시면 [email protected]으로 연락 주십시오.