이것은 다음 논문의 원본 트랜스포머 아키텍처를 처음부터 직접 구현한 것입니다: Vaswani, Ashish, et al. "Attention is all you need." Advances in neural information processing systems. 2017.. 트랜스포머를 처음부터 구현하는 방법에 대한 더 자세한 단계별 블로그는 Transformer from scratch를 참조하세요.
<a href=https://arxiv.org/pdf/1706.03762.pdf>
<p align="center">
<img width="540" height="700" src="https://user-images.githubusercontent.com/57716666/143226016-e184793b-a0c8-443c-b2c0-8f034eb82d93.jpg">
</p>
</a>
목차
About
"우리는 순환 구조(recurrence)와 컨볼루션(convolutions)을 완전히 배제하고, 오직 어텐션 메커니즘만을 기반으로 하는 새로운 간단한 네트워크 아키텍처인 트랜스포머를 제안합니다." - 초록 (Abstract)
트랜스포머는 자연어 처리(NLP) 및 그 이상 분야에서 우리가 할 수 있는 일에 혁명을 일으킨 획기적인 신경망 아키텍처가 되었습니다. 몇 가지 응용 사례로 BERT의 Google 검색 적용과 GPT를 이용한 Github Copilot을 들 수 있습니다. 이들 아키텍처는 본 논문에서 설명된 원래 트랜스포머 아키텍처의 업그레이드 버전입니다. 이 리포지토리의 목표는 논문을 읽으면서도 따라 하기 쉽고 이해하기 쉬운 구현체를 제공하는 것입니다. 설정은 간단하며 학습 목적으로 CPU에서도 모든 것이 실행 가능합니다.
✔️ 높은 커스터마이징이 가능한 설정 및 학습 루프
✔️ CPU와 GPU에서 실행 가능
✔️ 모든 메트릭에 대한 상세 로깅을 위한 W&B 통합
✔️ 사전 학습 모델 및 그 훈련 세부 정보
✔️ 그래디언트 누적(Gradient Accumulation)
✔️ 레이블 스무딩(Label smoothing)
✔️ BPE 및 WordLevel 토크나이저
✔️ 동적 배치(Dynamic Batching)
✔️ 배치 데이터셋 처리(Batch Dataset Processing)
✔️ 훈련 중 BLEU 점수 계산
✔️ 아키텍처의 모든 단계에 대한 차원 명시
✔️ 에포크마다 예시에 대한 번역 진행 상황 표시
✔️ 튜토리얼 노트북
설정 (Setup)
환경 (Environment)
Miniconda/Anaconda 사용 시:
cd path_to_repoconda env createconda activate attention-is-all-you-need-paper
*참고: GPU에 따라 cudatoolkit을 버전 10.2로 변경해야 할 수도 있습니다.
사전 학습 모델 (Pretrained Models)
사전 학습 모델과 토크나이저를 다운로드하려면 다음 명령어를 실행하세요:
python scripts/download_pretrained.py
*참고: wandb 설정에 대한 요청이 있으면 옵션 3을 선택하세요.
사전 학습 모델의 모든 정보와 결과는 이 프로젝트 링크에서 확인할 수 있습니다.
사용법 (Usage)
훈련 (Training)
훈련을 시작하기 전에 사용 가능한 설정 중 하나를 선택하거나 단일 파일 src/config.py 내에 자신만의 설정을 만들 수 있습니다. 커스터마이징할 수 있는 사용 가능한 매개변수들은 카테고리별로 정렬되어 다음과 같습니다:
- Run 🚅:
- RUN_NAME - 학습 실행 이름 (Name of a training run)
- RUN_DESCRIPTION - 학습 실행 설명 (Description of a training run)
- RUNS_FOLDER_PTH - 학습 실행 저장 경로 (Saving destination of a training run)
- Data 🔡:
- DATASET_SIZE - WMT14 en-de 데이터셋에서 포함할 예제 수 (최대 4,500,000)
- TEST_PROPORTION - 테스트 세트 비율
- MAX_SEQ_LEN - 허용되는 최대 시퀀스 길이
- VOCAB_SIZE - 어휘 크기 (적절한 선택은 토크나이저에 따라 다름)
- TOKENIZER_TYPE - 'wordlevel' 또는 'bpe'
- Training 🏋️♂️:
- BATCH_SIZE - 배치 크기
- GRAD_ACCUMULATION_STEPS - 매개변수 최적화 전에 기울기를 누적할 배치 수
- WORKER_COUNT - 데이터로더에 사용되는 워커 수
- EPOCHS - 에포크(epoch) 수
- Optimizer 📉:
- BETAS - Adam 베타 파라미터
- EPS - Adam eps 파라미터
- Scheduler ⏲️:
- N_WARMUP_STEPS - 스케줄러에 사용할 워밍업 단계 수
- Model 🤖:
- D_MODEL - 모델 차원 (Model dimension)
- N_BLOCKS - 인코더 및 디코더 블록 수
- N_HEADS - 다중 헤드 어텐션 메커니즘의 헤드 수
- D_FF - 위치별 피드 포워드 네트워크의 차원 (Dimension of the Position Wise Feed Forward network)
- DROPOUT_PROBA - 드롭아웃 확률
- Other 🧰:
- DEVICE - 'gpu' 또는 'cpu'
- MODEL_SAVE_EPOCH_CNT - 모델 체크포인트를 저장할 에포크 수
- LABEL_SMOOTHING - 레이블 스무딩 적용 여부
설정값을 결정한 후 train.py에서 config_name을 수정하고 다음 명령어를 실행하세요:
$ cd src
$ python train.py
추론 (Inference)
추론을 위해 브라우저에서 실행되는 간단한 앱을 Streamlit으로 만들었습니다. 사전에 모델을 학습시키거나 사전 학습된 모델을 다운로드했는지 확인하세요. 이 앱은 model 디렉토리에서 모델 및 토크나이저 체크포인트를 찾습니다.
$ streamlit run app/inference_app.py
# 데이터
WMT 2014 데이터가 영어-독일어 번역 작업에 사용됩니다. 이 데이터셋은 약 450만 개의 문장 쌍을 포함하고 있지만, 더 낮은 크기로 지정하여 결과를 더 빨리 보고 싶다면 수동으로 데이터셋 크기를 지정할 수 있습니다. **학습이 시작되면 데이터셋이 자동으로 다운로드되고, 전처리되며, 토큰화되고, 데이터 로더가 생성됩니다.** 또한, 유사한 길이의 문장들을 동적 배치(dynamic batching) 및 패딩(padding)하기 위해 사용자 정의 배치 샘플러(custom batch sampler)를 사용하며, 이는 학습 속도를 높여줍니다. 이러한 매우 빠른 처리는 HuggingFace 🤗 datasets와 tokenizers를 사용하여 구현됩니다.
# 아키텍처 (Architecture)
The 이 논문에서 제시된 원래의 트랜스포머 아키텍처는 기계 번역의 seq2seq 문제 유형에 맞추기 위해 인코더(encoder)와 디코더(decoder) 부분으로 구성되어 있습니다. 또한, 인코더 전용(예: BERT) 및 디코더 전용(예: GPT) 트랜스포머 아키텍처도 존재하지만, 여기서는 다루지 않습니다. 일반적으로 트랜스포머의 주요 특징 중 하나는 RNN이 갖지 못한 병렬화된 시퀀스 처리(parallelized sequence processing)입니다. 여기서 핵심 요소는 [어텐션 메커니즘 (attention mechanism)](https://arxiv.org/abs/1409.0473)이며, 이는 단어의 의미를 시퀀스 내 다른 단어들과 관련지어 고려하는 수정된 단어 표현(어텐션 표현, attention representations)을 생성할 수 있게 합니다 (예:
## Weights and Biases 로그
[Weights and Biases](https://wandb.ai/site)는 MLOps를 위한 매우 강력한 도구입니다. 저는 이 프로젝트에 이를 통합하여 훈련 시 매우 유용한 로그와 시각화 자료가 자동으로 제공되도록 했습니다. 실제로, [프로젝트 링크](https://wandb.ai/bkoch4142/attention-is-all-you-need-paper/runs/1rbhz2as?workspace=user-bkoch4142)에서 사전 학습된 모델의 훈련 과정을 확인하실 수 있습니다. 모든 로그와 시각화 자료는 클라우드에 실시간으로 동기화됩니다.
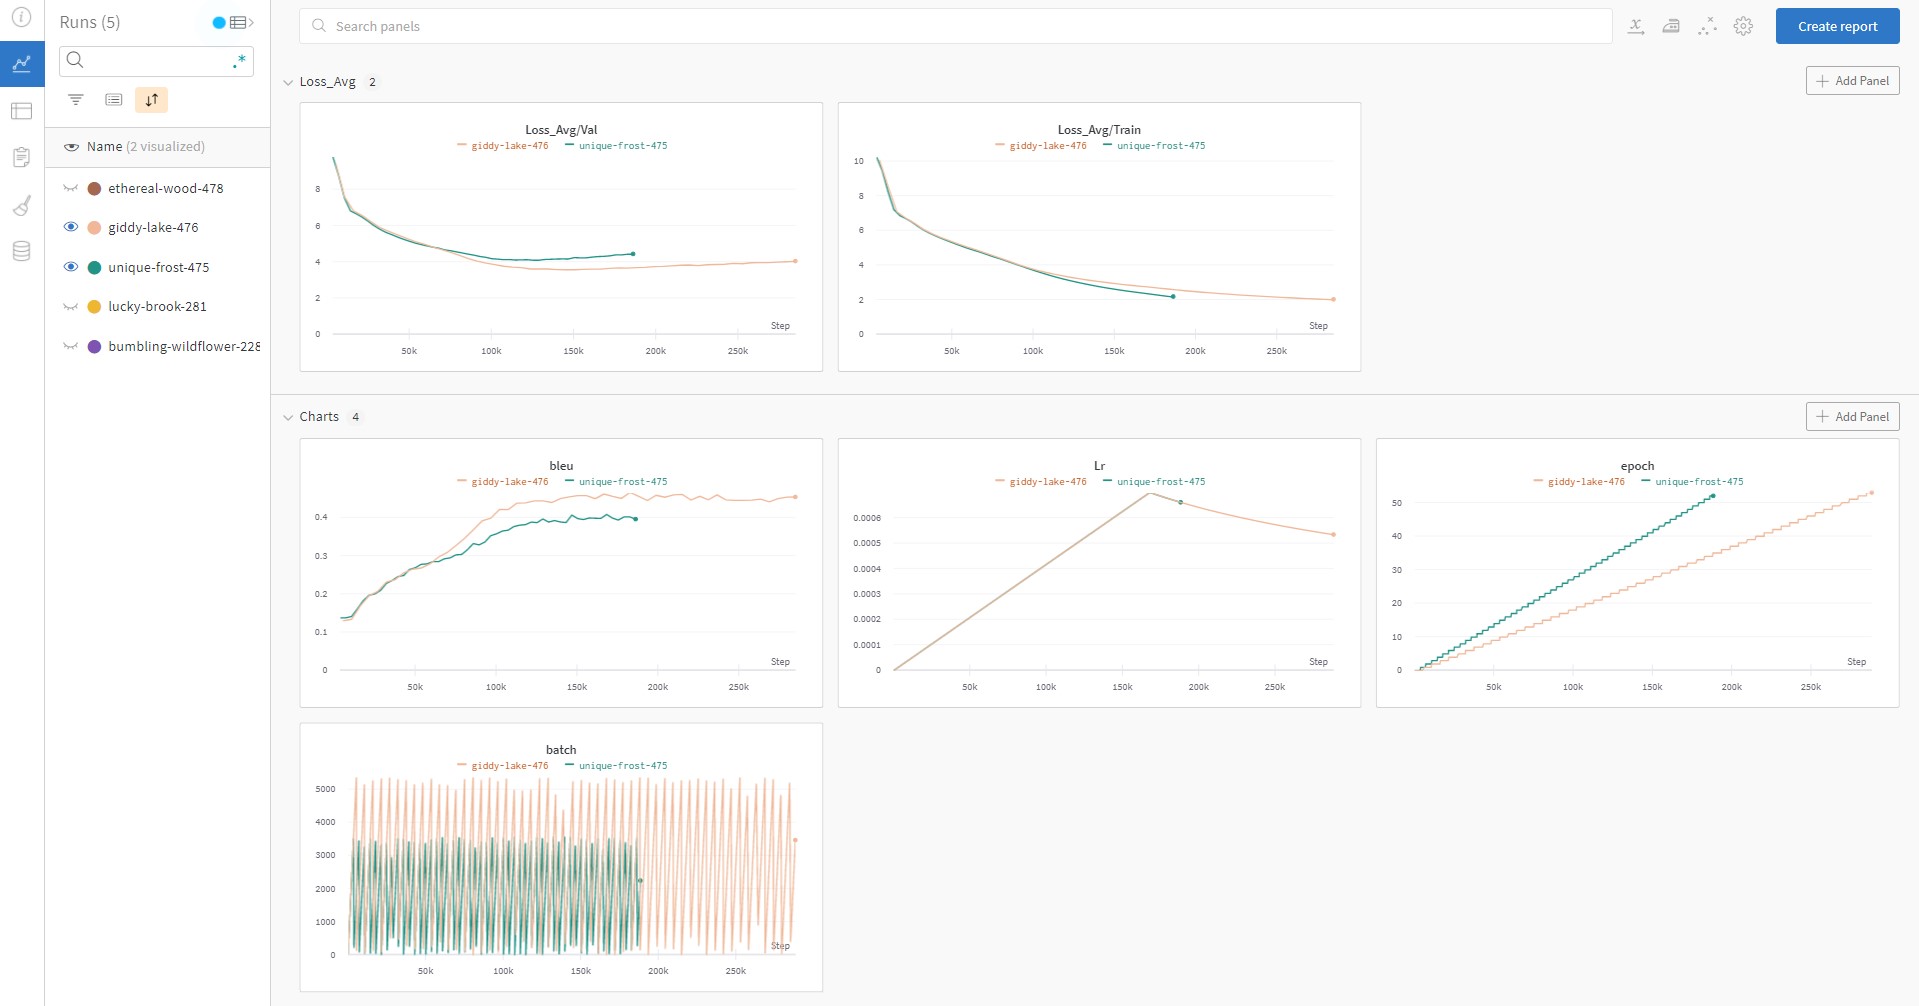
훈련을 시작하면 다음과 같은 메시지가 표시됩니다:
wandb: (1) W&B 계정 생성
wandb: (2) 기존 W&B 계정 사용
wandb: (3) 내 결과 시각화 안 함
...
시각화 자료를 클라우드에 생성하고 동기화하려면 **W&B 계정**이 필요합니다. 계정을 만들고 사용하는 데 1분도 걸리지 않으며 무료입니다. 결과를 시각화하고 싶지 않으면 옵션 3을 선택하세요.

## 인용 (Citation)
이 저장소를 인용하고 싶다면 다음 bibtex를 사용해 주세요:
@misc{Koch2021attentionisallyouneed,
author = {Koch, Brando},
title = {attention-is-all-you-need},
...
## 라이선스 (License)
이 저장소는 MIT 라이선스 하에 있습니다.
[](https://github.com/bkoch4142/attention-is-all-you-need-paper/blob/master/LICENSE)
