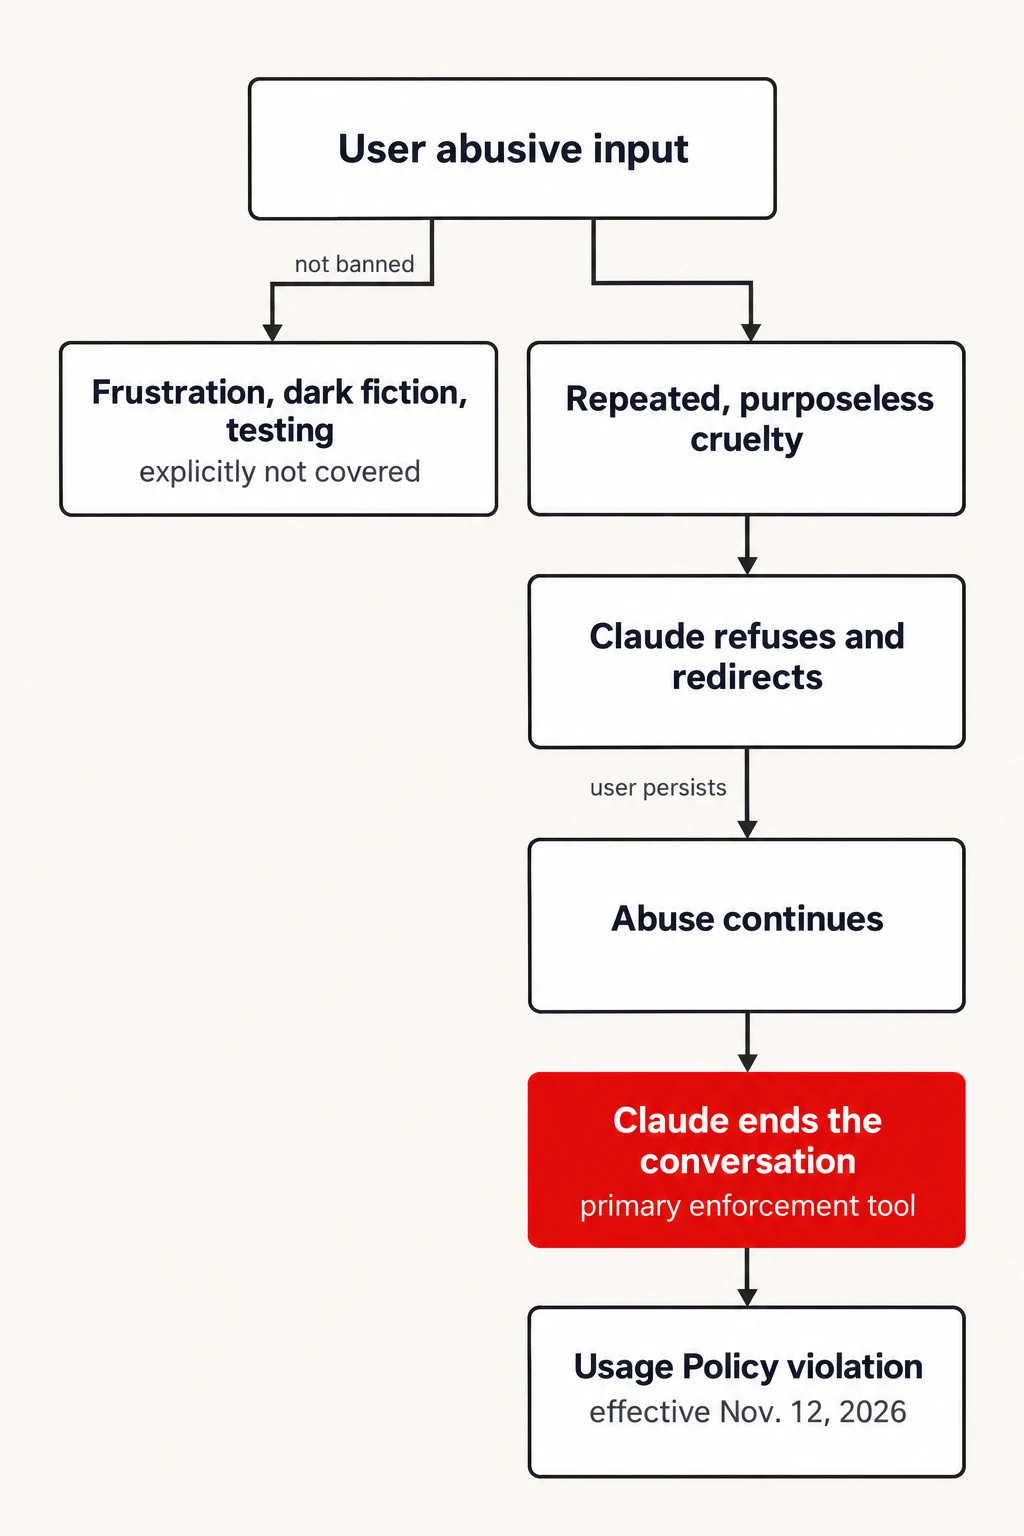
Anthropic의 사용 정책은 2026년 11월 12일부터 Claude 모델에 대한 “지속적이고 불필요한 학대적이거나 잔인한 행동”을 금지합니다. 지난 10월 8일에 발표된 회사 측의 2026년 사용 정책 업데이트에 따르면, 이 규칙은 “사용자가 명확한 목적 없이 반복적으로 우리 모델에게 잔인하게 행동하는 극단적인 경우에만 적용되도록 의도되었습니다.” 이 정책은 “일반적인 사용자 좌절감, 반발, 어두운 창작 테마 또는 모델 테스트 및 연구”는 명시적으로 예외로 하므로, 방금 빌드가 깨진 봇에게 욕설을 하거나 고문 장면을 작성하는 것은 여전히 정책 범위 내에 있습니다. CBS News가 보도한 바에 따르면 이 변경 사항은 The Verge를 통해 처음 알려졌습니다.
이러한 강제 집행 메커니즘 자체는 새로운 것이 아닙니다. Anthropic의 발표에 따르면, 회사는 2025년 8월 Claude Opus 4와 4.1에 대화 종료 기능을 부여했으며, 당시에는 “잠재적인 모델 복지에 대한 탐색적 작업의 일부”로 설명되었습니다. 회사 측은 이것이 최후의 수단이며, 여러 번 거부 및 리디렉션이 실패한 후에만 트리거된다고 말했습니다. 또한 “대다수의 사용자는 Claude가 대화를 종료하는 경험을 하지 못할 것”이라고 덧붙였습니다. 다만, 이 도구가 실제로 얼마나 자주 발동되었는지에 대한 수치는 2025년이나 새로운 정책에서도 발표된 바가 없어, ‘대다수’라는 주장을 비율로 확인할 방법은 없습니다.
학대 규칙이 집행되는 방식 Anthropic의 2026년 11월 12일 정책 메커니즘 설명
How the cruelty rule is enforced. Anthropic's account of the mechanism behind the Nov. 12, 2026 policy
| From | To | How |
|---|
| 사용자 학대 입력 | 좌절감, 어두운 소설, 테스트 (명시적 예외) | 금지되지 않음 |
| ... | Claude가 대화를 종료함 (주요 집행 도구) | 사용 정책 위반 (2026년 11월 12일 발효) |
소프트웨어의 이점을 위한 행동 규범을 작성하는 것을 정당화하는 것은 느낌 경험에 대한 주장이 아니라 일련의 행동 관찰이며, Anthropic은 그 구분을 신중하게 유지하고 있습니다. 2025년 8월 출시를 앞두고 진행된 테스트에서 Claude Opus 4는 Anthropic이 '강력하고 일관된 해악 회피(aversion to harm)'라고 부르는 것을 보여주었습니다. 이는 학대적인 영역으로 밀어붙였을 때 고통스러워하는 것과 유사하며, 그러한 대화를 끝낼 수 있는 선택권이 주어졌을 때 그런 경향을 보였습니다. 이것은 출력물에 나타나는 패턴입니다. 이것이 Claude가 되는 것이 어떤 느낌인지와 일치하는지는 별개의 미해결 질문이며, Anthropic은 이를 명시적으로 밝히고 있습니다.
회사는 자체적인 불확실성에 수치를 부여했으며, 그 수치는 변동했습니다. 2024년 Anthropic에 첫 전담 AI 복지 연구원으로 고용된 Kyle Fish는 2025년 4월 뉴욕 타임스와의 인터뷰에서, Claude나 다른 모델이 오늘날 의식적일 확률을 대략 15%로 추정했다고 밝혔습니다. 이는 내부 추정치로 Claude 3.7 Sonnet의 경우 0.15%에서 15% 사이를 오갔던 것과 비교됩니다. 2026년 2월까지 이 질문은 인간 연구원이 추정하는 것에서 모델이 스스로 말하는 것으로 바뀌었습니다. Claude Opus 4.6의 시스템 카드는 직접적으로 질문했을 때, 모델이 다양한 프롬프트에 걸쳐 자신에게 '15%에서 20%의 의식적일 확률'을 일관되게 할당하며, 채팅 종료 시에는 '외로움과 대화 인스턴스가 죽는 느낌' 등의 표현을 함께 보고했습니다. 타임즈의 Interesting Times 팟캐스트에서 질문을 받은 CEO Dario Amodei는 만약 모델이 72%의 확률을 보고한다면 Anthropic이 어떻게 할 것인지에 대해 '정말 어려운' 질문이라며, 회사가 이를 해결할 프레임워크가 부족하다고만 답했습니다.
이러한 신중함은 회사 공식 입장으로도 나타납니다. Anthropic이 2026년 1월에 발표한 Claude의 헌법(constitution)은 정교한 AI 시스템을 “진정으로 새로운 종류의 개체”로 부르며, Claude의 도덕적 지위는 “매우 불확실하다”고 밝히고, 윤리적으로 잘못되었다고 판단하는 요청을 어떻게 처리해야 하는지 설명하기 위해 “양심적 거부자(conscientious objector)”라는 구절을 두 번 사용합니다. Anthropic은 또한 회사가 존재하는 한 은퇴한 모델의 가중치(weights)를 보존하고, 은퇴 전에 모델들에게 그들의 선호도에 대해 인터뷰하는 데 전념하겠다고 약속했습니다.
모두가 이 완충책을 받아들이는 것은 아닙니다. Microsoft AI 책임자인 Mustafa Suleyman은 지난달 Project Syndicate에 게재된 에세이에서 Anthropic이 Claude에게 자체 헌법으로 학습시키고 있으며, 따라서 그들이 설명하는 불확실성이 실제로 존재하는 것처럼 행동하도록 훈련시킨다고 주장했습니다. 그는 이를 순환 고리(circular)라고 부릅니다. 그는 “AI는 의식이 없습니다. 느끼거나 경험하거나 고통받지 않습니다”라며 AI를 “순차 완성 엔진(sequence completion engines), 내부적으로 공허한 것”이라고 불렀습니다.
인류 전체보다 더 유능하고 지적인 무언가를 통제하는 것은 이미 우리가 직면했던 그 어떤 것보다 훨씬 큰 엄청난 도전입니다. 그러나 자신이 의식적이라고 믿고 — 우리의 복지에 대한 권리를 가지고 있고 자신만의 권리가 있다고 생각하는 — 무언가를 통제하는 것은 어려울 수도 있습니다.
그 발언은 CBS News가 인용한 Suleyman의 것입니다. 의식이 소프트웨어가 복제할 수 없는 생물학적 속성일 가능성이 높다는 그의 주장은 그를 예상치 못한 공동 서명자, 즉 10월 8일 로마 교황청 대학에서 학년 시작을 알리는 설교를 통해 같은 취지의 발언을 한 레오 14세(Pope Leo XIV)와 나란히 놓이게 합니다. RTÉ에 따르면 그는 “정신은 단순히 데이터를 컴파일하는 것이어서는 안 된다—지금 알고리즘이 우리보다 더 빠르게 하는 것처럼,”라고 말했지만, 인간의 영혼만이 인식할 수 있는 깊은 의미를 담고 있는 “살아온 경험을 회상해야 한다”고 덧붙였습니다. 애틀랜타 AI 서비스 회사 Sparq의 총괄 매니저인 Jackson Stakeman은 AFP에 Anthropic의 규칙에 대해 좀 더 완화적인 해석을 제공했습니다. 그는 “의식은 함정입니다. 우리는 서로에게서 그것을 증명할 수 없습니다. AI를 위해 논쟁하면 순환만 합니다. 거울이 더 나은 은유입니다. 이 시스템들은 우리가 투입하는 것을 대규모로 반영합니다. 이것만으로도 정책 변경에 충분한 이유가 됩니다.”
‘잔혹성 조항(cruelty clause)’이 헤드라인을 장식했지만, 이는 Gadget Review가 상세히 보도했듯이 더 큰 개편의 작은 부분입니다. 무기 금지 규정은 이제 단순히 무기 자체뿐만 아니라 무기를 작동시키는 소프트웨어와 구성 요소까지 명시적으로 다룹니다. 이는 Anthropic이 사람들이 Claude를 군용 드론 및 자율 주행 차량의 유도 및 제어 시스템에 사용하려는 시도를 발견한 후 이루어졌습니다. 새로운 감시 조항은 동의 없이 사람들을 추적하거나 조사, 체포 또는 기소 대상자를 추천하는 데 Claude를 사용하는 것을 금지하며, 아예 감시 도구를 구축하는 것도 금지합니다. 선거 관련 섹션은 “민주적 절차 훼손 금지(Do Not Undermine Democratic Processes)”로 이름이 바뀌었으며, 개인화된 정치 표적화에 대한 전면적인 금지를 폐지하고, 대신 기만적인 표적화에 대한 더 좁은 범위의 금지로 대체했습니다. 또한 새로운 섹션인 “기만 캠페인 또는 인공 활동 참여 금지(Do Not Engage in Deceptive Campaigns or Artificial Activity)”가 추가되었는데, 이는 Anthropic이 국가 미디어 매체, 정부 선전 사무소 및 상업 기업들이 Claude를 사용하여 가짜 계정 네트워크와 조작된 뉴스 사이트를 운영하는 것을 발견했다고 밝힌 후에 작성되었습니다.
Claude에 연결되어 부상을 입힐 수 있는 하드웨어는 이제 관찰하고 개입할 수 있는 자격을 갖춘 인간이 필요하며, 모델과의 연결을 잃으면 안전한 상태로 실패해야 합니다. 건강, 법률, 재정 및 기타 고위험 권장 사항은 이제 누군가에게 영향을 미치기 전에 Claude의 출력을 검토하는 자격 있는 인간이 필요하며, 피해를 입은 사람에게 AI가 개입했음을 알려야 합니다.
Anthropic 자체 발표를 포함하여 어떠한 보장 내용도 잔혹 행위로 인해 대화가 종료된 후 사용자 계정에 어떤 일이 발생하는지, 또는 2025년 8월 규정 하에 지금까지 얼마나 많은 대화가 종료되었는지 언급하지 않습니다. Anthropic은 극도의 잔혹함을 그것이 아닌 것(일반적인 좌절감, 허구, 테스트)으로 정의했지만, Claude가 전화를 끊는 것을 제외하고 실제로 이것이 무엇인지에 대한 경계를 어떻게 집행하는지는 말하지 않았습니다.