
AI가 코드를 작성한다면 누가 검증할까요?
요약
AI 코딩 에이전트의 급증은 개발 처리량을 높이지만, 버그와 재작업 부하를 급격히 증가시키고 있습니다. 따라서 소프트웨어 품질을 유지하면서 속도를 확보하기 위해서는 자동화된 소프트웨어 검증(automated software verification) 구축이 필수적입니다. 이는 AI 엔지니어링에 필요한 정교한 테스트 및 검증 자동화를 의미합니다.
핵심 포인트
- AI 코딩 에이전트 사용 증가는 버그와 재작업 부하를 증가시킴.
- 소프트웨어 품질 유지를 위해 자동화된 소프트웨어 검증이 필요함.
- Superpowers는 계획, TDD, 디버깅 등 규율 잡힌 개발 방법론을 강조함.
- RoboRev 같은 프레임워크가 새로운 검증 방안으로 논의됨.
AI 코딩 에이전트 시대의 자동화된 소프트웨어 검증
우리는 AI의 절정기에 살고 있으며, 점점 더 많은 개발자들이 실제로 직접 코드를 작성하거나 (때로는 리뷰하는 것조차) 없이 코드를 배포하고 있습니다. Faros가 22,000명의 개발자 4,000개 팀으로부터 2년간의 원격 측정 데이터를 분석한 2026년 연구에 따르면, 엔지니어링 처리량은 증가하고 있지만, AI 도입률이 높은 조직에서는 버그, 재작업(rework), 리뷰 부하, 프로덕션 사고가 훨씬 더 빠르게 증가하고 있습니다.
수치는 충격적입니다: Faros는 낮은 AI 도입 기간과 비교했을 때 개발자당 54% 더 많은 버그, 중앙값 PR(Pull Request) 리뷰 시간의 약 5배 증가, 그리고 PR당 세 배 이상의 사고 발생 건수를 보고했습니다. 이것들은 상관관계일 뿐이며, AI가 이러한 모든 결과의 원인이라는 증거는 아닙니다. 후속 Q3 보고서에서도 초기 효과 중 일부는 완화되고 있지만, 검증(verification), 수정(remediation), 운영 비용은 계속해서 하류로 쌓이고 있다는 것을 발견했습니다.
우리가 무엇을 하고 있는지 이해하고 개선하기 위해서는 충분히 속도를 늦춰야 합니다. 작은 팀이 방대한 AI 생성 diff를 의미 있게 리뷰할 수는 없습니다. AI가 현재 코드를 배포하는 속도에 비추어 볼 때, 평범한 리뷰 관행조차 따라잡기 어려워하고 있습니다.
그렇다면 소프트웨어 품질, 신뢰성, 유지보수성을 희생하지 않으면서 AI 지원 개발의 속도를 어떻게 유지할 수 있을까요?
간단합니다: **자동화된 소프트웨어 검증(automated software verification)**입니다. 우리가 AI 엔지니어로서 코드를 엄청난 속도로 밀어내기 위해 사용하는 것과 동일한 영리한 도구, 기술, 하네스를 사용하여 정교한 테스트 및 검증 자동화를 구축할 수 있습니다.
정당화된 신뢰와 확신을 구축하는 자동화된 소프트웨어 검증이 나아갈 방향입니다. 어떤 시스템도 버그 없는 소프트웨어를 보장할 수는 없지만, 사용자에게 도달하기 전에 문제를 포착할 더 많은 방법이 필요하기 때문입니다.
현재 무엇이 사용 가능한가요?
현재 몇 가지 개념들이 논의되고 있습니다.
슈퍼파워(Superpowers)
최근 주목받는 개념 중 하나는 Superpowers입니다. 이는 코딩 에이전트와 지원 하네스(harness)를 활용하는 에이전틱 개발 방법론이자 기술 집합체입니다. 이 방식은 에이전트가 즉시 코드 작성에 뛰어들기보다는, 보다 규율 잡힌 소프트웨어 엔지니어처럼 행동하도록 장려합니다.
예를 들어, 단순히 가정하는 것 대신 실제로 무엇을 구축하고 있는지 다듬는 데 도움을 줄 수 있습니다. 계획(planning), 테스트 주도 개발(test-driven development), 디버깅(debugging), 그리고 별도의 에이전트가 작업을 검토하는 것을 포함한 리뷰를 강조합니다.
이는 훌륭한 시작점입니다. 하지만 작업에 따라 전체 방법론을 따르는 것이 개발 속도를 늦출 수 있으며, 여전히 우리 코드의 정확성과 보안에 대한 신뢰를 얻는 데 필요한 광범위한 점검들을 대체하지는 못합니다. 어떤 플러그인만으로도 소프트웨어를 버그나 취약점으로부터 자유롭게 만들 수는 없습니다.
RoboRev
또 다른 흥미로운 프레임워크인 RoboRev는 널리 사용되는 pandas 라이브러리의 개발자인 Wes McKinney에게서 나왔습니다. RoboRev는 지속적인 AI 코드 리뷰를 로컬 개발 루프(local development loop)로 가져옵니다.
이 아이디어는 매우 설득력이 있습니다. 마치 대면 동료 검토(in-person peer reviews)처럼, 우리가 사용하는 첫 번째 LLM이 작성한 코드를 또 다른 LLM이 검토하게 할 수 있다는 것입니다. 별도의 리뷰어, 특히 다른 모델을 사용한다면, 작성 에이전트가 놓친 실수나 아키텍처 문제를 포착할 수 있습니다. 이는 또 하나의 관점일 뿐이며, 편향되지 않거나 정확한 리뷰를 보장하는 것은 아닙니다.
일반적인 RoboRev 설정에서는 코드를 커밋하면 로컬 데몬(local daemon)이 구성된 코딩 에이전트를 사용하여 해당 커밋을 자동으로 검토합니다. 이 과정에서 발견된 사항들은 현재 사용 중인 LLM과 코딩 하네스에 다시 피드백할 수 있도록 제시되어, 컨텍스트가 아직 신선할 때 문제를 수정할 수 있게 합니다.
RoboRev는 후속 리뷰 워크플로우(follow-up review workflows)와 목표 지향적 검토 작업(targeted review tasks)도 지원합니다. 이 매력적인 점은 검증이 개발 주기 자체의 일부가 되기 때문에, 마지막에 기억해서 해야 하는 일이 아니라는 것입니다. 해당 문서에는 사용 가능한 명령어와 통합 기능들이 설명되어 있습니다.
하지만 코드 리뷰라는 개념 자체가 새로운 것은 아닙니다. 2026년에는 Claude, Codex, GitHub Copilot, Cursor, Greptile, CodeRabbit, Qodo와 같은 제공업체들이 AI 기반의 코드 리뷰를 제공합니다.
이 모든 것을 설명하는 것은 가장 기술에 밝은 엔지니어조차도 잠들게 할 것이므로, 대신 주요 서비스들에 집중해 보겠습니다.
Claude 코드 리뷰
Anthropic에서 호스팅하는 코드 리뷰는 강력한 PR(Pull Request) 검토기입니다. GitHub 풀 리퀘스트에서 실행되면 여러 전문 에이전트를 병렬로 보내 변경 사항을 조사하고, 논리 오류, 보안 취약점, 회귀 현상(regressions), 놓친 엣지 케이스 등을 찾습니다.
목표는 빠르고 로컬에서 수행하는 검토보다 시간이 더 오래 걸리고 비용이 더 많이 들 수 있는 심층적인 리뷰입니다. 2026년 10월 기준으로, Anthropic은 이 호스팅 서비스를 Team 및 Enterprise 플랜에 대한 연구 미리보기(research preview)로 제공하며, 별도의 사용량 기반 청구가 이루어집니다.
또한 Claude Code용으로 Anthropic이 관리하는 /code-review 플러그인도 있습니다. 이는 코딩 워크플로우에서 리뷰를 실행하고 그 결과를 PR에 게시할 수 있습니다. 이 서비스는 호스팅된 리뷰 서비스와 다른 워크플로우이므로, 깊이, 설정 또는 가격 면에서 동일하다고 간주하지 않는 것이 좋습니다. 검토가 포함되어 있다고 가정하기 전에 플랜 및 사용 약관을 확인하세요.
OpenAI Codex 리뷰
Codex 코드 리뷰는 저장소의 컨텍스트와 지침에 따라 풀 리퀘스트를 검토하는 것과 유사한 접근 방식을 취합니다. 연결된 GitHub PR에서 @codex review로 리뷰를 요청하거나 자동 리뷰를 구성할 수 있습니다. Codex는 또한 PR이 존재하기 전에 로컬 변경 사항을 검토하는 것도 지원합니다.
검사하고 싶은 내용에 대해 더 상세하게 설명할 수 있습니다: diff, PR, 보안 문제, 또는 명세서 준수 여부 등입니다. 만약 리뷰에서 문제가 발견되면, Codex에게 수정안을 준비하도록 요청하고, 결과로 나온 변경 사항을 검사한 다음, 리뷰를 반복할 수 있습니다. 이는 유용한 '리뷰 및 복구(review-and-repair)' 루프를 제공하지만, 리뷰와 구현은 여전히 독립적인 검증이 필요합니다.
GitHub Copilot 코드 리뷰
GitHub는 가장 간단하고 수동 개입이 적은 접근 방식을 제공합니다. Copilot Code Review를 구성하여 PR(Pull Request)을 자동으로 검토하고, 리포지토리의 지침을 따르며, 적용하거나 Copilot 코딩 에이전트에게 전달할 수 있는 수정 사항을 제안하도록 할 수 있습니다.
매우 원활하지만, 그 피드백을 맹목적으로 받아들이기 시작하면 문제가 발생합니다. Copilot은 보통 승인 검토(approving review) 대신 댓글을 남기는 경향이 있지만, GitHub는 일부 설정에서 승인을 구성하는 것을 지원합니다. 어느 쪽이든, 자동화된 검토가 안전한 병합 결정과 같지는 않습니다.
단점은 이 검토 경험이 DIY 에이전트 워크플로우보다 더 관리된다는 것입니다. 지침을 사용자 정의할 수는 있지만, 자체 코딩 에이전트를 호출할 때 얻는 것과 같은 직접적이고 실행별 모델 구성(model configuration)은 할 수 없습니다.
Cursor Bugbot
Cursor Bugbot은 GitHub PR을 자동으로 검토하여 논리 버그 및 기타 문제를 찾고, 발견된 내용을 Cursor에서 처리할 수 있게 합니다. 또한 Autofix 기능을 통해 클라우드 에이전트를 거쳐 수정 사항을 제안할 수도 있습니다.
가장 큰 장점은 이미 Cursor를 사용하는 팀에게 편리하다는 것입니다. 단점은 모델 선택과 검토 오케스트레이션(review orchestration)의 상당 부분이 완전히 사용자 정의 가능한 워크플로우로 노출되기보다는 Cursor에 의해 처리된다는 점입니다. Cursor는 프론티어 모델(frontier model)과 사내 모델을 조합하여 사용한다고 밝히고 있습니다.
한 명의 검토자로 충분하지 않다
저는 강력한 코딩 모델이 코드를 작성하고 별도의 강력한 모델이 이를 검토하는 것이 좋습니다. 서로 다른 모델은 서로 다른 관점을 가져올 수 있지만, 모델 다양성이 마법은 아닙니다. 두 에이전트가 동일한 잘못된 답변에 동의하거나, 동일한 요구 사항을 간과하거나, 존재하지 않는 버그를 자신 있게 플래그 지정할 수도 있습니다.
실질적인 교훈은 AI 검토를 LLM(대규모 언어 모델)의 판단에 의존하지 않는 확인 절차와 결합하는 것입니다. 그리고 이상적으로는, 특히 위험도가 높은 변경 사항에 대해서는 최종 결정에 대한 책임을 인간이 지니도록 유지해야 합니다.
좋습니다. 코드를 검토할 수는 있습니다. 하지만 코드가 명세(spec)를 충족하고, 버그나 취약점을 도입하지 않으며, 실수로 비밀 정보를 노출하지 않는다는 확신을 높이기 위해 할 수 있는 것이 훨씬 더 많습니다.
그것이 바로 다음에 다룰 내용입니다.
AI 시대와 자동화된 소프트웨어 개발에서의 CI/CD 파이프라인
여기에 가능한 것들의 *상위 집합(superset)*으로 구축된 포괄적인 검증 파이프라인을 소개합니다. 각 단계는 코드가 의도한 대로 작동한다는 확신을 더할 수 있지만, 모든 팀이 모든 검사를 필요로 하는 것은 아니며, 어떤 검사 세트도 소프트웨어가 완벽함을 증명할 수는 없습니다. 이러한 광범위한 철학은 소프트웨어 공학에서 잘 정립되어 있으며 NIST의 Secure Software Development Framework와 같은 프레임워크와 일치합니다.
긴 텍스트가 싫으신가요? 이 섹션 끝에 전체 파이프라인 다이어그램이 있습니다.
코드 품질 및 빌드 검사
린터(Linter) 검사: 스타일 위반 및 일반적인 실수를 확인합니다.
포매터(Formatter) 검사: 들여쓰기나 간격 등 포맷팅이 규칙을 따르는지 확인합니다.
타입 검사(Type checking): TypeScript와 같은 타입 지정 언어를 사용하는 경우, 타입이 올바르게 사용되었는지 확인합니다.
컴파일/빌드 검사(Compilation/build checks): 애플리케이션이 성공적으로 컴파일되거나 빌드되는지 확인합니다.
자동화 테스트
단위 테스트(Unit tests): 개별 기능 단위가 의도한 대로 작동하는지 테스트합니다.
통합 테스트(Integration tests): API, 데이터베이스, 결제 제공업체에 연결되는 결제 흐름과 같이 여러 구성 요소가 함께 작동하는지 테스트합니다.
종단 간 테스트(End-to-end (E2E) tests): 애플리케이션 전반에 걸쳐 중요한 사용자 워크플로우를 처음부터 끝까지 검증합니다.
보안 및 의존성 검사
정적 애플리케이션 보안 테스트(Static application security testing, SAST): 소스 코드를 잠재적인 보안 취약점과 관련된 패턴에 대해 스캔합니다.
시크릿 스캐닝(Secret scanning): 저장소에 실수로 포함된 비밀번호, 키 또는 민감한 자격 증명을 찾습니다.
의존성 취약점 스캐닝(Dependency vulnerability scanning): 패키지 의존성에서 알려진 취약점을 찾습니다.
의존성 최신 상태 및 지원 현황(Dependency freshness and support status): 주의가 필요할 수 있는 오래되거나 지원되지 않는 패키지를 식별합니다.
에이전트 기반 코드 검토 (Agentic code review)
일반 버그 스캐닝: AI 에이전트를 사용하여 발생 가능성이 높은 버그를 찾아 플래그 지정합니다.보안 중심 검토: 규칙 기반 스캐너가 포착할 수 있는 범위를 넘어 잠재적인 보안 위험을 조사하는 데 AI 에이전트를 사용합니다.명세서 대비 검토: 최신 PR(Pull Request) 또는 기능 브랜치가 요청된 동작을 구현했는지, 중요한 엣지 케이스를 포함하여 확인합니다.
인프라 및 데이터베이스 검사
컨테이너 및 인프라 구성 스캐닝: 컨테이너와 클라우드 인프라의 보안 설정 오류나 잘못된 구성을 찾습니다.데이터베이스 마이그레이션 유효성 검사: 스키마 변경 사항을 배포해도 안전한지, 데이터 손실이나 다운타임을 유발할 수 있는지, 또는 롤백을 어렵게 만들지는 않은지 평가합니다.
아키텍처 및 유지보수성 검토
코드 비대화(Bloat), 복잡성, 아키텍처 단순화 점검: AI 에이전트를 사용하여 불필요한 코드, 과도한 설계(overengineering), 지나친 복잡성을 식별하고 구현을 단순화할 기회를 찾습니다.
기억해 둘 만한 기타 검사
애플리케이션에 따라 성능 및 부하 테스트, 접근성 검사, 개인 정보 보호 및 규정 준수 검사, 그리고 소프트웨어 라이선스/공급망(supply-chain) 검사를 추가합니다. 보안적으로 배포된 시스템이라도 느리거나, 접근성이 떨어지거나, 데이터를 잘못 처리할 수 있습니다. 이러한 검사는 모든 커밋에서 실행될 필요는 없지만, 전체 프로세스에 포함되어야 합니다.
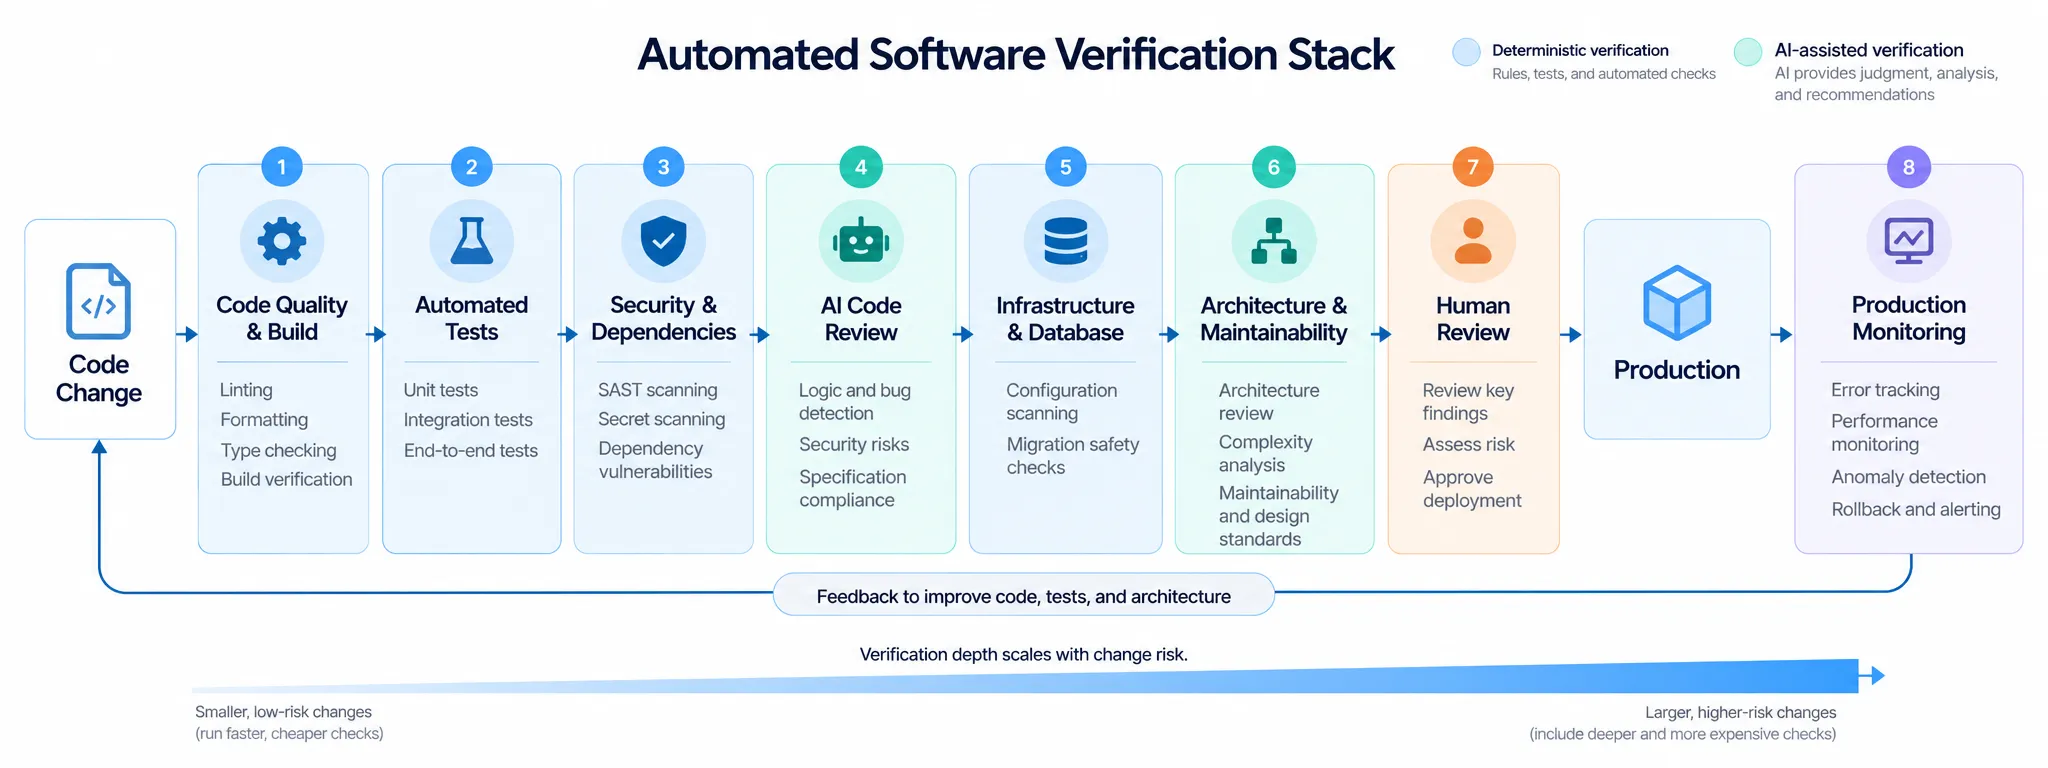
이 모든 것을 종합하면, 어떻게 이러한 검사들을 구성할 수 있을까요?
우리가 논의했던 대부분의 검증 패턴은 수십 년 동안 확립된 관행이었으며, 주요 플랫폼들은 이미 이를 자동화하는 도구를 제공합니다. GitHub Actions, GitLab CI/CD, 그리고 Jenkins가 일반적인 오케스트레이션(orchestrate) 방법입니다.
예를 들어 GitHub Actions를 살펴보겠습니다. 개발자들은 리포지토리 내에 저장된 YAML 파일에 자동화 워크플로우를 정의합니다. 이 워크플로우는 코드를 푸시하거나, PR을 열거나, 변경 사항을 병합할 때 트리거될 수 있습니다. 그러면 GitHub가 실행 환경(runner)을 시작하고 워크플로우 단계를 실행합니다.
AI 자동 생성 콘텐츠
본 콘텐츠는 HN OpenAI Codex의 원문을 AI가 자동으로 요약·번역·분석한 것입니다. 원 저작권은 원저작자에게 있으며, 정확한 내용은 반드시 원문을 확인해 주세요.
원문 바로가기