데이터가 무엇을 의미하는지 아는 것이 기초입니다. 사람과 에이전트가 그 의미를 바탕으로 행동하게 하고, 그것이 허용되었음을 증명하는 것은 이 기초 위에 쌓는 것입니다. 컨텍스트(Context)는 시맨틱스(Semantics), 상태(State), 그리고 제어(Controls)의 스펙트럼을 관통합니다.
Forrester와 Gartner가 같은 분기에 경쟁적인 컨텍스트 레이어 정의를 발표할 때, 그 단어는 주류가 됩니다. Google이 폐지된 항공사의 내부 비즈니스 데이터를 1,000만 달러에 구매할 때, 그 가치는 주류입니다. W3C와 Google이 기계가 읽을 수 있는 위키의 경쟁적인 형식을 발표할 때, 인프라(plumbing)는 주류가 됩니다.
주류라는 것이 정착되었다는 의미는 아니지만, 어떤 면에서 보아도 시맨틱스(semantics)는 컨텍스트의 핵심 부분입니다. 시맨틱스를 정의해야 할 필요성이 온톨로지(ontology)의 부활을 이끌었습니다. 지금 온톨로지에 대해서는 두 가지가 동시에 사실입니다.
온톨로지는 그 어느 때보다 필수적이며, 프롬프트(prompt)가 아니라 가드레일(guardrail)입니다. 그것은 데이터가 무엇을 의미하는지 알려주고, 시스템의 가정을 명시적으로 만들고 기계가 처리할 수 있게 합니다. 어려운 부분은 API를 호출하는 것이 결코 아니었습니다. 그 행동이 허용되는지 아는 것입니다.
온톨로지는 이토록 과대광고되거나 위조하기 쉬웠던 적이 없습니다. AI는 숙련된 온톨로지학자보다 더 빨리 그럴듯해 보이는 스키마를 작성할 수 있습니다. 하지만 시맨틱 모델의 비용이 0에 가까워지고, 누구나 하나를 생성할 수 있게 되면서—누가 좋은 것과 나쁜 것을 가려낼 것이며, 왜 사람들이 합치될까요?
그래프는 사물들이 어떻게 관련되는지를 모델링하고 거버넌스(govern)하는 적절한 장소일 수 있습니다. 특히 온톨로지 같은 것은 작고, 상대적으로 변화가 느리며, 진정으로 그래프 형태를 띱니다. 그래프는 런타임에 컨텍스트를 선택함으로써 도움을 줄 수 있습니다. 정의, 검증, 그리고 목표 설정은 여전히 인간의 영역입니다.
이 문제에는 네 가지 흐름이 관통하고 있습니다. 거버넌스는 프롬프트에서 가드레일로 이동합니다: 온톨로지는 사물들이 무엇을 의미하는지뿐만 아니라 에이전트가 그것들에 대해 무엇을 할 수 있도록 허용할지를 결정합니다. 신뢰는 실제 병목 현상이 됩니다. 이제 그럴듯한 온톨로지를 생성하는 것이 비용이 들지 않지만, 하나를 검증하는 것은 여전히 모든 것을 필요로 하기 때문입니다.
엔지니어링이 루프(loop)에서 그래프로 이동하다: 한 에이전트가 원을 그리며 추측하는 것과, 지난주에 무슨 일이 있었는지 그리고 누가 소유해야 하는지를 기억하는 매핑된 시스템의 차이를 비교해 봅시다. 인프라와 검증이 여기에 도래했습니다: 그래프 툴링과 사용 사례가 급증하고 있으며, 시장은 10배 이상 성장할 것으로 예측되고 있고, 인수합병(acquisition) 시즌도 열렸습니다.
📋 목차
- 컨텍스트 정의하기
- 차별화 요소로서의 지식 및 컨텍스트 그래프
- 컨텍스트 = 지식 + 전문성 + 규범
- 온톨로지가 AI 에이전트가 검색(retrieval)에서 실행(execution)으로 나아가도록 돕는 방법
- AI 에이전트를 위한 그래프 엔지니어링
- 그래프가 AI 에이전트의 메모리 문제를 해결하는 데 도움을 줄 수 있는 이유
- LLM 위키 및 지식 그래프 형식과 레시피
- 온톨로지로 작업할 준비가 된 주체는 누구인가
- 온톨로지 교육 및 자동화
- 온톨로지 생태계의 진화
- 의미(Meaning) → 순회(Traversal) → 추론(Reasoning) → 행동(Action)
- GraphRAG가 작동하는 경우와 그 방향성
- 지식 그래프 시장 견인력과 구현 사례
- 그래프 사용 사례, 툴 및 리소스
'Year of the Graph' 이 호는 metaphacts, Graphwise, Cambridge Intelligence, Tentris, yWorks, packt, State of the Graph, Connected Data London에서 제공합니다.
다가오는 호에 소개되거나 이 작업에 대한 지원을 원하시면 연락 주십시오!
엔터프라이즈 정보 아키텍처가 신뢰할 수 있는 그래프 AI를 여는 방법
George Anadiotis's image-4a3b
의미론적 지식 레이어(semantic knowledge layer)에 기반을 둔 엔터프라이즈 정보 아키텍처는 분산된 데이터베이스들을 상호 연결되고 기계가 실행 가능한 구조물로 연결하여, 신뢰할 수 있는 그래프 AI와 자연어 질의를 구동합니다. 복잡한 '폐기하고 교체하는(rip-and-replace)' 프로젝트 대신, 이는 사일로화된 데이터를 엄격한 거버넌스(governance)가 내장된 상태로 AI 준비가 된 엔터프라이즈 지식으로 풀어냅니다.
metaphacts의 무료 백서에서 의미론적 지식 그래프가 기업 데이터와 신뢰할 수 있는 AI를 어떻게 연결하는지 알아보세요.
컨텍스트 정의하기
모두에게 컨텍스트 레이어(context layer)가 필요하지만, 정확히 그것이 무엇이며 어떻게 얻을 수 있을까요? 수조 달러 규모의 기회가 될 것이라고 여겨지는 것에 대해 던질 만한 합리적인 질문입니다. 신흥 시장으로서 컨텍스트 레이어는 너무 오래 정의되지 않은 상태로 머무를 수 없습니다.
Forrester는 '컨텍스트 레이어'에 대한 정의를 제시했고, 지식 그래프 커뮤니티가 이를 철저히 검증했습니다. Forrester의 전제는 다음과 같습니다: 시맨틱스(semantics), 온톨로지(ontology), 시맨틱 레이어(semantic layer), 지식 그래프(knowledge graph), 그리고 컨텍스트 레이어가 상호 교환 가능한 유행어(buzzwords)가 되었다는 것입니다. 몇 달간의 실무자 인터뷰 끝에 그들이 제안한 해결책은 다음과 같습니다:
컨텍스트 레이어는 시맨틱 레이어와 지식 그래프의 다음 진화 단계입니다. 이는 전자의 비즈니스 시맨틱스와 거버넌스(governance)를 후자의 온톨로지 모델링과 결합하고, 런타임 이벤트(runtime events), 의사결정(decisions), 결과(outcomes)와 함께 지속적으로 업데이트하여 기업의 살아있는 모델을 형성합니다.
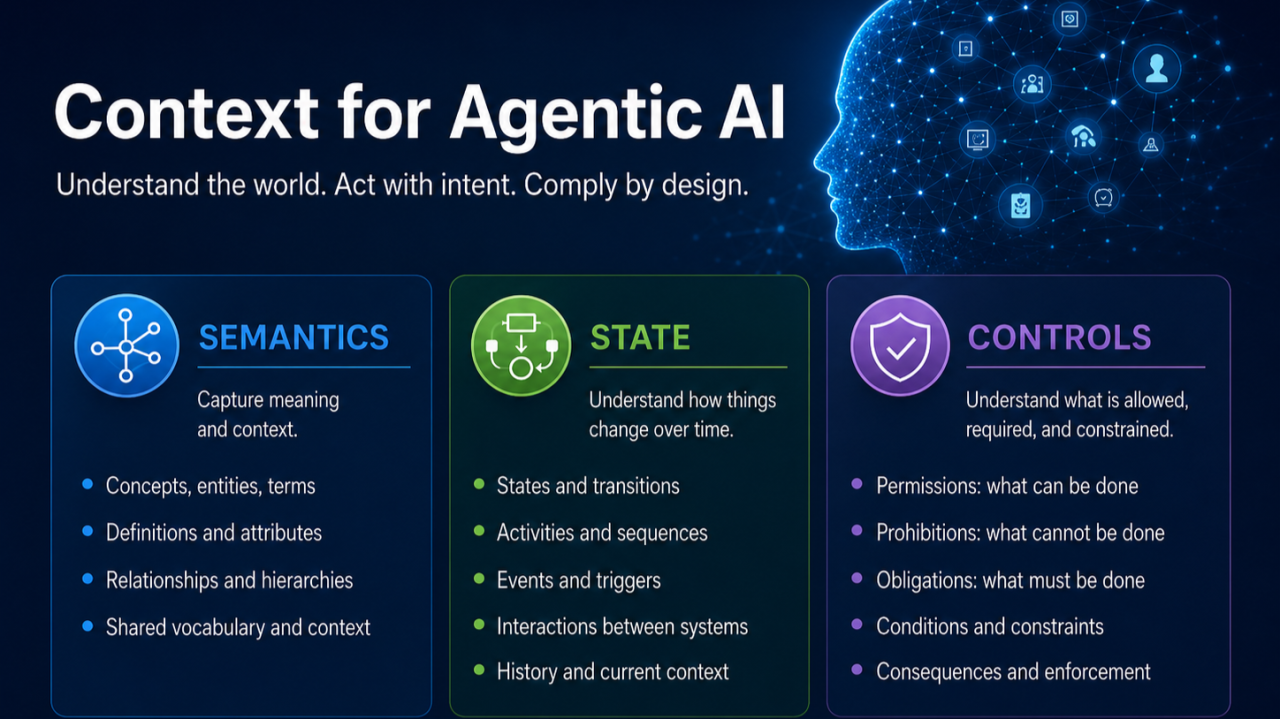
Context for agentic AI. Image: Dan Everett
IDC의 리서치 디렉터인 Dan Everett는 컨텍스트를 “어떤 정보가 관련성이 있는지, 그리고 효과적인 의사결정과 행동을 지원하기 위해 그것이 어떻게 해석되어야 하는지를 제약하는 상황 또는 조건”으로 정의합니다. 에버릿은 지식 그래프가 실제로 얼마나 많은 컨텍스트를 제공하는지 질문합니다.
사람들이 지식 그래프가 에이전틱 AI(agentic AI)에 필요한 컨텍스트를 제공한다고 주장할 때, 에버릿은 이것이 부분적으로만 사실이라고 주장합니다. '에이전틱 AI를 위한 컨텍스트 레이어'라는 많은 주장은 재활용된 시맨틱 레이어를 기반으로 합니다. 이 정의가 에이전틱 AI의 요구사항으로 전환되려면, 시맨틱스(semantics), 상태(state), 그리고 제어 장치(controls)가 필요합니다.
시맨틱스: 개념(concepts), 개체(entities), 용어(terms), 정의(definitions), 관계(relationships).
상태: 상태와 전이(states and transitions), 활동과 순서(activities and sequences), 시스템 간의 상호작용(interactions between systems).
제어 장치: 어떤 행동을 할 수 있는지, 어떤 조건 하에서 가능한지, 그리고 그로부터 무엇이 발생하는지를 관리하는 권한(permissions), 금지 사항(prohibitions), 의무(obligations).
25개 산업 리더들이 성공적인 AI 전략을 공유합니다
George Anadiotis's image-6d0ce
AI를 파일럿 단계에서 프로덕션으로 옮긴 과정에서의 거버넌스 프레임워크, 아키텍처 결정, 구현 접근 방식에 대해 들어보세요. 두 날짜 모두 온라인으로 진행되며 완전히 무료입니다. 한 번 등록하면 팀과 언제든지 공유할 수 있는 전체 녹화 세션 라이브러리를 얻게 됩니다.
차별점으로서의 지식 그래프와 컨텍스트 그래프
Gartner는 또한 지식 그래프(knowledge graphs)와 컨텍스트 그래프(context graphs) 사이의 중요한 차이점을 강조합니다. 지식 그래프는 상태, 개체, 관계 등 '무엇이 존재하는지'를 모델링합니다. 반면, 컨텍스트 그래프는 움직임, 의사결정 흐름, 이벤트 추적 등 '상태가 시간에 따라 어떻게 변화하는지'를 모델링합니다. 이 둘은 함께 작동합니다: 지식 그래프가 도메인 이해도를 공급하고, 컨텍스트 그래프가 판단(judgment)을 공급합니다.
Gartner는 2028년까지 AI 에이전트 시스템의 50% 이상이 컨텍스트 그래프 위에서 실행될 것으로 예측했습니다. 그리고 별도로, 같은 해에 컨텍스트 엔지니어링은 AI 구축 도구의 80%에 내장되어 에이전트 정확도를 최소 30% 향상시킬 것이라고 합니다.
Gartner의 분석은 여기에 도달하기 위해 필수적인 네 가지 역량을 지적합니다: 워크플로우와 채널 전반에 걸친 의사결정 추적(decision traces)의 체계적인 포착. 고정된 스키마가 아닌 실행 데이터로부터 구조를 나타낼 수 있는 컨텍스트 인식 계보 그래프(Context-aware lineage graphs). AI 관측 가능성(AI observability) – 에이전트가 그래프에서 읽고, 감사 가능한 추적(auditable traces)으로 다시 작성하는 것. 에이전트 행동을 개선하는 지속적인 학습 루프(Continuous learning loops).
전략적 이해관계도 명확하게 제시됩니다: LLM이 상품화됨에 따라 모델 자체가 아니라 독점적인 컨텍스트가 차별점이 됩니다. Andrea Volpini의 말처럼, 당신은 모델을 소유할 수는 있지만 의미는 아웃소싱할 수 있습니다. 자신들의 의사결정 로직을 소유한 조직은 다른 누구도 복제할 수 없는 에이전트를 구축합니다. 사례로 Google이 최근 폐업한 Spirit Airlines의 내부 비즈니스 데이터를 1,000만 달러에 구매하기로 합의한 것이 있습니다.
Ben Lorica는 기업들이 보존하는 대부분의 것이 결과 기록일 뿐이며, 작업을 수행하려는 에이전트가 최종 결과 이상의 것을 필요로 할 수 있다고 지적합니다. 이것이 여러분의 Slack 아카이브가 갑자기 경쟁 우위(competitive moat)가 된다는 의미는 아닙니다. 직장 내에서 나오는 부산물(workplace exhaust) 대부분은 그저 부산물일 가능성이 높습니다. Lorica는 세 가지 유용한 계층을 식별합니다.
가장 아래쪽에는 메시지, 회의록, 티켓, 커밋, 클릭 기록, 로그 등이 있습니다. 그 위에는 궤적(trajectories)이 있는데, 여기서 이러한 파편들이 목표에서 결정으로, 행동으로, 결과로 연결된 순서열로 구성됩니다. 이는 비록 그렇게 이름 붙여지지 않았더라도 컨텍스트 그래프(context graph)와 정확히 유사하게 들립니다. 가장 가치 있는 계층은 이러한 궤적들로부터 구축할 수 있는 것들입니다: 좋은 예시, 실패 사례, 평가, 수정 사항, 그리고 재사용 가능한 워크플로우입니다.
GraphRAG는 뛰어난 그래프 시각화가 필요합니다
그래프 시각화는 사용자가 답변에 어떻게 도달했는지 이해하고, 기본 데이터의 이상 징후를 발견하며, 복잡한 경로와 관계를 파악하는 데 도움을 줍니다. 그리고 첫 번째 답변이 또 다른 질문을 제기할 때, 대화형 시각화(interactive visualization)는 사용자에게 계속 탐색할 수 있는 방법을 제공합니다.
저희의 무료 가이드에서는 데이터 모델링과 레이아웃부터 시각적 노이즈 감소 및 적절한 기술 선택에 이르기까지 효과적인 그래프 시각화의 기초를 다룹니다.
컨텍스트 = 지식 + 전문성 + 규범(Norms)
Prukalpa는 컨텍스트 = 지식 + 전문성 + 규범이라고 주장합니다. 이 엔터프라이즈 컨텍스트 계층은 세 가지 요소를 에이전트가 사용할 수 있는 기계적 컨텍스트로 변환합니다. 여기에는 두 개의 절반이 있습니다. AI 준비 데이터와 지식 그래프를 포함하는 핵심 기반(core substrate)과, 의미론 및 온톨로지(공유된 의미 계층), 그리고 스킬(재사용 가능하고 버전 관리되며 테스트 가능한 절차적 지식 단위)로 구성된 세 가지 긴밀하게 통합된 부분이 있습니다.
여기에 추가적으로 상위에 실행되는 다섯 가지 기능이 있습니다: 컨텍스트 마이닝, 컨텍스트 자체를 위한 개발 수명 주기, 복합 학습 루프(compounding learning loops), 여러 인터페이스에 걸친 활성화 및 검색, 그리고 거버넌스 및 관찰 가능성입니다.
Florence Benezit은 에이전트가 접근하는 데이터 아키텍처가 현재의 진실을 저장하는 데는 탁월하지만, 그것이 어떻게 그렇게 되었는지(과정)를 보존하도록 설계되지는 않았다고 지적합니다. 그녀가 제안하는 해결책도 유사합니다. 세 개의 계층을 쌓아 올리는 것입니다: 지식 그래프 (knowledge graphs), 온톨로지 (ontologies), 그리고 컨텍스트 그래프 (context graphs).
Pramod Sadalage와 Prem Chandrasekaran은 에이전트가 데이터의 주요 소비자(primary consumers)가 될 때, 데이터 아키텍처 자체가 AI 아키텍처가 된다고 덧붙입니다. 그들은 에이전트 기반 AI(agentic AI)를 위해 데이터를 준비시키는 'AI-ready data stack'을 소개합니다.
데이터 신뢰성을 높이기 위한 데이터 계약 (data contracts)과 품질 확보, 그리고 에이전트가 왜 행동했는지 기록하고 접근 범위를 제한하는 추적성 (traceability) 및 거버넌스(governance)를 통해 데이터를 추적 가능하고 관리되게 만듭니다. 컨텍스트 계층은 엔티티와 관계에 대한 도메인 모델, 분석 스토어의 SQL로 컴파일된 메트릭에 대한 시맨틱 모델, 그리고 라이브 시스템에 대한 보호된 읽기 및 액션의 역량 모델을 인코딩하며, 이 세 가지 모두에 걸쳐 출처(provenance) 신호를 제공합니다. 이를 기반으로 에이전트는 라이브 시스템에 쿼리하고 다시 쓸 수 있게 되어 데이터를 운영 가능하게 만듭니다.
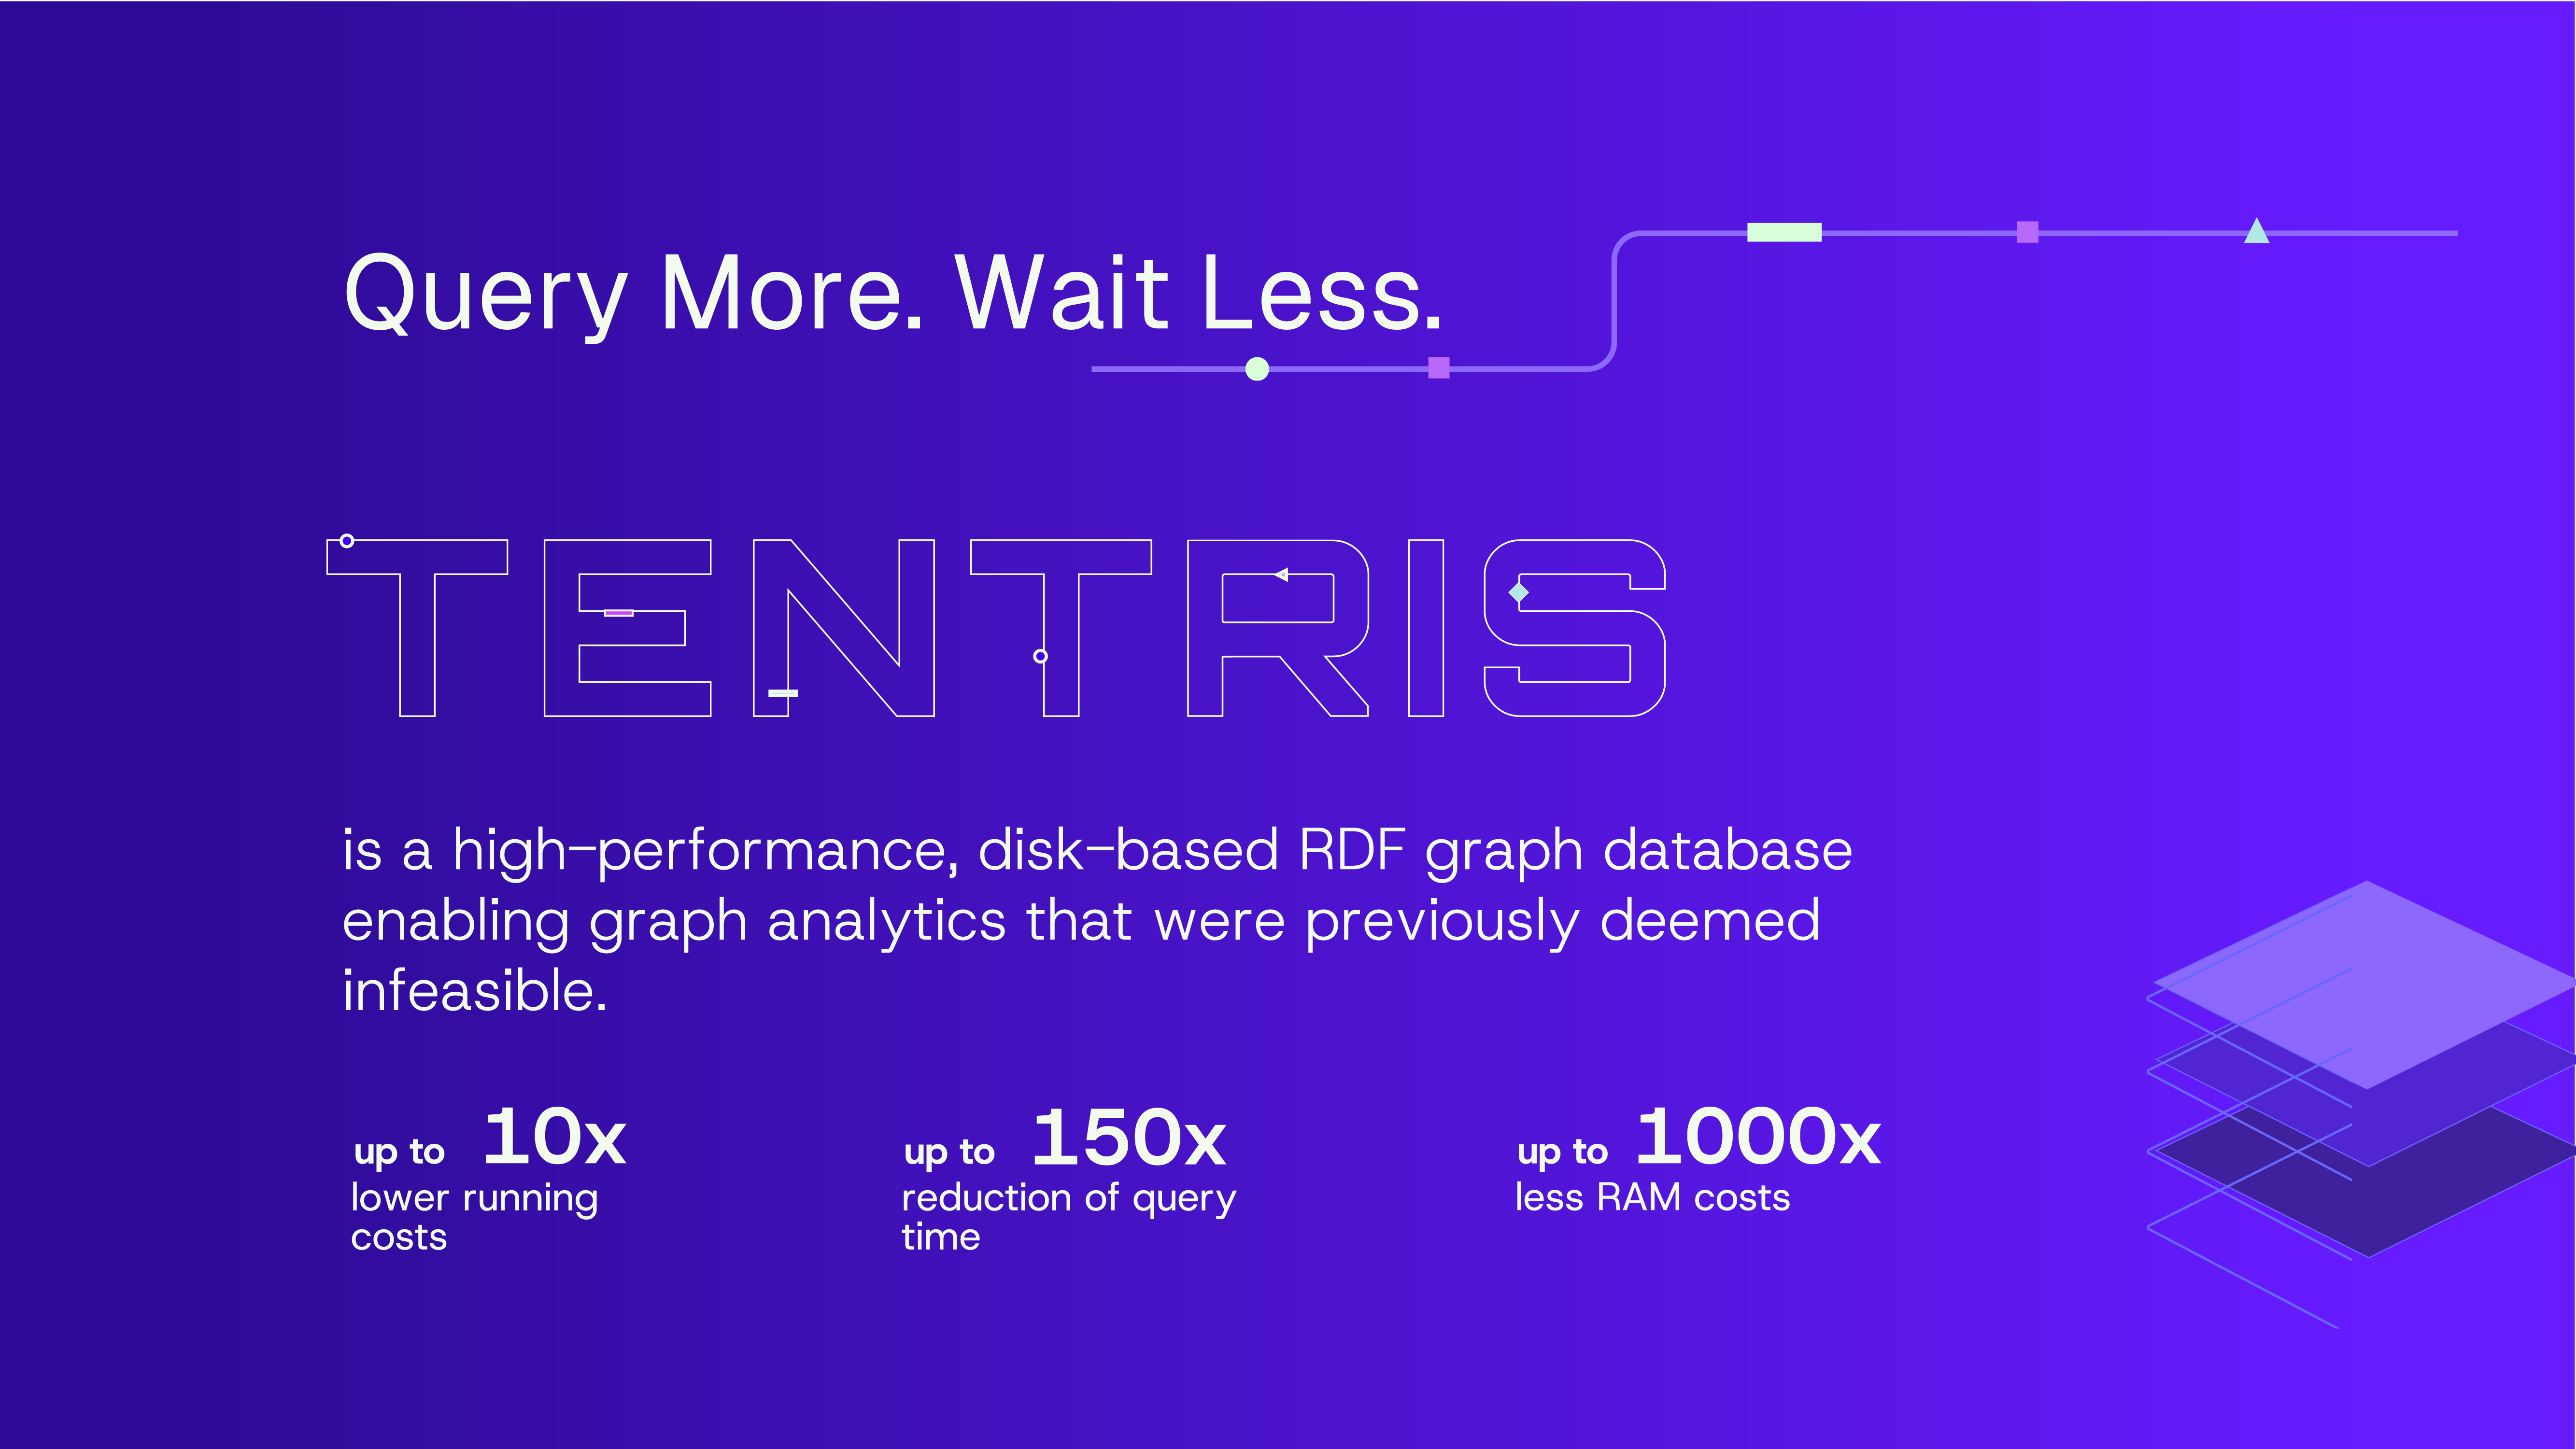
더 많이 쿼리하고, 더 적게 기다리세요. TentrisDB는 고성능의 디스크 기반 RDF 그래프 데이터베이스입니다.
George Anadiotis's image-a8a95
이는 엔터프라이즈 AI 및 GraphRAG부터 디지털 트윈, 생명 과학, 공급망 분석에 이르기까지 다양한 애플리케이션을 가능하게 합니다. 성능, 확장성, 효율성을 결합함으로써 Tentris는 지식 그래프를 정적인 저장소에서 실시간 분석 자산으로 변모시켜, 기업이 AI 이니셔티브를 가속화하고 연결되고 신뢰할 수 있는 지식을 기반으로 애플리케이션을 구축하도록 돕습니다.
온톨로지는 AI 에이전트가 검색(retrieval)에서 실행(execution)으로 나아가도록 돕는다
Yuan Gao는 엔터프라이즈 에이전트에게 어려운 부분은 API를 호출하는 것이 거의 아니라고 지적합니다. 어려운 부분은 어떤 액션이 허용되는지 결정하고, 모호한 부작용을 만들지 않으면서 실행하며, 그 후에 무슨 일이 일어났는지 증명하는 것입니다.
우리는 '에이전트가 올바른 정보를 검색하고 설명할 수 있는가?'에서 '에이전트가 통제된 의사결정을 내리고 작업을 신뢰성 있게 완료할 수 있는가?'로 이동하고 있습니다. 검색(Retrieval)은 '주문'이라는 단어를 포함하는 모든 문서를 찾아낼 수는 있지만, 에이전트가 올바른 비즈니스 객체를 선택했는지 보장하지는 못합니다.
온톨로지(Ontology)는 이러한 차이점들을 명시적으로 만듭니다. 즉, 기업 내의 객체들, 그 상태들, 이들 간의 관계들, 각 정의에 대한 권위 있는 출처, 그리고 어떤 개념들이 서로 대체될 수 없는지에 대한 정보입니다.
하지만 온톨로지의 역할은 정의(definition)에만 머무르지 않습니다. 에이전트 라이프사이클의 다섯 단계 전반에 걸쳐 참여합니다: 기업 이해, 올바른 데이터 찾기, 행동 통제(governing action), 워크플로우 계획, 그리고 실행 검증입니다.