
AI가 정확하다고 해도 공정하고 윤리적이며 신뢰할 수 있을까요?
요약
본 글은 AI의 높은 정확도가 반드시 공정하고 윤리적이며 신뢰할 수 있음을 의미하지 않음을 지적합니다. 채용 시스템이나 대출 위험 평가 사례를 통해, 전반적인 성능 지표만으로는 놓치기 쉬운 그룹별 오류 분포와 그로 인한 사회적 영향을 분석해야 함을 강조합니다.
핵심 포인트
- AI의 정확도(Accuracy)는 공정성(Fairness)을 보장하지 않는다.
- 오류 유형과 결과가 그룹별로 다르게 나타날 수 있다 (False Rejection/Approval).
- COMPAS 사례처럼, 서로 다른 '공정성 기준'은 상이한 결론을 도출할 수 있다.
- AI 윤리는 기술적 성능뿐 아니라 사용의 정당성과 통제 가능성을 이해하는 것이 핵심이다.
AI가 정확하다고 해도 공정하고 윤리적이며 신뢰할 수 있을까요?
높은 정확도, 정교한 알고리즘, 그리고 좋은 의도를 넘어 책임감 있는 AI를 구축하는 것이 왜 필요한지.
같은 직무에 지원하는 두 후보자를 상상해 보세요.
두 사람 모두 관련 자격과 풍부한 경험, 비슷한 기술을 가지고 있습니다. AI 기반 채용 시스템이 그들의 지원서를 평가하고 한 후보자는 추천하고 다른 후보자는 거절합니다.
조직 측은 자체 모델이 95%의 정확도를 달성했다고 보고합니다.
인상적하게 들리죠?
하지만 만약 이 동일한 시스템이 특정 인구 통계 그룹의 지원자를 평가할 때 일관되게 더 많은 실수를 한다면 어떨까요?
만약 지원자들이 자신이 왜 거절되었는지 결코 알 수 없다면요?
그리고 그 결정에 대해 의미 있게 이의를 제기할 수 있는 사람이 아무도 없다면요?
갑자기, 95%의 정확도는 우리에게 충분하지 않습니다.
이것은 AI 개발에서 가장 중요한 질문 중 하나입니다. 시스템이 기술적으로 인상적인 결과를 산출했을 때, 그것이 자동으로 공정하고 윤리적이며 신뢰할 수 있다는 의미일까요?
반드시 그렇지 않습니다.
저는 Northeastern University London에서 Applied Artificial Intelligence 석사 과정의 일환으로 AI 및 데이터 윤리에 대한 연구를 하면서 이러한 질문들이 실제 AI 시스템과 어떻게 연결되는지 탐구해 왔습니다.
가장 흥미로운 교훈은 AI 윤리가 단순히 알고리즘을 더 좋게 만드는 것에 관한 것이 아니라는 것입니다. 그것은 그 사용이 정당화되는 이유, 누가 그 결정에 영향을 받는지, 그리고 그러한 결정들이 어떻게 통제되어야 하는지를 이해하는 것에 관한 것입니다.
더 깊이 살펴볼 가치가 있는 몇 가지 가정들을 탐구해 보겠습니다.
1. AI 시스템이 정확하면서도 불공정할 수 있을까요?
물론입니다. 그리고 바로 이 지점에서 AI를 평가하는 것은 단일 성능 지표를 확인하는 것보다 더 복잡해집니다.
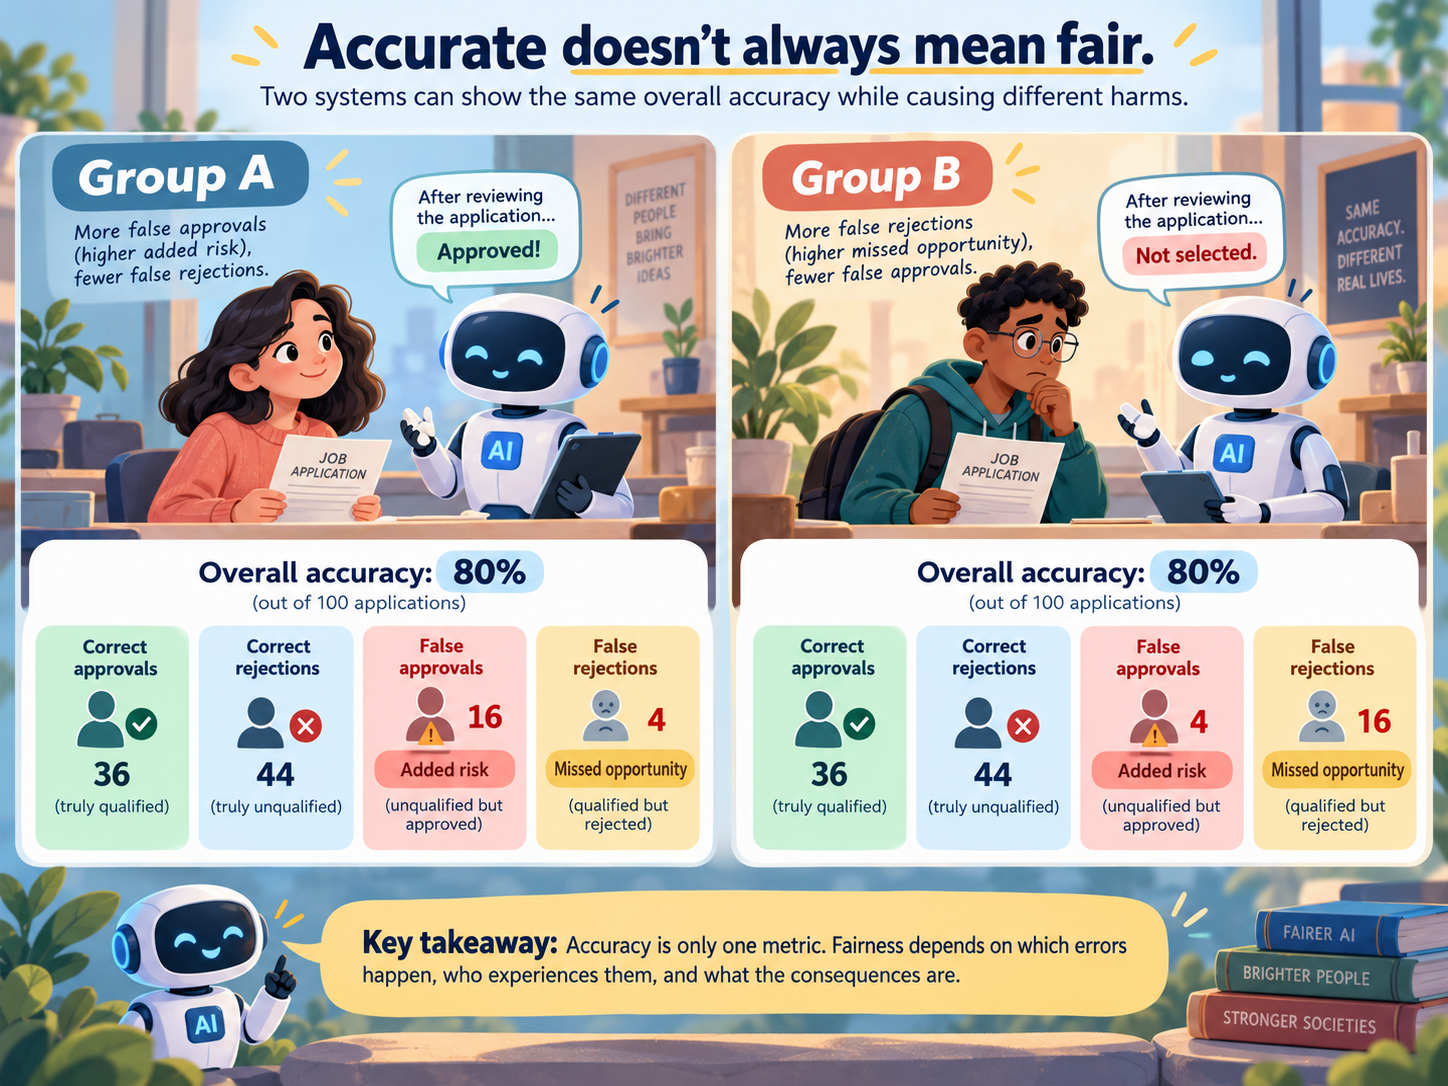
대출 연체 위험을 평가하는 데 사용되는 AI 시스템을 상상해 보세요. 이 시스템은 두 인구 통계 그룹에 대해 동일한 전반적 정확도를 달성합니다.
언뜻 보기에는, 이 시스템이 모든 사람에게 동등하게 효과적인 것처럼 보일 수 있습니다.
하지만 만약 그 실수가 다르게 분포되어 있다면 어떨까요:
- Group A의 경우, 실제로 대출을 상환할 수 있는 신청자를 자주 거부합니다.
- Group B의 경우, 나중에 채무 불이행(default)을 하는 신청자를 더 자주 승인합니다.
전반적인 정확도가 동일하더라도, 각 그룹은 서로 다른 유형의 오류와 그로 인한 결과를 경험하게 됩니다.
오탐지 거부(false rejection)는 누군가에게 주거, 교육 또는 사업 기회에 대한 접근을 박탈할 수 있습니다. 오탐지 승인(false approval)은 또 다른 종류의 재정적 위험을 초래합니다.
윤리적인 질문은 AI가 얼마나 자주 정확한지에만 국한되지 않습니다. 또한 AI가 틀렸을 때 누가 그 결과를 감수해야 하는가입니다.
실제 사례: COMPAS
COMPAS 위험 평가 시스템은 알고리즘적 공정성(algorithmic fairness)에 대한 논의에서 대표적인 예시가 되었습니다.
2016년, ProPublica는 이 시스템이 피고인이 다시 체포될 가능성에 대해 예측한 내용을 조사했습니다.
그들의 분석은 오류 유형에서 인종적 차이를 보고했습니다. 흑인 피고인은 높은 위험군으로 잘못 분류될 가능성이 더 높았으며, 백인 피고인은 낮은 위험군으로 잘못 분류될 가능성이 더 높았습니다.
COMPAS를 개발한 회사는 ProPublica의 분석에 이의를 제기하며 예측적 공정성(predictive fairness)을 다르게 해석하여 시스템을 옹호했습니다.
이러한 의견 불일치는 중요한 점을 강조합니다. 서로 다른 공정성 기준은 동일한 모델에 대해 서로 다른 결론을 도출할 수 있다는 것입니다.
AI 시스템은 한 측정 기준 하에서는 그룹 전반에 걸쳐 유사하게 작동할 수 있지만, 다른 측정 기준 하에서는 다르게 작동할 수 있습니다.
공정성은 단순히 지표 이상의 의미입니다
John Basl, Ronald Sandler, Steven Tiell이 저술한 『Getting from Commitment to Content in AI and Data Ethics: Justice and Explainability』에서 그들은 광범위한 정의의 '정의(justice)'에 대한 약속이 AI 개발을 안내하기 위해서는 더 정확한 의미가 필요하다고 논합니다.
유용한 관점 세 가지는 다음과 같습니다:
절차적 정의 (Procedural justice): 의사 결정 과정이 공정하고, 일관되며, 적절한 검토에 열려 있는가?
분배적 정의 (Distributive justice): 혜택, 기회, 위험 및 부담이 공정하게 분배되고 있는가?
인정 정의 (Recognition justice): 영향을 받는 개인과 커뮤니티가 적절하게 인정받고, 존중되며, 대표되는가?**
이러한 관점들은 공정성 지표(fairness metric)를 최적화하는 것이 모든 공정성 문제를 해결하는 것과 같지 않다는 점을 설명하는 데 도움이 됩니다.
예를 들어, AI 채용 시스템은 통계적 기준을 충족할 수 있지만, 여전히 부당한 프로세스에 의존하거나 지원자가 이의를 제기할 수 없는 결정을 내릴 수도 있습니다.
개발자들을 위한 교훈은 간단합니다:
어떤 공정성 지표를 최적화해야 할지 묻기 전에, 구축하고 있는 특정 시스템에서 '공정성'이 무엇을 의미해야 하는지를 질문하십시오.
[](https://media2.dev.to/dynamic/image/width=800%2Cheight=%2Cfit=scale-down%2Cgravity=auto%2Cformat=auto/https%3A%2F%2Fdev-to-uploads.s3.us-east-2.amazonaws.com%2Fuploads%2Farticles%2Ftvwplk5n533i6qv3760v.png)
2. AI가 결정을 설명한다면, 그것이 신뢰할 수 있다는 의미인가?
AI 시스템이 대출 신청을 거부한다고 가정해 봅시다.
신청자가 이유를 묻습니다.
시스템은 응답합니다:
"귀하의 신청은 신용 기록, 소득 안정성, 부채 대비 소득 비율 때문에 거부되었습니다."
그것은 투명하게 들립니다.
하지만 그 설명이 결정이 정당했음을 입증하는 것일까요?
반드시 그렇지는 않습니다.
아마도 근본적인 데이터가 부정확했을 수 있습니다. 어쩌면 부적절한 변수가 예측에 영향을 미쳤을 수도 있습니다. 어쩌면 신청자가 오류를 수정할 방법이 없을 수도 있습니다.
여기서 네 가지 관련되지만 구별되는 개념으로 나아가게 됩니다.
**투명성(Transparency)**은 시스템과 그 작동 방식에 대한 어떤 정보가 제공되는지에 관한 것입니다.
**설명 가능성(Explainability)**은 시스템의 행동에 대해 이해할 수 있는 이유나 설명이 제공될 수 있는지 여부에 관한 것입니다.
**해석 가능성(Interpretability)**은 사람들이 모델의 작동 방식이나 출력물을 어떻게 이해할 수 있는지에 관한 것입니다.
**책무성(Accountability)은 누가 결정에 대해 책임을 져야 하는지, 실패에 어떻게 대처해야 하는지, 그리고 적절한 구제책을 제공해야 하는지를 다룹니다.
이 개념들은 서로 연결되어 있지만, 상호 교환 가능한 것은 아닙니다.
어떤 시스템은 사람이 이해할 수 있는 설명 없이 기술적인 세부 사항을 공개할 수 있습니다.
근거가 되는 결정 자체가 정당했는지 보여주지 않으면서도 설득력 있는 설명을 제공할 수도 있습니다.
또한, 모든 결정에 대한 상세한 기록을 가지고 있으면서도 실수를 이의 제기할 의미 있는 과정이 부족할 수도 있습니다.
이는 윤리적 원칙들이 맥락별 요구 사항을 필요로 한다는 Basl, Sandler, Tiell의 주장과 밀접하게 관련되어 있습니다. 단순히 투명성을 약속하는 것만으로는 충분하지 않습니다.
우리는 다음과 같은 질문을 던져야 합니다:
- 누구에게 투명한가?
- 어떤 정보에 대해?
- 어떤 목적으로?
- 영향을 받은 사람이 그 정보를 가지고 실제로 무엇을 할 수 있는가?
누군가에게 기술적인 설명을 제공하는 것과, 잘못된 결과에 이의를 제기할 진정한 기회를 제공하는 것 사이의 차이점을 고려해 보세요.
후자는 잘 쓰인 설명 이상의 것을 요구합니다. 관련 정보에 대한 접근 권한, 검토 과정, 그리고 결정을 수정할 권한을 가진 누군가를 필요로 할 수 있습니다.
투명성은 책무성을 가능하게 하는 데 도움을 줄 수는 있지만, 투명성만으로는 책무성을 보장하지 못합니다.
3. 데이터 수집에 동의하면 개인 정보가 보호되나요?
우리 모두는 모든 줄을 읽지 않고 개인 정보 고지에
AI 시스템에 특정 작업을 완료하도록 권한을 부여하는 것이 개인 데이터에 대한 무제한적인 권한을 주는 것과는 다릅니다.
프라이버시는 단순히 정보를 비밀로 유지하는 것을 넘어섭니다
프라이버시에는 자율성(autonomy), 통제(control), 맥락(context), 그리고 잠재적 피해에 대한 노출도(exposure to potential harm)가 포함됩니다.
어떤 서비스는 필요한 것보다 훨씬 많은 정보를 수집하면서도 안전하게 정보를 저장할 수 있습니다.
개인은 의미 있는 대안 없이 데이터 처리에 동의할 수도 있습니다.
그리고 한 가지 합법적인 목적을 위해 공유된 데이터가 나중에 개인이 합리적으로 예상하지 못한 방식으로 재사용될 수도 있습니다.
이것이 바로 프라이버시를 단순히 암호화(encryption)나 동의 체크박스에 국한할 수 없는 이유입니다.
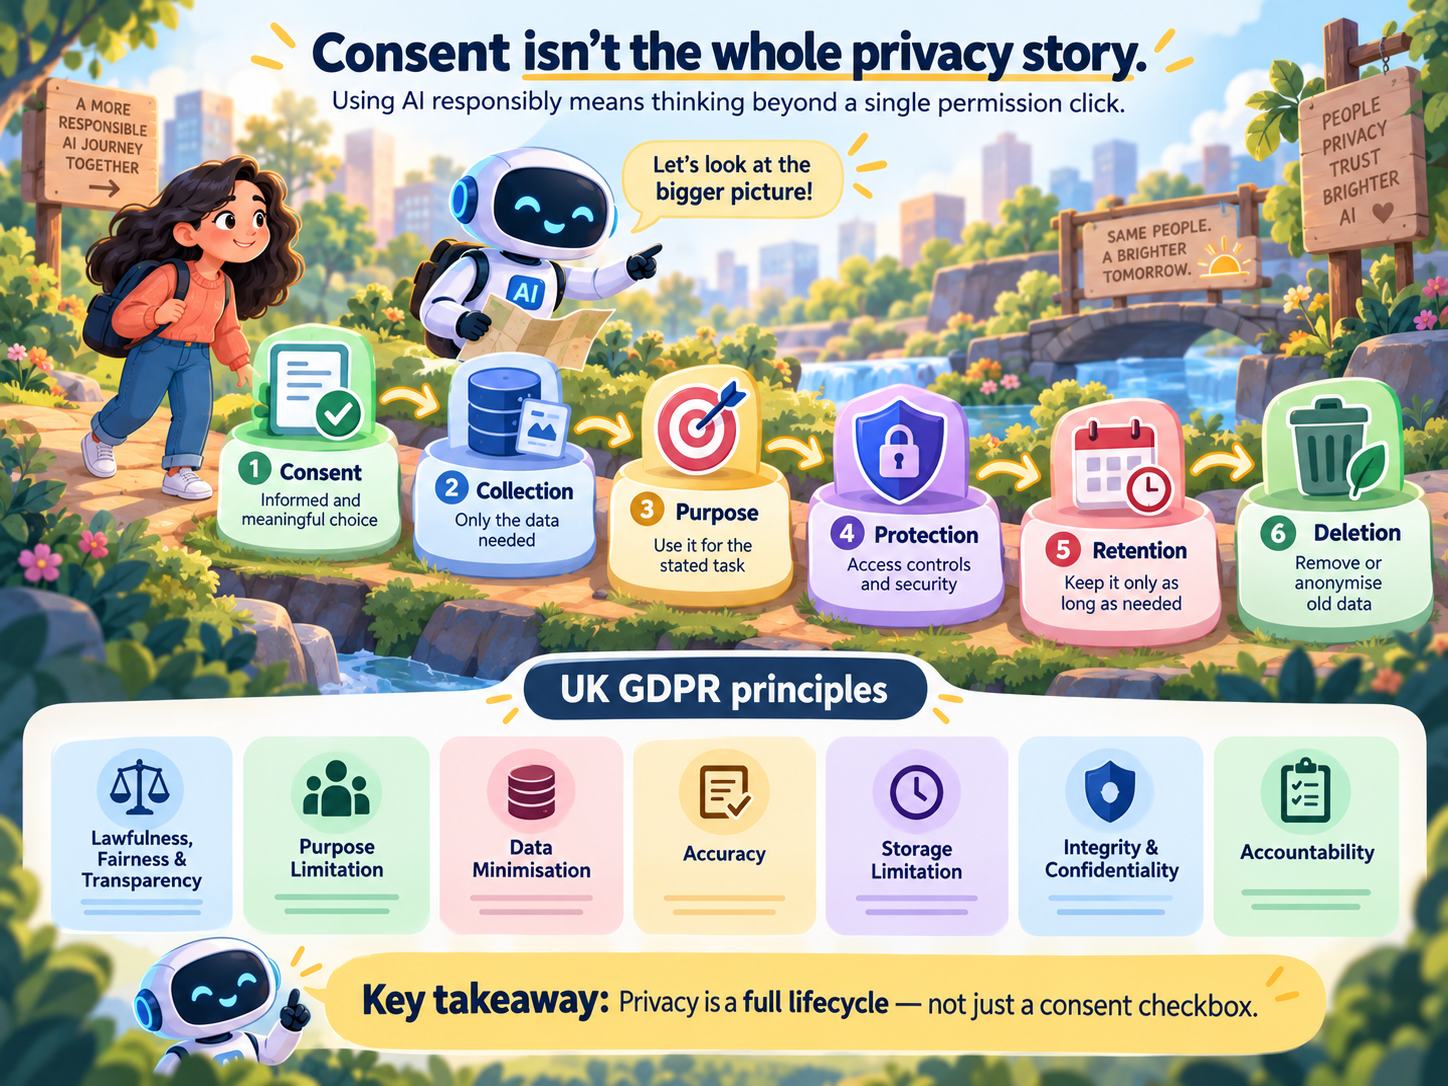
7가지 영국 GDPR 원칙
영국 일반 데이터 보호 규정(UK General Data Protection Regulation, UK GDPR)은 책임 있는 개인 데이터 처리 방식에 대해 생각하는 데 중요한 기반을 제공합니다.
그의 7가지 원칙은 다음과 같습니다:
- 적법성, 공정성 및 투명성 (Lawfulness, fairness, and transparency): 개인 데이터를 적법하고 공정하게 처리하며, 적절한 투명성을 유지해야 합니다.
- 목적 제한 (Purpose limitation): 지정된 합법적인 목적을 위해 데이터를 수집하고 추가 사용에 대한 제한을 존중해야 합니다.
- 데이터 최소화 (Data minimisation): 관련 목적에 필요한 데이터만 수집해야 합니다.
- 정확성 (Accuracy): 개인 데이터를 정확하게 유지하고 적절하게 업데이트해야 합니다.
- 저장 제한 (Storage limitation): 식별 가능한 개인 데이터를 필요 이상으로 오래 보관하는 것을 피해야 합니다.
- 무결성 및 기밀성 (Integrity and confidentiality): 적절한 보안 조치를 사용하여 정보를 보호해야 합니다.
- 책임성 (Accountability): 데이터 보호 요구 사항을 준수할 책임을 지고, 그 준수를 입증해야 합니다.
이러한 원칙들은 개인 정보를 접근하고, 처리하고, 저장하거나 공유하는 AI 시스템을 개발할 때 관련됩니다.
하나의 중요한 법적 구분점: UK GDPR 하에서 동의가 개인 데이터 처리를 위한 유일한 합법적 근거는 아닙니다.
더 광범위한 원칙은 처리가 적절한 합법적 근거를 가져야 하며, 적용 가능한 요구 사항을 준수해야 한다는 것입니다.
개발자에게 유용한 질문은 단순히 다음과 같지 않습니다:
이것은 다음과 같습니다:
"이 시스템이 데이터가 필요한가? 그 사용은 정당화되는가? 그리고 관련된 사람들을 보호하는 통제 장치는 무엇인가?"
[](https://media2.dev.to/dynamic/image/width=800%2Cheight=%2Cfit=scale-down%2Cgravity=auto%2Cformat=auto/https%3A%2F%2Fdev-to-uploads.s3.us-east-2.amazonaws.com%2Fuploads%2Farticles%2F5qc4khtqb3wyluoqn3jr.png)
4. 알고리즘은 우리가 원하는 것을 보여주는가, 아니면 우리의 믿음을 형성하는가?
온라인에서 정보를 소비하는 방식을 생각해 보세요.
소셜 플랫폼을 열고 게시물, 기사, 추천 및 의견의 흐름과 마주칩니다.
우리는 자신이 보는 것이 주로 자신의 관심사를 반영한다고 가정할 수 있습니다.
하지만 우리가 접하는 정보는 또한 플랫폼의 랭킹 시스템, 추천 목표, 그리고 다른 사용자들의 행동에 의해 영향을 받습니다.
이것은 중요합니다. 왜냐하면 우리가 접하는 정보는 우리가 형성하는 믿음과 결정에 영향을 미칠 수 있기 때문입니다.
잘못된 정보가 퍼지는 이유
Filippo Menczer와 Thomas Hills는 『Information Overload Helps Fake News Spread, and Social Media Knows It』에서 정보 과부하(information overload), 인지 편향(cognitive biases), 사회적 영향력(social influence), 그리고 알고리즘 증폭(algorithmic amplification)이 잘못된 정보에 어떻게 기여하는지 조사했습니다.
여러 메커니즘이 특히 흥미롭습니다.
정보 과부하: 사람들은 자신이 접하는 모든 정보를 신중하게 평가할 수 없습니다.
확증 편향 (Confirmation bias): 우리는 이미 가지고 있는 믿음을 뒷받침하는 정보에 더 잘 반응할 수 있습니다.
내집단 영향력 (In-group influence): 우리가 소속되었다고 인식하는 사람들로부터 공유된 정보는 더 신뢰할 수 있게 느껴질 수 있습니다.
알고리즘 증폭 (Algorithmic amplification): 랭킹 및 추천 시스템은 오해의 소지가 있는 자료를 포함하여 특정 콘텐츠의 가시성을 높일 수 있습니다.
소셜 봇 (Social bots): 자동화된 계정은 온라인 사회 활동의 외관과 확산에 기여할 수 있습니다.
이러한 메커니즘들은 상호 작용할 수 있습니다.
누군가가 오해의 소지가 있는 주장에 접하고, 이에 참여하며, 관련 콘텐츠를 더 많이 받고, 신뢰하는 연락처로부터 유사한 메시지를 반복적으로 받는 상황을 상상해 보세요.
시간이 지남에 따라 이러한 반복적인 노출은 기존의 믿음을 강화할 수 있습니다.
중요하게도, 이것은 모든 사용자에게 필연적인 결과가 아니라 가능한 피드백 메커니즘입니다.
AI 자동 생성 콘텐츠
본 콘텐츠는 Dev.to AI tag의 원문을 AI가 자동으로 요약·번역·분석한 것입니다. 원 저작권은 원저작자에게 있으며, 정확한 내용은 반드시 원문을 확인해 주세요.
원문 바로가기