이 글은 2024년 12월 5일에 작성되었습니다.
안녕하세요, Inflab의 DevOps 엔지니어 Poka입니다.
저에게 처음인 회사 Inflab에 입사한 지 벌써 3개월이 다 되어갑니다.
이번에는 AI/ML 전문 직무가 없는 저희 같은 스타트업이 기계 학습(Machine Learning)/AI를 활용하여 자동 스팸 필터링 시스템을 도입하고 개선해 온 과정을 소개합니다.
img.png
スパム投稿に苦しめられる運営チーム… img.png
Inflearn의 성장에 따라 다양한 스팸성 콘텐츠가 게시되기 시작했습니다. 초기에는 운영팀이 이러한 게시물을 하나하나 수동으로 확인하여 스팸으로 처리했습니다.
하지만 플랫폼이 확대되면서 모든 게시물을 수동으로 관리하는 것은 점차 비효율적이고 많은 시간이 소요되는 작업이 되었습니다.
DevOps 팀의 Jake님과 Jace님이 GPT-4o mini 모델과 금지어 목록을 사용하여 스팸 여부를 판별하는 시스템을 구축했습니다.
이 구성을 선택한 이유는, 스팸 필터링이 아직 초기 단계였고 비용 효율적인 접근 방식이 필요했기 때문입니다.
스팸의 패턴을 찾아내는 방식으로, 새로운 패턴이 발견될 때마다 프롬프트 관리용 백오피스에 예시 데이터를 추가하는 Few-Shot 방식을 통해 필터링을 개선해 나갔습니다.
이 방법은 특정 패턴을 차단하는 데는 효과적이었지만, 새로운 스팸 유형이 발견될 때마다 수동으로 패턴을 추가해야 한다는 제약이 있었습니다.
또한, 특정 게시판에 자주 올라오는 스팸 패턴을 기준으로 예시 데이터나 금지어를 추가했기 때문에 모든 게시판에 일관되게 적용하기는 어려웠습니다.
더욱이, 스팸 필터링 초기 단계에서 저렴한 모델을 사용했기 때문에 성능이 낮은 AI로는 스팸 게시물을 효과적으로 차단할 수 없다는 한계도 있었습니다.
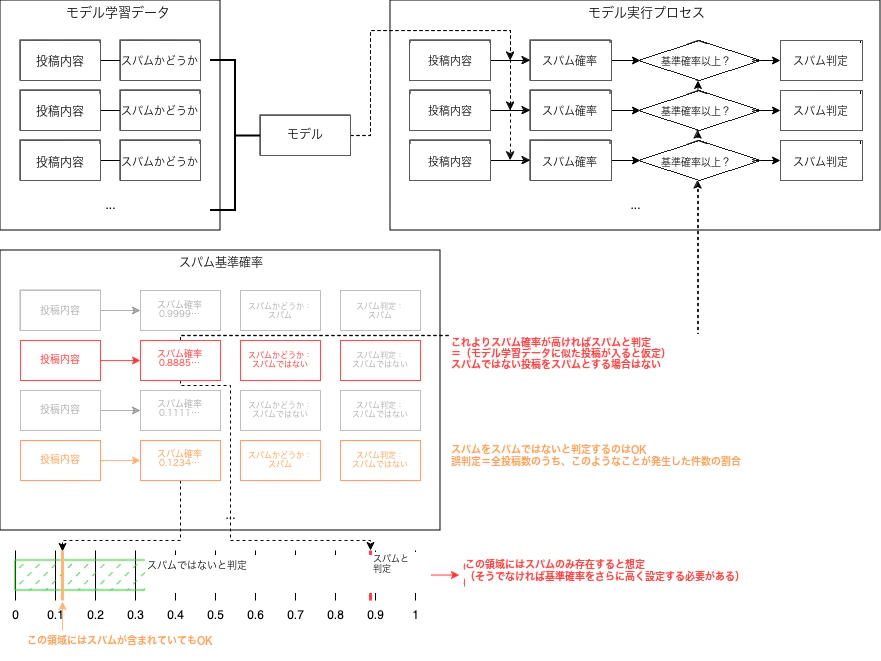
다음 단계로, 새로운 종류의 스팸을 학습하여 처리할 수 있는 적응형(Adaptive) 스팸 필터를 구축했습니다.
스팸을 더 확실하게 추출하기 위해 TfidfVectorizer로 데이터를 벡터에 변환했습니다. 이는 스팸 게시물에서 의미 없이 사용되는 단어의 가중치를 낮추고 중요한 단어만 추출하기 위함입니다.
벡터화란 텍스트 데이터를 벡터로 변환하는 것으로, 각 단어를 숫자에 매핑하여 텍스트의 특징을 수치적으로 표현할 수 있기 때문입니다.
쉽게 말해, 방대한 텍스트를 지도 위에 배치하고 중요한 위치만 선명하게 보이도록 하는 작업과 유사합니다. 새로운 게시물의 벡터가 스팸 게시물의 벡터에 가까울수록 두 것은 유사하며, 스팸일 가능성이 높다고 판단할 수 있습니다.
이러한 전처리 과정을 통해 기계 학습 모델이 데이터를 효과적으로 처리하고 분석할 수 있는 기반을 마련했습니다.
데이터셋의 제약: 당시 이용 가능한 데이터셋의 양이 많지 않았기 때문에, 적은 데이터로도 학습할 필요가 있었습니다.
- 계산 속도: 스팸 게시물은 작성 후 최대한 빨리 발견하지 못하면 일반 사용자에게 피해를 최소화하기 어렵습니다. 따라서 빠른 계산이 요구되었습니다.
- 지속적 학습의 용이성: 새로운 종류의 스팸이 추가되어도 지속적으로 학습할 수 있어야 했습니다.
- 모델 크기의 제약: 모델의 크기가 커지지 않도록 할 필요가 있었습니다.
위 조건에 적합한 모델로 SGDClassifier를 선택했습니다.
이 모델은 필요한 계산량이 많지 않아 GPU 없이 CPU만으로도 빠르게 추론할 수 있었습니다.
게시물 작성 이벤트는 특정 시간대에 집중되는 경향이 있기 때문에, 서버를 상시 가동하는 대신 서버리스 함수 위에서 이벤트 기반으로 작동하도록 설계했습니다.
최초 모델 학습은 로컬 환경에서 약 2~3시간을 들여 진행했습니다.
실제 배포 환경에서는 서버리스 함수인 AWS Lambda에서 작동하도록 TfidfVectorizer와 SGDClassifier를 포함한 scikit-learn 라이브러리를 Lambda Layer로 추가했습니다.
덕분에 Python 코드에 수정이 있을 때는 코드만 빠르게 배포할 수 있었습니다.
Python + Lambda Layer의 조합으로 콜드 스타트(Cold Start)는 약 2.8초 만에 완료되었습니다. 또한, 한 번 구동되면 피크 시간대에는 거의 콜드 스타트 없이 실행됨을 확인했습니다.
그 결과, 1,024 MB 메모리를 할당한 Lambda 함수에서 모델 추론에 걸리는 시간은 단지 0.2~0.6밀리초였습니다.
학습된 벡터와 모델 파일은 S3에 저장하여 사용하고 있습니다. 또한 Jenkins의 cron job을 통해 새로운 게시물을 주기적으로 모델에 추가 학습시켜, 새로운 종류의 스팸에도 자동으로 적응할 수 있도록 했습니다.
- 게시물이 생성될 때마다 SNS Topic을 발행합니다. - 이 Topic이 SQS로 도착합니다. - SQS가 스팸 필터링 Lambda를 호출합니다. - 기계 학습 모델이 스팸 여부를 판정합니다.
spam-step-workflows
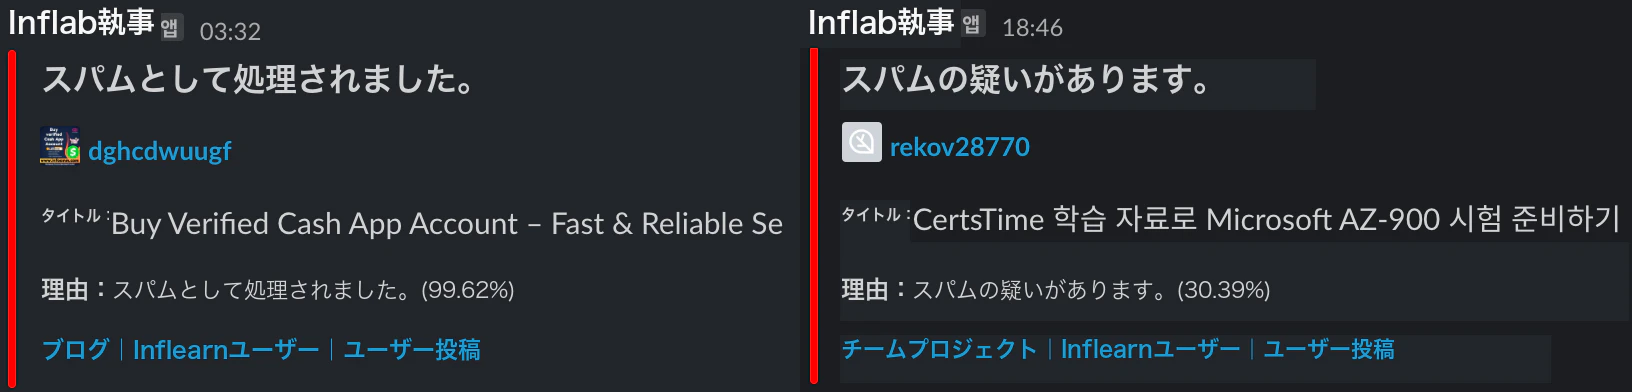
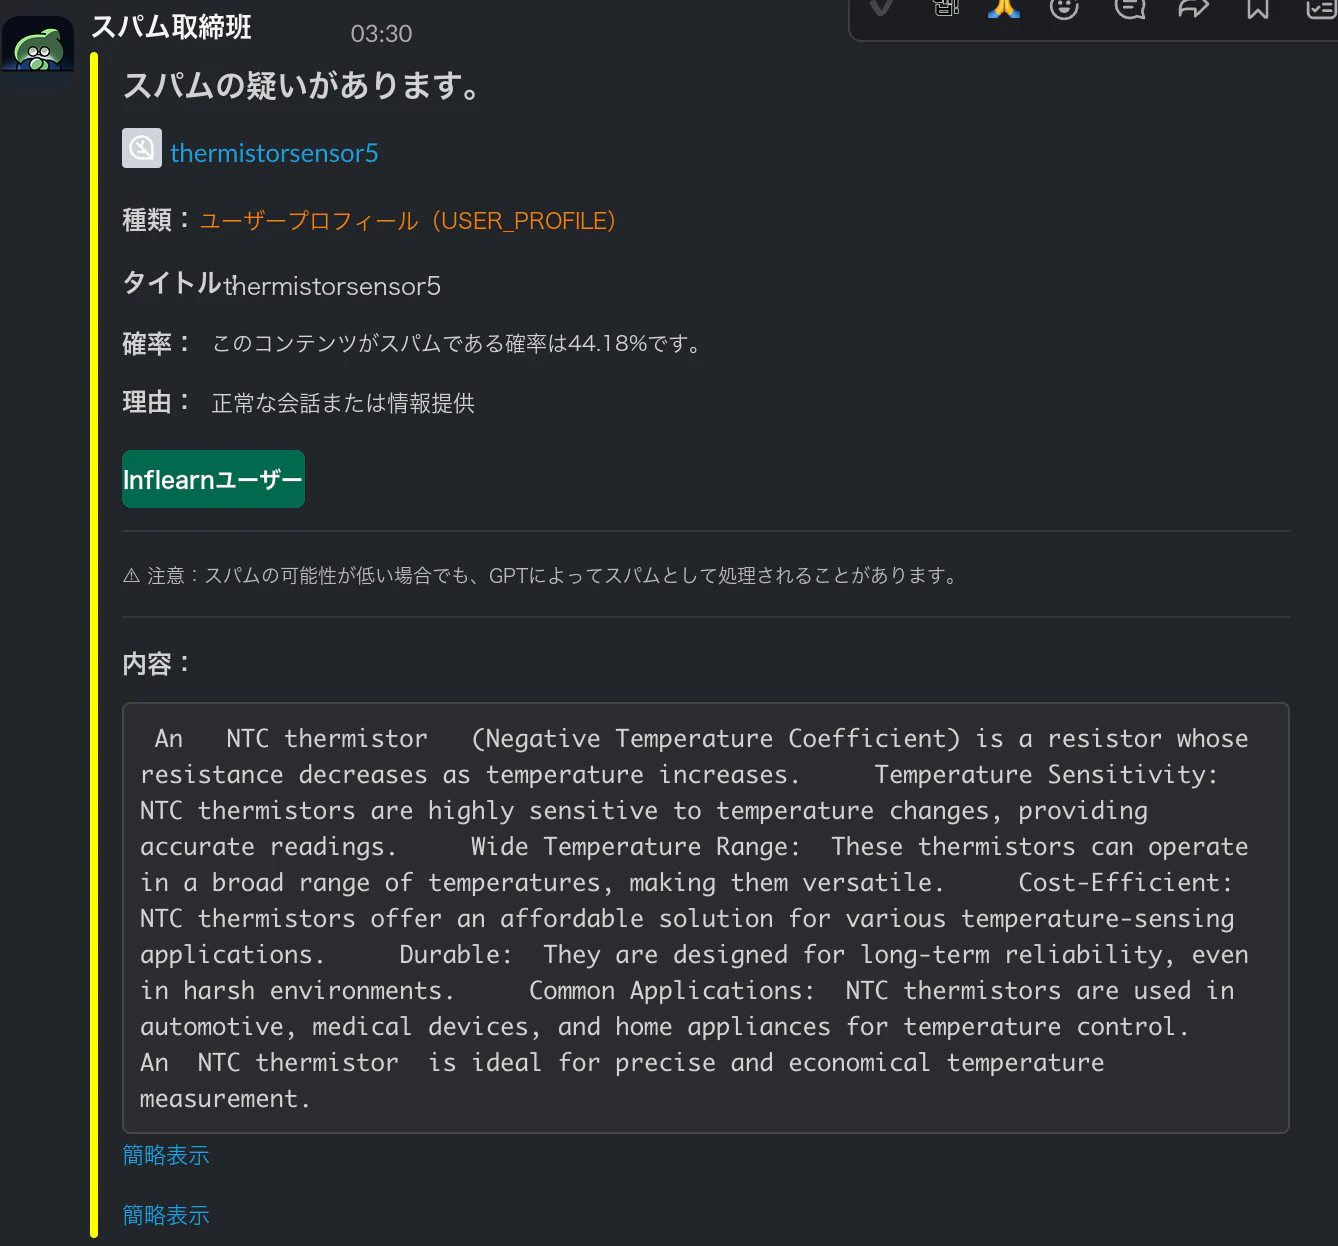
기계 학습 도입에 맞춰, 스팸 탐지 프로세스에 '스팸', '의심', '정상'이라는 3단계가 추가되었습니다.
각 단계에는 고유한 임계값을 설정하여 콘텐츠를 평가합니다. 게시물이 '스팸' 단계의 임계값을 초과할 경우, 스팸으로 확정됩니다.
spam-alarm
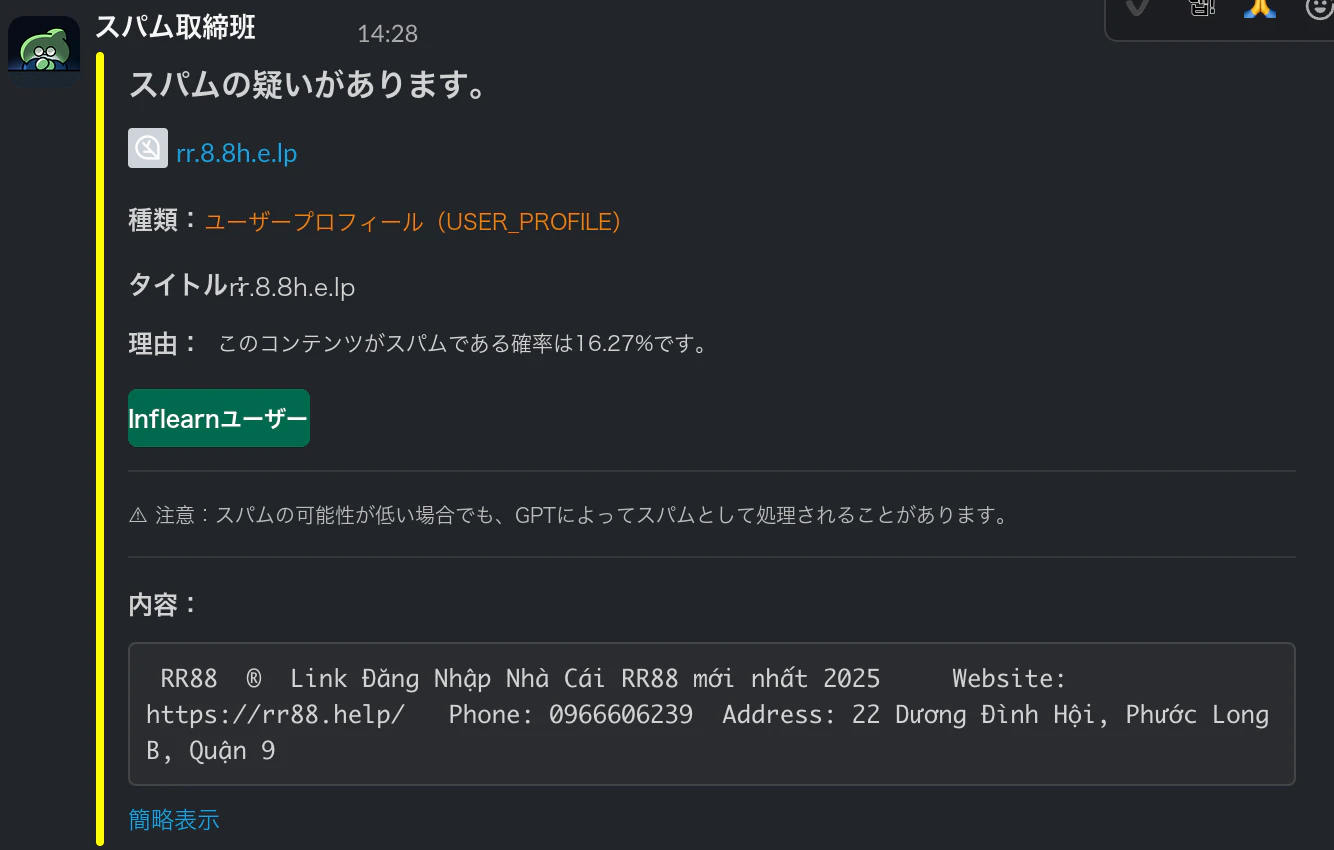
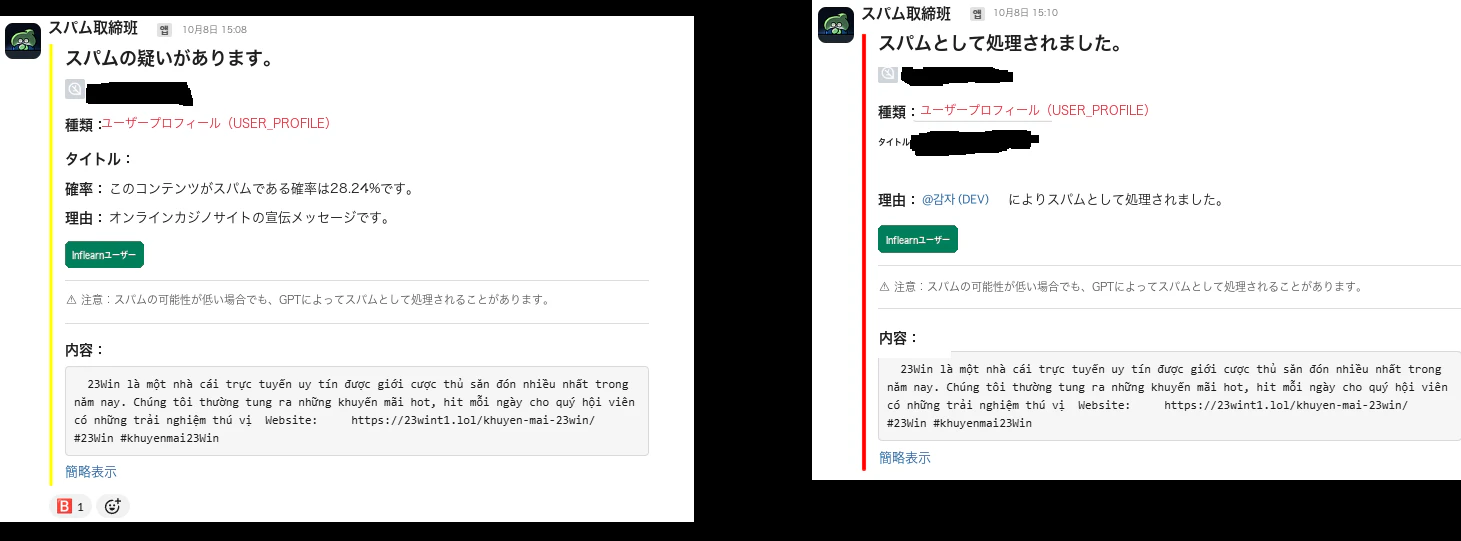
'스팸' 또는 '의심' 단계로 분류된 경우에는 운영팀이 실시간으로 상황을 모니터링할 수 있도록 Slack에 알림이 전송되도록 구성했습니다.
vi-lang-spam
기계 학습 모델은 한국어와 영어에서는 우수한 성능을 보였으나, 태국어, 몽골어, 중국어, 일본어 등 다양한 언어로 작성된 스팸 게시물에는 어려움을 겪었습니다.
기계 학습과 ChatGPT를 결합하여 다국어 스팸에 대응할 수 있는 시스템을 마련했습니다.
또한, 스팸을 효과적으로 판정하기 위해 GPT에게 다음과 같은 프롬프트를 제공했습니다.
- 역할: 콘텐츠 심사 전문가
- 수행할 작업: 입력된 콘텐츠를 스팸 또는 정상으로 분류
- 스팸으로 간주하는 경우: 광고, 홍보, 기만적인 내용 포함
- 단순한 오타나 일반적인 주제는 스팸으로 간주하지 않음
- 정상 데이터로 간주하는 경우: 일반적인 대화, 불분명한 대화
- 출력 형식:
{ "is_spam": 0 or 1, "reason": "스팸이라고 판단한 이유를 50자 이내로 한국어로 기술" }
이 프롬프트를 통해 GPT가 수행해야 할 작업을 명확히 지시하여 스팸 판정의 확실성을 높였습니다. 아울러 출력 형식을 고정하고 토큰 양을 줄였습니다.
B emoji
게시물이 '의심' 단계로 분류되면, 운영팀은 직접 내용을 확인한 후 admin 페이지에서 게시물과 사용자를 차단하고, 확인 완료 표시로 🅱️ 이모티콘을 추가했습니다.
이 작업을 간소화하기 위해, 스팸 의심 알림에 🅱️ 이모티콘이 붙으면 해당 게시물과 사용자가 자동으로 차단되도록 했습니다.
new-spam(2).png
스팸 콘텐츠 차단이 개선됨에 따라, 일반적인 게시물을 가장하여 무관한 링크를 삽입하거나, 체험담을 위장한 홍보성 게시물 등 다양한 종류의 스팸이 나타나기 시작했습니다.
이를 효과적으로 차단하기 위해 Karrot의 테크 미트업에서 공개된 Zero Shot With Auto Generate Prompt 기법을 적용하기로 했습니다.
카테고리별로 기존 스팸 데이터와 정상 데이터 각각의 특징을 더 자세히 추출하기 위해 GPT-4o 모델로 분석하고, 그 결과를 MongoDB에 저장했습니다.
매주 1회 Jenkins job으로 기존 특징과 지난주의 스팸/정상 데이터 특징을 비교하여 새로운 특징이 있으면 추가하도록 설계했습니다.
또한, 특징 추출 시에는 다양한 조건의 에지 케이스를 고려했습니다. 예를 들어, 홍보 목적의 게시물은 자동으로 스팸으로 처리해야 하지만, 학습자가 프로젝트 결과물을 공유하는 것과 같은 일반적인 커뮤니티 활동은 스팸으로 처리해서는 안 됩니다. 이러한 조건을 명시하여 과도한 일반화를 피하고 false positive(오탐)를 줄일 수 있도록 했습니다.
이렇게 MongoDB에 저장된 특징을 가져와 GPT-4o mini의 프롬프트에 포함했습니다. 그 위에 각 카테고리와의 관련성이나, 학습자에 의한 프로젝트 결과물 공유 같은 일반적인 커뮤니티 활동인지 등을 단계적으로 판정하여 정확도를 높였습니다.
자동 스팸 처리 시스템을 도입함으로써, 기존에 겪었던 많은 문제들이 해결되었습니다.
매일 수작업으로 진행하던 스팸 대응 대부분이 이제 자동화되었고, 수작업으로 대응하는 것은 극히 일부의 건만 남게 되었습니다.
이로 인해 CX 팀으로부터도 강력한 지지를 얻을 수 있게 되었습니다.
스팸 계정이 자동으로 처리되면서, 더 이상 스팸 게시물을 올려봤자 의미가 없다고 판단했는지, 스팸 계정 생성 요청은 점차 줄어들었습니다.
현재는 1일 동안 생성되는 스팸 계정 수가 시스템 도입 전과 비교하여 76% 감소했습니다.
이렇게 많은 리소스를 사용하는 솔루션은 상당한 비용이 들 것이라고 생각하는 분들이 많을 것입니다.
하지만 저희가 구축한 AWS Lambda, SNS, SQS, S3, 그리고 ChatGPT API의 비용을 모두 합쳐도, 게시물 1건이 스팸인지 판별하는 데 단지 0.05원밖에 들지 않는 것을 확인할 수 있었습니다.
본 기사에서는 Inflearn이 직면했던 스팸 게시물 문제를 해결하기 위해 만든 자동 스팸 필터링 시스템이 어떻게 발전해 왔는지 소개했습니다.
처음에는 금지어가 포함되어 있는지 확인하는 것만 하는 단순한 구성이었습니다. 거기서부터 ChatGPT를 이용해 스팸 패턴을 감지하도록 하고, 나아가 머신러닝 모델과 ChatGPT를 결합하여 다양한 종류의 스팸을 필터링할 수 있도록 개선했습니다.
이러한 개선 덕분에 끊임없이 나타나는 새로운 종류의 스팸도 자동으로 차단할 수 있게 되었습니다. 그 결과, 서비스 운영팀의 수고가 줄어들었을 뿐만 아니라, 저품질 링크로 유도하는 스팸 게시물을 삭제하여 SEO 지표를 개선하는 등의 효과도 얻었습니다.
앞으로는 프롬프트 관리용 백오피스를 고도화하여, 서비스 운영팀에서도 스팸 게시물의 특징을 쉽게 확인하고 수정할 수 있도록 시스템을 개선해 나갈 예정입니다.
이상으로 Inflearn의 스팸 필터링 과정을 소개했습니다.
끝까지 읽어주셔서 감사합니다.