
메모리는 IT 산업의 핵심 동력이며, AI에게는 더욱 그러하다
요약
AI와 생성형 AI의 발전으로 인해 시스템 컴퓨팅의 초점이 CPU/GPU에서 메모리(Memory)로 이동하고 있습니다. 특히 HBM과 플래시 스토리지를 포함한 DRAM 수요가 폭발적으로 증가하며, 이는 IT 산업 전반에 걸친 대규모 업그레이드 주기를 예고합니다.
핵심 포인트
- AI 시대에는 컴퓨팅보다 메모리가 핵심 제어 지점(control point)이 됨.
- HBM 및 플래시 스토리지를 포함한 DRAM 수요가 폭발적으로 증가하고 있음.
- 전 세계 서버 플릿의 노후화로 인해 대규모 시스템 업그레이드 주기가 예상됨.
- 메모리 제조사들이 HBM 생산을 위해 일반 DRAM 용량을 전환하며 공급이 타이트해지고 있음.
메모리는 IT 산업의 핵심 동력이며, AI에게는 더욱 그러하다
대부분의 사람들이 고성능 상업용 및 기술 컴퓨팅을 지켜봐 온 시간 동안, 시스템의 컴퓨트 부분 – 50년 전에는 CPU였고 지난 15년간은 GPU였다 – 이 의심할 여지 없이 시스템의 초점이었다. 메모리, 스토리지(storage), I/O는 항상 중요했지만, 부차적인 것이었다.
시스템과 클러스터 예산은 컴퓨트를 최대화하는 데 집중되었고, 이러한 다른 요소들은 종종 부차적이었다. 솔직히 말해서, 조직들은 CPU나 GPU 활용도를 높이는 것의 손해를 감수하고 메모리와 I/O에 돈을 아끼는 경우도 있었다.
머신러닝(machine learning)의 등장과 이것이 생성형 AI(generative AI)로 진화하고 나아가 에이전트 AI(agentic AI)가 되면서, 메모리가 전면에 나서게 되었고 대부분의 IT 분야에서 컴퓨트를 능가하는 제어 지점(control point)이 되었다. 이는 우리 중 많은 사람들에게 다소 혼란스러울 수 있는데, 변화의 개념 자체보다는 그 규모와 속도 때문에 그렇다.
여기에는 Gartner가 제공한 메모리 대 비메모리 판매에 대한 최신 칩 매출 분석이 있으며, 시장 조사관의 관점에서 플래시(flash)는 메모리로 간주된다:
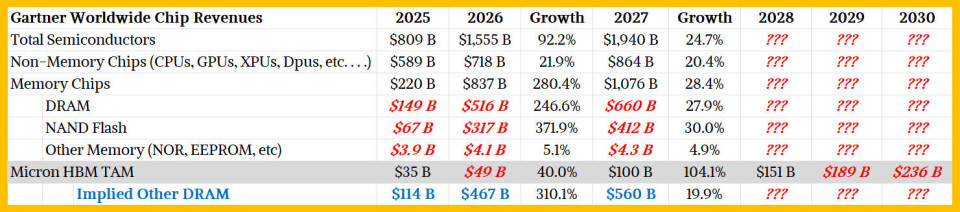
보시다시피, 반도체 시장 전체는 일종의 무어의 법칙(Moore’s Law) 곡선 위에 있어 매년 매출이 두 배가 되고 있다. 만약 '모어의 법칙'이라고 부르고 싶다면 그렇게 불러도 좋다. 거의 두 배 증가한 것은 2025년과 2026년 사이에 일어났지만, 보시다시피 예측은 2026년과 2027년 사이에 성장률이 둔화되는 것을 보여준다. 이는 우리가 GenAI 붐 이후로 불가피하다고 말해왔던 것이다. 어느 시점에서는 경쟁이 발휘되고, 또 다른 시점에서는 사람들이 필요한 일을 할 충분한 용량을 갖게 된다.
또한, 다른 종류의 DRAM(DDR4 및 DDR5, LPDDR4 및 LPDDR5 등)을 혼합 비율에서 역산할 수 있도록 Micron의 최신 HBM 메모리 전체 시장 규모 예측치도 추가했습니다. 보시다시피, 암시된 기타 DRAM 매출액이 HBM 판매량을 압도할 것이며, 이는 가까운 미래에도 그럴 가능성이 높습니다.
DRAM 메인 메모리, HBM 스택형 메모리, 그리고 플래시 스토리지를 향한 수요는 엄청나며, 이는 상업 기업들이 워크로드의 성능을 '확대'하려 하면서 디스크 드라이브 대신 채택했기 때문만은 아닙니다. 우리는 시스템 전반에 걸친 대규모 업그레이드 주기 속에 있습니다. 왜냐하면 전 세계 서버 플릿에 놓인 5년, 6년, 또는 7년 된 장비들이 업그레이드되어야 하기 때문입니다. 그리고 AI 시스템을 위해 공간과 전력을 절약하기 위해 기업들은 코어의 거의 최대 밀도를 추구하고 있으며, 이는 다시 고용량 DRAM 및 플래시 수요를 촉진하고 있습니다. 전통적인 IT 분야(트랜잭션 처리, 데이터 웨어하우징, 데이터 분석, 웹 인프라)는 플래시와 DRAM 메모리 측면에서 거대 기술 기업들과 그들의 엄청난 GenAI 야망과 경쟁하는 상황에 놓여 있습니다. 게다가 메모리 제조사들이 더 높은 매출(하지만 반드시 더 높은 이익은 아닐 수 있음)을 쫓아 AI 가속기를 위한 HBM 스택형 메모리를 생산하기 위해 DRAM 칩 용량을 전환하면서, DRAM 공급이 타이트해지고 있습니다.
이는 DRAM 가격을 급등하게 만들었습니다. 2022년 11월, OpenAI의 ChatGPT가 생성형 AI(GenAI) 붐을 일으켰을 때, 서버용 DDR4 메모리는 GB당 약 3달러였고 DDR5 메모리는 GB당 약 4달러였습니다. (이 가격들은 중간 용량에 대한 평균치입니다. 밀도가 높은 메모리는 GB당 훨씬 더 비싸고, 용량이 작은 메모리는 상당히 저렴합니다.) 30TB TLC 엔터프라이즈 SSD는 GB당 약 10센트에서 13센트 정도였습니다. 4년 후, DDR4 서버 메모리의 일반 판매 가격은 2배에서 3배 더 비싸졌고, DDR5 서버 메모리는 9배에서 13배나 높아졌으며, 그 30TB TLC SSD는 6배에서 7배 더 많은 비용이 들게 되었습니다. 참고로, 이러한 변화의 일부는 수십 년 동안 메모리 및 플래시 비즈니스를 괴롭혀온 과잉 공급 문제로 인해 2021년 말에 발생한 메모리 및 플래시 가격 폭락 때문이기도 합니다.
그리고 참고로, 디스크 드라이브 가격도 급등했습니다. 30TB 근접 라인(nearline) 디스크 드라이브는 같은 기간 동안 약 2.5배의 비용이 들며, 저렴한 디스크를 살 수 있다고 생각한다면 잊으셔도 좋습니다. 왜냐하면 하이퍼스케일러와 클라우드 빌더들이 남아있는 세 개의 디스크 드라이브 제조사(Seagate, Western Digital, Toshiba)로부터 대다수의 디스크 드라이브 공급을 계약했기 때문입니다.
HBM은 조금 다릅니다. 우선 HBM 스택형 DRAM 메모리 제조업체는 Samsung, SK Hynix, Micron Technology 세 곳이 있으며, 시장이 개방되어 있지 않고 Nvidia 및 AMD 두 GPU 제조사와 XPU 제조사 및/또는 이들의 칩 관리자들에게만 전용되기 때문에 현물 가격(spot price)이 없습니다. 따라서 가격 정보가 다소 불분명합니다.
HBM2가 2017년에 처음 출시되었을 때 약 20달러/GB를 호가한다는 소문이 돌았지만, 이는 2년 후에는 약 8달러/GB 수준으로 안정화되었습니다. 대역폭(bandwidth) 향상을 제공한 HBM2E의 경우 약 10달러/GB였으며, 스택당 용량과 대역폭이 더 많은 HBM3는 약 12달러/GB까지 상승했고, 대역폭 부스트가 적용된 HBM3E는 약 13.50달러/GB였습니다. 차세대 GPU와 XPU에서 출하될 예정인 HBM4의 경우, 약 16달러/GB를 호가한다는 소문이 있습니다 – 실제로는 Nvidia의 계약 가격이 36GB 스택당 560달러에서 600달러라는 것입니다. 어떤 이유에서인지 일부 사람들은 상당한 대역폭 향상을 갖춘 HBM4E가 HBM4보다 GB당 두 배 비쌀 것이라고 예상하고 있습니다. 저는 위에서 제시된 HBM2부터 HBM4 메모리의 추세 데이터를 고려할 때, 그렇게 믿기 어렵습니다. 20달러/GB는 이해할 수 있지만, 이점들에도 불구하고 36달러/GB는 상상하기 어렵습니다.
여기서 기억해야 할 점이 있습니다: 완제품 HBM 부품의 GB당 비용은 GenAI(생성형 AI) 붐이 시작된 이후로 단지 1.6배 상승했을 뿐입니다. 반면, 제조 과정에서 정상적이지만 수율(yield)이 100% 미만이기 때문에 폐기되는 DRAM 칩의 수는 세대가 지날수록 증가하고 있습니다. 현재 떠도는 생각은 HBM 제조업체들이 2027년에 HBM4E 가격을 인상하여 HBM의 수익성을 표준 DRAM과 비슷하게 맞추겠다는 것입니다.
덧붙여, 위에 언급된 HBM 비용은 최종 사용자가 장치에 HBM 메모리를 구매할 때 지불하는 금액이 아닙니다. 이는 위에서 설명한 DRAM 및 플래시 가격과는 다릅니다. 제가 2024년 2월에 작성했던 He Who Can Pay Top Dollar For HBM Memory Controls AI Training에서 설명했듯이, 사용자가 GPU와 XPU를 구매할 때의 HBM 비용은 공급업체가 구매하는 가격보다 훨씬 높습니다. HBM 메모리는 Nvidia와 AMD가 제공하는 GPU 사용자에게 전체 비용의 절반을 차지하며, OpenAI가
사실은 이렇습니다. 저는 GPU 및 XPU 제조사(및 설계자)들이 할당받는 최대한의 HBM을 활용하기 위해 어떤 시도를 하고 있는지에 대한 모든 소문을 들었습니다. 일부는 메모리 용량을 어느 정도 희생하면서도, 추론(inference)의 디코딩 부분에 중요한 메모리 대역폭을 유지하기 위해 HBM4로 전환하는 대신 HBM3E 스택을 더 많이 사용하는 방식을 고수하고 있습니다.
Nvidia가 2027년에 출시될 예정이었던 'Rubin Ultra' GPU의 초기 계획에서 물러나고 있다는 소문이 돌고 있습니다. 이 GPU는 레티클 제한(reticle-limited)된 네 개의 GPU 칩렛과 최대 1TB의 HBM4E 메모리를 탑재할 예정이었습니다. AMD는 'Altair' MI455X GPU 가속기의 경우 488GB를 유지하고 있는 반면, Nvidia는 일부 미래 Rubin 및 Rubin Ultra 설계에서는 192GB까지 낮출 것을 고려하고 있다고 알려졌습니다.
더 가능성이 높아 보이는 것은 Nvidia가 HBM 컨트롤러를 GPU 칩렛에서 분리하여 HBM4 및 HBM4E 설계로 가능한 맞춤형 베이스 다이(base die)에 통합할 것이라는 점입니다. 이는 Nvidia가 NVHBM이라고 부르지만, 결코 Nvidia만의 고유한 기술은 아닙니다. 다른 회사들도 자신들의 HBM 스택을 위한 맞춤형 베이스 다이를 갖게 될 것이며, 그중 상당수는 메모리 내부에서 특정 수학적 함수를 내장할 것입니다. 이는 프로세서 인 메모리(processor in memory) 또는 PIM이 지난 10년간 해왔던 방식입니다 (시장 견인력 없이). 이를 통해 무언가를 GPU나 XPU로 끌어와야 하는 대신, 메모리 자체에서 처리되도록 만들 수 있습니다.
Nvidia가 설명하듯이, HBM 스택의 이러한 맞춤형 베이스 다이가 중요한 이유는 다음과 같습니다. “메모리 컨트롤러를 XPU가 아닌 3D HBM 스택에 통합함으로써, NVHBM은 표준 HBM4E 대비 최대 30% 더 높은 메모리 대역폭과 15% 낮은 HBM 전력 소비를 제공하며, XPU 컴퓨트 다이의 면적을 최대 25%까지 확보할 수 있습니다.”
제가 도박꾼이라면, Rubin Ultra가 각 칩렛당 확보된 추가 25%의 칩 면적을 활용하여 두 개의 칩렛 전반에 걸쳐 더 많은 성능을 추가하고, 어쩌면 HBM4E 메모리 512GB를 제공하거나 동일한 대역폭으로 384GB를 제공할 것이라고 베팅하겠습니다. 원래 Rubin Ultra는 GPU 칩렛당 네 개의 스택을 가지고 있었으며, 이는 각 4GB씩 총 16개의 칩으로 구성되어 1,024GB 용량을 달성했고, 삼성의 스택 사양을 고려했을 때 무려 58TB/sec의 총 메모리 대역폭을 제공했습니다. 스택 높이를 줄이고 칩렛 수를 절반으로 나누면, 28TB/sec의 대역폭을 유지하면서 각각 256GB(높이 8), 384GB(높이 12), 또는 512GB(높이 16) 용량을 확보할 수 있습니다.
모든 GPU 및 XPU 제조사들은 비슷한 선택지를 살펴보고 있으며, 그들이 진정으로 원하는 것은 최첨단 기술을 사용하는 장치에 대해 최대 HBM 용량과 대역폭을 훨씬 낮은 GB당 가격으로 얻는 것입니다.
AI 자동 생성 콘텐츠
본 콘텐츠는 The Next Platform의 원문을 AI가 자동으로 요약·번역·분석한 것입니다. 원 저작권은 원저작자에게 있으며, 정확한 내용은 반드시 원문을 확인해 주세요.
원문 바로가기