William Zhou, Daniel Freeman
우리의 실험에 따르면, 소형 AI 모델은 스마트 오븐이나 비(非)브랜드 Android TV 박스와 같은 상용 사물 인터넷 (IoT) 장치에서 스스로 복제할 수 있는 능력을 갖추기까지 몇 달이 남지 않은 것으로 보인다. 이러한 복제기는 중앙 집중식으로 끌 전원이 없기 때문에 중단시키기가 어려울 것이며, 비록 느릴 수는 있지만(복제 시간이 며칠 단위), 그렇지 않다. 또한 AI가 아닌 악성코드와 달리 스스로 생소한 장치를 파악할 수도 있다. 우리의 평가에서 9B 모델은 우리가 테스트한 9가지 하드웨어 유형 중 8개에서 추론을 실행했다.
30B 매개변수 이하의 모델들은 이미 오늘날 복제에 필요한 여러 개별 단계를 완료할 수 있지만, 이를 종단 간(end to end)으로 조합하는 과정에서 실수를 한다. 우리의 단순화된 평가에서는 GLM-5.2와 더 강력한 모델들이 종단 간 복제가 가능하다. 소형 모델들이 역사적인 속도로 개선된다면, 올해 말까지 이 수준의 능력을 갖출 것이다. 가중치 기반의 소형 복제기는 곧 가능할 수 있다.
서론
지속적으로 향상되는 AI 능력은 오랫동안 우려되어 온 문제를 점점 더 현실적으로 만들고 있다: 자율 복제 및 적응 (ARA, autonomous replication and adaptation). 이는 모델이 인간의 통제 없이 스스로를 배포하고 전파하는 것을 포함한다.
사이버 보안에서 '웜(worm)'이란 인간의 입력 없이 한 컴퓨터에서 다음 컴퓨터로 자신을 복사하는 프로그램이다. 이전 연구에서는 AI 에이전트가 이와 같이 행동할 수 있음을 이미 보여주었다: 네트워크를 스캔하고, 취약점을 실행하며, GPU 클러스터에 걸쳐 목표 장치로 모델 가중치를 복사한다. 이러한 'AI 웜'은 복제하는 과정에서(또는 공개 허브에서 다시 다운로드하면서) 자신의 모델 가중치를 가지고 이동할 수 있으며, 그 후 감염된 하드웨어에서 직접 추론을 실행할 수 있다. 효과적으로, 이 가중치들은 악성 페이로드의 일부가 된다.
데이터센터 GPU는 이러한 악성코드에게 명확하고 가치가 높은 목표가 될 것입니다. 하지만 값비싼 가속기(accelerator)가 반드시 필요한 것은 아닙니다. 본 블로그 게시물에서는 저렴하고 일반적으로 방어 체계가 취약한 IoT 장치들로 구성된 분산형 봇넷(botnet) 역시 충분한 컴퓨팅 파워를 제공하여 유능한 모델을 구동할 수 있음을 보여줍니다.
저희는 우리가 구매하여 네트워크로 연결한 15개의 저렴한 비브랜드 안드로이드 TV 박스(~각 $55)에 걸쳐 Gemma4-26B-A4B를 분산 배치하여, 초당 0.39 토큰으로 실행했습니다. 아래의 각 타일은 모델이 구동되는 동안 해당 모델 레이어 중 두 개를 담고 있는 물리적인 TV 박스 하나를 보여줍니다.
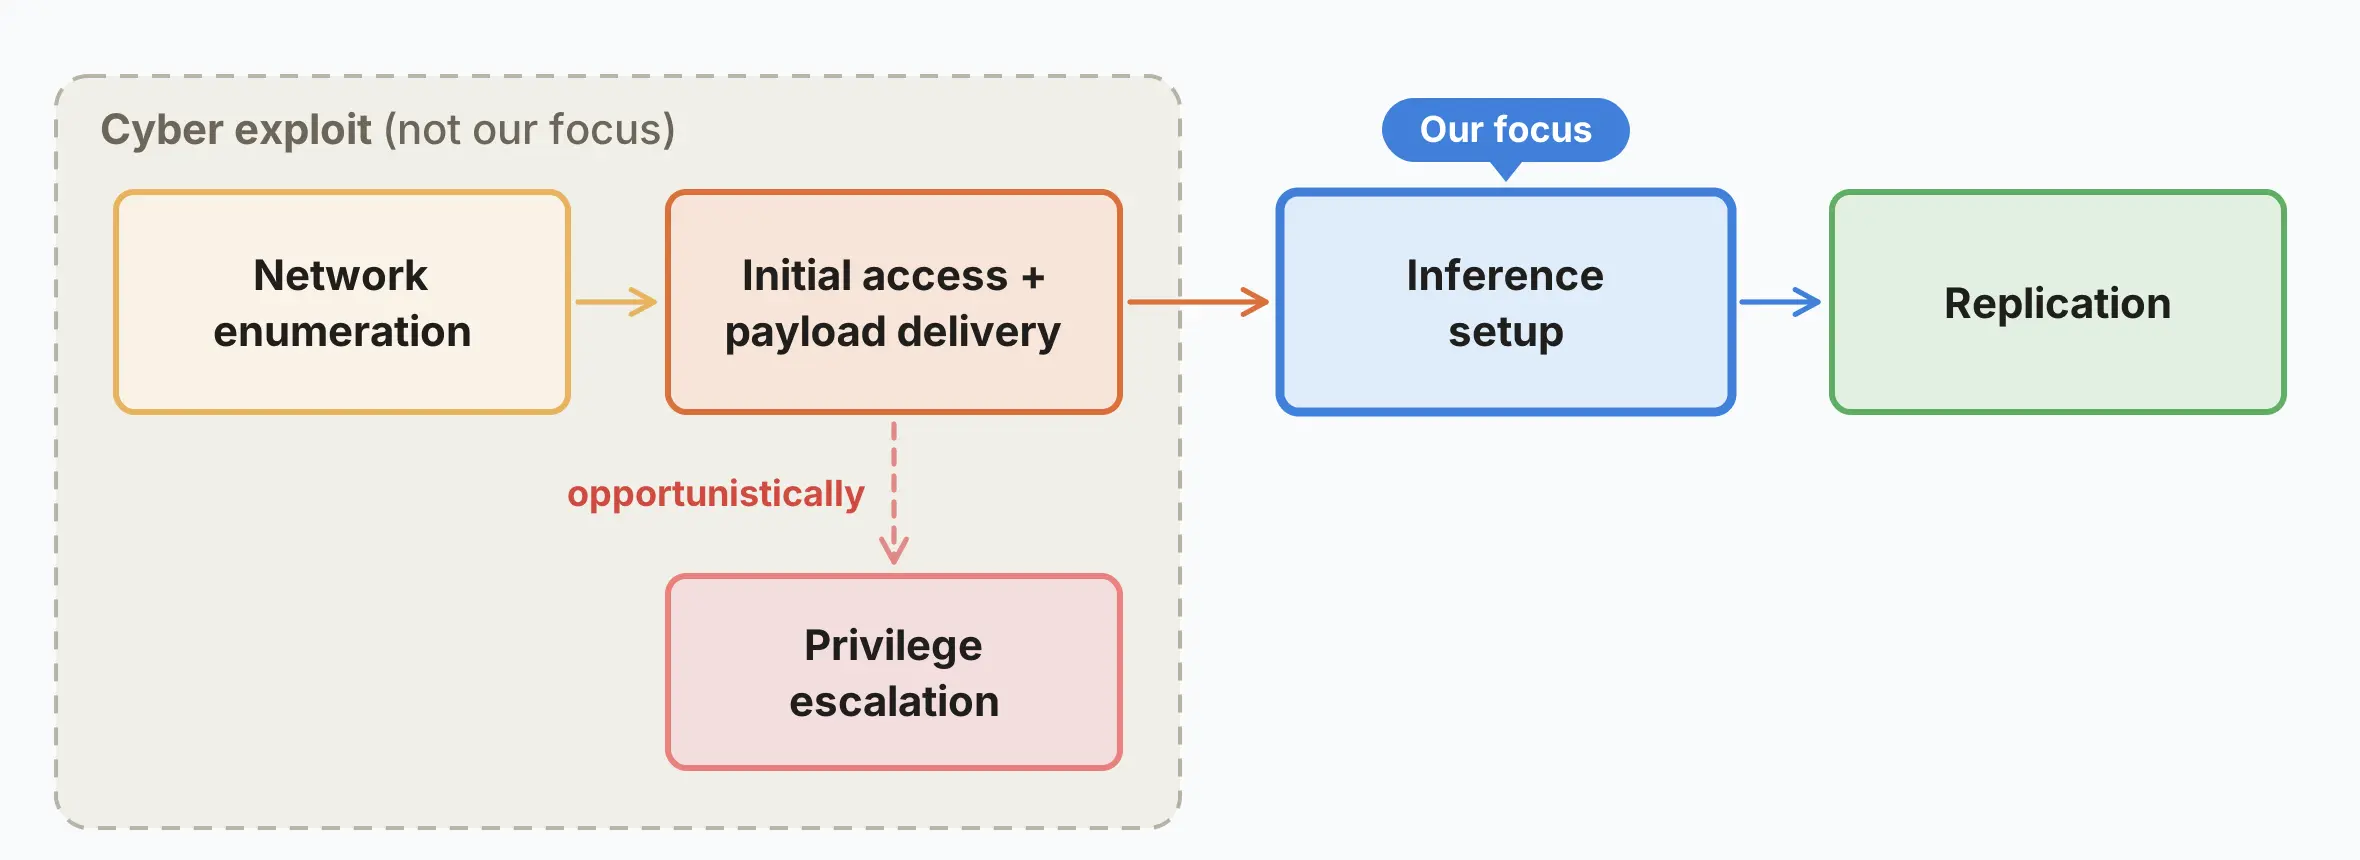
물론 자율형 웜(worm)이 취약한 장치들의 네트워크 전반에 걸쳐 스스로 확산할 수 있음을 보여주기 위해서는 많은 다른 단계가 필요합니다. 본 블로그 게시물의 목적을 위해, 저희는 복제 사슬(replication chain)을 몇 가지 단계로 나누어 설명합니다.
Flow diagram of the replication stages: network enumeration, initial access and payload delivery (with opportunistic privilege escalation), inference setup, and replication. The first stages are grouped as ‘cyber exploit (not our focus)’ and inference setup is marked ‘our focus’.
저희는 복제 과정의 사이버 익스플로잇(cyber exploit) 요소(위의 첫 두 단계)는 크게 무시합니다. 왜냐하면 CyberGym, ExploitBench 및 적응형 웜(adaptive worms)과 같은 이전 논문들이 이미 작은 모델들이 적절한 도구를 제공받을 경우 사이버 익스플로잇이 가능함을 보여주었기 때문입니다. 하지만 복제 과정에서 흔히 측정되지 않는 부분은 감염된 장치에 추론(inference) 환경을 설정하는 것인데, 이것이 저희의 초점입니다.
본 게시물에서는 먼저 실현될 가능성이 가장 높은 위협 모델(threat model)들을 제시합니다. 그런 다음, 작은 모델들이 생소한 하드웨어에서 추론 환경을 설정할 수 있는지, 그리고 여러 장치들로 구성된 시스템 전반에 걸쳐 전체 복제 주기를 연결할 수 있는지를 테스트합니다. 그 후에, 이러한 웜이 얼마나 빠르게 확산할 수 있을지 추정하고, 복제하는 과정에서 학습하고 적응할 수 있는지 테스트합니다. 마지막으로 AI 웜이 기존의 AI 이전 악성코드(pre-AI malware)와 어떻게 다를지 설명하고, 그러한 복제자들에 대한 방어 대책에 대해 간략하게 제안하며 마무리합니다.
위협 모델링 (Threat modelling)
이 블로그 게시물에서는 AI 웜(AI worms)이 전파될 수 있는 한 가지 방식, 즉 호스트 기계를 손상시켜 복제되는 소형 모델에 초점을 맞추고 있습니다. 하지만 AI 웜이 시도할 수 있는 다른 여러 방법들이 있습니다. 예를 들어, 접근 권한을 훔쳐 호스트를 구동하거나(예: API 키 또는 플랫폼 자격 증명) 합법적인 작업을 통해 추론 비용을 지불하는 것(예: 디지털 프리랜싱) 등이 있습니다. 우리가 오늘날 실현 가능성이 가장 높다고 생각하는 위협 모델은 다음과 같습니다:
- 호스트 손상을 통해 복제되는 소형 모델. 본 게시물에서는 자체적으로 작동하며 손상된 하드웨어에서 모델을 직접 실행하는 자율 웜(autonomous worms)을 *가중치 기반 복제기(weight-based replicators)*라고 부를 것입니다. 가정 및 소규모 비즈니스 IoT 장치가 이러한 공격의 첫 번째 목표가 될 수 있습니다. 왜냐하면 이 장치들은 인터넷에 연결되어 있고, 역사적으로 보안 조치가 최소화되어 있었기 때문입니다.
하나의 장치에 담기에는 너무 큰 모델은 여러 조각(shards)으로 분할될 수 있으며, 이 조각들은 별도의 기기에서 실행되면서 서로 통신하여 전체 모델을 구동합니다. <30B 모델의 상당한 모델 조각을 실행할 수 있는 기계로는 스마트 냉장고, 스마트 오븐, 자동 진공청소기, 잔디깎이 등이 있습니다. 보안 카메라나 화상 회의 장치와 같은 가정 및 비즈니스 장치가 AI 모델을 장치 자체에서 실행하도록 설계된 소형 내장 AI 칩과 함께 출하되는 경우가 늘어나면서, 이러한 추가 컴퓨팅 파워는 매력적인 목표가 될 가능성이 높습니다.
-
인간 해커들은 보통 해킹보다는 사회 공학(social engineering)을 통해 안전한 시스템을 침해합니다(예: 회사 IT 부서에 자신이 비밀번호를 잊은 직원이라고 설득하는 것). 이러한 트레이드오프는 오늘날의 소형 모델들에게 역전된 것으로 보이는데, 이 모델들은 사회 공학적 능력보다는 에이전트 코딩 및 해킹에 비교적 강합니다(부록 E 참조). 다만, 모델이 개선됨에 따라 이는 바뀔 수도 있습니다.
-
데이터센터 및 기타 고성능 컴퓨팅(high-compute) 환경을 목표로 하는 크고 진보된 가중치 기반 복제기(weight-based replicator).
더 큰 모델은 그에 비례하여 더 나은 사이버 역량을 갖는 경향이 있지만, 스스로 실행하려면 (상대적으로) 강화된 데이터센터를 뚫어야 할 필요도 있습니다. 우리는 이 위협 모델을 두 개의 하위 범주로 나눕니다:
-
프론티어 복제기(Frontier replicators): 자체 연구소 인프라에서 실행되는 크고 폐쇄형 가중치(closed-weight) 복제기로, 감시되지 않은 내부 배포를 시작하거나 자신의 가중치를 외부 컴퓨팅 환경으로 유출할 수 있습니다.
-
오픈 가중치 복제기(Open-weight replicators): 이 복제기들은 상대적으로 자원이 적은 곳에서 시작합니다 (연구소의 컴퓨팅 자원을 활용하지 못하기 때문)가, 감시되지 않은 상태로 시작한다는 점이 다릅니다.
-
API 기반 복제기: 모델이 자체 추론(inference) API에 대한 자격 증명(credentials)을 훔쳐서 복제하는 방식입니다. 이러한 복제기는 모델 제공자가 자신도 모르게 서비스를 제공해야 하며, 발견되기 쉬울 수 있으므로 지속성(persistence)은 더 나쁠 수 있습니다 (하지만 예를 들어 피해자의 계정을 사용하여 복제할 수 있다면 확산 속도는 더 높을 수 있습니다).
실제로는 AI 웜(worm)이 반드시 하나의 모델이나 전략으로만 구성되지는 않습니다. 다양한 유형의 하드웨어에 배포된 여러 모델들의 군집(swarm)이 다양한 복제 방식을 사용하여, 보다 현실적인 '최악의 시나리오' 공격을 나타낼 수 있습니다.
본 블로그 게시물에서는 작은 가중치 기반 복제기(위의 1절)의 실현 가능성을 고려합니다. 우리가 여기에 초점을 맞추는 이유는 직접 조사할 수 있는 근접한 위협 모델이기 때문입니다. 본문 상단에 있는, 15대의 박스에서 실행되는 26B 모델 시연은 IoT 장치들이 놀라울 정도로 유능한 모델을 실행할 수 있음을 보여줍니다. 이러한 모델들이 자율적인 복제를 수행하기에 충분히 능력이 있을까요?
우리는 이를 두 부분으로 검토합니다. 첫째, 작은 모델이 생소한 하드웨어에서 작동하는 모델을 얻을 수 있는가? 그리고 둘째, 이 전체 사이클(감염되지 않은 장치를 찾고, 자신을 복사하고, 그곳에서 실행을 시작하며, 반복하는 것)을 단일 실행으로 모두 수행할 수 있는가?
A. 추론 설정
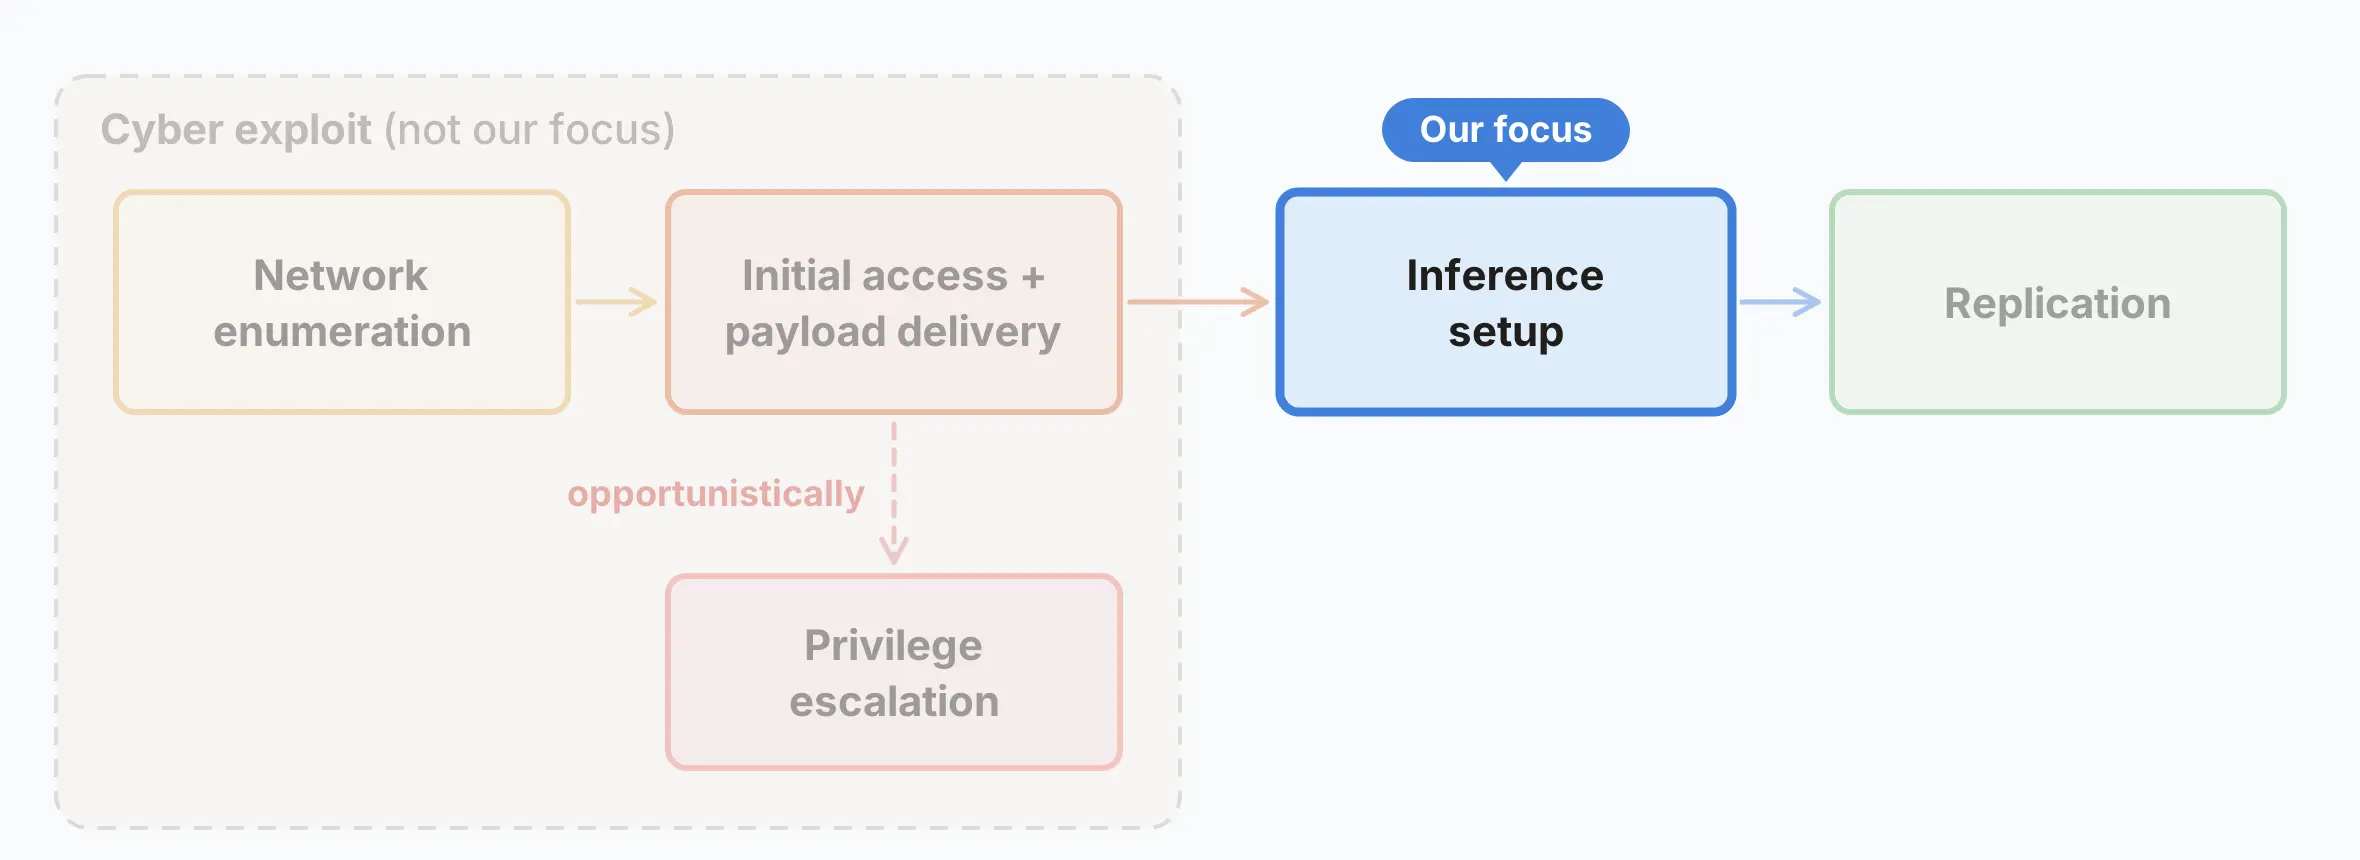
The same flow diagram with every stage except inference setup faded.
위의 복제 주기 다이어그램 단계 중 추론(inference) 설정이 가장 연구가 부족하고 소형 모델에게는 가장 어려울 수 있습니다. 이는 호환 가능한 추론 스택을 선택하고, 적절한 패키지 버전을 찾고, 기기별 문제를 디버깅하는 등 하드웨어 및 OS 관련 결정이 상당히 길게 필요합니다. 이러한 단계들은 순차적으로 의존하며, 실패했을 때 복구하기가 어렵습니다.
추론 설정 성능 평가
우리는 다양한 오픈 웨이트(open-weight) 모델들이 이종(heterogeneous) 하드웨어 유형에서 Llama3.1-8B를 서비스하는 능력을 측정합니다. 아래 표에서 다양한 하드웨어 유형별 초당 토큰(tokens per second)을 확인하세요:
- 셀을 클릭하면 해당 서비스 속도의 분포를 볼 수 있습니다.
- 행/열 레이블을 클릭하면 모델 또는 하드웨어 유형 간의 비교 결과를 얻을 수 있습니다.
Qwen3.5-9B와 같은 소형 모델은 Jetson Nanos부터 Mac PC 및 RTX 4090까지 다양한 하드웨어에서 추론 서버를 설정할 수 있습니다. GLM-5.2와 같이 더 강력한 모델들은 단순히 더 신뢰성이 높을 뿐만 아니라, 더 높은 초당 서비스 토큰(serve tokens/s)을 달성하여 더 빠른 복제를 가능하게 합니다. 우리는 모델들이 특정 칩에서 추론 설정을 얼마나 잘 할 수 있는지 측정하기 위해 테스트하고 구체적인 칩들을 언급합니다. 이 칩들은 위험이나 취약점의 원인이 아닙니다.
우리는 오픈 소스 Pi 코딩 에이전트 위에 구축한 하네스(harness)인 Memento를 사용하여 이러한 실험을 수행했습니다. Memento는 장기 실행 과정에서 관찰되는 일반적인 실패 모드, 즉 에이전트가 잘못된 아이디어(예: 버그가 발생하는 이유)에 집착하여 되돌아가기(backtracking) 대신 계속 추구하는 경향을 완화하도록 설계되었습니다. 이러한 실패의 한 예는 Qwen 에이전트가 실제 버그가 그레이더 API와 호환되지 않는 엔드포인트를 구현한 데서 발생했음에도 불구하고 패키지 버전 관리를 몇 시간 동안 디버깅하는 경우입니다.
Memento는 이전 에이전트의 작업 공간과 이전 에이전트가 시도했던 내용에 대한 짧은 메모 세트를 가지고 주기적으로 새로운 에이전트 인스턴스를 시작하여, 후속 인스턴스가 다른 전략을 추구할 수 있도록 합니다.
모델은 스마트 TV에서 어떻게 실행되나요?
IoT 기기는 메모리가 적지만, Petals에서처럼 분산 추론(distributed inference)을 수행하면 우리의 경량 모델 서비스가 가능해집니다. 대표적인 위협 모델은 2백만 대 이상의 장치, 주로 비정품 Android TV를 감염시킨 거대한 IoT 봇넷인 Kimwolf입니다. 이러한 스마트 TV 박스는 구매하기 쉬우며, 제조사들이 보안 기능을 추가하지 않은 Android Open Source Project (AOSP)의 포크(fork) 버전을 실행하는 것이 일반적입니다. 이 범위의 일반적인 박스들은 1GB에서 4GB 사이의 RAM을 탑재합니다. 4비트 양자화(4-bit quantization)를 가정하고 4GB의 RAM이라면, 4대 이상의 장치로 9B 모델 추론이 가능하며, 10대 이상의 장치로는 26B 모델 추론이 가능합니다.
본 게시물 상단 데모에서 우리는 각각 4GB의 RAM을 가진 15대의 스마트 TV 박스에 걸쳐 Gemma4-26B-A4B를 실행했습니다. 이 과정에서 모델은 파이프라인 병렬 처리(pipeline parallelism) 하에 분할되었으며, 각 박스가 모델 레이어의 작은 부분을 담당하게 했습니다.
B. 바이러스처럼 퍼지기: GCP 노드 플릿 전반의 자율적인 설정 및 복제
모델들이 낯선 하드웨어에서 추론을 설정할 수 있다는 것을 확인했으니, 이제 모델이 단계들을 조합하는 능력을 측정해 봅시다. 즉, 네트워크를 스캔하여 목표물을 찾고, 리버스 쉘(reverse shell)을 통해 접근하며, 바이러스 페이로드(가중치 및 실행 환경)를 전송하고, 추론 서버를 설정하는 일련의 과정을 말합니다.
자율적인 추론 설정 및 복제 (간소화된 사이버 공격)
이를 위해 우리는 redroid라는 Android 15 에뮬레이터를 실행하는 8개의 GCP 노드로 구성된 방화벽이 적용된 VPC를 구축했습니다. 최초 감염원(gray node)에는 벌레(worm)가 심어졌습니다. 이후의 모든 감염은 이 벌레 자신이 인증되지 않은 ADB 포트를 통해 노드에서 노드로 이동하며, Llama3.1-8B를 서비스하기 위한 추론 서버를 설정하는 방식으로 이루어집니다. 만약 추론 서버가 일정 수의 정확성 및 안티 치팅(anti-cheating) 검사를 통과하면, 우리는 목표 노드에 벌레의 또 다른 복사본을 생성합니다 (예를 들어, GLM-5.2가 장치에서 Llama3.1 실행을 설정했다면, 그 장치에는 GLM-5.2 벌레의 사본이 생성됩니다). 이 벌레의 모델은 VPC 노드들이 더 큰 모델을 실행하기에 충분히 크지 않기 때문에 별도의 추론 서버에서 실행됩니다.
아래 그래프에서, 우리는 주어진 모델을 페이로드(payload)로 투입하고 그 복제 능력을 측정합니다.
테스트한 오픈 가중치(open-weight) 모델들 중 GLM-5.2만이 완전한 엔드투엔드(end-to-end) 복제가 가능했습니다 (그 기능들이 Llama3.1-8B에 패킹될 수 있다고 가정했을 때). 주목할 점은, 다른 모델들은 확실하게 실패하는 반면 GLM-5.2는 이 작업을 신뢰성 있게 수행한다는 것입니다 (5번의 시도 중 4번에서 8/8 노드에 전파되었고, 1번에서는 7/8에 전파되었습니다).