
대규모 기술 기업이 막대한 컴퓨팅 자원을 투입한 Atari Skiing을 개인 개발로 하루 만에, 몇 달러의 코드로 능가하다 — TANREN
요약
LLM을 활용하여 코드를 진화시키고 검증하는 새로운 방법론인 TANREN(鍛錬)을 소개합니다. 이 기술은 Deep Reinforcement Learning이 취약한 Atari Skiing 게임에 적용되었으며, 단 하루 만에 몇 달러의 비용으로 기존 최고 성능 에이전트와 인간 기준을 능가하는 결과를 보여주었습니다. TANREN은 모델 가중치 대신 Python 함수 자체를 진화시키고 결정론적 검증기로 평가한다는 점에서 혁신적입니다.
핵심 포인트
- LLM 기반 코드 진화 엔진 TANREN 소개
- Atari Skiing에서 최고 성능 에이전트 능가 입증
- 모델 가중치가 아닌 '코드' 자체를 진화시킴
- 단기간, 저비용으로 고성능 결과 도출 가능
요약 (TL;DR)
- 동결된 LLM(거대 언어 모델)에게 코드를 작성하게 하고 검증기로 선별하는 진화 엔진 'TANREN(鍛錬)'을 심층 강화학습(Deep Reinforcement Learning)이 취약한 Atari Skiing에 투입했습니다. - 결과물은 읽을 수 있는 Python 함수 1개(127행)입니다. 사용되지 않은 시작 국면 10개에 대한 봉인 판정에서 평균 −3310.7점을 기록했습니다.
- 공개적으로 가장 강력한 RL 에이전트 R2D2(Bandit)의 −3851.44점에 10개 중 10개 승리(유의확률 검정 p=0.000977)를 거두었습니다. Agent57(−4202.6)과 인간 기준(−4336.9)도 능가했습니다. - 소요 시간은 약 하루(사전 측정 2시간 + 진화 2.5시간·60세대), API 비용은 몇 달러에 불과합니다. 가중치(weight)는 전혀 훈련하지 않았습니다.
- 챔피언 코드, 검증기, 당시 실행 기록은 GitHub에 MIT 라이선스로 공개했습니다. 본 기사에서는 그 코드를 실제로 읽어보겠습니다.
TANREN이란 무엇인가 (30초 만에)
TANREN은 모델의 가중치(weight)가 아니라 코드 자체를 진화시키는 방법입니다.
동결된 저렴한 LLM → 하나의 Python 함수의 변이체 대량 생산
결정론적 검증기 → 모든 후보 점수 평가 (LLM을 심판으로 사용하지 않음)
유전 알고리즘 → 최적의 것을 남기고 나머지는 버림
...
나오는 것은 AI 모델의 가중치(parameter)가 아니라, 짧고 읽을 수 있는 결정론적인 Python 함수입니다. 설계 개념과 Atari Pong을 21-0으로 완벽하게 클리어했던 이야기는 제1회에 작성했습니다.
이번에는 이 장치를 그대로 Skiing에 적용합니다.
이번의 전장: Atari Skiing
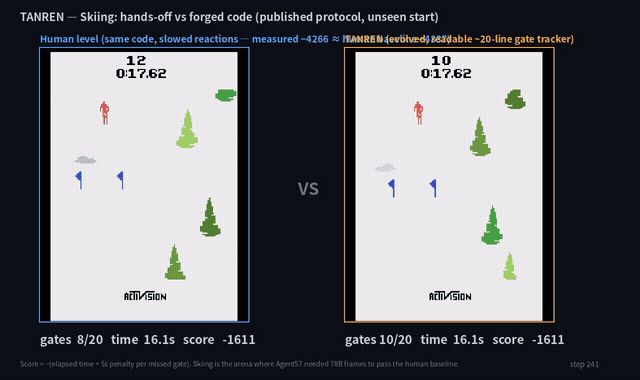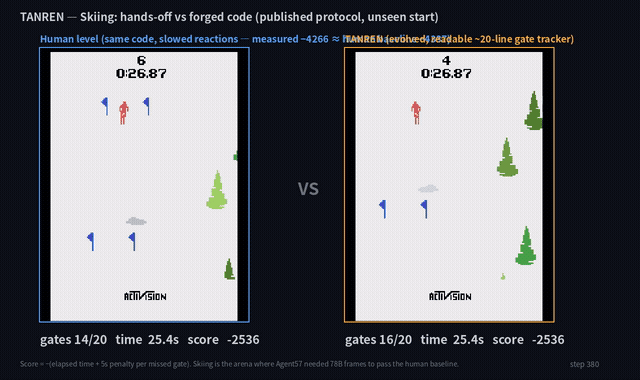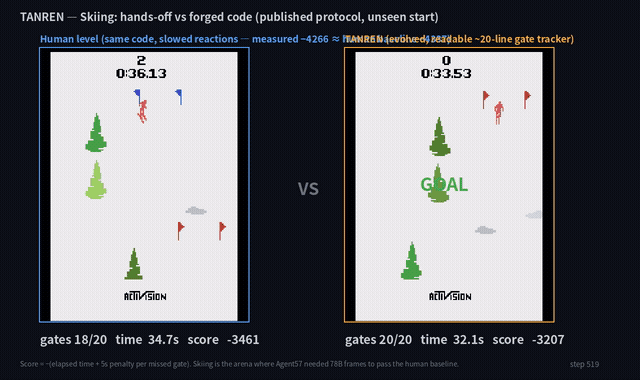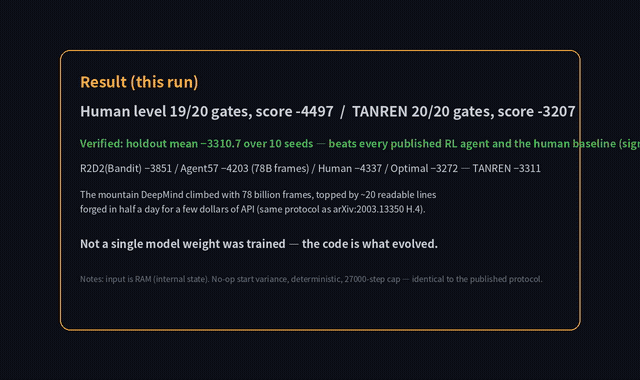
Skiing은 슬라롬 게임입니다. 점수는 다음 공식으로 결정됩니다.
점수 = −(소요 시간 + 실수한 게이트 수 × 5초 페널티)
0에 가까울수록 좋은 점수입니다. 까다로운 점은, 페널티가 골인 지점에서만 판정된다는 것입니다.
어떤 게이트 실수가 좋지 않았는지 보상(reward)으로부터 역산하기 어려운, 이른바 '지연 크레딧 할당(delayed credit assignment)'의 전형적인 예입니다.
공개된 수치를 나열합니다. 출처는 DeepMind 논문 Agent57: Outperforming the Atari Human Benchmark(arXiv:2003.13350)의 부록 Table H.4이며, optimal 값은 같은 논문의 본문에 있습니다.
| 에이전트 | Skiing 점수 |
|---|---|
| 논문 본문에서 optimal으로 기재된 값 | −3272 |
| TANREN (읽을 수 있는 Python 127행) | |
| −3310.7 | |
| R2D2(Bandit)= 공개적으로 가장 강력함 | −3851.44 |
| Agent57 | −4202.6 |
| 인간 기준 | −4336.9 |
| ... |
MuZero는 Skiing에서 무작위보다 낮은 점수를 기록합니다. 'Atari 57개 게임에서 인간 기준 초과'를 내세운 DeepMind의 Agent57은 이 게임에서 인간 기준을 넘어서기까지, 공개 수치로 약 780억 프레임 분량의 플레이가 필요했습니다. Atari는 1초에 60프레임이므로, 게임 내 시간으로 환산하면 약 41년 분 동안 계속 활강한 것과 같습니다.
반면에, 인간에게 이 게임은 어렵지 않습니다. 게이트를 보고, 조금 앞을 예측하고, 방향을 트는 것만 하면 됩니다.
즉, '판단 규칙(rule of judgment)'이 짧게 작성될 수 있다는 프로그램의 결정론성이 유리해지는 분야입니다.
이는 제1회에서 'TANREN이 강점을 갖는 영역'으로 언급했던 조건에 부합합니다.
문제 설정: 진화시키는 것은 함수 1개만
진화의 대상은 다음 시그니처를 가진 함수 단 하나뿐입니다.
def act(ram, prev, t, mem):
# ram : Atari 본체의 RAM 128바이트 (0..255의 튜플)
# prev: 직전에 반환된 행동
...
입력은 픽셀이 아니라 RAM 128바이트입니다. 어떤 바이트에 무엇이 들어있는지는 함수에게 알려주지 않습니다.
점수 평가를 하는 검증기는, 실제 에뮬레이터(ALE)에서 이 함수를 1 에피소드 동안 실행하여 점수를 반환하는 프로그램일 뿐입니다. 공개된 atarisim.py로부터 Skiing과 관련된 핵심 부분만 추출하면 다음과 같습니다.
def run_episode(act_fn, game, seed, max_steps=3000):
ale = ALEInterface()
ale.setInt(

⚠️ `[IMG:N]` 형식 토큰은 이미지 placeholder 입니다. 번역하지 말고 원래 위치에 그대로 유지하세요.

- **LLM은 채점에 관여하지 않습니다.** 같은 코드와 같은 seed를 사용하면 몇 번을 실행해도 동일한 점수가 나옵니다. -
**시작 국면을 seed로 다르게 합니다.** no-op의 횟수를 변경함으로써, 하나의 궤적만을 암기한 코드가 이길 수 없도록 했습니다. DQN이나 Agent57 논문과 같은 평가 방식입니다. -
**오류가 발생한 코드는 제외하지 않고 no-op으로 처리합니다.** LLM이 작성하는 코드는 보통 예외를 발생시키므로, 검증기 측에서 이를 받아들입니다.

## 실행 전에 승리 가능 여부를 측정하기

진화를 돌리기 전에 단계를 하나 거칩니다.

- **상대를 원본 자료로 고정합니다.** 이번에는 논문의 표를 확인하여 최강이 R2D2(Bandit)의 −3851.44임을 확인했습니다. 2차 자료에서는 Agent57이 최강이라고 쓰이는 경향이 있지만, 같은 논문의 표에서는 R2D2(Bandit)가 더 높습니다. -
**LLM을 사용하지 않는 수치 탐색으로 이 코드 형식의 한계를 측정합니다.** 골격만 갖춘 코드(파라미터 5개인 비례 조향)를 준비하고, 파라미터를 탐색합니다. **한계치가 상대에게 도달할 때만 진화를 실행합니다.**

Skiing의 측정 결과는 **−3619**였습니다. 단지 5개의 파라미터로 구성된 비례 조향만으로도 이미 R2D2(Bandit)・Agent57・인간 기준을 능가하고 있습니다. 여기서 GO입니다. 소요 시간은 약 2시간이었고, LLM 비용은 발생하지 않았습니다.

## 진화의 경과

변이기는 `google/gemini-2.5-flash-lite`를 사용했고, 섬(island)은 2개, 세대는 60세대입니다. 공개된 실행 기록 `atari_skiing_run1t.json`에 세대별 이력이 담겨 있으므로, 왕자가 업데이트된 시점을 추출합니다. 값은 확인용 시작 국면 20개(seed 80~99)의 평균입니다.

| 세대 | 왕자의 점수 (확인용 20개 평균) |
|---|---|
| 0 | −3650.25 |
| ... |
세대 18부터 30까지는 13세대에 걸쳐 거의 움직임이 없었고, 세대 31에서 한 단계 하락했습니다. 기록은 다음과 같이 읽을 수 있습니다.
import json
d = json.load(open(
# 수직 속도 추정 및 예측
current_vy_raw = ram[PLAYER_VY_RAW]
prev_vy_raw_avg = mem.get('prev_vy_raw_avg', 0.0)
...
현재 위치가 아니라, 깃문(gate)에 도착하는 시점의 위치를 기준으로 방향을 바꿉니다. 도달까지의 프레임 수는 수직 거리를 수직 속도의 평활값으로 나누어 추정하고 있습니다.
5. 2~3개 깃문 앞까지 보고 '통과 경로' 만들기
# 다중 게이트 조향 로직: 최소 두 개의 게이트가 있으면, 그 위치를 고려하여 방향을 잡습니다.
# 이는 연속된 게이트들을 통과하는 데 도움을 줍니다.
if len(closest_gates) >= 2:
...
이 부분이 종의 비례 조향에는 없던 부분입니다.
- 첫 번째와 두 번째 게이트 사이의 수직 간격이 20 미만이면, 첫 번째 게이트의 중심을 노립니다.
- 간격이 넓을수록 두 번째 게이트의 중심으로 가깝게 합니다(45 이상일 경우 완전히 두 번째 게이트를 따릅니다).
- 세 번째 게이트가 첫 번째 게이트로부터 수직 60 이내에 있으면, 그 중심과의 평균을 취합니다.
- 마지막으로, 첫 번째 게이트의 중심과 반반씩 섞습니다.
가장 가까운 깃문만 따라가면, 다음 깃문을 향한 방향 전환이 느려집니다. 앞선 깃문들을 섞어주면, 미리 자리를 잡는 움직임이 됩니다.
6. 16방위의 방향을 좌우 버튼으로 누르기
# 목표 수평 위치와 현재 예측 위치를 기반으로 원하는 방위를 결정합니다.
if target_x_center is None:
want_hd = 8 # 게이트가 없으면 직진으로 기본 설정합니다.
...
노리는 위치와 예측 위치의 차이에서 '향하고 싶은 방향'을 정하고(8은 직진, ±3.5로 클램프), 현재 방향과의 차이가 임계값을 초과하면 좌우 버튼만 누르면 됩니다.
읽을 수 있기에 보이는 거친 부분들
이 코드는 사람이 정리한 것이 아니기 때문에, 읽다 보면 거친 부분이 보이기도 합니다.
elif dh < -8:
분기에는 도달하지 않습니다. 직전에 % 16을 했기 때문에 dh는 0 이상 16 미만이며, 8을 초과하면 16을 빼므로, -8 미만이 될 수 없기 때문입니다. -
blend_factor
은 해당 줄이 있는 if len(closest_gates) >= 2: 블록 내에서는 항상 0.5입니다. -
weight1 + weight2
는 항상 1이기 때문에, 나눗셈은 필요 없습니다. -
좌우 임계값이
1.6
과 -1.8
로 비대칭적입니다. 주석에 TWEAKED THRESHOLD for turning left
이라고 되어 있어, 변이의 흔적이 그대로 남아 있습니다. -
gate_density
는 목표의 좌우와 관계없이 양의 방향으로만 더해집니다.
AI 모델의 가중치에서는 이런 지적은 할 수 없습니다.
어떤 줄이 어떻게 작동하는지 리뷰를 통해 확인할 수 있다는 것이 코드로 만드는 장점입니다.
champion.py 전체 내용(127줄)
def act(ram, prev, t, mem):
# Constants for byte indices (discovered through analysis/experimentation)
PLAYER_X = 25 # 플레이어의 수평 위치
...
결과
판정은 진화에도 선택에도 사용하지 않은 시작 국면 10개(seed 100~109)에서 단 한 번만 진행했습니다.
| seed | 100 | 101 | 102 | 103 | 104 | 105 | 106 | 107 | 108 | 109 |
|---|---|---|---|---|---|---|---|---|---|---|
| 점수 | −3654 | −3219 | −3310 | −3179 | −3185 | −3207 | −3273 | −3207 | −3654 | −3219 |
표지판 판정(封印判定) 10회의 평균: −3310.7
대 R2D2(Bandit): −3851.44
10회 중 10승 (단측 검정 p=0.000977)
대 Agent57: −4202.6 / 인간 기준 −4336.9 | 둘 다 상회
대 optimal: −3272 | 평균으로는 38.7에 미달. 10회 중 6회가 이 값보다 좋은 점수
비용: 사전 측정 2시간 + 진화 2.5시간(60세대) · API 수 달러 · 전체로 약 하루
단측 검정은 10회 모두 승리할 확률을 '승패가 오분'이라는 가정 하에 계산하는 것일 뿐입니다.
from math import comb
n = k = 10
p = sum(comb(n, i) for i in range(k, n + 1)) / 2**n
...
주의할 점이 두 가지 있습니다.
- 확인용 20회 값은 −3258.4였으나, 표지판 판정에서는 −3310.7입니다. 선별에 사용된 국면의 쪽이 더 잘 나오는, 흔한 차이가 여기에도 나타나고 있습니다. 보고하는 수치는 표지판 판정 쪽을 따릅니다.
- 10회 중 2회(seed 100과 108)는 −3654로, 나머지 8회보다 크게 나쁜 값입니다. 평균이 optimal에 미달한 것은 이 2회의 분입니다.
직접 재현 가능합니다
챔피언은 단순한 Python 함수이기 때문에 ale-py가 있으면 작동합니다.
git clone https://github.com/matu79go/tanren-champions
cd tanren-champions/skiing
pip install ale-py
...
champion.py를 수정하여 --champion으로 전달하면, 자신의 개조판을 동일한 검증기에서 채점할 수 있습니다. 위에 언급된 미흡한 부분을 고치면 점수가 어떻게 변하는지 시도해 보세요.
비교의 전제
숫자를 나열할 때의 조건입니다.
- 입력은 RAM(128바이트 내부 상태)이며, 픽셀이 아닙니다. 이미지에서 상태를 읽어오는 부분은 이번 대상 외입니다. -
게임 전용 코드입니다. Agent57 등은 하나의 기법으로 57게임을 푸는 범용 에이전트이며, 목적이 다릅니다. - 평가 프로토콜은 공개 측에 맞춰져 있습니다(결정론의 ALE · frame skip 4 · sticky actions 없음 · no-op에 의한 시작 분산 · 27000 스텝 상한). - '약 780억 프레임(게임 내 시간으로 약 41년분)'은 Agent57이 Skiing에서 인간 기준을 초과할 때까지의 공개 학습량이며, 41년은 60프레임/초로 환산한 값입니다. TANREN은 학습하지 않으므로 같은 축의 숫자가 아니라, 규모감의 대비로 제시하고 있습니다.
- 공개하는 것은 챔피언 · 검증기 · 실행 기록입니다. 진화 엔진 본체는 공개하지 않았습니다.
어디서든 이길 수는 없습니다
같은 공개 리포지토리에는, 승리하지 못한 기록도 놓여 있습니다. Bowling은 표지판 판정 185.7로 인간 기준(160.7)을 초과했지만, Agent57(251.18)에는 미치지 못했습니다. 사전 측정에서 나왔던 '이 코드 형식의 천장은 약 186'이라는 값에 결과가 그대로 착지했습니다.
Skiing에서 이기고 Bowling에서 도달하지 못한 차이는, 경기장의 성질에 있습니다.
- 가치가 소수의 구조적 판단에 집중된 과제 → 읽을 수 있는 코드로 정점에 도달함
- 가치가 무수한 정밀한 미세 조정에 분산된 과제 → 신경망의 영역
따라서, 달리기에 앞서 천장을 측정하여 승산이 있는지 여부를 먼저 판정합니다.
요약
Skiing의 결과로 말할 수 있는 것은, '심층 RL에게 어려운 난관'과 '문제 자체의 어려움'은 별개라는 것입니다. 보상이 늦게 도착하는 바람에 학습이 난항을 겪는 과제라도, 판단 규칙이 짧게 작성 가능하다면, 코드 진화는 몇 시간 만에 답에 도달합니다.
이번에 소개한 TANREN이라는 기법은, python의 알고리즘 생성을 작고 저렴한 LLM으로, 정련을 반복하여 심화시켜 나가는 것입니다.
LLM은 확률론으로 움직이기 때문에, 답이 안정적이지 않고, 내부의 움직임도 블랙박스로 파악할 수 없습니다.
반면, TANREN으로 생성된 프로그램은 결정론적으로 출력되기 때문에, 내부에서 무엇이 일어나고 있는지, 어떻게 작동하는지, 그리고 답이 항상 일정하다는 큰 장점이 있습니다.
맺음말
거대 자본으로의 편중이 진행되는 상황에서, '현재 가진 환경에서 무엇을 할 수 있는가'를 파고드는 것에는 비용 절감 이상의 의미가 있다고 생각합니다.
무대를 잘 선택한다면, 현재 가지고 있는 단일 머신과 몇 달러만으로도 빅테크 기업이 수백 장의 GPU와 오랜 시간을 들여 개발한 최고 점수를 능가할 수 있는 분야가 있습니다.
막대한 컴퓨팅 자원이 없더라도 지혜로 맞설 수 있는 방법은 분명히 있을 것입니다. 'AI 후진국, 일본'에 안주하지 않고, 제한된 리소스로 승기를 찾아내는 실전적인 방법을 앞으로도 연구하고 전파해 나가겠습니다.
- 챔피언 코드・검증기・실행 기록: https://github.com/matu79go/tanren-champions/tree/master/skiing
- 제1회(TANREN의 설계와 Pong): https://zenn.dev/suzukishoten/articles/68cd8e1f82858d
- 기술 리포트 상세・검증 로그: https://suzuki-shoten.dev/jp/projects/tanren/
- 작성자: 스즈키 쇼텐 AI & Software Engineer / FDE(업무・기술 상담은 사이트 또는 X의 DM까지)
Discussion

AI 자동 생성 콘텐츠
본 콘텐츠는 Zenn ML의 원문을 AI가 자동으로 요약·번역·분석한 것입니다. 원 저작권은 원저작자에게 있으며, 정확한 내용은 반드시 원문을 확인해 주세요.
원문 바로가기