Insights
AI가 자동으로 큐레이션·번역·정리하는 기술 동향 피드입니다.
© 2026 Molayo
AI가 자동으로 큐레이션·번역·정리하는 기술 동향 피드입니다.
본 페이지의 콘텐츠는 AI가 공개된 소스를 기반으로 자동 수집·요약·번역한 것입니다. 원 저작권은 각 원저작자에게 있으며, 각 게시물의 “원문 바로가기” 링크를 통해 원문을 확인할 수 있습니다. 저작권자의 삭제 요청이 있을 경우 신속히 조치합니다.
AI 에이전트에게 운영 환경 권한을 부여할 때, 단순 명령어 차단을 넘어 '대상 환경'을 판정하는 설계의 중요성을 다룹니다. hook을 활용해 명령어가 운영 환경을 향하는지 분석하고, 환경에 따라 실행 권한을 allow, ask, deny로 차등 부여하는 전략을 제안합니다.
LLM이 1토큰을 생성하는 디코딩 과정에서 GPU와 CPU의 역할 및 하드웨어적 병목 지점을 분석합니다. 디코딩 단계에서는 연산 성능보다 VRAM의 메모리 대역폭이 성능을 결정짓는 핵심 요소임을 설명합니다.
AI 생성물을 상업적으로 납품할 때 고려해야 할 5가지 실무 관점을 제시합니다. 미술관학적 관점의 이력 증명부터 품질 보증, 법적 리스크 관리까지 전문적인 기준을 다룹니다.
Claude Code와 VPS를 활용하여 16명의 AI 에이전트로 구성된 가상의 영업 회사를 운영하는 실전 사례를 소개합니다. MCP 서버와 후크 시스템을 통해 에이전트 간의 연속성을 확보하고 업무를 자동화하는 구체적인 설계 방식을 다룹니다.
AI 에이전트에게 구현과 테스트를 동시에 맡길 때 발생하는 품질 저하 문제를 해결하기 위한 실험적 접근을 다룹니다. 구현에 맞춰 테스트를 작성하는 AI의 특성을 극복하기 위해 에이전트를 격리하고, 사양(Specification) 기반의 검증 루프를 구축하는 방법을 제안합니다.
Claude Code 사용 시 구두로 전달한 정보가 memory 파일이나 규칙 문서에 자동으로 반영되지 않아 발생하는 불일치 문제를 다룹니다. 사용자가 직접 파일을 업데이트하지 않으면 AI는 과거의 규칙을 지속적으로 참조하며 일관된 오류를 범할 수 있습니다.
Claude Code의 지시 계층인 CLAUDE.md, Skill, 서브 에이전트, Hook의 동작 차이를 실측 실험을 통해 비교 분석합니다. 각 계층의 작동 타이밍과 강제력을 검증하여 상황에 맞는 최적의 지시 위치를 제안합니다.
LLM의 성능을 결정짓는 핵심 요소인 데이터 혼합 비율(Data Mixture)과 학습 단계별 전략을 분석합니다. 데이터의 종류를 5개 레이어로 분류하고, 사전 학습부터 SFT, DPO에 이르기까지 최적의 성능을 위한 데이터 배분 방식을 고찰합니다.
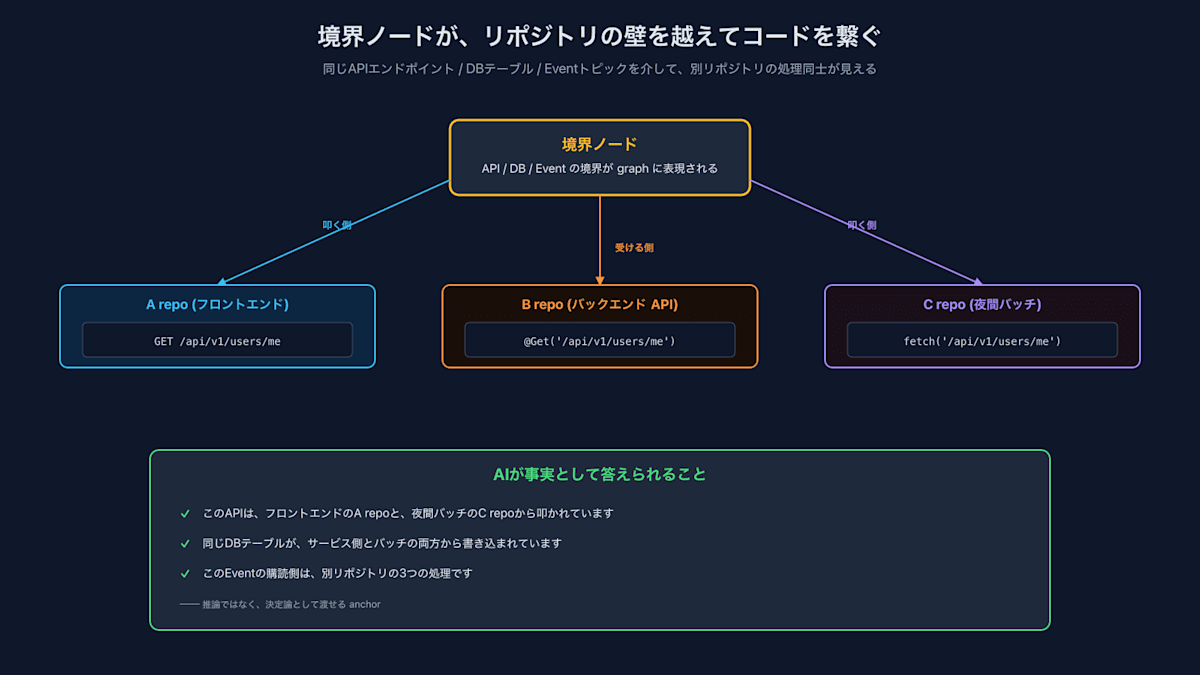
46개 리포지토리에 분산된 복잡한 코드베이스를 정적 분석을 통해 하나의 지식 그래프(code-graph)로 통합한 사례를 다룹니다. AI의 컨텍스트 윈도우 한계와 할루시네이션 문제를 해결하기 위해 외부에서 관계성을 추출하는 접근 방식을 설명합니다.
AI 에이전트에게 프롬프트를 직접 입력하는 대신, 에이전트가 자율적으로 작동하는 메커니즘인 '루프 엔지니어링(Loop Engineering)'의 중요성을 다룹니다. 엔지니어의 역할이 코드 작성에서 시스템 설계와 검증, 경계 짓기로 이동하고 있음을 강조합니다.

단일 GPU 환경에서 vLLM, Reranker, Embedding 프로세스를 동시에 운용할 때 발생하는 커널 행(Kernel Hang) 현상과 그 원인을 분석합니다. MPS(Multi-Process Service) 미사용으로 인한 프로세스 간 연산 경합이 GPU 사용률은 100%지만 실제 연산은 멈추는 문제를 야기함을 설명합니다.
Claude Code를 활용하여 직접 코드를 작성하지 않고도 UI 컴포넌트의 데모와 샘플 소스 간 정합성을 검증하는 품질 체크 스크립트를 구축한 사례를 소개합니다. 수작업의 한계를 느낀 시점에 AI에게 사양을 전달하여 문제를 해결하는 효율적인 워크플로우를 보여줍니다.
AI 에이전트가 보고하는 프롬프트 인젝션 탐지 결과가 실제 공격이 아닌 모델의 작화(Confabulation)일 수 있음을 경고합니다. AI의 자기 신고를 증거로 믿지 말고, 도구 결과나 파일 변경 사항 등 독립적인 로그를 통해 사실 관계를 확인해야 합니다.
Sakana AI가 멀티 에이전트 시스템을 하나의 API로 통합하여 제공하는 신제품 'Fugu'를 정식 출시했습니다. 연구 단계의 기술을 넘어 상용 프로덕트로 진화하며 AI 사용 방식을 혁신하려는 비전을 보여줍니다.
Amazon Bedrock에 탑재된 xAI의 Grok 4.3은 기존 Bedrock API인 Converse나 InvokeModel 대신, OpenAI 호환 추론 엔진인 Mantle을 통해서만 호출할 수 있습니다. 사용자는 OpenAI SDK를 사용하여 베이스 URL과 API 키를 설정함으로써 Bedrock 환경에서 Grok을 사용할 수 있습니다.
고추론 모델(High-reasoning model)을 사용할 때 명시적인 if-then 규칙이 오히려 모델의 판단을 방해하는 현상을 분석합니다. 규칙이 모델의 추론 능력과 충돌할 때 발생하는 문제를 해결하기 위해, 결정론적 규칙 대신 철학과 컨텍스트 중심의 프롬프팅으로 전환하는 과정을 다룹니다.

Confluent Cloud의 Flink SQL을 활용하여 복잡한 AI 에이전트 파이프라인을 통합 구축하는 방법을 소개합니다. 기존의 다중 컴포넌트 아키텍처 대신 SQL 함수만으로 이상 탐지, 벡터 검색, 에이전트 실행을 구현할 수 있습니다.
Z.ai의 GLM Coding Plan이 지난 반년 동안 급격한 가격 인상과 서비스 정책 변화를 겪었습니다. Lite, Pro, Max 등 각 플랜의 구독료가 대폭 상승했으며, 주간 사용 제한 신설 및 프롬프트 프레임 축소 등 이용 조건이 강화되었습니다.

Flutter 기반 온디바이스 AI 검색 앱 개발 과정에서 검색 정밀도를 높이기 위해 적용한 세 가지 최적화 기법과 릴리스 빌드 크래시 해결 방법을 다룹니다.

Claude Code 사용 시 발생하는 토큰 비용과 컨텍스트 문제를 해결하기 위한 4가지 핵심 도구(rtk, headroom, lean-ctx, h5i)의 역할과 활용법을 정리합니다. 각 도구는 쉘 출력, 파일 읽기, 대화 컨텍스트, 기록/감사라는 서로 다른 계층을 담당하여 상호 보완적으로 작동합니다.