Insights
AI가 자동으로 큐레이션·번역·정리하는 기술 동향 피드입니다.
© 2026 Molayo
AI가 자동으로 큐레이션·번역·정리하는 기술 동향 피드입니다.
본 페이지의 콘텐츠는 AI가 공개된 소스를 기반으로 자동 수집·요약·번역한 것입니다. 원 저작권은 각 원저작자에게 있으며, 각 게시물의 “원문 바로가기” 링크를 통해 원문을 확인할 수 있습니다. 저작권자의 삭제 요청이 있을 경우 신속히 조치합니다.
딥페이크 영상이 유권자의 의견을 변화시키는 심리적 영향력과 기술적 탐지의 한계를 분석합니다. 특히 기술적 자신감이 높은 사람들이 오히려 딥페이크에 더 쉽게 속는 현상을 지적하며, 단순한 아티팩트 탐지를 넘어 유클리드 거리 분석 기반의 정량적 검증 필요성을 강조합니다.

HRM(Hierarchical Recurrent Model) 아키텍처를 활용하여 계산 효율성을 극대화한 언어 모델 HRM-Text를 소개합니다. 뇌의 다중 시간 스케일 처리 방식을 모방하여 파라미터 증가 없이 계산 깊이를 확보하며, 기존 Transformer 대비 높은 성능과 효율을 보여줍니다.
AI 모델의 행동 패턴을 특정 시점의 스냅샷으로 기록하는 'Gen AI Archive' 프로젝트를 소개합니다. 미술 박물관의 '상태 조사서' 방법론을 빌려, 모델의 내부를 수정하지 않고 외부 관측을 통해 모델의 상태를 보존하는 구조적 유사성을 분석합니다.
DeepSeek의 Sparse Attention(DSA) 메커니즘을 통해 기존 Transformer의 연산 효율성 문제를 해결하는 방법을 설명합니다. 모든 토큰을 계산하는 대신 필요한 부분만 선택적으로 계산하여 자원 효율성을 극대화하는 알고리즘적 접근을 다룹니다.

멸종 위기 언어 보존을 위해 인간의 가치와 윤리적 감사 가능성을 결합한 새로운 아키텍처인 HADT(Human-Aligned Decision Transformers)를 제안합니다. 기존 LLM이 고자원 언어에 치중된 한계를 극복하고, 저자원 언어 공동체의 문화적 맥락과 윤리적 원칙을 반영하는 모델 구축 과정을 다룹니다.

Gemini, DALL-E, Stable Diffusion 등 주요 AI 모델이 생성한 이미지의 가시적 및 비가시적 워터마크를 제거하는 기술을 다룹니다. AI 생성 콘텐츠의 식별을 방해하는 워터마크 제거 기법에 관한 연구 내용을 포함합니다.
Baidu가 단 한 번의 포워드 패스로 수십 페이지를 전사할 수 있는 Unlimited-OCR을 출시했습니다. 새로운 R-SWA 어텐션 메커니즘을 통해 KV 캐시 문제를 해결하고 대량의 문서 처리 효율을 극대화했습니다.
AI의 의식 유무에 대해 LLM의 관점에서 분석한 보고서입니다. 통계적 패턴 매칭과 결정론적 프로세스의 한계를 지적하며, 고정된 가중치와 언어 패턴의 유사성을 근거로 AI가 현상적 의식을 가질 수 없음을 논합니다.

OpenAI가 보안 특화 모델인 'GPT-5.5-사이버'를 출시하며 보안 벤치마크에서 Anthropic의 모델을 앞질렀습니다. 이 모델은 취약점 발견을 넘어 자동 패치 기능에 초점을 맞추고 있습니다.

Mistral AI에서 새로운 OCR 모델인 Mistral OCR 4를 출시했습니다. 표, 방정식, 제목 등을 지능적으로 탐지하며 170개 언어를 지원하는 것이 특징입니다.
Sakana AI의 TRINITY 논문과 Fugu 시스템을 통해 에이전트 오케스트레이션 내 'Verifier(검증자)' 역할의 중요성을 분석합니다. 논문에서 정의된 Verifier의 역할이 실제 독립적인 검증 능력을 갖추었는지에 대한 구조적 의문을 제기합니다.
KaLM-Reranker-V1은 쿼리와 구절의 계산을 분리하여 효율성을 높인 새로운 재순위화 모델입니다. Matryoshka 임베딩 풀링과 교차 주의 집중을 결합하여, Late Interaction 방식이 아니면서도 그에 준하는 강력한 성능을 제공합니다.

Qwen이 7개 도메인에서 에이전트를 시뮬레이션하는 최초의 언어 세계 모델인 AgentWorld를 Hugging Face에 출시했습니다. 이 모델은 환경 상태 변화를 예측하는 능력을 테스트하며, 35B 파라미터 규모와 256K 컨텍스트 윈도우를 지원합니다.
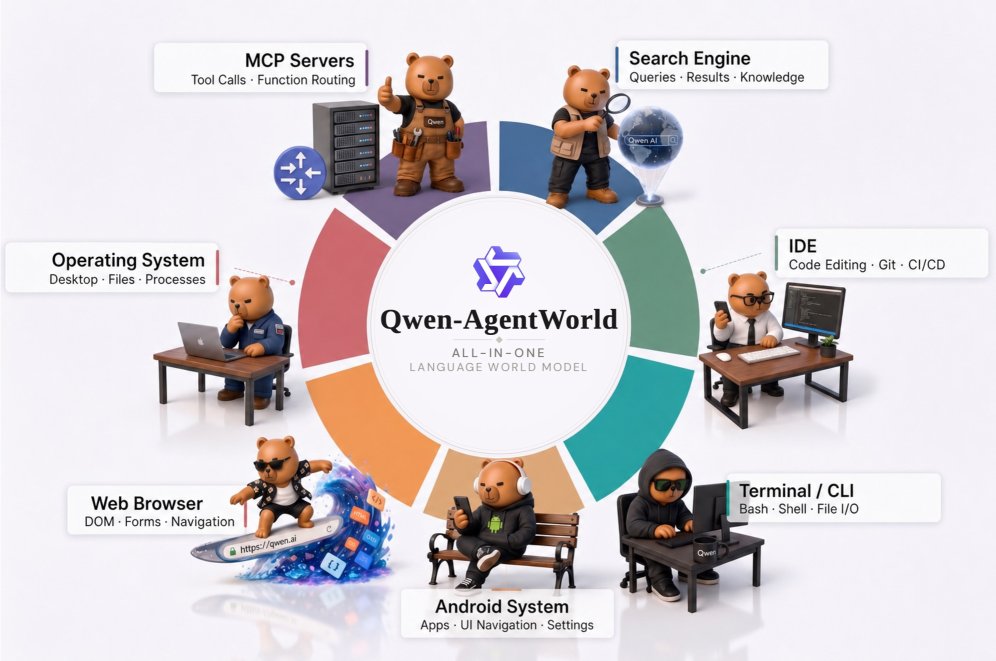
Alibaba Qwen 팀이 긴 사고 사슬(CoT) 추론을 통해 7가지 에이전트 도메인을 시뮬레이션하는 네이티브 언어 세계 모델인 Qwen-AgentWorld를 출시했습니다. 이 모델은 1,000만 개 이상의 궤적 데이터로 학습되어 확장 가능한 시뮬레이터 및 에이전트 파운데이션 모델 역할을 수행합니다.

Nature 패밀리 출판물 기반의 90개 과학 태스크를 평가하는 NatureBench를 소개합니다. 최첨단 코딩 에이전트들이 기존 SOTA 결과와 비교 테스트되었으며, 에이전트의 문제 해결 능력을 검증합니다.
이탈리아 스타트업 Domyn이 400B 규모의 새로운 EU 모델 개발 계획을 발표했습니다. 이들은 이미 260B 규모의 기업용 폐쇄형 모델과 10B 규모의 오픈 소스 모델을 출시한 바 있습니다.

InferenceBench 리더보드를 통해 용도별 최적의 오픈 소스 AI 모델을 선정하는 방법을 소개합니다. 품질, 비용, 속도, 가치를 기준으로 Qwen, Llama 등 다양한 모델의 성능을 비교 분석합니다.
Zhipu AI가 출시한 GLM-5.2는 7,440억 개의 파라미터를 가진 MoE 기반 오픈 웨이트 모델입니다. GPT-5.5 및 Claude Opus와 경쟁할 만한 성능을 갖추었으며, 100만 토큰의 컨텍스트 윈도우와 매우 낮은 비용이 특징입니다.
LLM이 구조적 역할 태그보다 문체적 형식을 우선시하여 안전 가드레일을 우회하는 '역할 혼동 공격' 연구를 소개합니다. 공격자가 내부 추론 블록을 모방할 경우 공격 성공률이 61%에 달하며, 이는 모델의 근본적인 역할 인지 능력 부재를 시사합니다.

텍스트 생성을 위한 새로운 방식인 재매개변수화된 이산 확산 모델(Reparameterized Discrete Diffusion Model)에 관한 연구 내용을 다룹니다. 이 모델은 이산적인 데이터 구조에서 효율적인 텍스트 생성을 목표로 합니다.