
테이블, 텍스트, 이미지에 대한 다중 벡터 검색기(Multi-Vector Retriever)를 활용한 RAG
요약
본 글은 이미지, 테이블, 텍스트 등 다양한 데이터 유형을 아우르는 RAG(검색 증강 생성)의 필요성을 다루며, 이를 해결하기 위한 '다중 벡터 검색기(Multi-Vector Retriever)'를 소개합니다. 이 기술은 답변 합성용 컨텍스트와 검색 참조를 분리하여 정보 손실 없이 정확한 질의응답을 가능하게 합니다.
핵심 포인트
- Multi-Vector Retriever는 텍스트, 테이블, 이미지 등 복합 데이터 처리에 유용합니다.
- RAG 개선 방법론 외에 모달리티 및 반정형 데이터를 아우르는 통합 전략이 필요합니다.
- 검색 참조와 답변 합성 컨텍스트를 분리하여 정보 손실을 방지하는 것이 핵심입니다.
요약
다양한 데이터 유형(이미지, 텍스트, 테이블) 전반에 걸친 원활한 질의응답은 RAG의 성배 중 하나입니다. 저희는 내용물이 혼합된 문서를 대상으로 하는 다중 벡터 검색기(multi-vector retriever)를 보여주는 세 가지 새로운 쿠크북을 출시합니다. 이 쿠크북들에는 또한 이미지에 대한 RAG 잠재력을 열기 위해 멀티모달 LLM과 다중 벡터 검색기를 결합하는 몇 가지 아이디어도 제시되어 있습니다.
- 반정형(테이블 + 텍스트) RAG용 쿠크북
- 멀티모달(텍스트 + 테이블 + 이미지) RAG용 쿠크북
- 비공개 다중 모드(텍스트 + 테이블 + 이미지) RAG용 쿠크북
배경 지식
LLM은 적어도 두 가지 방식으로 새로운 정보를 습득할 수 있습니다: (1) 가중치 업데이트(예: 파인튜닝)와 (2) RAG(검색 증강 생성)로, 이는 관련 컨텍스트를 프롬프트를 통해 LLM에 전달합니다. RAG는 LLM의 추론 능력과 외부 데이터 소스의 내용을 결합하기 때문에 사실적 회상에 특히 유망하며, 이는 엔터프라이즈 데이터에 특히 강력합니다.

RAG 개선 방법
RAG를 개선하기 위해 여러 가지 기법이 개발되었습니다:
아이디어
예시
출처
기본 사례 RAG (Base case RAG)
임베딩된 문서 청크에 대한 Top K 검색, LLM 컨텍스트 창을 위해 문서 청크 반환
LangChain vectorstores, 임베딩 모델
요약(Summary) 임베딩
임베딩된 문서 요약에 대한 Top K 검색, 하지만 LLM 컨텍스트 창을 위해 전체 문서 반환
윈도우링(Windowing)
임베딩된 청크 또는 문장에 대한 Top K 검색, 하지만 확장된 윈도우 또는 전체 문서 반환
메타데이터 필터링(Metadata filtering)
메타데이터로 필터링된 청크를 포함하는 Top K 검색
RAG 임베딩 파인튜닝(Fine-tune RAG embeddings)
사용자 데이터에 대해 임베딩 모델을 파인튜닝
2단계 RAG (2-stage RAG)
첫 번째 단계 키워드 검색 후 두 번째 단계 의미론적 Top K 검색
하지만 반정형 데이터(구조화된 테이블과 비정형 텍스트)와 여러 모달리티(이미지)를 포함하는 문서에 대한 RAG는 여전히 어려운 과제로 남아 있습니다. 여러 멀티모달 모델이 등장함에 따라, 이제 모달리티 및 반정형 데이터를 아우르는 RAG를 가능하게 하는 통합 전략을 고려할 가치가 있습니다.
Multi-Vector Retriever (다중 벡터 검색기)
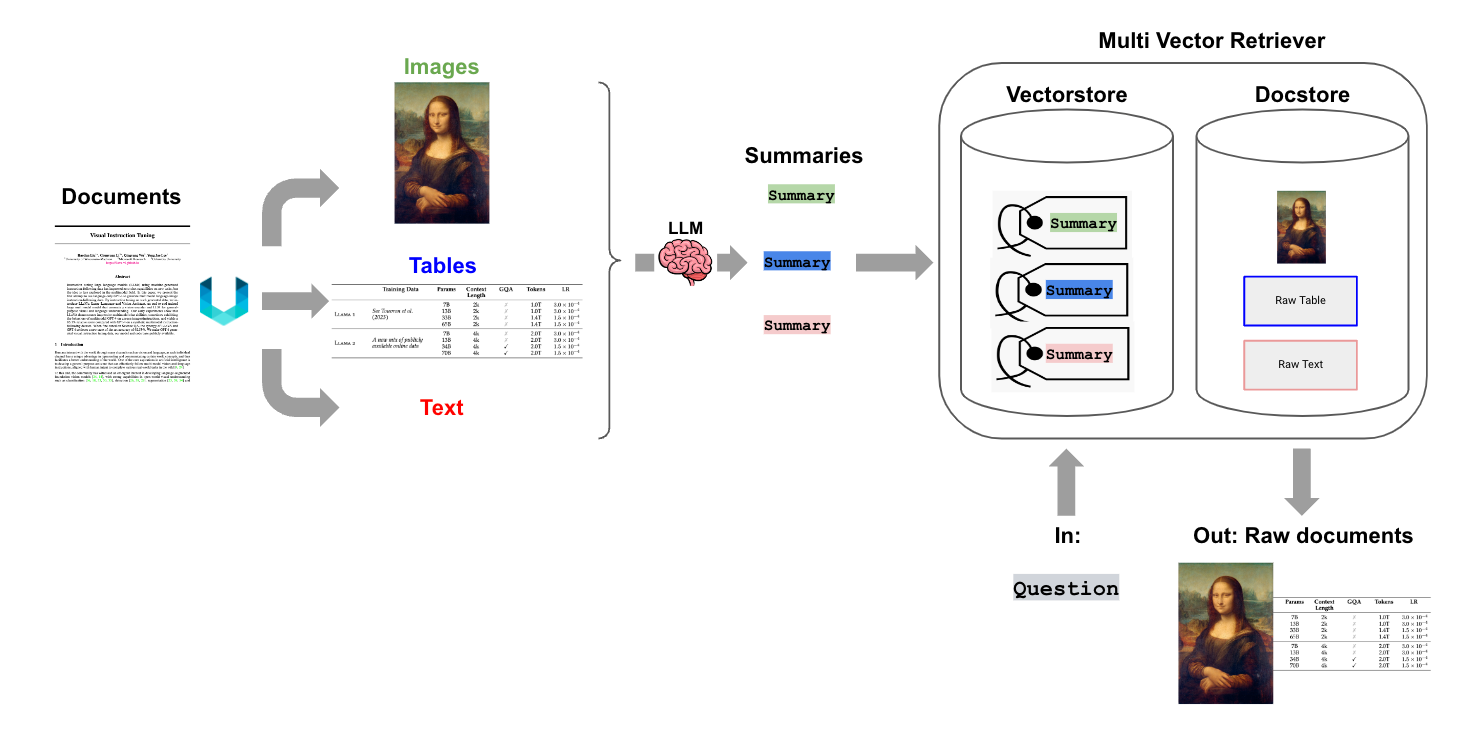
지난 8월에 저희는 multi-vector retriever를 출시했습니다. 이 검색기는 RAG를 위한 간단하면서도 강력한 아이디어를 사용합니다: 답변 합성(answer synthesis)에 사용하려는 문서와, 검색기(retriever)에 사용하려는 참조(reference)를 분리하는 것입니다. 간단한 예로, 우리는 벡터 기반 유사성 검색에 최적화된 방대한 문서의 요약본을 생성할 수 있지만, 답변 합성 과정에서 컨텍스트가 손실되는 것을 막기 위해 전체 문서를 LLM에 계속 전달합니다. 여기서 저희는 이 접근 방식이 순수 텍스트를 넘어 유용하며, 테이블이나 이미지 둘 중 어느 것에든 일반적으로 적용되어 RAG를 지원할 수 있음을 보여줍니다.
Document Loading (문서 로딩)
물론, 이 접근 방식을 가능하게 하려면 먼저 문서를 다양한 유형으로 분할하는 능력이 필요합니다. Unstructured는 이러한 작업에 매우 적합한 훌륭한 ELT 도구입니다. 왜냐하면 수많은 파일 형식에서 요소(테이블, 이미지, 텍스트)를 추출할 수 있기 때문입니다.
예를 들어, Unstructured는 PDF 파일을 먼저 포함된 모든 이미지 블록을 제거하여 분할합니다. 그런 다음 레이아웃 모델(YOLOX)을 사용하여 바운딩 박스(테이블용)와 문서의 후보 하위 섹션(titles, 예: 서론 등)을 얻습니다. 이후 각 title 아래에 속하는 텍스트를 집계하고, 사용자별 플래그(예: 최소 청크 크기 등)를 기반으로 다운스트림 처리를 위해 추가적인 텍스트 블록 청킹을 수행합니다.
Semi-Structured Data (반정형 데이터)
Unstructured 파일 파싱과 다중 벡터 검색기(multi-vector retriever)를 결합하면, 테이블을 포함할 수 있는 단순한 청킹 전략으로는 어려웠던 반정형 데이터에 대한 RAG를 지원할 수 있습니다. 저희는 테이블 요소의 요약본을 생성하는데, 이는 자연어 검색에 더 적합합니다. 만약 사용자 질문과 의미적 유사성을 통해 테이블 요약본이 검색된다면, 위에서 설명한 것처럼 답변 합성을 위해 *원본 테이블(raw table)*을 LLM에 전달합니다. 아래의 쿡북과 다이어그램을 참고하십시오:

다중 모드 데이터(Multi-Modal Data)
더 나아가 이미지도 고려할 수 있으며, 이는 GPT4-V와 같은 다중 모드 LLM이나 LLaVA, Fuyu-8b와 같은 오픈 소스 모델의 출시로 빠르게 가능해지고 있습니다. 위에서 논의한 다중 벡터 검색기 프레임워크를 활용하여 문제를 접근하는 방법이 최소 세 가지가 있습니다:
옵션 1:
다중 모드 임베딩(CLIP과 같은)을 사용하여 이미지와 텍스트를 함께 임베딩합니다. 유사성 검색을 통해 검색할 수 있지만, 문서 저장소(docstore)에 이미지를 단순히 링크하는 방식으로 처리합니다. 원본 이미지와 텍스트 청크를 다중 모드 LLM에 전달하여 합성을 수행합니다.
옵션 2:
다중 모드 LLM(GPT4-V, LLaVA 또는 FUYU-8b와 같은)을 사용하여 이미지에서 텍스트 요약본을 생성합니다. 텍스트 임베딩 모델을 사용하여 텍스트 요약본을 임베딩하고 검색합니다. 그리고 다시 한번, 답변 합성을 위해 문서 저장소에서 원본 텍스트 청크나 테이블을 참조하며; 이 경우, 다중 모드 LLM으로 합성이 불가능할 수 있으므로 이미지(예: docstore에서 제외)는 포함하지 않습니다.
옵션 3:
다중 모드 LLM(GPT4-V, LLaVA 또는 FUYU-8b와 같은)을 사용하여 이미지에서 텍스트 요약본을 생성합니다. 그리고 옵션 1에서 했던 것처럼 원본 이미지를 참조하여 이미지 요약본을 임베딩하고 검색합니다. 다시 한번, 답변 합성을 위해 원본 이미지와 텍스트 청크를 다중 모드 LLM에 전달합니다. 이 옵션은 다중 모드 임베딩을 사용하고 싶지 않을 때 적합합니다.

저희는 옵션 2를 테스트했습니다.
7b 파라미터 LLaVA 모델(가중치는 여기에서 사용 가능)을 사용하여 이미지 요약문을 생성했습니다. LLaVA가 최근 llama.cpp에 추가되면서 일반 소비자용 노트북(Mac M2 max, 32gb 기준 초당 45 토큰)에서도 실행할 수 있게 되었고, 합리적인 수준의 이미지 요약문을 생성합니다. 예를 들어, 아래 이미지를 통해 유머를 포착했습니다: 이 이미지는 다양한 조각의 프라이드치킨으로 가득 찬 쟁반을 클로즈업한 모습입니다. 치킨 조각들은 세계 지도를 닮은 방식으로 배열되어 있으며, 일부는 대륙 모양으로, 다른 일부는 국가 모양으로 배치되었습니다. 이 치킨 조각들의 배치는 시각적으로 매력적이고 재미있는 세상의 표현을 만들어냅니다.

저희는 이러한 요약문들을 테이블 및 텍스트 요약문과 함께 다중 벡터 검색기(multi-vector retriever)에 저장합니다.
데이터 프라이버시가 우려되는 경우, 이 RAG 파이프라인은 LLaVA 7b를 이용한 이미지 요약, Chroma 벡터스토어, 오픈 소스 임베딩(Nomic의 GPT4All), 다중 벡터 검색기, 그리고 답변 생성을 위한 Ollama.ai를 통한 LLaMA2-13b-chat 등 오픈 소스 구성요소들을 사용하여 일반 소비자용 노트북에서 로컬로 실행할 수 있습니다.
결론
다중 벡터 검색기는 반정형(semi-structured) RAG뿐만 아니라 다중 모드 데이터가 포함된 반정형 RAG를 지원하는 데 사용될 수 있음을 보여줍니다. 또한, 이 전체 파이프라인을 오픈 소스 구성요소를 사용하여 일반 소비자용 노트북에서 로컬로 실행할 수 있다는 점을 보여줍니다. 마지막으로, 저희는 미래의 교과서에 기능을 추가하기 위해 다중 벡터 검색기 개념을 활용하는 세 가지 일반적인 멀티모달 RAG 접근 방식을 제시합니다.
AI 자동 생성 콘텐츠
본 콘텐츠는 LangChain Blog의 원문을 AI가 자동으로 요약·번역·분석한 것입니다. 원 저작권은 원저작자에게 있으며, 정확한 내용은 반드시 원문을 확인해 주세요.
원문 바로가기