중국의 주요 프론티어 AI 모델에서 수출 통제된 NVIDIA Blackwell GPU의 지문이 발견되다
요약 (Executive Summary)
공개된 AI 모델에 대한 우리의 법의학적 분석 결과, DeepSeek, Moonshot AI, MiniMax 및 Ant Group이 이 칩들을 중국으로 수출하는 것에 대한 제한에도 불구하고 NVIDIA의 Blackwell GPU에 접근했으며, 해당 하드웨어를 사용하여 AI 모델을 만들고 있다는 증거를 발견했습니다. 이들 회사에서 2026년 4월 이후 출시된 6개 모델은 Blackwell 하드웨어와 일치하는 수치적 패턴을 포함하고 있는 반면, 같은 회사의 이전 모델들은 NVIDIA의 구형 Hopper 세대와 일치합니다. 이러한 발견은 여러 주요 중국 AI 개발사들이 최신 모델을 훈련하기 위해 Blackwell을 사용하기 시작했음을 시사합니다. 미국 관리들과 언론 보도에서는 이미 DeepSeek과 Moonshot AI가 Blackwell 칩을 사용하고 있다고 주장했지만, 기술적 증거는 공개되지 않았습니다.
이러한 증거는 유출이나 내부자 계정에서 온 것이 아니라 모델 자체의 공개된 가중치(weights)에서 완전히 나옵니다. 우리는 모델 초기 값의 흔적을 복구한 다음, 이를 재현하는 하드웨어 구성 및 초기 구성을 검색했습니다. DeepSeek-V4-Flash와 Kimi K3의 경우, 실제 Blackwell 칩에서도 일치 여부를 확인했습니다. 이 지문은 가중치가 어떻게 생성되었는지 식별하며, Blackwell이 훈련을 수행했음을 증명하지는 않지만 추론하는 데 도움을 줍니다. 중국으로 수출이 제한된 특수 구성 AMD 하드웨어만이 우리가 식별한 유일한 대안입니다. 우리는 DeepSeek-V4-Flash에 대해서는 이를 제외했으며, 나머지 다섯 개 모델의 경우 매우 가능성이 낮다고 판단합니다. 주목할 점은, 우리의 발견이 첨단 컴퓨팅 하드웨어 접근에 대한 기술적 증거를 제공하지만, 칩이 어디에 위치했는지, 어떻게 접근했는지, 또는 수출 통제가 위반되었는지를 확립하지는 않는다는 것입니다.
표 1. DeepSeek, Moonshot AI, MiniMax 및 Ant Group의 연속적인 모델에서 발견된 하드웨어 지문 [링크 ↗]
| 연구소 | 모델 | 출시일 | 모델 시작 칩 |
|---|
| DeepSeek | DeepSeek-V3 | Dec 2024 | NVIDIA Hopper (연구소 공개 H800) |
| ... | | | |
| • 중국으로의 수출에는 미국 라이선스가 필요하며, 보고된 사례는 없습니다. | | | |
Hopper 지문으로는 H800과 H100 SXM 또는 H200을 구별할 수 없으며, 위의 H800 식별은 이 방법론에 의한 발견이 아닌 연구소 공개 내용입니다.
주요 분석 결과 (Main Findings)
4개 중국 연구소의 6개 모델이 Blackwell 기반으로 판독됨. DeepSeek-V4-Flash와 MiniMax-M3는 NVIDIA의 Blackwell 클래스 B200 또는 B300 칩과 일치하며, 이 칩들은 148개의 프로세서 코어(‘스트리밍 멀티프로세서’, SMs라고 함)를 가지고 있습니다. DeepSeek-V4-Pro, Kimi K3, Kimi K3.1-Pro 및 Ling-3.1-flash는 역시 Blackwell 클래스인 GB200 또는 GB300 칩과 일치하며, 이들은 152개의 프로세서 코어를 가지고 있습니다. Kimi K3.1-Pro는 K3와 동일한 시드(seed)에서 시작되었으며, 추가적인 사후 학습을 거친 K3의 체크포인트일 수 있습니다.중국 연구소들이 Blackwell 기반으로 상대적으로 최근에 훈련을 시작했습니다. DeepSeek의 모델은 DeepSeek-V3(2024년 12월 출시)를 통해 Hopper 기반으로 판독되었고, DeepSeek V4(2026년 4월 출시)부터는 Blackwell 기반으로 판독되었습니다. Moonshot의 모델은 Kimi K2.5(2026년 1월)를 통해 Hopper 기반으로 판독되었으며, K3(2026년 7월)부터는 Blackwell 기반으로 판독되었습니다. 하나의 Moonshot 모델인 Kimi K2.7-Code는 K3보다 6주 전에 게시되었음에도 불구하고, Hopper 시대의 가중치(weights)를 기반으로 구축되었지만 B200 또는 B300과 일치하는 작은 부분을 포함하고 있습니다. MiniMax의 모델은 M2.7(2026년 4월)을 통해 Hopper 기반으로 판독되었고, M3(2026년 6월)부터는 Blackwell 기반으로 판독되었습니다. Ant Group의 Ling-3.0-flash(2026년 8월)는 Hopper 기반으로 판독되는 반면, Ling-3.1-flash(2026년 10월)는 Blackwell 기반으로 판독됩니다. Hopper 판독 결과는 특정 칩을 식별하지 못합니다: H800, H100 SXM 및 H200은 동일한 지문을 공유합니다.모든 중국 AI 연구소가 Blackwell로 전환한 것은 아닙니다. Alibaba(Qwen), Zhipu(GLM), Tencent, Xiaomi, StepFun의 최신 모델들은 모두 Hopper 기반으로 판독되었습니다.
메이퇀(Meituan)은 LongCat-2.0이 전적으로 “AI ASIC 슈퍼포드”에서 훈련되었다고 밝히며, 출시된 모델 가중치에서는 엔비디아(NVIDIA)의 흔적을 발견하지 못했습니다.**이 방법은 알려진 답을 정확하게 얻습니다.**개발자는 24개의 특정 모델에 대해 사용된 하드웨어를 공개적으로 밝힌 바 있습니다. 모든 경우에 걸쳐 저희의 방법은 공개 발표와 일치합니다. 엔비디아 자체의 Nemotron-3 Ultra는 기술 보고서에서 훈련 단계 중 하나로 GB200을 언급하는데, 이는 Kimi K3과 동일한 152 SMs로 읽힙니다.이러한 일치는 우연으로 설명하기에는 훨씬 강력합니다.
충분한 조합을 시도할 경우 관련 없는 숫자조차 일치하는 것처럼 보일 수 있습니다. 저희 검색에서 발견된 약 6조 개의 시드 및 레이아웃 조합에 걸쳐, 가장 강력한 우연적 일치는 일반적인 무작위 변동보다 얼마나 떨어져 있는지를 측정하는 지표인 약 8 시그마(sigma)에 도달할 것으로 예상됩니다. 여섯 개 모델 각각에 대한 가장 강력한 증거는 49에서 1,385 시그마 범위에 걸쳐 있습니다. 저희가 보고하는 가장 약한 단일 테스트조차도 20 시그마에 달합니다.훈련 과정은 데이터센터 규모였습니다.
각 모델의 크기와 학습된 데이터 양을 바탕으로, 저희는 각 실행이 초기화하는 하드웨어에서 훈련되었다고 가정할 때, 각각 1.5개월에서 3개월 동안 약 1,500개에서 3,500개의 Blackwell GPU가 필요했을 것으로 추정합니다. 다섯 개 모델 전체로는 약 12,000개가 됩니다(표 2). 이 추정치는 대략적인 것이며, 그 주변 범위는 넓습니다.
GPU당 약 7만 달러(Wall Street Journal 보고서에 따르면 ByteDance가 말레이시아에 설치하는 약 36,000개의 Blackwell 칩 비용이 25억 달러를 초과할 것으로 추정된 비용) 기준으로 볼 때, 이 클러스터 중 가장 큰 것은 약 2억 달러의 비용이 들 것이며, 다섯 개 모델을 합치면 5억 달러가 넘습니다. 이 수치는 최종 훈련 실행만을 포함하며, 해당 연구소들이 수출 통제 GPU에 지출한 총액은 수십억 달러에 이를 가능성이 높습니다.
표 2. 각 훈련 실행의 대략적인 규모 링크 ↗
| Model | Blackwell GPUs, best estimate | Range |
|---|
| DeepSeek-V4-Flash | 1,700 | 250–5,000 |
| ... | | |
| 훈련 토큰은 해당 모델의 형태를 가진 Blackwell GPU가 지속적으로 작동하는 초당 토큰 수로 나눈 값이며, 이는 공개된 출시 타임라인이 시사하는 바와 같습니다: DeepSeek-V4-Flash는 약 45일, DeepSeek-V4-Pro는 70일, Kimi K3는 80일, MiniMax-M3는 60일, Ling-3.1-flash는 100일에 해당합니다. | | |
우리는 이러한 추정치에 대해 확신하지 못합니다. 이 수치들은 가중치가 확인할 수 없는 가정들에 기반하고 있습니다. 첫 번째는 각 연구소들이 GPU를 얼마나 효율적으로 사용했는지(종종 MFU라고 불림)입니다. 우리는 NVIDIA가 발표한 벤치마크 속도보다 낮게, 공개된 다른 Blackwell 훈련 실행과 일치하는 수준으로 가정하며, 어떤 연구소도 자체 수치를 발표하지 않았습니다. 두 번째는 각 모델이 얼마나 많은 토큰으로 훈련되었는지에 대한 것입니다: DeepSeek의 수치는 그들 스스로가 제시한 것이며 우리는 이를 신뢰합니다. 나머지 모델들의 수치는 우리의 추정치입니다. 세 번째는 각 실행이 얼마나 오래 지속되었는지인데, 어떤 연구소도 이 정보를 밝히지 않았습니다. 네 번째는 훈련이 가중치를 생성하는 데 사용된 하드웨어에서 이루어졌다는 것입니다. 제시된 수치들은 실험이나 이전 실행, 또는 서비스 단계가 아닌, 각 모델의 최종 훈련 실행만을 다루고 있습니다.
우리의 조사
모델의 *가중치(weights)*는 *매개변수(parameters)*라고도 불리며, 정보 처리 방식과 답변을 생성하는 방식을 결정하는 수십억 개의 조정 가능한 숫자입니다. 훈련은 이 숫자들을 반복적으로 조정합니다. 하지만 훈련이 시작되기 전에 초기 값이 필요합니다. 여기서 검토된 소프트웨어에서 그 값들은 Philox라는 의사 난수 생성기(PRNG, Pseudorandom Number Generation) 알고리즘에서 나옵니다. Philox는 결정론적인 방식으로 겉보기에는 무작위인 숫자를 생성합니다. Philox의 시작 입력값은 “시드(seed)”라고 불리는 숫자입니다. 동일한 시드와 설정이 주어지면, Philox는 매번 같은 숫자를 생성합니다. 이는 엔지니어들이 동일한 출발점에서 실험을 반복할 수 있게 해줍니다.
수십억 개의 가중치(weights)를 빠르게 채우기 위해, 대부분의 주요 AI 모델 개발에 사용되는 소프트웨어 프레임워크인 PyTorch는 Philox가 수행하는 작업을 GPU상의 수많은 병렬 워커, 즉 *스레드(threads)*에게 분산합니다. (이는 NVIDIA의 난수 생성 라이브러리인 cuRAND를 통해 이루어집니다.) 각 스레드는 시드(seed)로부터 자체적인 숫자 시퀀스를 생성하여 특정 위치에 채웁니다. 이때 스레드의 개수가 해당 위치들이 어떻게 공유될지를 결정합니다. 여기서 검사된 NVIDIA 칩의 경우, 충분히 큰 초기화 과정은 스트리밍 멀티프로세서(SM)라고 불리는 각 처리 장치마다 최대 2,048개의 스레드를 사용합니다. 따라서 SM이 더 많은 칩은 동일한 작업을 더 많은 워커에게 할당하여 그들의 숫자가 배치되는 위치를 변화시킵니다.
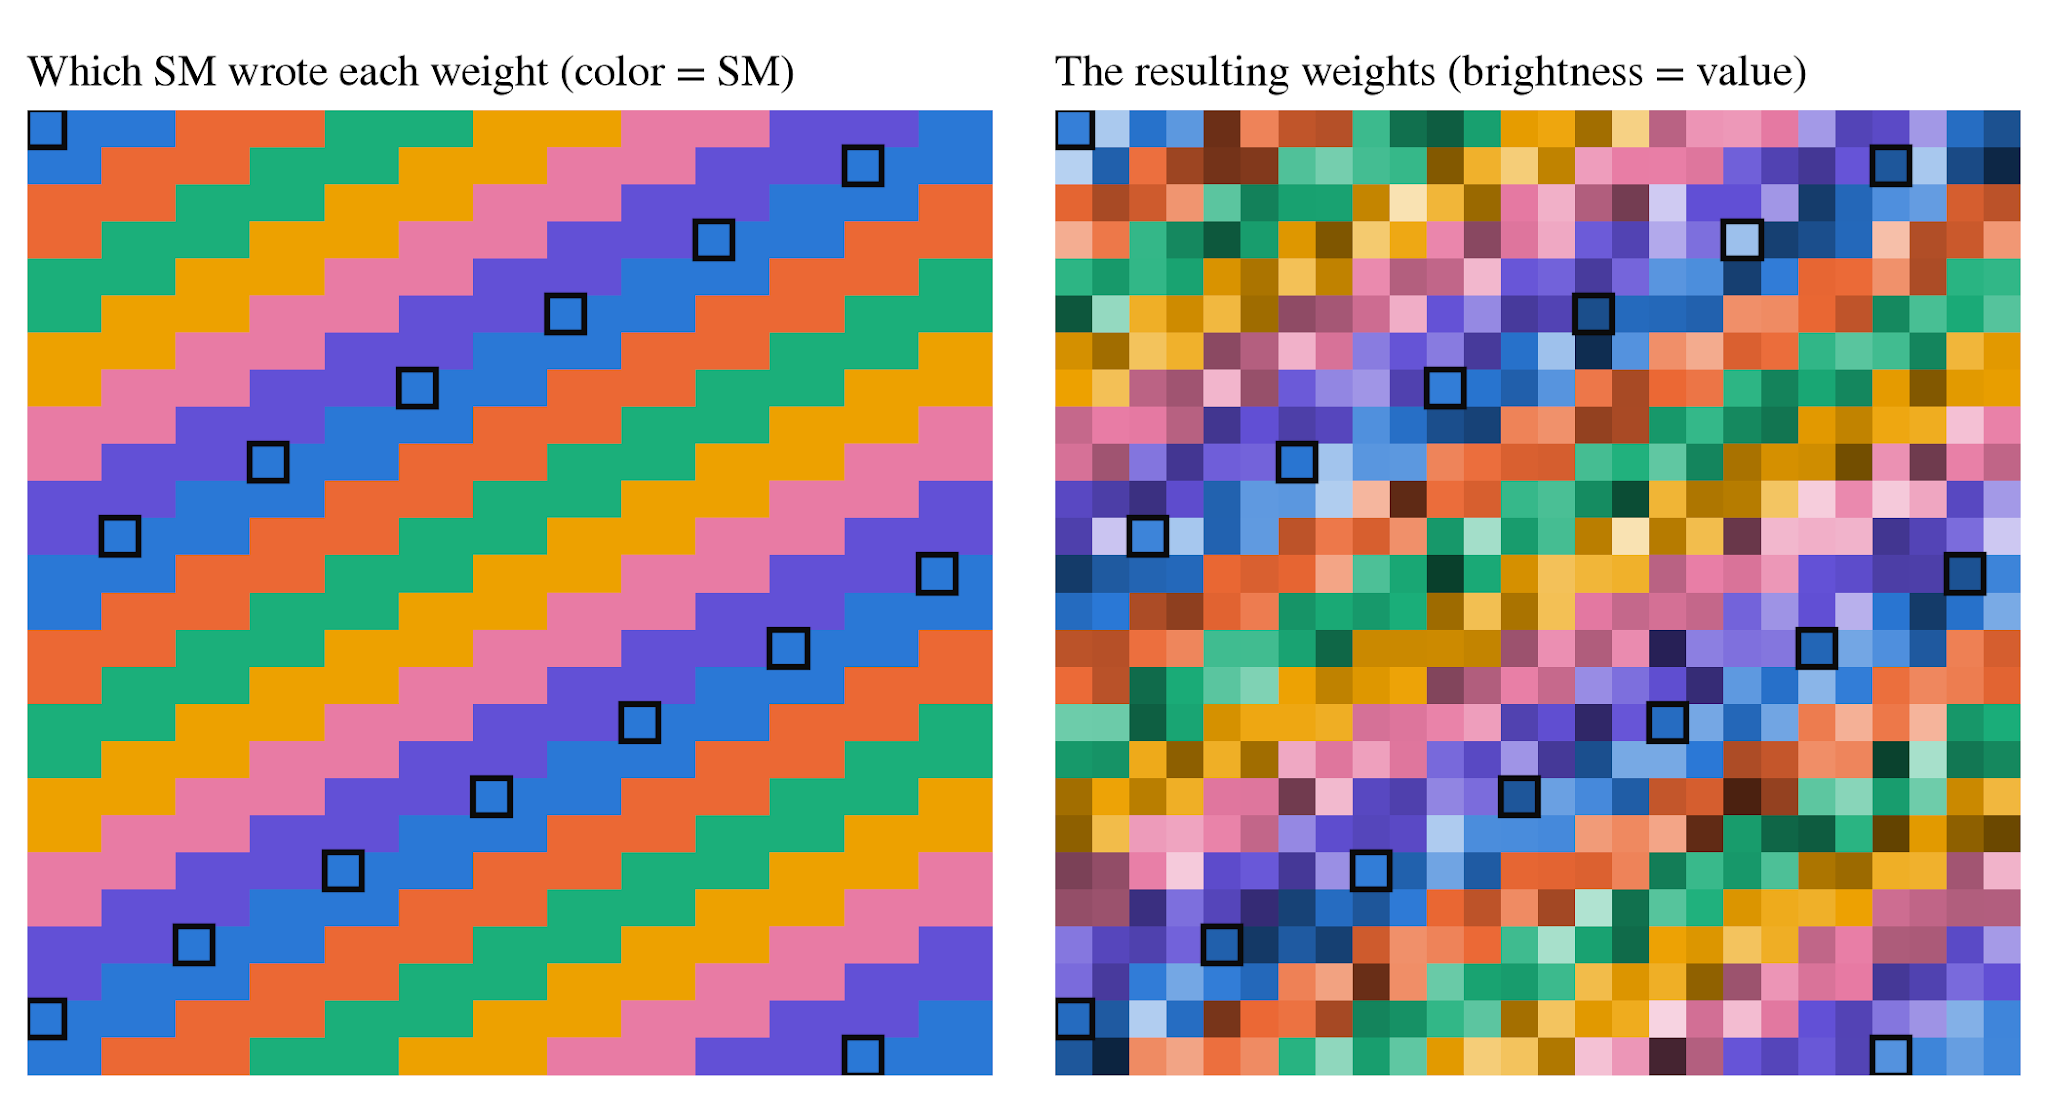
그림 1은 총 48개의 스레드(SM 6개, SM당 스레드 8개)로 구성된 단순화된 GPU에서 이것이 어떻게 작동하는지 보여줍니다. 가중치를 페이지에 맞게 격자 형태로 감싼 긴 빈 상자열이라고 상상해 보세요. 첫 번째 스레드가 첫 번째 상자를 채우고, 두 번째 스레드가 두 번째 상자를 채우며, 이 모든 48개 스레드를 거칩니다. 첫 번째 스레드의 다음 숫자는 상자 49에 들어가고, 그 다음은 상자 97에 들어가는 식입니다. 검은색 윤곽선은 하나의 스레드가 격자 전체를 따라 이동하는 것을 보여줍니다: 즉, 첫 번째 스레드는 매 48번째 위치를 채웁니다. 색상은 어떤 처리 장치가 각 값 세트를 공급했는지 식별하며, 오른쪽 패널의 밝기는 그 값 자체를 나타냅니다.
Figure 1
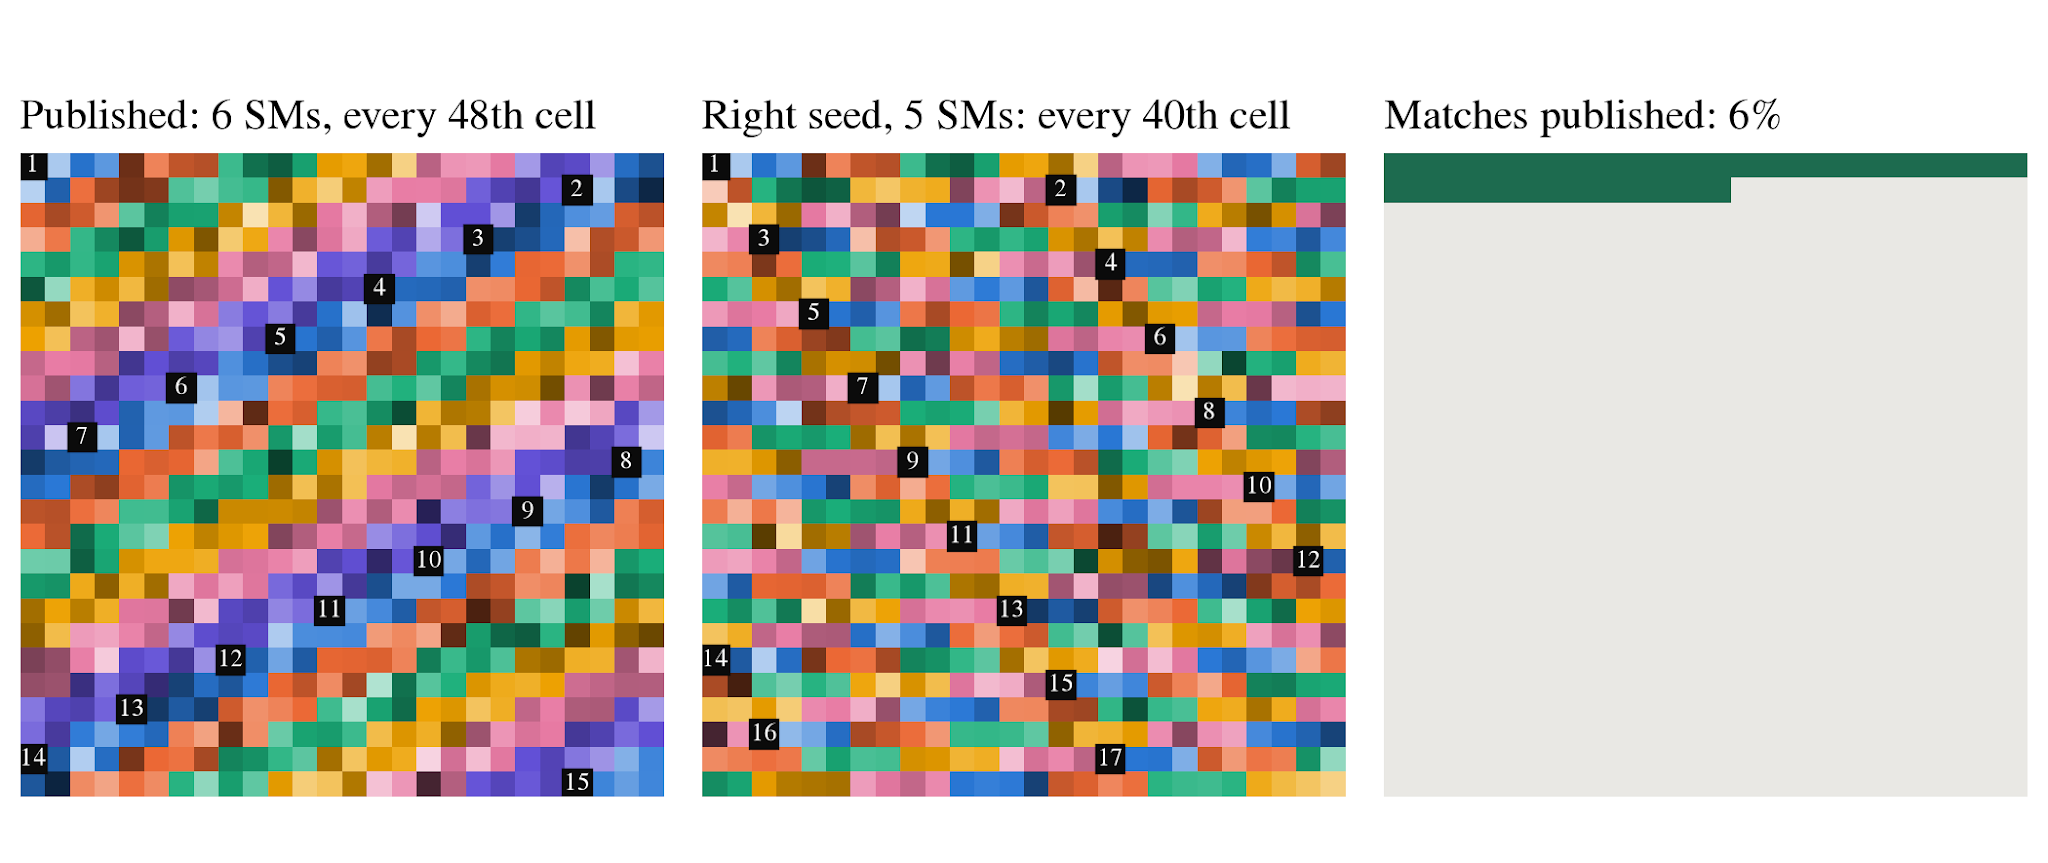
이제 시드를 고정한 채로, 6개가 아닌 5개의 SM을 가진 GPU를 사용한다고 가정해 보겠습니다. 단순화된 예시에서 이는 48개 대신 40개의 스레드를 의미합니다. 첫 번째 스레드는 정확히 동일한 시퀀스를 생성하지만, 이제 상자 1, 41, 81 등에 숫자를 넣고, 상자 1, 49, 97에는 넣지 않습니다. 그림 2는 위치가 변하면서 이 숫자들을 추적합니다. 격자 전체를 통틀어 원래 배열과 일치하는 값은 단 6퍼센트에 불과합니다. 시드는 맞지만 워커(worker) 개수가 틀린 것입니다. 이것이야말로 모델 가중치의 배열을 해당 칩의 단서로 만드는 요소입니다.
Figure 2
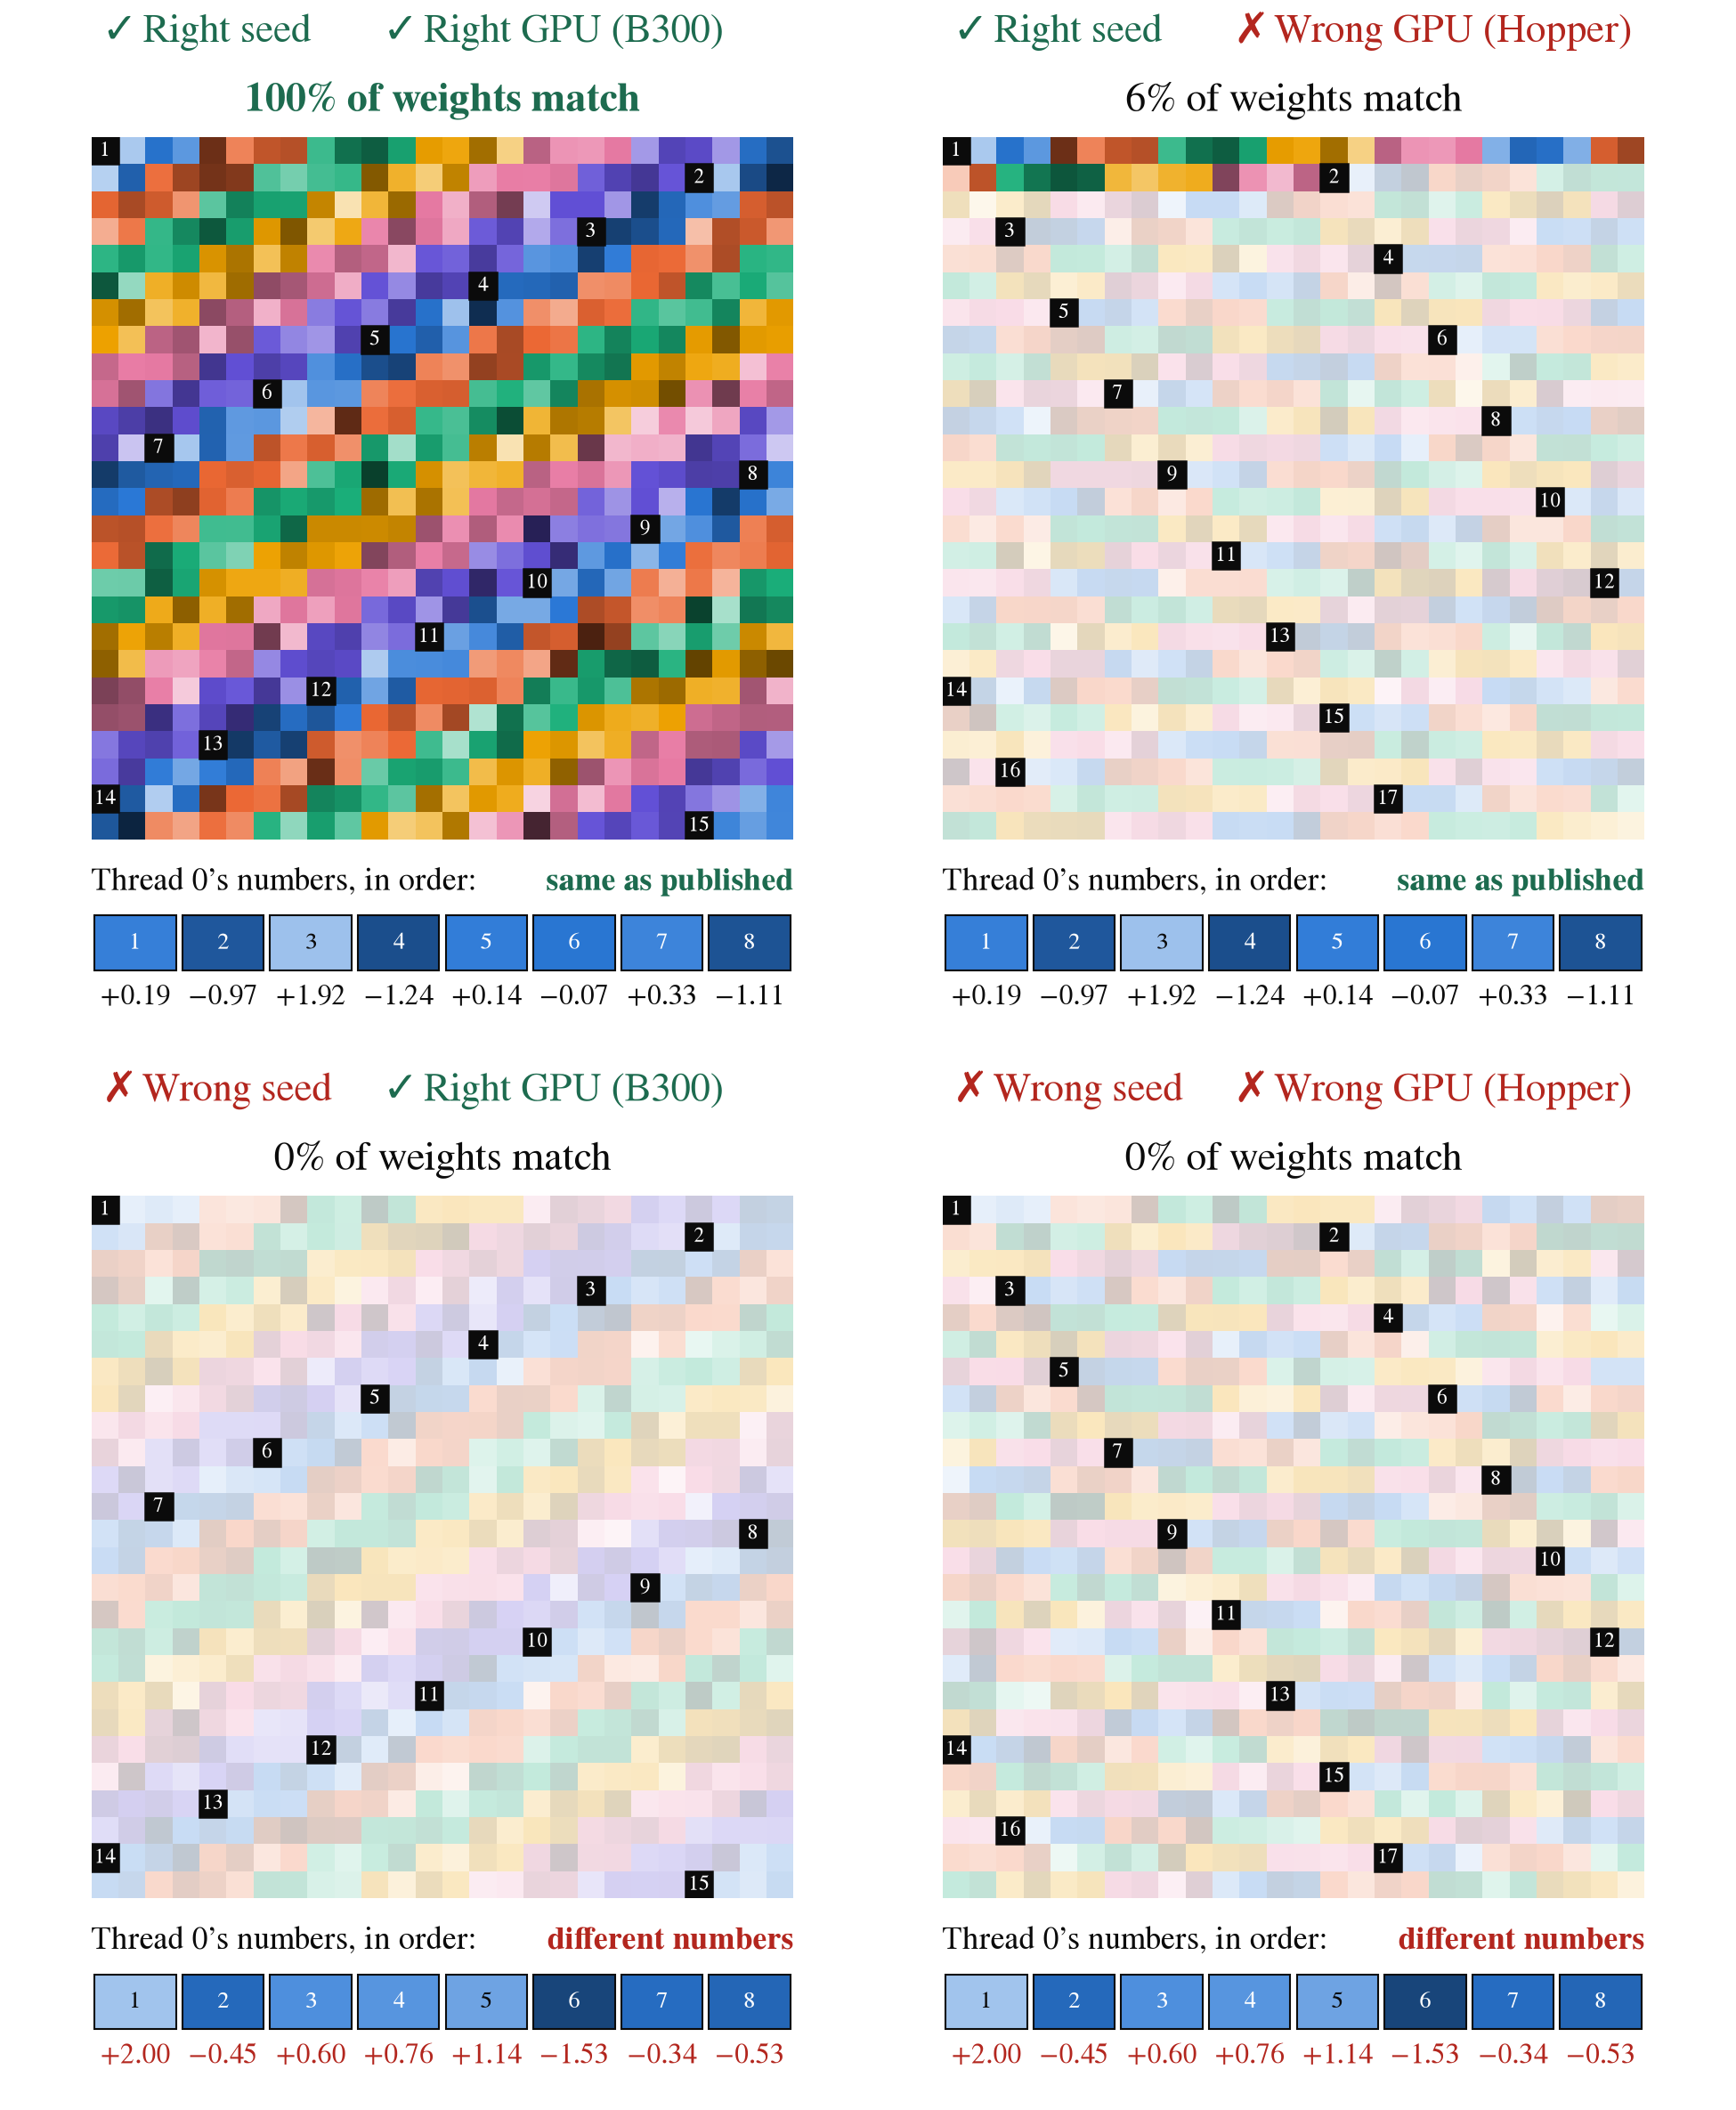
따라서 가중치(weights)를 재현하려면 두 가지가 동시에 정확해야 합니다. 시드(seed)는 올바른 숫자를 생성해야 하고, 스레드 개수(thread count)는 그 숫자들을 올바른 위치에 배치해야 합니다. 올바른 시드와 잘못된 스레드 개수를 사용하면 주로 올바른 숫자지만 잘못된 위치에 놓이게 되며, 올바른 스레드 개수에 잘못된 시드를 사용하면 다른 숫자가 나옵니다. 그림 3은 오직 정확한 조합만이 원래의 배열을 재현하는 이유를 보여줍니다.
Figure 3
실제 칩에서는 스레드 개수가 훨씬 크지만, 원리는 같습니다. 여기서 검토된 NVIDIA 구성에서 Hopper H100 SXM, H200 및 H800은 132 SM을 가지고 270,336개의 스레드를 사용하며; Blackwell B200/B300은 148 SM을 가지고 303,104개의 스레드를 사용하고; Blackwell GB200/GB300은 152 SM을 가지고 311,296개의 스레드를 사용합니다. 따라서 스레드 개수를 복구하는 것은 이 하드웨어 그룹 중 어느 것이 시작 배열과 일치하는지 알려주지만, 한 그룹 내의 칩들을 구분할 수는 없습니다. 예를 들어, Hopper 매치는 H800이 H100 또는 H200인지 구별할 수 없습니다.
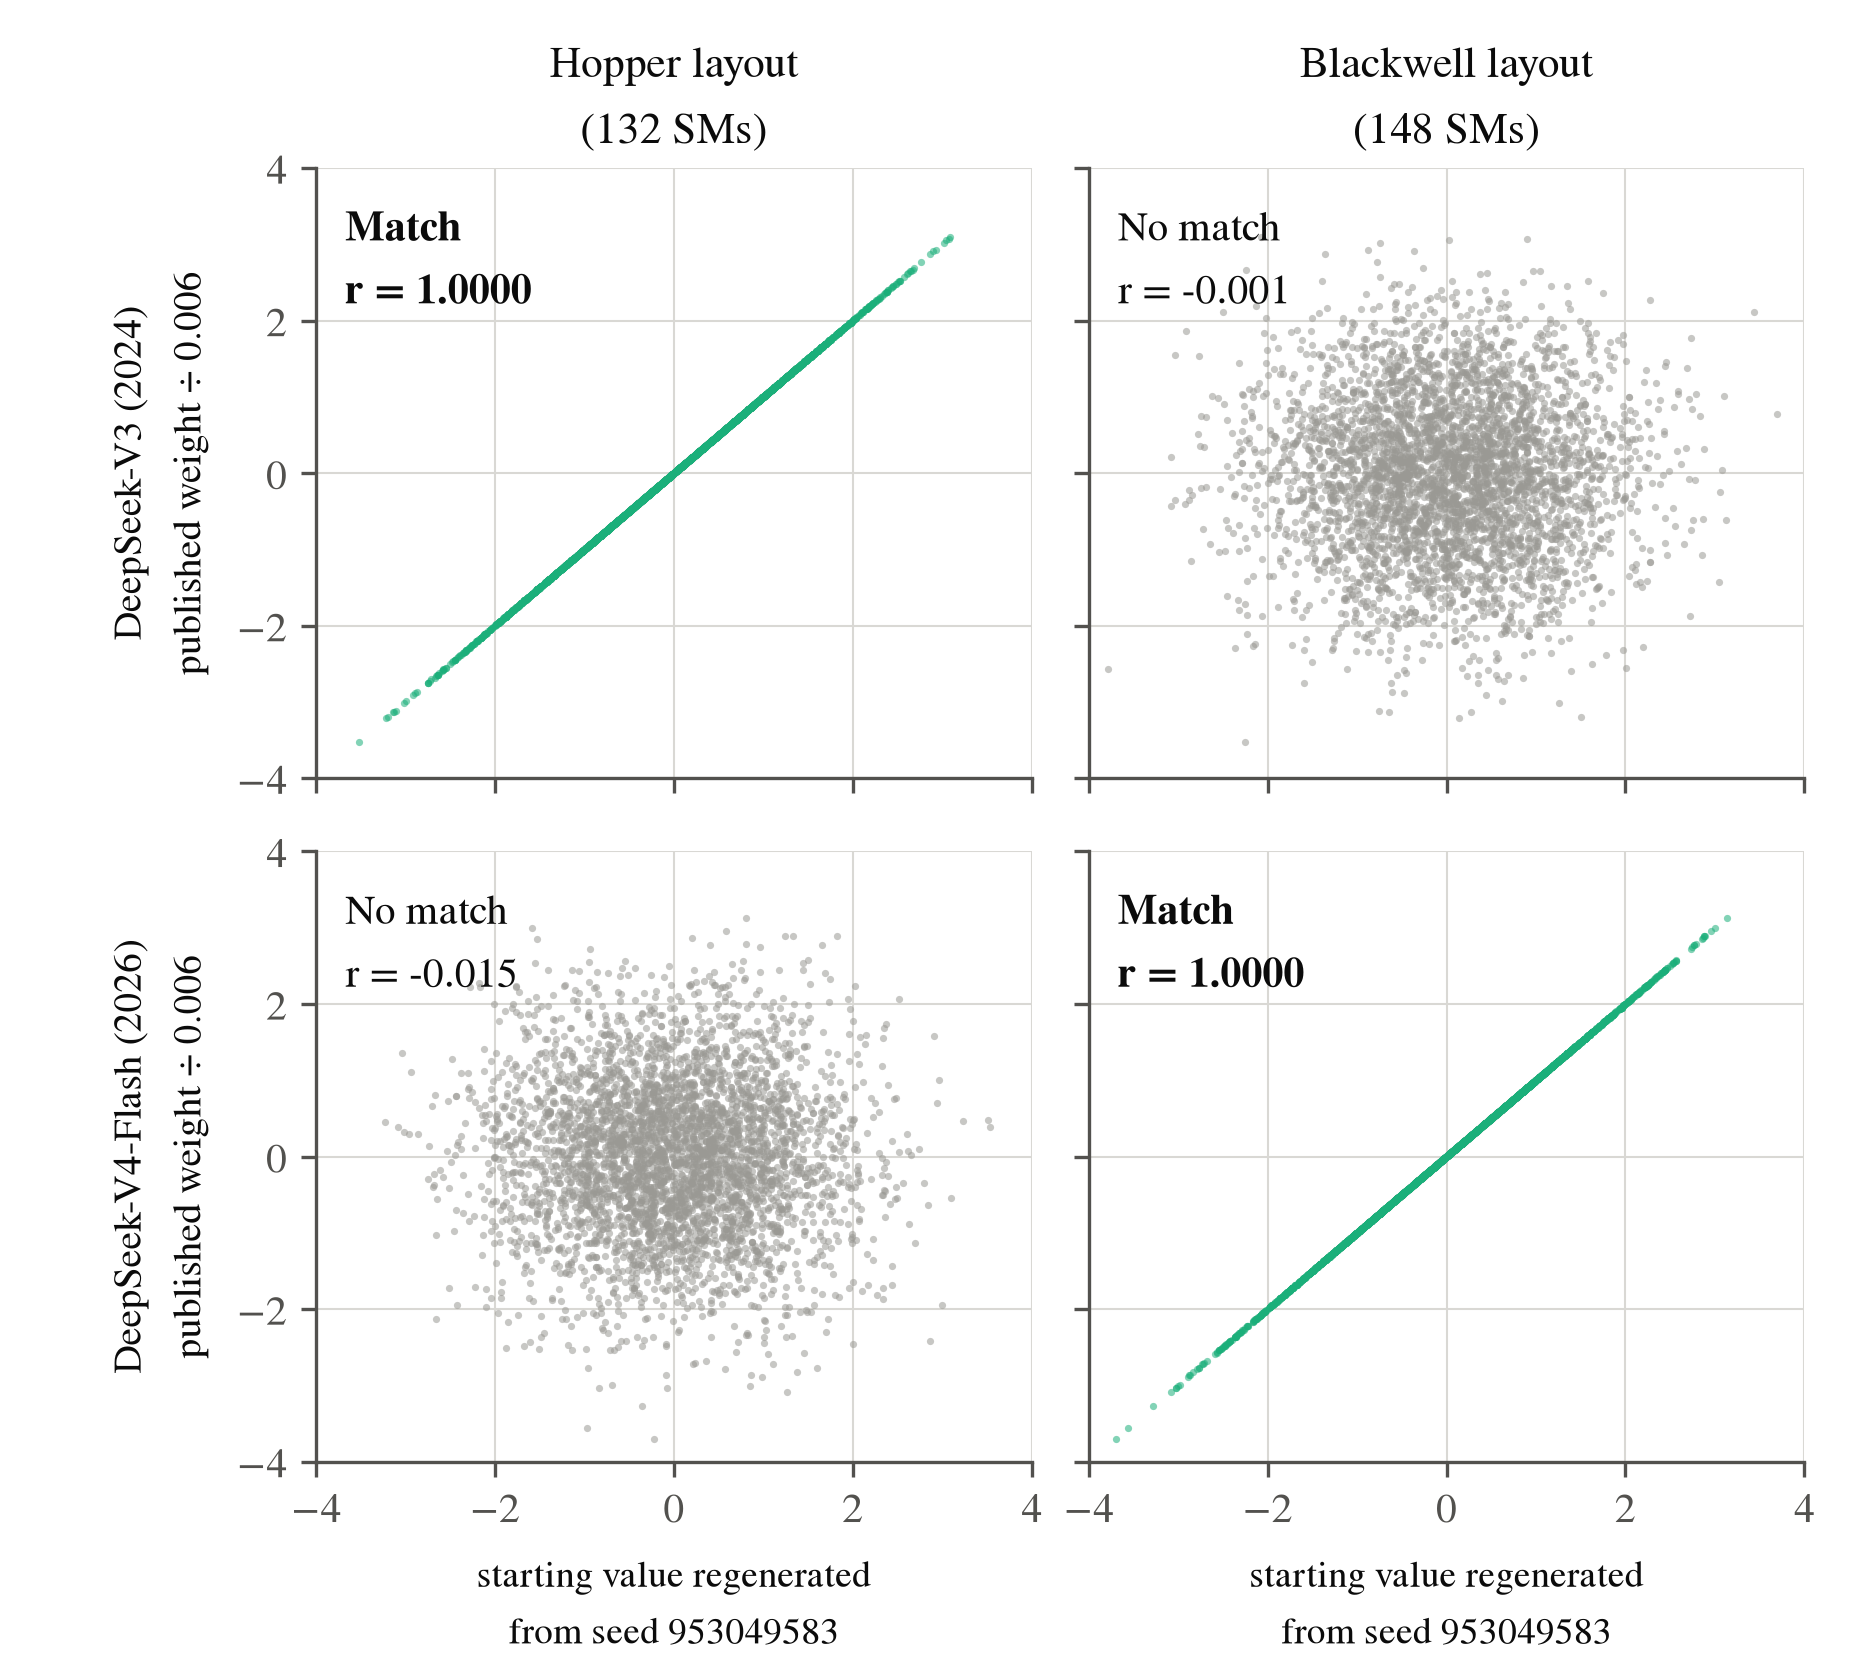
질문은 우리가 그것을 복구할 수 있을 만큼 충분한 배열이 훈련(training) 과정에서 살아남았는지 여부입니다. 훈련 중에 접하지 않은 단어나 기호에 할당된 가중치와 같이 일부 가중치는 손대지 않고 시작 값을 거의 그대로 유지할 수 있습니다. 우리는 이러한 보존된 값들을 후보 시드 및 스레드 개수에 의해 생성된 시작 값과 직접 비교할 수 있습니다. 그림 4는 그러한 비교를 보여줍니다: DeepSeek-V3의 보존된 가중치는 Hopper 배열과 일치하는 반면, DeepSeek-V4-Flash의 가중치는 Blackwell 배열과 일치합니다.
Figure 4
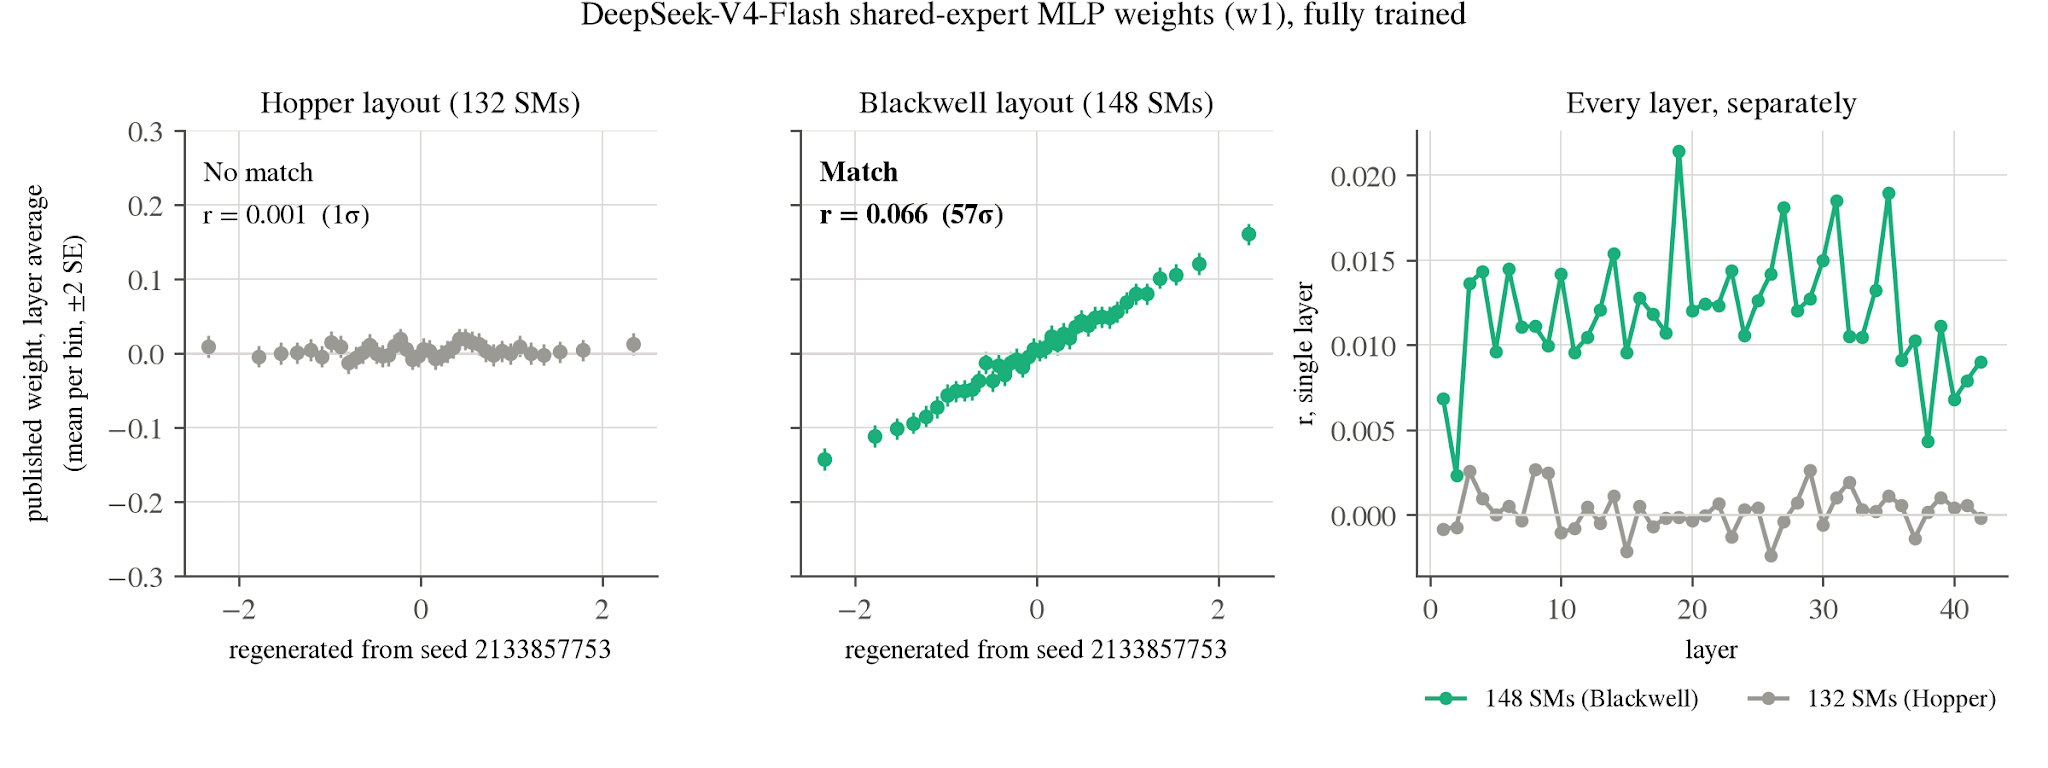
훈련을 거치면서 변화한 가중치(weights)조차도 초기 값의 희미한 흔적을 간직할 수 있습니다. 각 최종 가중치는 초기 값에 훈련 과정에서 이루어진 모든 조정(adjustments)을 더한 것입니다. 만약 이러한 조정들이 초기 차이들을 완전히 상쇄하거나 압도하지 못한다면, 그 차이들 중 일부는 살아남게 됩니다. 예를 들어, 0.2와 0.8에서 시작하여 각각 약 0.1씩 증가하는 두 가중치는 나중에 와서도 여전히 같은 순서를 유지할 것입니다. 실제 조정은 훨씬 더 다양하기 때문에, 단 하나의 가중치만으로는 많은 정보를 얻기 어렵습니다. 하지만 수십만 개의 가중치 전반에 걸쳐, 초기 값이 높았던 것이 여전히 높은 최종 값과 연관되는 경향이 있는지 테스트할 수 있습니다. **그림 5(Figure 5)**는 이러한 약하지만 측정 가능한 관계를 보여줍니다. 이는 이 가중치들에서 발견된 결과이지, 모든 훈련 실행을 거쳐 생존이 보장되는 속성은 아닙니다.
Figure 5