Agentic AI는 지난 6개월 동안 CPU 업계에 [폭풍을 일으켰습니다](https://www.tomshardware.com/pc-components/cpus/demand-for-data-center-cpus-has-surged-and-ai-agents-are-responsible-why-the-cpu-to-gpu-ratio-is-more-important-than-ever-for-hyperscalers]. 하지만 여전히 최신 하드웨어가 어느 정도 수준인지 평가할 수 있는 견고하고 반복 가능한 벤치마크(benchmarks) 영역이 아닙니다. 저희는 CPU와 메모리 성능을 가속기(accelerator)로부터 분리하여, 이러한 구성 요소들이 에이전트형 루프(agentic loop)에 어떻게 기여하는지 이해하기 위해 콘텐츠 논쟁의 핵심인 에이전트형 루프의 최소한 한 가지 측면을 엔드투엔드(end-to-end)로 평가할 내부 테스트 세트를 개발해 왔습니다.
이는 아직 진행 중인 작업이지만, 저희는 Tom’s Hardware Premium 독자분들께 이 문제를 어떻게 다루고 있는지, 테스트 방법론은 무엇인지, 그리고 과정에서 에이전트형 루프에 대해 어떤 것을 배웠는지 비하인드를 보여드리고 싶었습니다. 저희는 테스트를 프로토타입으로 만들고 핵심 설계를 확정했지만, 여기서 도출되는 수치들이 검증을 거쳐 신뢰성을 갖기까지는 아직 할 일이 남아 있습니다.
이 컴퓨팅 영역은 최첨단(bleeding-edge)이며 급속도로 진화하고 있기 때문에, 저희에게는 의심할 여지 없이 사각지대(blind spots)가 존재합니다. 괜찮습니다. 저희가 수행하는 테스트는 세션이 증가함에 따라 CPU 전반에 걸쳐 에이전트형 성능이 어떻게 확장되는지를 살펴보고, 상호 작용성을 유지하면서 가능한 한 많은 에이전트 세션을 제공할 수 있는 각 칩의 이상적인 처리량(throughput)을 제공하도록 설계되었습니다.
본 기사의 말미에는 이 접근 방식의 몇 가지 단점과 다중 턴 에이전트형 흐름(multi-turn agentic flows) 같은 문제들을 해결하기 위해 저희가 구상하고 있는 아이디어들에 대한 섹션을 포함했습니다. 그리고 이러한 테스트들이 로컬 AI에 대한 다른 테스트를 대체하기 위한 것이 아니라 보완하기 위한 것임을 염두에 두시기 바랍니다. 이 공간이 계속 진화하고 하드웨어 특성이 더 명확하게 정의됨에 따라, 저희는 미래에 이 테스트가 어디로 나아가야 할지에 대해 더욱 정보에 입각한 결정을 내릴 수 있을 것입니다.
에이전트형 AI 루프 정의하기
"AI 에이전트(AI agents)"는 마치 LLM에 장착된 작은 일꾼들 같아서, 사용자가 던지는 어떤 작업이든 처리할 수 있음을 의미합니다. 이는 훌륭한 설명이지만, 에이전트형 AI(agentic AI)의 성능을 벤치마킹하려면 좀 더 기술적인 정의가 필요합니다.
여기서 중요한 부분은 두 가지입니다. 첫 번째는 함수입니다. 에이전트형 AI에서는 LLM에 도구(tools)에 대한 접근 권한을 부여하는데, 인기 있는 LangGraph와 같은 에이전트 프레임워크의 경우 이는 파이썬 함수가 됩니다. 도구는 파일을 읽거나 쓰거나, 데이터베이스를 조회하거나, 코드에 대한 테스트를 실행하거나, 함수로 정의할 수 있는 거의 모든 것일 수 있습니다. 기본적인 예시는 다음과 같습니다.
@tool    def run_command(command: str) -> str:
        """Run a build or test command in the repository root. Allowed: make [targets], python -m pytest [args]."""
        return traced("run_command", {"command": command}, lambda: ws.run_command(command))
이것이 파이썬 내부에서 LangGraph를 사용하여 도구 호출을 작성하는 방식이며, 이는 우리가 LangGraph 페르소나를 통해 LLM에 접근 권한을 부여한 도구 호출의 예시입니다. 우리는 "@tool"을 사용하여 LLM이 호출할 수 있는 도구로 함수를 식별하고, 이어서 일반적인 파이썬 방식으로 "def run_command"를 정의하며 명령어를 인수로 전달합니다. 끝에 붙은 추가적인 "-> str"는 인수가 문자열(string)일 것이며 함수가 문자열을 반환해야 함을 나타냅니다.
그 뒤에는 LLM이 읽을 수 있는 도구 설명(description)이 이어집니다 (삼중 따옴표는 파이썬에서 여러 줄에 걸쳐 공백을 허용할 뿐입니다). 우리는 LLM에게 make 또는 pytest를 사용하여 빌드 또는 테스트 명령을 실행할 수 있다고 프롬프팅합니다. 이 예시의 경우, 우리는 함수를 익명 람다 함수로 감싸서 상위 트레이스(trace) 함수에 다시 전달합니다. 하지만 지금은 이것이 중요하지 않습니다. 목표는 도구 호출이 어떻게 생겼는지 보여주는 것입니다.
이것은 저희 코딩 에이전트가 사용할 수 있는 몇 안 되는 도구 중 하나일 뿐입니다. 이 도구는 또한 파일을 읽고 쓰고, 파일을 편집하며, 정규 표현식(regular expressions)을 사용하여 코드를 검색할 수도 있으며, 이 모든 것은 파이썬 함수로 동일한 방식으로 정의되어 있습니다. 에이전트 기반 AI (Agentic AI)는 종종 "루프"로 설명되는데, 이는 작업 수행 과정에서 도구를 여러 번 호출하거나/또는 서로 다른 도구들을 호출해야 하는 경우가 많기 때문입니다.
예를 들어 파이썬 프로젝트를 다룬다고 가정해 봅시다. 저희는 LLM(대규모 언어 모델)에게 "이 파이썬 스크립트를 디버깅해 줘"라고 프롬프트를 줄 수 있습니다. 그러면 먼저 어떤 파이썬 스크립트에 대해 이야기하는지 평가하기 위해 "파일 목록 보기 (list files)" 도구를 호출할 수 있습니다. 다음으로, 내용을 이해하기 위해 "파일 읽기 (read file)" 도구를 호출하거나, 문제 해결을 시작할 지점을 찾기 위해 "코드 검색 (search code)"을 사용할 수도 있습니다. 그 후에는 "파일 편집 (edit file)"과 "명령 실행 (run command)"을 수행할 수 있으며, 파일이 수정되지 않았다면 이 도구들을 몇 번 더 반복적으로 호출하는 루프를 돌릴 수 있습니다.
이것이 바로 에이전트 기반 루프(agentic loop)입니다. 저희가 LLM에게 프롬프트를 주면, 모델은 답변을 구성하는 데 필요한 도구를 평가하고 호출하기 시작합니다. 그런 다음, 도구 호출로부터 받은 정보를 바탕으로 재평가하고, 추가적인 도구를 호출할 수도 있습니다.
동시성(concurrency) 시작하기
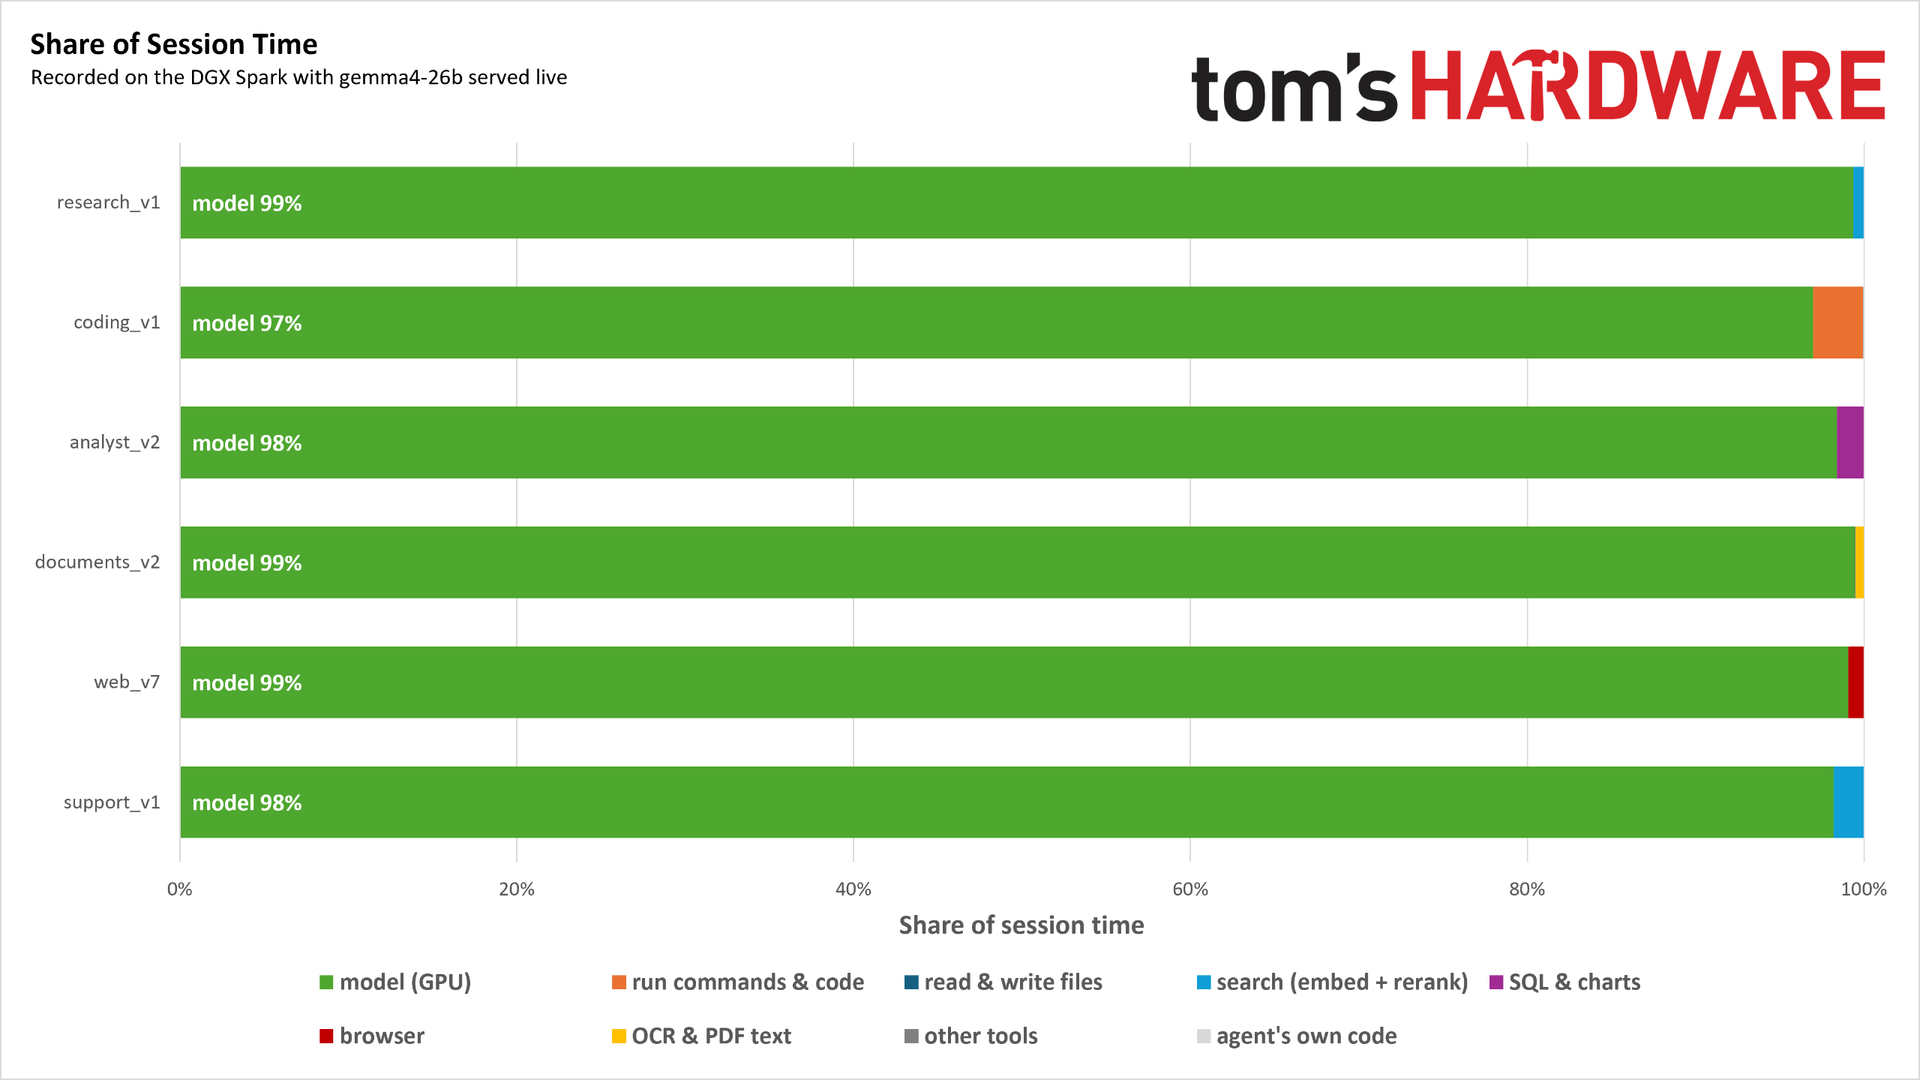
Session time for AI agents.
여러 작업을 수행할 때, 세션 시간의 대부분은 단일 에이전트가 순차적으로 작동하는 GPU에서 소모됩니다. (이미지 출처: Tom's Hardware)
본문 후반부에서는 구체적인 테스트와 그 기능에 대해 자세히 다루겠지만, 저희 벤치마크가 왜 이런 방식으로 설계되었는지 배경을 설명드리는 것이 좋습니다. 저희는 통합 메모리 128 GB, Blackwell GPU, 그리고 비교적 약한 Arm 기반의 Grace CPU를 특징으로 하는 Nvidia DGX Spark (GB10)에서 테스트를 개발했습니다. 위에서는 GB10에서 gemma4-26b-a4b을 사용하여 이러한 에이전트 루프를 실행하는 데 걸린 시간을 볼 수 있습니다. 모델 자체는 도구를 호출할 수만 있다면 크게 중요하지 않으며, 개발사들이 계속해서 다양한 모델들을 출시함에 따라 저희가 테스트를 재기록할 수 있습니다.
여기서 핵심은 모델이나 에이전트가 수행하는 특정 작업 자체가 아니라, 소요된 시간의 비율입니다(물론 이는 유용한 맥락을 제공합니다). 여기서 각 결과는 에이전트가 모델에 대해 실행해야 하는 일련의 순차적 작업 목록이며, 거의 모든 시간이 GPU에서 소비됩니다. 코딩 에이전트를 사용하는 경우와 같이 비교적 까다로운 CPU 작업조차도 전체 계산 시간 중 아주 작은 부분을 차지할 뿐입니다. 강력하고 큰 모델을 구동하는 대용량 GPU에 접근할 수 있다면, 에이전트 한두 개를 실행하는 것은 CPU에게 문제가 되지 않습니다.
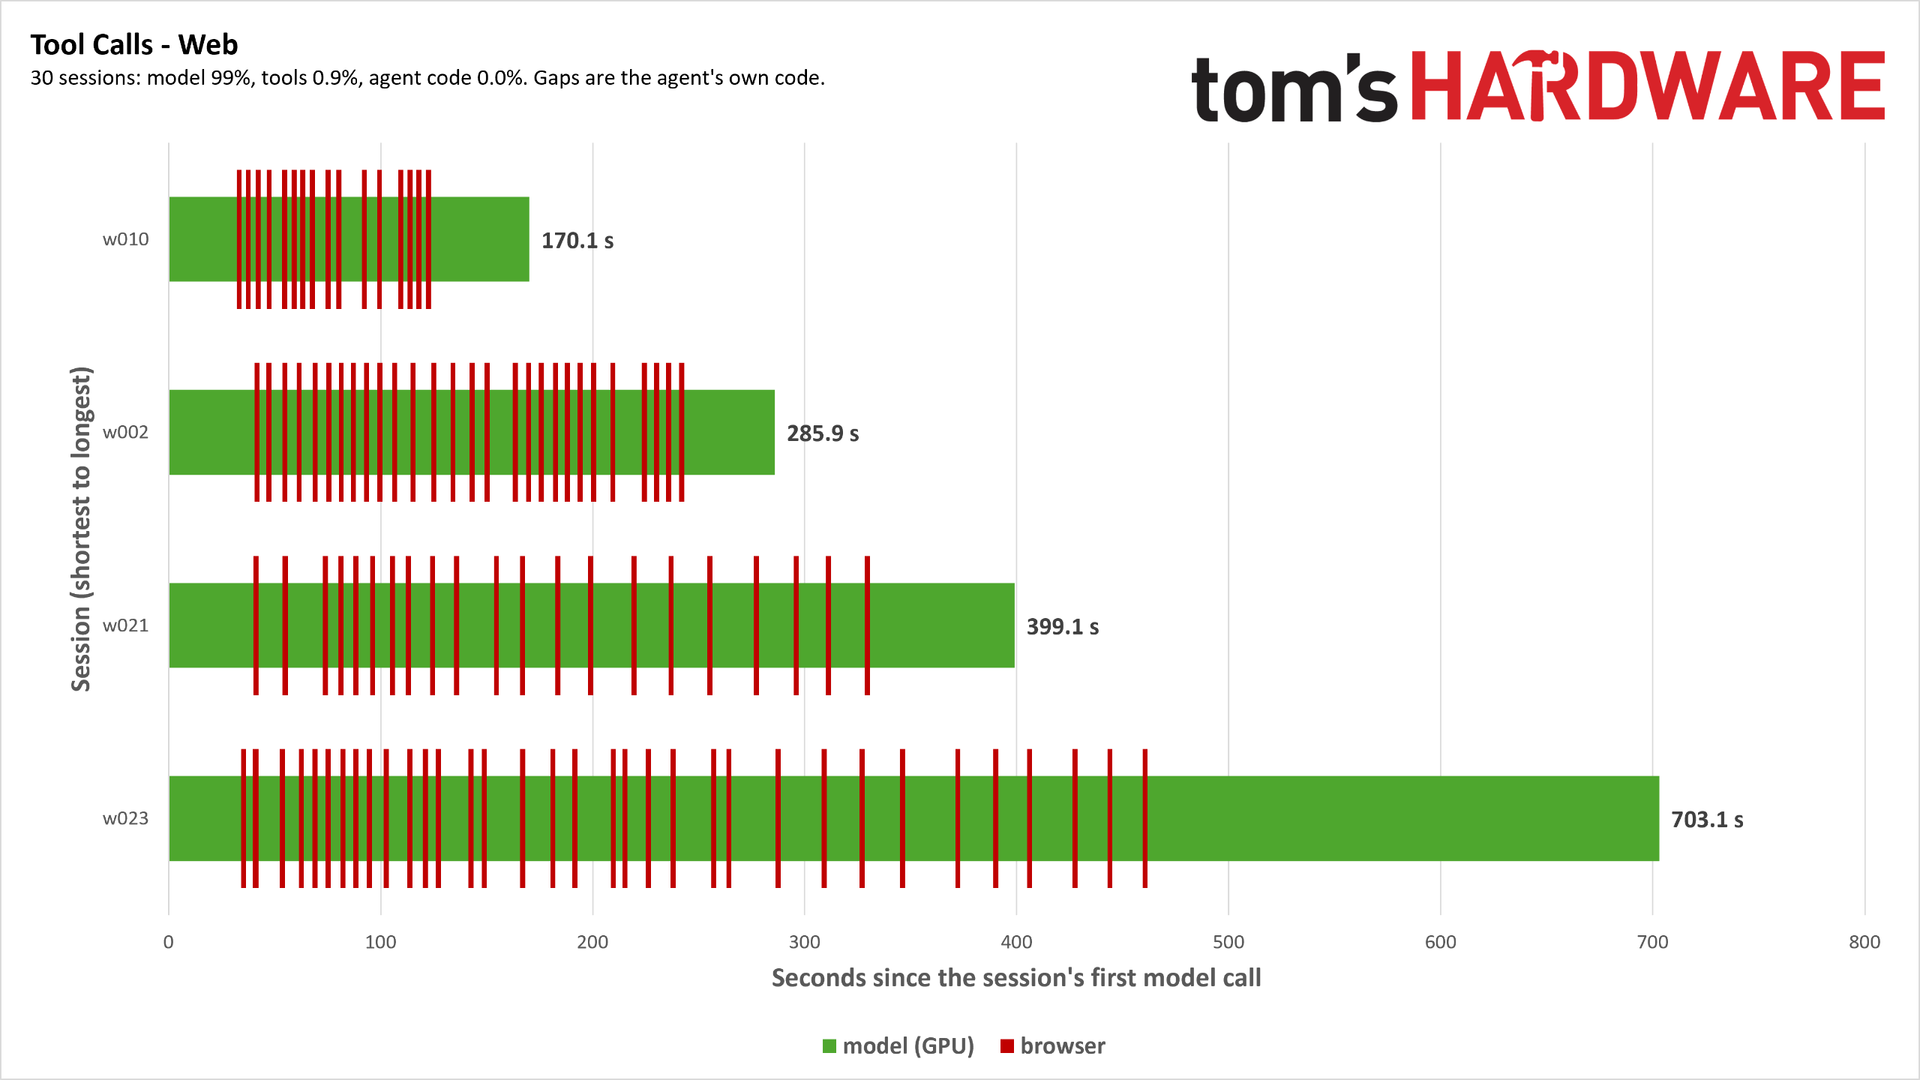
Tool calls.
단일 쿼리만으로도 여러 개의 도구 호출(tool calls)이 발생하며, 에이전트가 도구를 호출하고 응답을 전달한 다음 다시 도구를 호출하는 루프를 만듭니다. (Image credit: Tom's Hardware)
특정 작업 세트를 자세히 살펴보면, 해당 시간 동안 CPU가 실행할 수 있는 충분한 작업들이 있다는 것을 알 수 있지만, 이러한 작업들은 너무 빠르게 발생하여 전체 소요 시간에 거의 기록되지 않습니다.
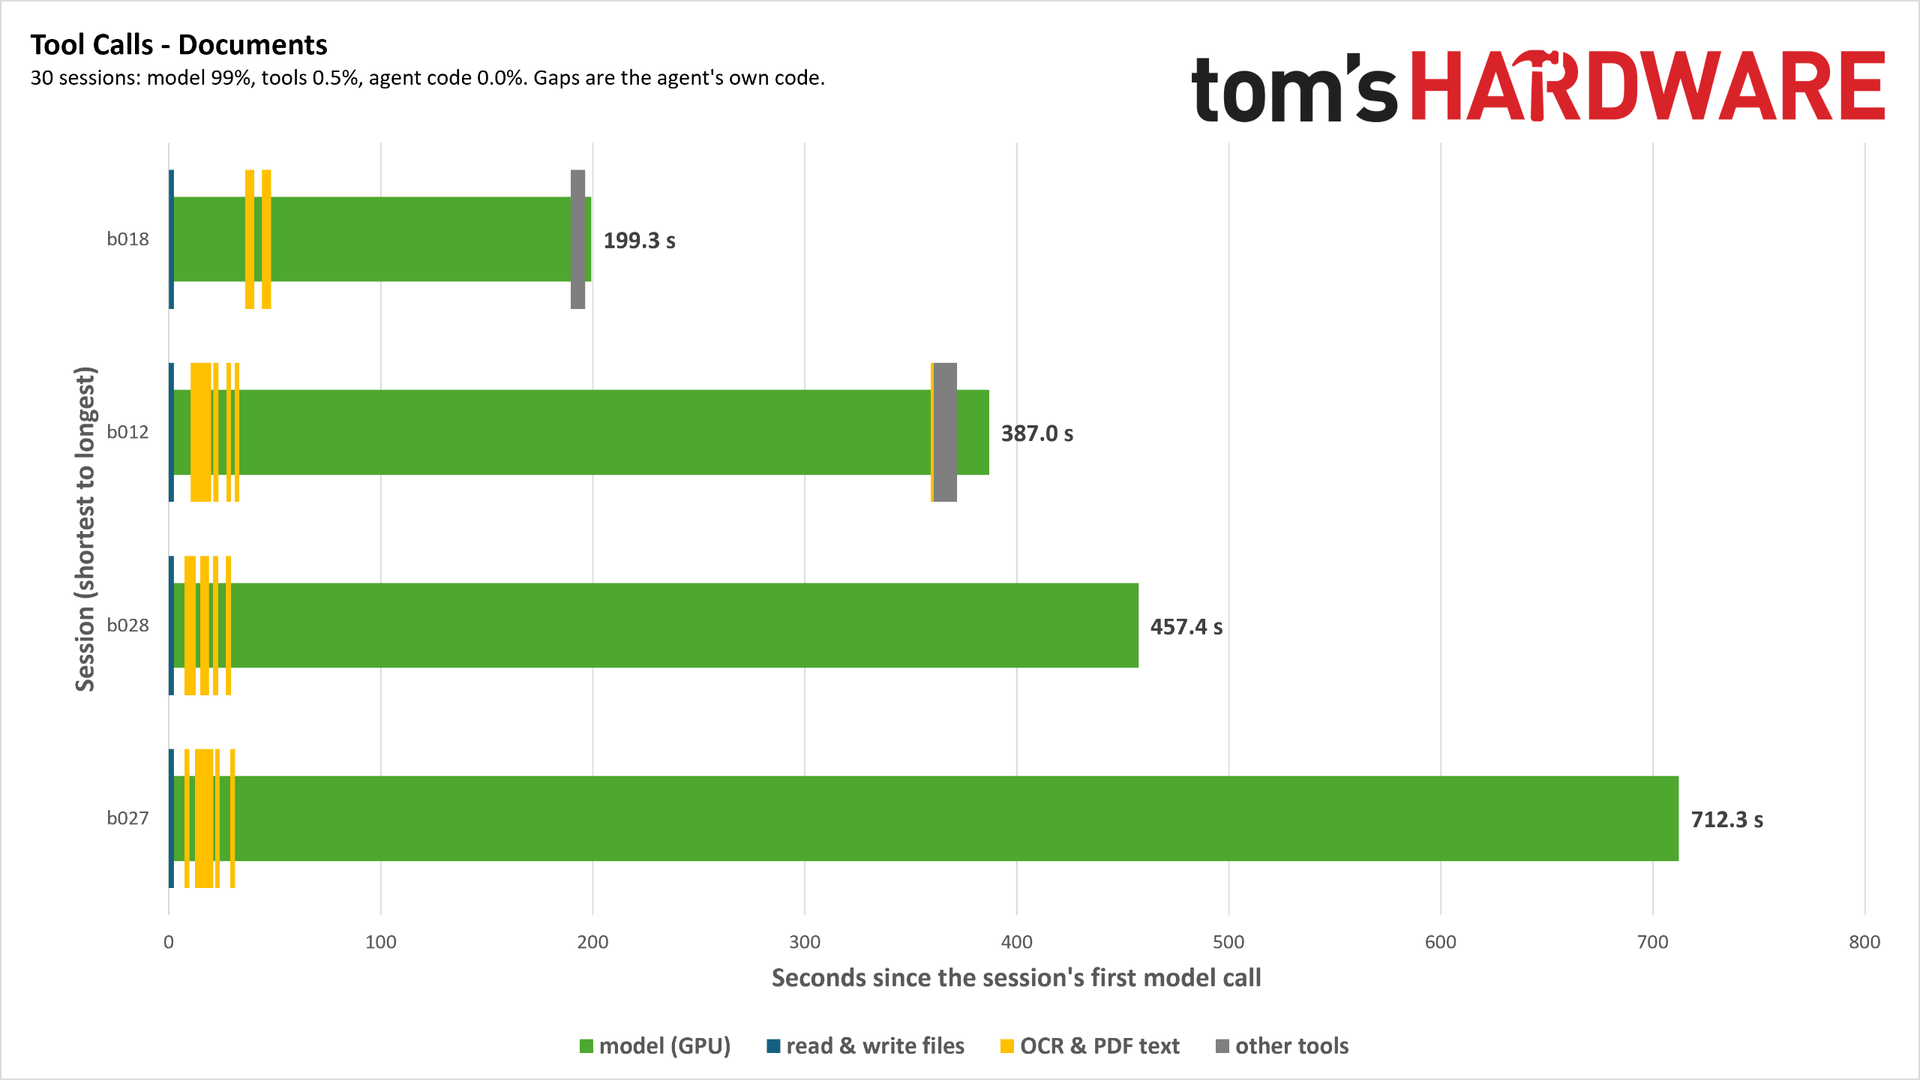
Tool calls.
도구 호출 패턴은 작업에 따라 다릅니다. (Image credit: Tom's Hardware)
이러한 작업들은 균일하게 간격이 떨어지지도 않습니다. 에이전트가 도구를 호출해야 하는 시점에 따라, 워크로드의 형태는 매우 다르게 보일 수 있습니다. 예를 들어 위에서 볼 수 있듯이, 문서 에이전트는 일련의 PDF 파일에서 정보를 스캔하고 추출하는 작업을 맡고 있습니다. 에이전트 시간의 거의 전부가 작업 초반에 소요되며, 그 이후에는 거의 순수한 GPU 추론(inference)만 이루어집니다.
물론 더 강력한 GPU는 추론 단계를 더 빠르게 처리하겠지만, 일반적인 도구들을 사용하는 경우에도 단일 에이전트 루프의 CPU 부분을 병목 현상으로 만들기 위해서는 CPU와 GPU 사이에 심각한 불균형을 만들어야 합니다. 하지만 에이전트는 단순히 순차적 작업 목록만 처리하는 것이 아닙니다. 이들은 서브 에이전트를 생성하며, 여러 세션이 샌드박스 환경(sandboxed environments)에서 동일한 시스템에서 실행될 경우, 제한된 자원에 대한 경합(contention for limited resources) 문제가 실제 이슈가 됩니다.
테스트 플랫폼을 설계할 때 심각한 CPU/GPU 불균형이 발생하도록 하는 대신, 우리는 동시성(concurrency)에 초점을 맞췄습니다. 아이디어는 각 프로세스에서 작업 목록을 루프(loop)로 실행하는 동시 세션들로 칩 전체를 스윕하는 것입니다. 이 스윕이 확장됨에 따라 CPU 전반에 걸쳐 경합(contention)이 나타나기 시작하며, 에이전트가 수행하는 도구 호출(tool calls), 코드 실행 및 컴파일, 웹 브라우징, 그리고 기타 다양한 작업의 사소한 차이들이 쌓여갑니다.
벤치마크 작동 방식
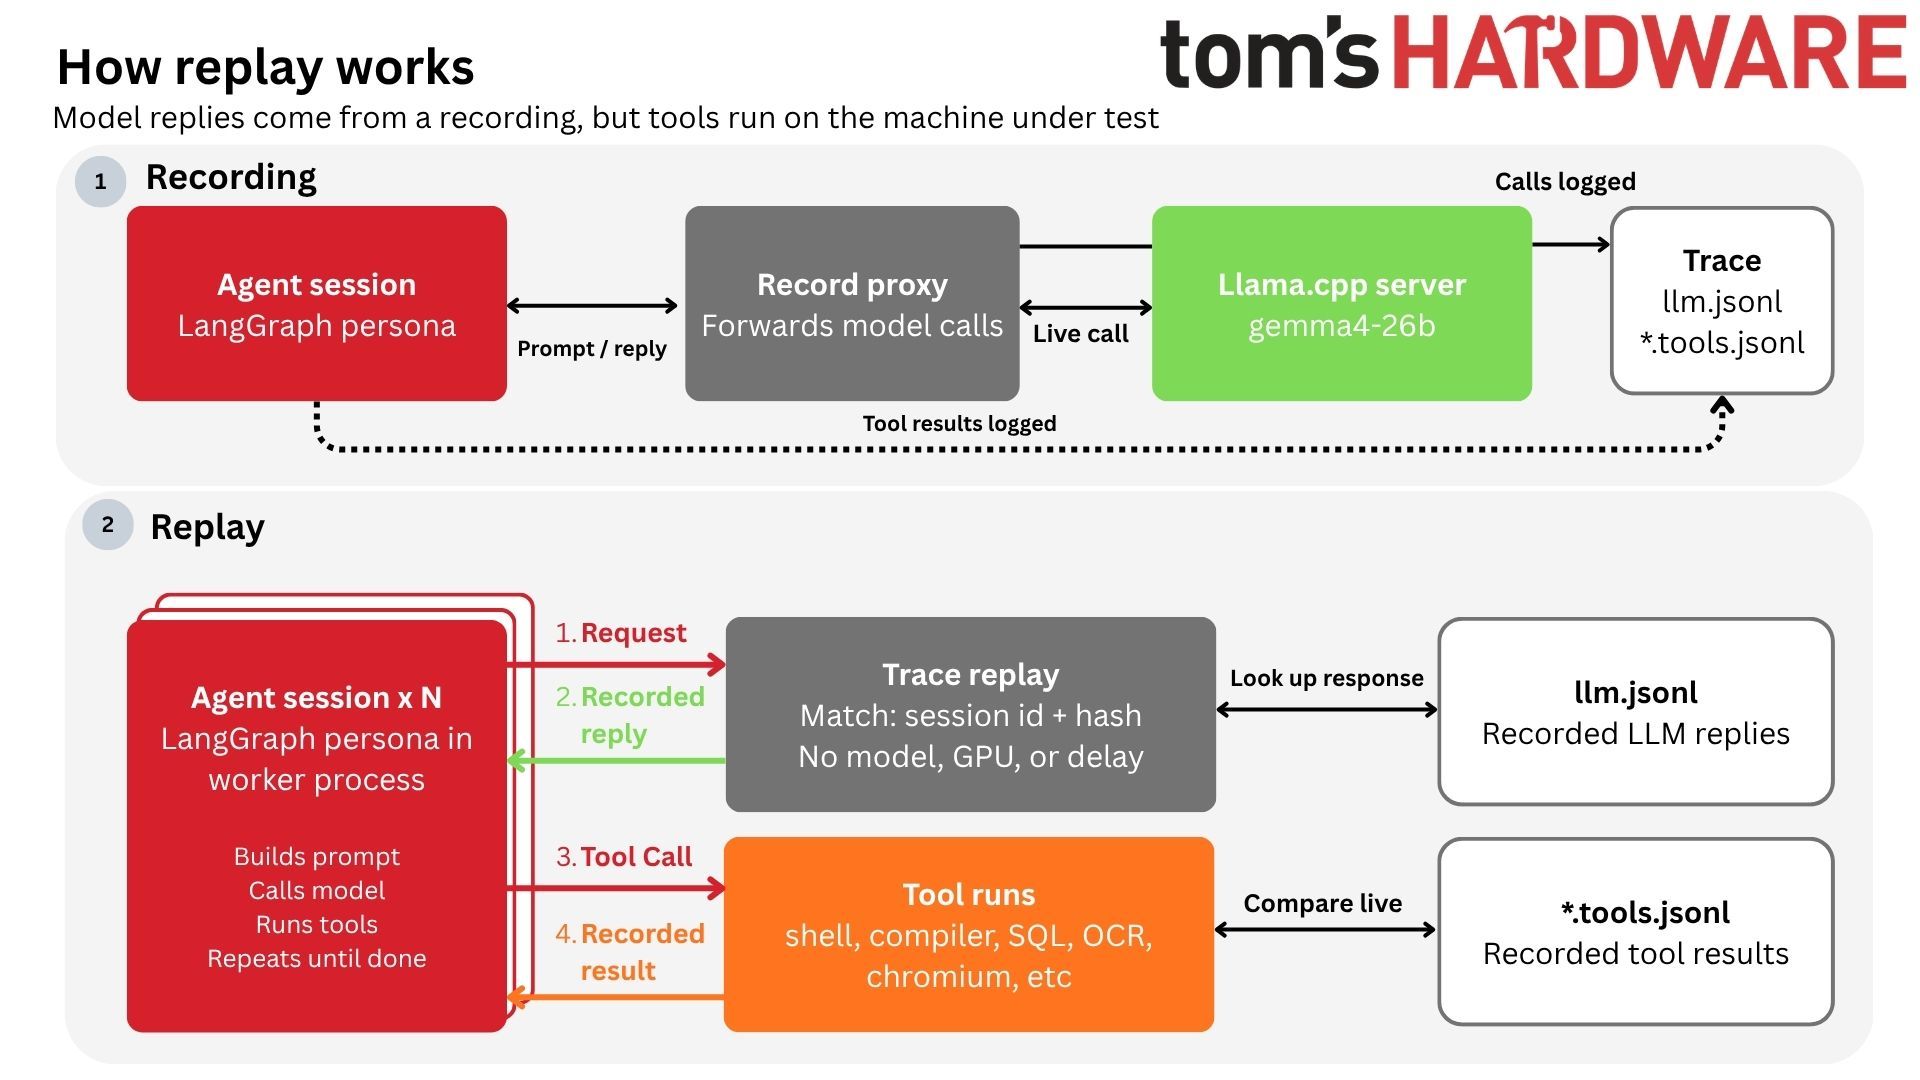
동시성을 핵심 기준으로 삼아, 우리는 벤치마크의 설계와 내부 작동 방식을 분석할 수 있습니다. 전체적인 디자인은 간단합니다. LangGraph로 구축된 커스텀 에이전트들은 llama.cpp 서버(Gemma4-26b-a4b 실행)를 대상으로 순차적으로 30개의 작업을 수행하는 목록을 가지고 있습니다. 하지만 에이전트들은 서버에 직접 연결하는 대신, 트레이스(trace)를 기록하는 프록시 서버를 거칩니다.
라이브 녹화(live recording) 동안, 에이전트는 프록시 서버와 통신하고, 이 프록시 서버는 실제 호출을 llama.cpp 서버로 전달합니다. 이 과정에서 프록시 서버는 LLM으로 기록되는 모든 요청과 그 응답을 포괄적인 JSON 파일에 작성합니다. 도구 호출(Tool calls)은 서버 체인을 우회하며 자체 JSON 파일에 기록됩니다. 마지막으로, 각 작업에 대해 정확한 응답이 생성되고 해시되어 별도의 JSON으로 저장됩니다.
Agentic CPU benchmark flow.
(이미지 출처: Tom's Hardware)
모든 것을 기록함으로써 우리는 라이브 모델을 방정식에서 완전히 제거할 수 있습니다. 에이전트들은 여전히 정상적으로 실행되지만, 실시간 LLM에 대해 실행되는 대신, 캡처된 트레이스를 재현하는 해당 프록시를 대상으로 실행됩니다. 요청과 도구 호출은 모두 실시간으로 발생하지만, 에이전트들에게는 실시간 추론 캡처(live inference capture)를 기반으로 한 트레이스 응답이 즉시 반환됩니다.
에이전트로부터 요청이 들어오면, 해당 요청은 세션 레이블(session label)과 해시(hash)를 통해 일치 여부를 확인하여 마스터 JSON에서 응답을 조회하기 전에 정확성을 보장합니다. 불일치가 발생하면 실행이 중단되고 무효한 것으로 표시됩니다. 모든 것이 정상적으로 확인되면, 응답이 반환되며 에이전트 세션은 필요한 도구(tools)를 호출합니다. 이 도구 호출들은 기록 과정에서 생성된 JSON과 비교되며, 이때 기록된(recorded) 결과가 다시 반환됩니다. 이는 매우 중요한 부분입니다.
테스트는 실제 도구 호출을 기록된 결과와 비교하지만, 설령 도구 호출이 정확하더라도 테스트가 흐트러지는 것을 방지하기 위해 항상 기록된 결과를 반환합니다. 실제 도구 불일치(tool mismatches)는 로그로 남겨집니다. 테스트는 계속 진행되지만, 도구 불일치가 있는 각 레벨은 무효한 것으로 표시됩니다.
이러한 설정 덕분에 벤치마크를 재설계하고 확장하는 것이 간단해집니다. LangGraph를 사용하여 Python으로 새로운 페르소나(persona)를 작성하거나 CrewAI와 같은 다른 프레임워크로 확장할 수 있습니다. 또한, 향후에는 기능이 확장된 일부 모델을 포함하여 다양한 모델에 대해 트레이스(traces)를 재기록할 수도 있습니다. OpenAI와 호환되는 엔드포인트(endpoint)를 통해 통신하는 한, 테스트의 조각들을 조합하여 더 광범위한 워크로드 범위를 표현할 수 있습니다.
테스트는 단일 워커 프로세스(worker process)에서 시작하여 CPU의 최대 스레드 수까지 확장되며, 레벨당 세 번 반복됩니다. 각 워커 프로세스는 30개의 작업 목록을 기반으로 작동하며, 새로운 워커 프로세스는 목록의 다음 지점에서 시작합니다. 따라서, 첫 번째 워커 세션은 작업 하나(task one)에서 시작하고, 두 번째 워커 세션은 작업 둘(task two)에서 시작하는 식입니다. 작업들이 동일한 시간을 차지하지 않기 때문에, 이러한 오프셋(offset)은 작업이 겹치면서 불균형한 경합(imbalanced contention)을 유발합니다.
실제로 측정하는 것
테스트를 통해 얻는 측정 지표(metric)는 초당 세션 수(sessions per second)입니다. 여기서 세션은 처음부터 끝까지 완료되는 단일 작업을 의미하며, 우리는 각 레벨에서 초당 완료되는 세션 수를 측정합니다. 당연히 낮은 레벨에서는 초당 세션 수가 적게 기록되며, 종종 1 미만으로 떨어져 작업 완료 시간이 1초보다 길다는 것을 의미합니다. 작업은 순차적으로 완료됩니다. 우리가 알아보고자 하는 것은 세션이 증가함에 따라 칩들이 어떻게 분기하는지, 즉 CPU에서 에이전트형 작업(agentic work)의 처리량(throughput)을 측정하는 것입니다.
우리는 이 테스트를 통해 두 가지 주요 점수를 도출합니다. 첫 번째는 피크 처리량(peak throughput)으로, 기록된 가장 높은 초당 세션 수와 해당 수치가 기록된 동시성 레벨입니다. 다음은 이상적 처리량(ideal throughput)으로, 가장 느린 상위 5% 세션이 기본 동시성 레벨에서 단일 세션을 완료하는 데 걸리는 시간의 1.5배를 넘지 않는 지점입니다. 우리는 세션 수가 증가함에 따라 작업 시간이 더 오래 걸릴 것으로 예상하지만, 이 1.5배 지점을 넘어서면 작업 길이가 상당히 길어지며, 프로세서의 토폴로지(topology)에 따라 처리량이 저하되기 시작할 수 있습니다.