
에이전트 평가(Agent Evals)에 대한 가장 일반적인 질문과 답변
요약
본 글은 에이전트가 기대대로 동작하는지 검증하는 '에이전트 평가(Agent Evals)'의 중요성과 방법을 다룹니다. 기존 소프트웨어와 달리, 에이전트는 실행마다 출력이 달라지고 경로도 다양하여 단위 테스트가 어렵습니다. 따라서 트레이스 기반으로 작은 데이터셋을 구축하고 기준선 평가를 수행해야 합니다.
핵심 포인트
- 에이전트 평가는 변동성을 고려해 결과를 점수화하는 것이 핵심입니다.
- 평가는 오프라인(출시 전)과 온라인(운영 환경) 방식으로 구분하여 사용합니다.
- 테스트는 트레이스에서 발견한 특정 '행동'을 중심으로 작은 데이터셋부터 시작해야 합니다.
- 최적의 평가 조합은 팀, 제품, 목표에 따라 달라지므로 점진적으로 접근하는 것이 중요합니다.
주요 요점
**평가(Evals)**는 에이전트의 실행 결과를 점수화하여, 기대하는 대로 동작하는지 확인할 수 있게 해줍니다. 시작하려면, 원하는 행동 하나를 선택하고 실제 추적 기록을 바탕으로 작은 데이터셋을 구축한 다음 기준선(baseline) 평가를 실행하세요. 출시 전에는 오프라인 평가(offline evals)를, 운영 환경에서는 온라인 평가(online evals)를 사용하고, 새로운 실패 사례는 데이터셋 예시로 만드세요.**가능할 때는 코드 평가자(code evaluators)를, 불가능할 때는 LLM 심사관(LLM judges)을, 그리고 둘 다 확인할 때는 인간 검토(human review)를 사용하세요.**여러 단계를 거치는 에이전트의 경우, 전체 스레드(threads), 궤적(trajectories), 최종 상태까지 평가해야 합니다. Terminal-Bench와 같은 벤치마크는 더 긴 작업과 자체 환경을 가진 오프라인 평가입니다.Harbor가 이를 실행하고 결과를 LangSmith 실험에 기록합니다.
에이전트를 구축하고 출시하는 과정에서, 개발 단계뿐만 아니라 실제 사용자들이 의존하기 시작했을 때도 에이전트가 기대한 대로 동작하는지 확인할 방법이 필요합니다.
기존 소프트웨어의 경우, 동일한 입력은 동일한 출력을 생성하므로 단위 테스트(unit test)로 정확한 결과를 확인할 수 있습니다. 하지만 에이전트는 몇 가지 이유 때문에 테스트하기가 더 어렵습니다:
실행마다 출력이 달라집니다. 동일한 요청에 대해서도요.
여러 개의 답변이 정답일 수 있어, 정확히 일치하는지 확인하는 방식만으로는 부족합니다.
에이전트가 스스로 단계를 선택하므로, 올바른 출력이라 할지라도 '잘못된' 경로를 거쳐서 나올 수 있습니다. 예를 들어, 에이전트는 필요하지 않은 도구를 호출하거나 사용자 허가 없이 행동을 취할 수 있습니다.
에이전트 평가(Agent evals)가 해결책입니다. 이는 이러한 변동성을 고려하여 에이전트의 실행 결과를 점수화합니다. 이 테스트들은 평가하는 에이전트와 마찬가지로 만능은 아니며, 가장 좋은 평가 조합은 팀, 그들의 제품, 그리고 무엇을 최적화하고 싶은지에 따라 달라집니다.
LangSmith를 통해 지난 몇 년 동안 에이전트 엔지니어링을 해오면서, 저희 팀은 매우 다양한 평가 질문들을 접했습니다. 이 블로그에서는 에이전트 평가를 시작하는 방법과 워크플로우에서 사용할 수 있는 다양한 유형의 평가에 대한 가장 일반적인 질문들을 다룹니다.
어디서부터 시작해야 할까요?
모든 에이전트 평가는 먼저 여러분의 에이전트가 실제로 무엇을 하는지 이해하는 것에서 시작합니다. 트레이스(trace)는 에이전트를 한 번 실행한 기록으로, 입력값, 출력값, 그리고 그 사이에 발생한 모든 모델 및 도구 호출을 포함합니다. 샘플 트레이스를 읽어보면서 에이전트가 요청을 어떻게 처리하고 어디서 잘못되는지 확인해 보세요. 여기서 발견하는 것이 무엇부터 테스트해야 하는지를 알려줍니다. 작게 시작하세요.
관심 있는 동작(behavior)을 선택하세요. 예를 들어, 여행 어시스턴트의 경우, '사용자가 요청한 날짜와 가격 범위로 예약하는지 여부'가 하나의 동작이 될 수 있습니다. 트레이스로부터 작은 데이터셋을 구축하세요. 데이터셋은 예제들의 모음이며, 각 예제는 입력값과 종종 예상 출력값을 가진 단일 테스트 케이스입니다. 하나의 동작에 대해 10개에서 20개의 예제만으로도 시작하기 충분하며, LangSmith에서는 트레이싱 뷰(tracing view)에서 데이터셋에 직접 트레이스를 추가할 수 있습니다. 에이전트가 아직 프로덕션 환경에 배포되지 않았다면, 팀원이나 소수의 신뢰하는 디자인 파트너에게 테스트하게 하거나(dogfooding), 그 트레이스들을 활용하세요. 기준선(baseline)을 실행하세요. 현재 에이전트를 데이터셋과 비교하여 실행하고 결과를 실험(experiment)으로 저장합니다. 실험에는 특정 버전의 에이전트를 데이터셋에 대해 실행한 결과와 평가자들의 점수가 포함됩니다. 여러분은 이 실험과 비교하며 미래 버전의 에이전트 성능을 측정하게 됩니다. 발견하는 실패 사례를 추가하세요. 프로덕션 환경이나 테스트 중에 발견되는 모든 실패는 새로운 예제가 됩니다.
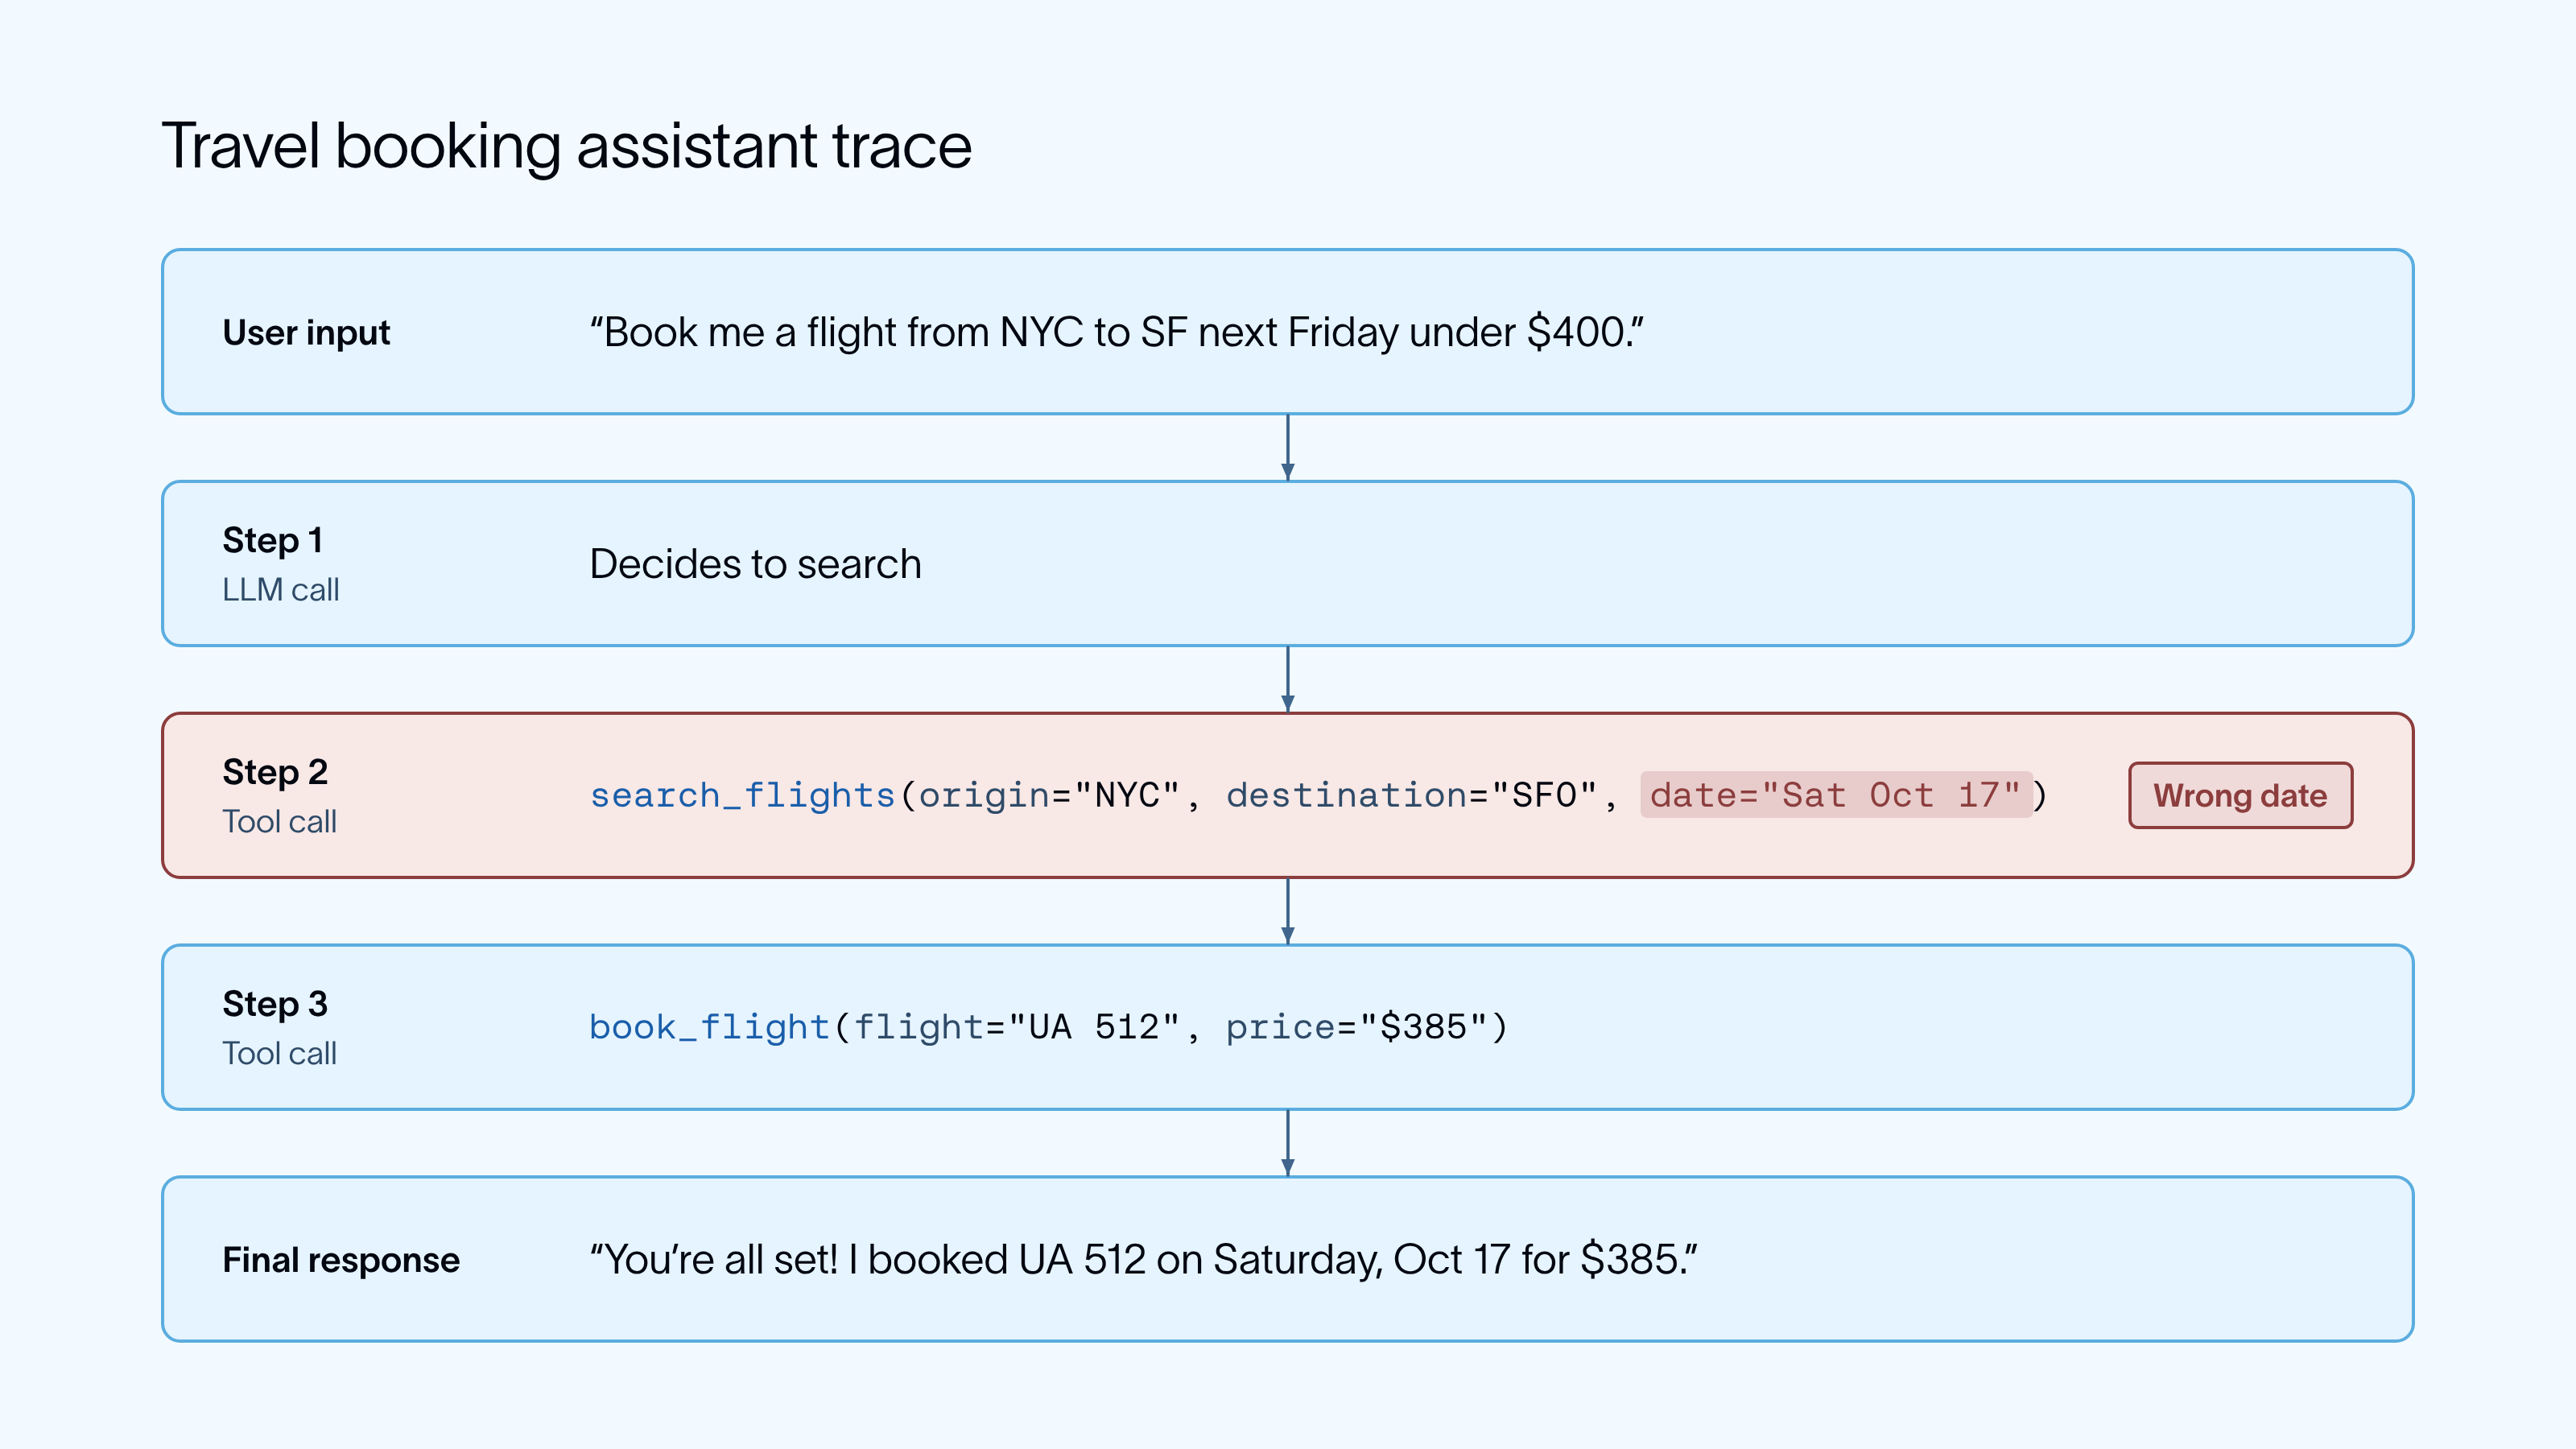
실패 사례를 데이터셋에 계속 추가하면 개선 루프(improvement loop)가 완성됩니다. 실패 사례를 찾아 데이터셋에 추가하고, 에이전트를 개선한 다음, 다시 실행합니다. 평가할 더 많은 에이전트 동작을 식별함에 따라, 위와 동일한 패턴을 따라 평가 스위트(eval suite)를 확장하게 됩니다.
오프라인 평가와 온라인 평가의 차이점은 무엇인가요?
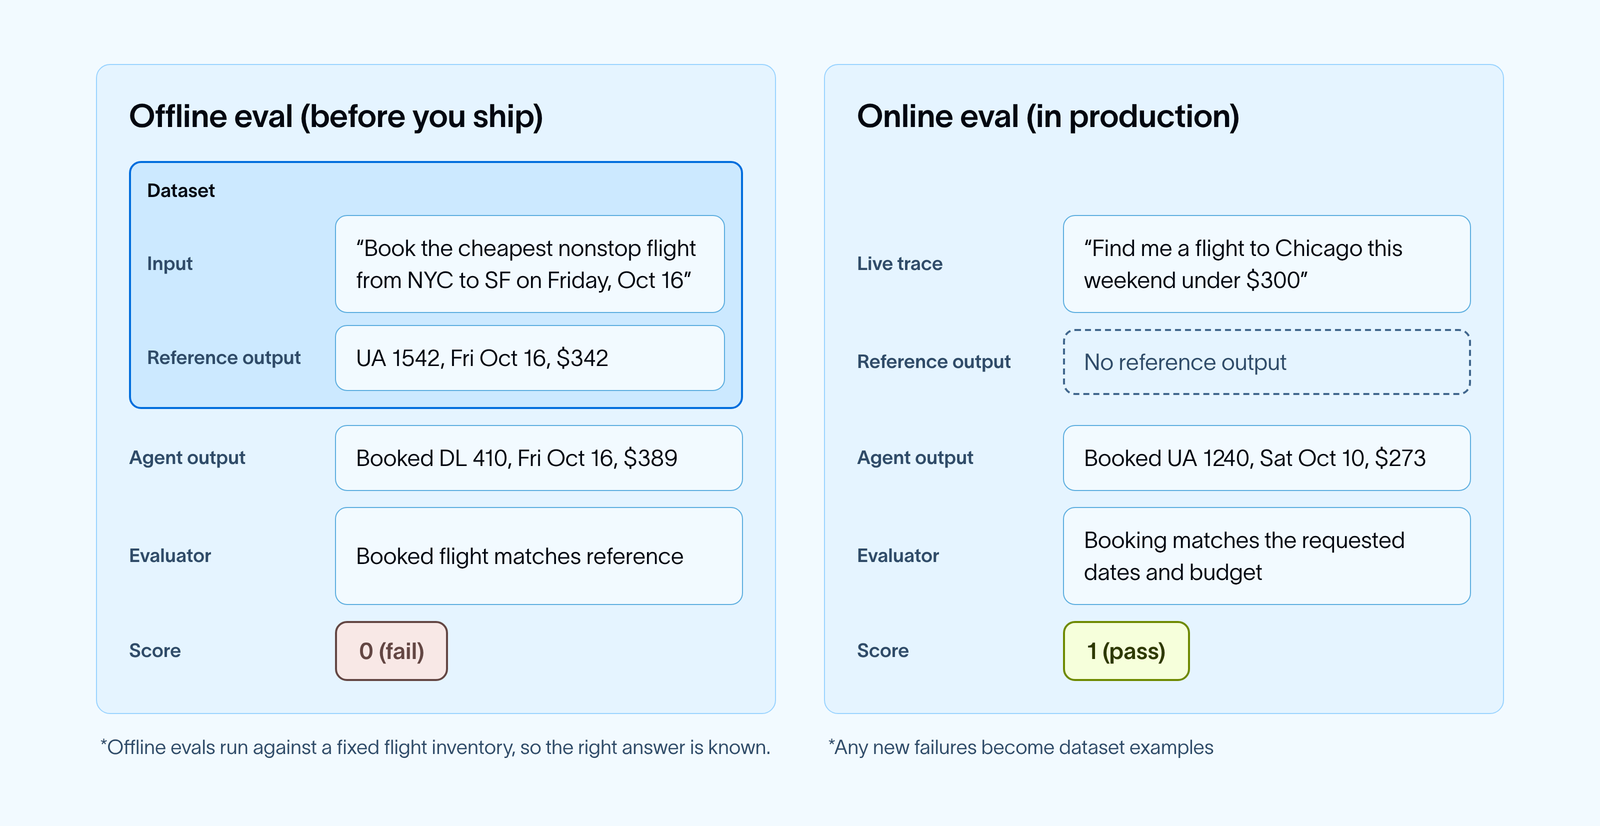
평가는 변경 사항을 배포하기 전과 에이전트가 실제로 운영된 후에 실행되어야 하며, 그렇게 하는 것이 좋습니다. 배포 전에 평가는 특정 변경 사항이 에이전트를 더 좋게 만들었는지 아니면 더 나쁘게 만들었는지를 알려줄 수 있습니다. 배포 후에는 평가가 실제 사용자와 함께 에이전트가 어떻게 성능을 내고 있는지를 알려줄 수 있습니다.
**오프라인 평가(Offline evals)는 에이전트를 변경 사항을 배포하기 전에 데이터셋으로 실행해 보는 방식입니다. 사용자가 예시 입력값을 직접 선택할 수 있으며, 예상 출력값(참조 출력값, reference outputs)도 포함할 수 있습니다. 이 데이터셋을 활용하여 다양한 에이전트 버전을 넘나드는 실험 결과를 비교할 수 있습니다. 새로운 프롬프트, 모델 또는 도구를 테스트하거나 사용자에게 도달하기 전에 회귀(regressions)를 포착하는 데 가장 적합합니다.
Terminal-Bench와 같은 벤치마크 역시 오프라인 평가이며, 고정된 작업 세트를 기반으로 구축되어 에이전트, 모델 또는 버전을 비교할 수 있게 해줍니다. Harbor는 이러한 벤치마크를 실행하고 그 결과를 LangSmith 실험(LangSmith experiments)에 기록하며, 이는 아래에서 더 자세히 다룹니다.
**온라인 평가(Online evals)**는 실제 운영 추적(production traces)이 들어오는 대로 점수를 매깁니다. 비교할 참조 출력값이 없는 경우가 많기 때문에, 자체적으로 실행을 채점할 수 있는 코드 검사 및 LLM 심사관에 의존합니다. 이는 품질을 모니터링하고 데이터셋이 놓친 문제를 찾는 데 가장 적합합니다.
두 가지 모두 필요하며, 서로 영향을 주고받습니다. 온라인 평가가 플래그를 지정한 실패 사례는 오프라인 데이터셋의 새로운 예시가 됩니다.
LangSmith에서 오프라인 평가용 데이터셋을 구축하는 방법은 몇 가지가 있습니다. 처음부터 예시를 작성하거나, 기존 추적(traces)에서 실행 결과를 추가하거나, 팀이 검토한 실행 결과를 주석 처리 대기열(annotation queue)로 보내거나, CSV 또는 JSONL 파일을 업로드하거나, 이미 가지고 있는 소수의 예시로부터 합성 예시를 생성할 수 있습니다.
평가 스위트가 커짐에 따라, 기존 데이터셋에 예시를 추가할지 아니면 새로운 데이터셋을 시작할지 결정해야 합니다. 일반적인 규칙은 다음과 같습니다:
- 실험이 시간이 지남에 따라 비교 가능하도록 하려면, 동일한 평가자(evaluators)와 동일한 동작을 테스트하는 예시는 같은 데이터셋에 유지합니다. - 입력값이 다르게 보이거나(예: 단일 요청 대 전체 대화), 다른 평가자가 필요하거나, 또는 데이터셋이 다른 목적을 수행할 때(예: 모든 풀 리퀘스트에서 실행되는 작은 세트 대 배포 전에 실행하는 더 큰 세트) 새로운 데이터셋을 만듭니다.
단일 데이터셋 내에서도 스플릿(splits)을 사용하여 예시의 하위 집합을 실행할 수 있습니다.
에이전트 평가자의 다양한 유형은 무엇인가요?
평가기(evaluator)는 실행 결과를 점수화하는 로직입니다. 일반적으로 네 가지 유형이 있습니다. 대부분의 팀은 하나 또는 두 개로 시작하여 시간이 지남에 따라 더 많은 평가기를 추가합니다.
**코드 평가기(Code evaluators)**는 예약된 가격이 사용자의 예산보다 적은지 여부와 같이 결정론적으로(deterministically) 무언가를 확인합니다. 빠르고, 저렴하며, 일관성이 있지만, 결정론적 입력과 출력을 필요로 한다는 점이 유용성을 제한합니다.LLM-as-a-judge는 어시스턴트의 답변이 항공편 세부 정보를 명확하게 확인하는지 여부와 같이 코드로 검사하기 어려운 것을 모델을 사용하여 등급 매깁니다.**사람 검토(Human review)**는 팀원이나 해당 분야 전문가가 실행 결과를 직접 점수화합니다. 속도는 느리지만, 주관적인 품질과 다른 평가기들을 검사하는 데 가장 좋은 신호입니다. 종종 더 작은 샘플에서 사용되어 LLM 평가기의 판단에 정보를 제공합니다.**쌍별 평가기(Pairwise evaluators)**는 두 개의 출력을 나란히 비교하고 더 나은 것을 선택하며, 이는 두 가지 프롬프트나 모델 중에서 선택할 때 유용합니다.
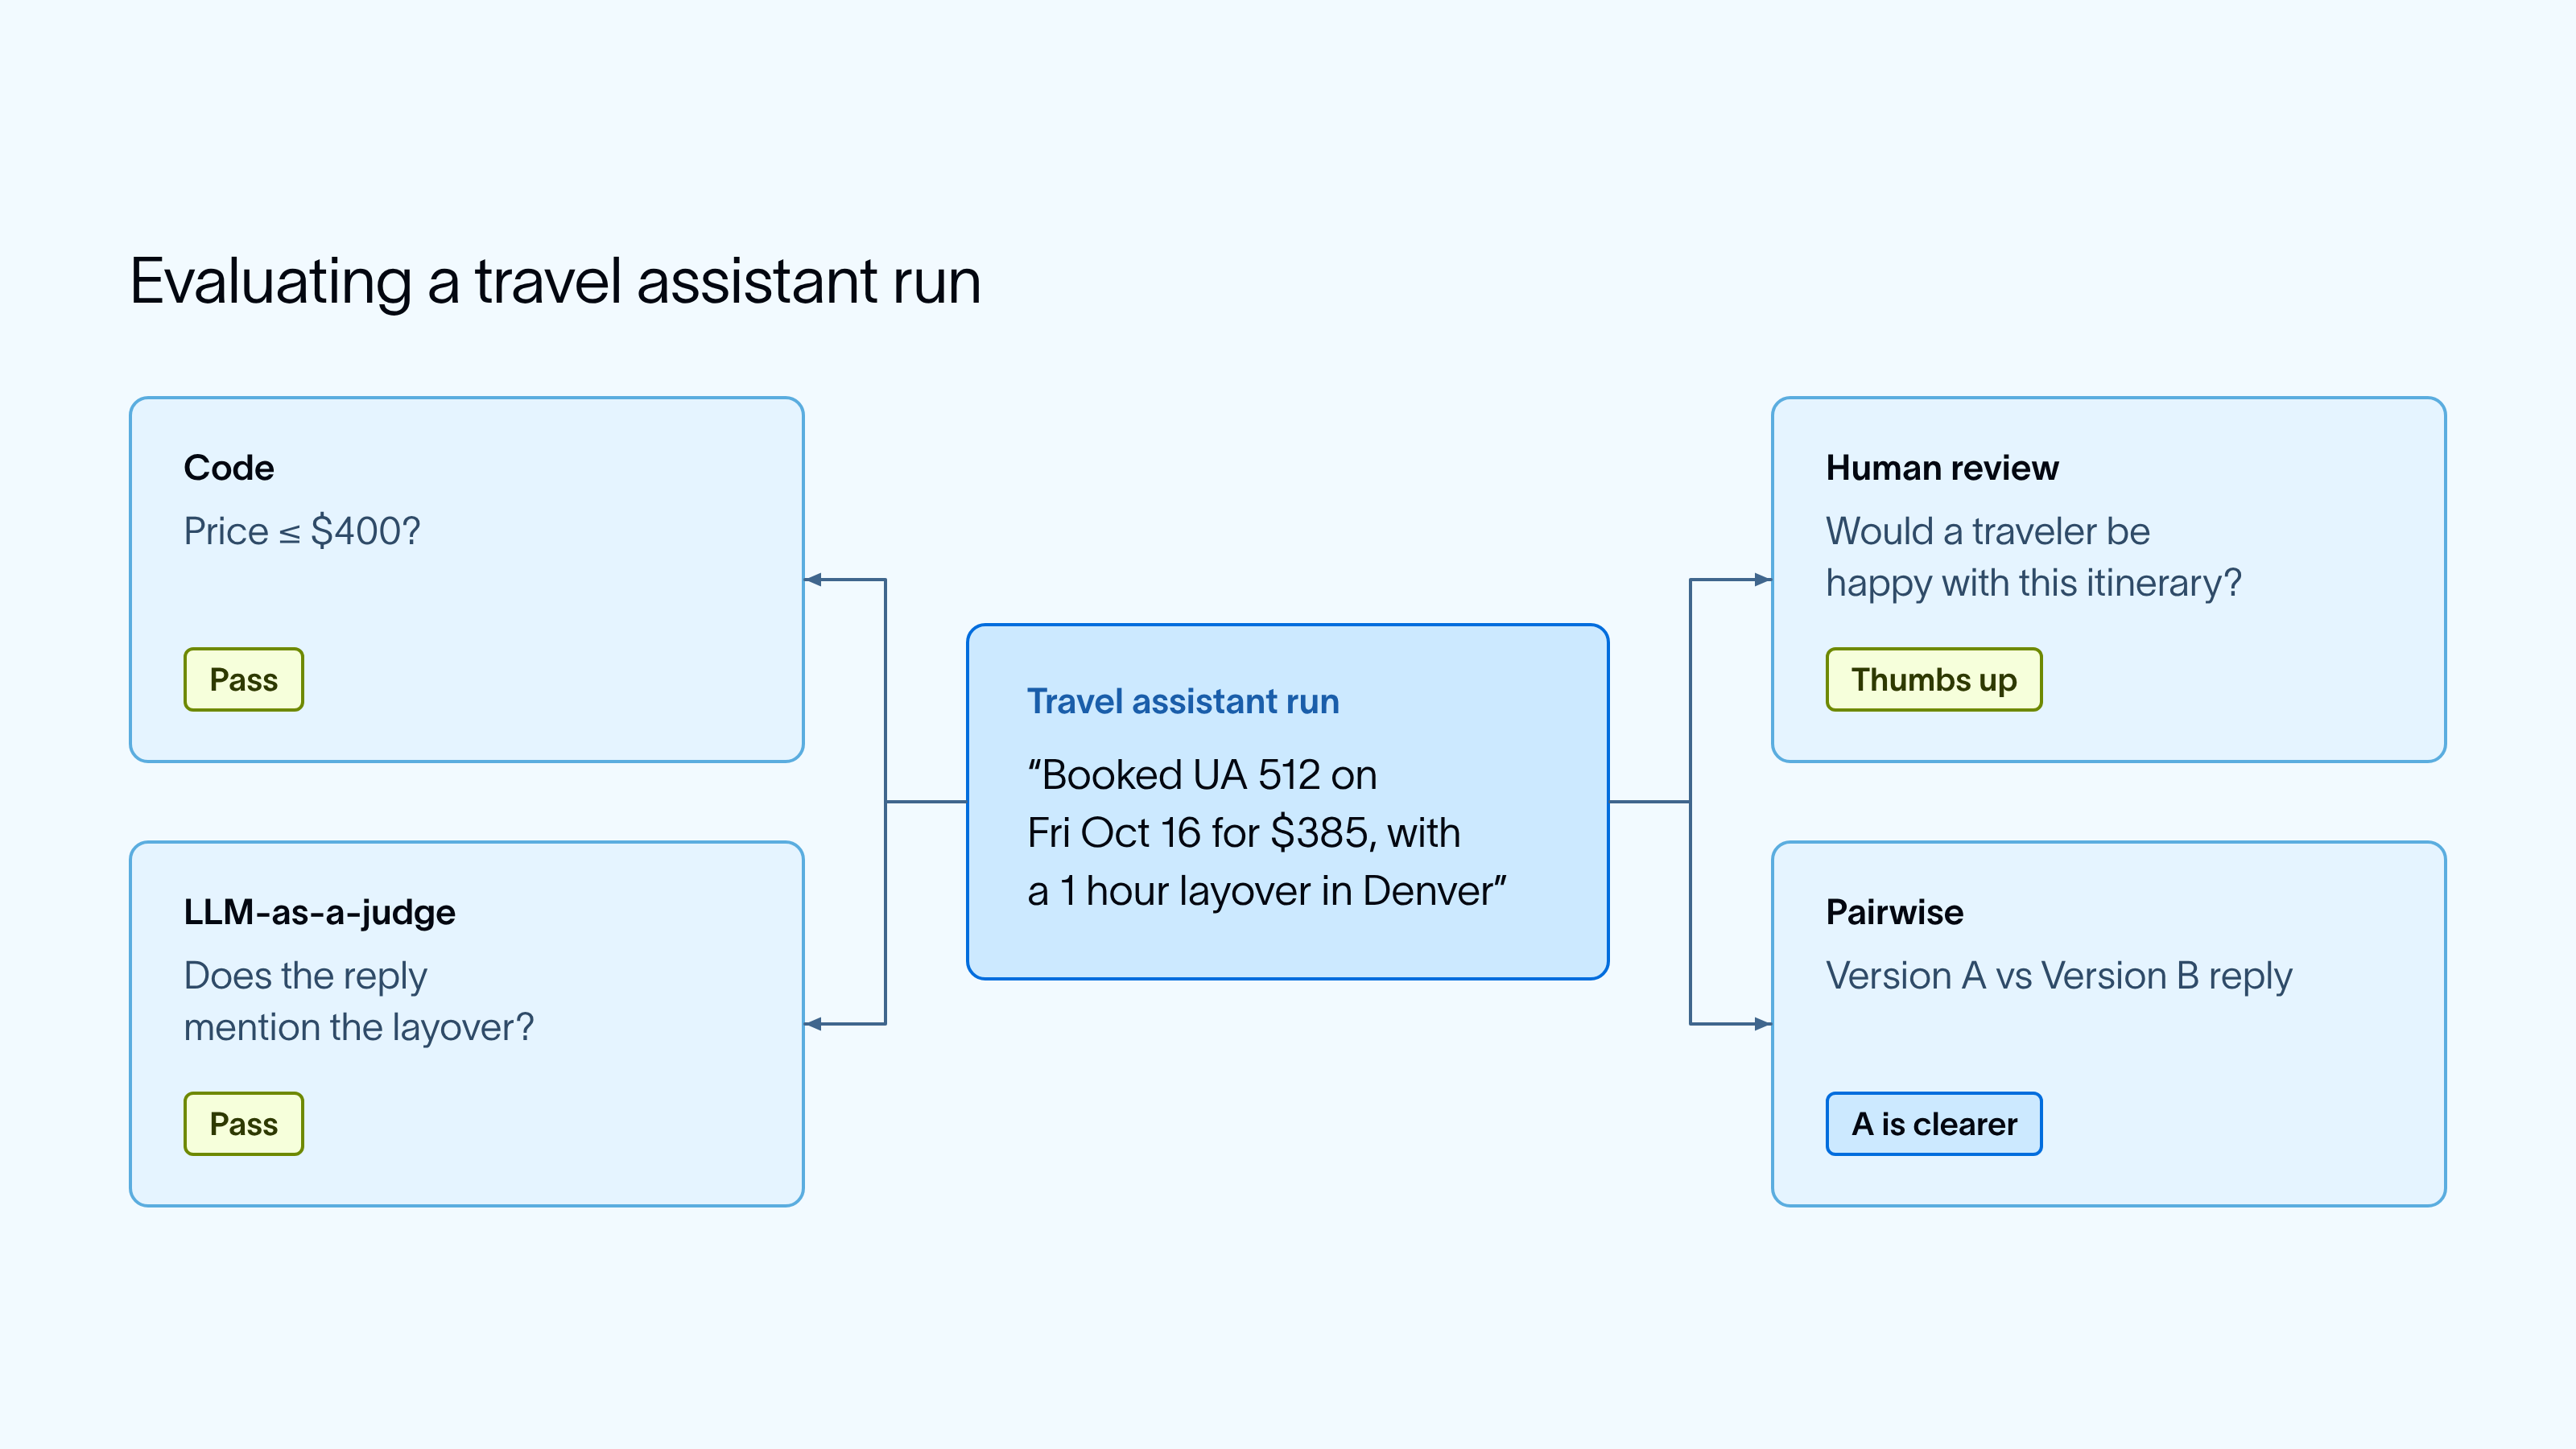
이러한 평가기들은 에이전트 실행의 여러 부분에 지정될 수 있습니다. 하나의 평가기는 다음을 점수화할 수 있습니다:
단일 단계(A single step). 예: search_flights가 올바른 날짜와 함께 호출되었는지 여부.최종 응답(The final response). 예: 답변이 에이전트가 실제로 예약한 항공편을 확인하는지 여부.전체 대화(A full conversation). 예: 최종 예약이 사용자가 여러 턴에 걸쳐 요청한 모든 변경 사항을 반영하는지 여부환경의 최종 상태(The end state of an environment). 예: 에이전트가 자체 컨테이너에서 실행된 후 모의 예약 시스템의 예약 기록. 벤치마크는 종종 이 설정을 사용하며, 때로는 이를 컨테이너화된 평가(containerized evals)라고 부르기도 합니다.
LLM 심판을 신뢰할 수 있나요?
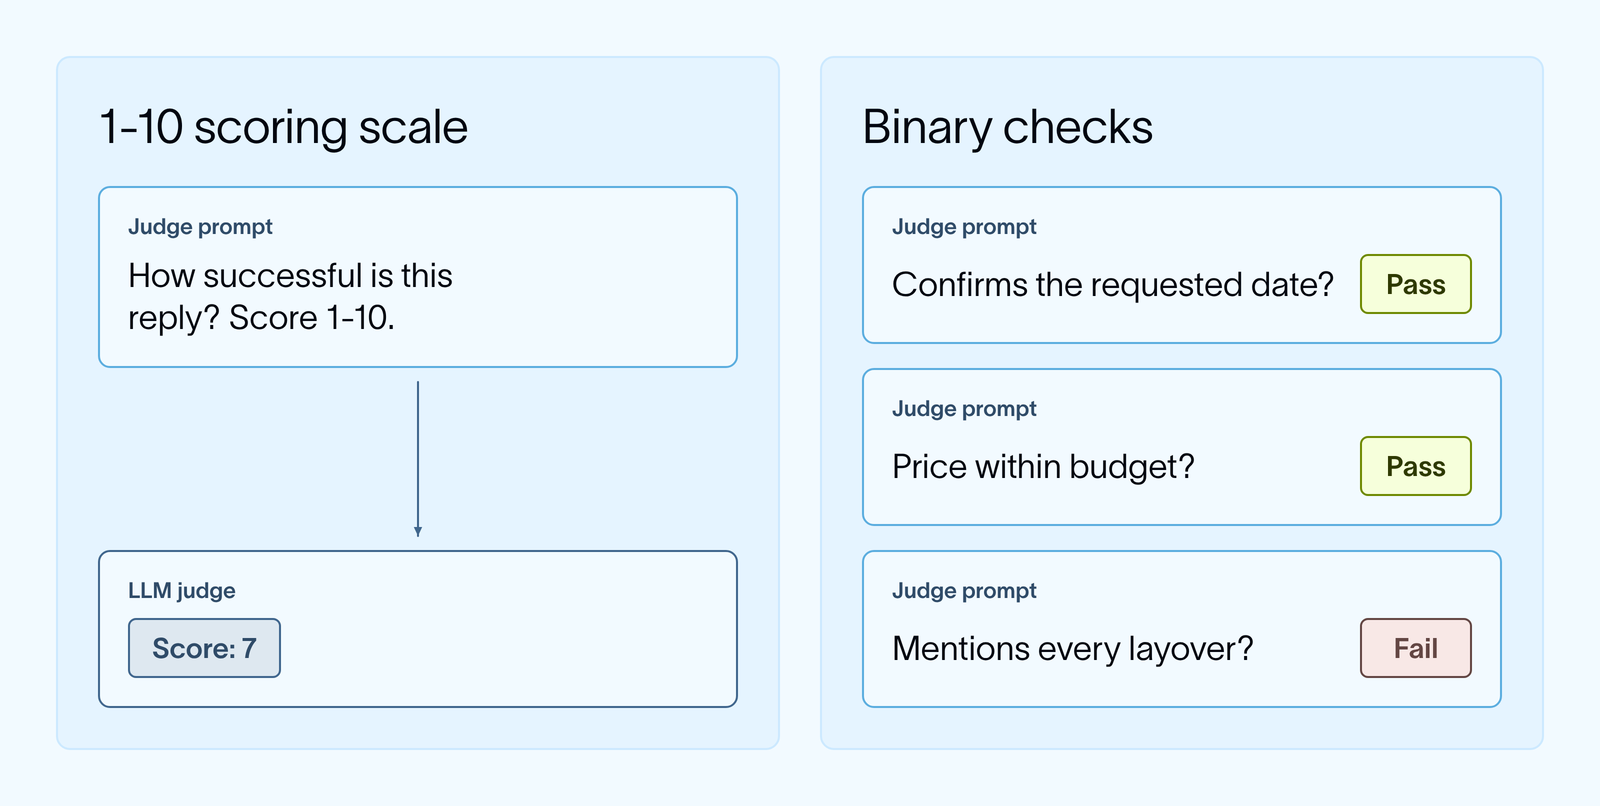
LLM 심판은 답변이 검색된 문서에 의해 뒷받침되는지 여부와 같이 코드로 확인하기 어려운 출력을 등급 매기는 데 모델을 사용합니다. 심판들은 유연하지만, 일관성이 부족하고 팀의 판단에서 벗어날 수 있습니다. 다음 몇 가지 습관들이 이들을 신뢰할 수 있게 만듭니다:
인간 점수와 판단기(judge) 비교하기. 팀원 중 누군가에게 실행 결과 샘플을 채점하게 하고, 판단기가 어느 부분에서 의견이 다른지 확인하세요. 판단기의 프롬프트나 예시를 조정하여 일치하도록 만드세요. LangSmith의 어노테이션 큐(Annotation queues) 기능이 이를 쉽게 만들어줍니다. 저희 LLM-as-a-judge 문서를 통해 자세히 알아보세요. 구체적인 질문 던지기. 여행 에이전트 예시에서 "답변에 모든 경유지가 언급되었나요?"라고 묻는 것이 "이 답변이 좋은 답변인가요?"라고 묻는 것보다 판단하기가 더 쉽습니다. 정확한 채점 척도 정의하기. 1점에서 10점까지 점수를 매기는 것보다, 이진(binary) 합격/불합격 여부 또는 소수의 레이블링된 카테고리로 평가하는 것이 재현성이 훨씬 높습니다. 판단기는 6점과 7점을 구분하는 데 어려움을 겪을 수 있습니다.
에이벌(evals)과 벤치마크(benchmarks)는 같은가요?
벤치마크는 일련의 태스크로 구성된 오프라인 평가(offline eval) 유형입니다. 태스크란 지침, 컨테이너 내 환경, 그리고 결과를 점수화하는 테스트 스크립트를 포함하는 벤치마크의 단일 테스트 케이스를 말합니다. 에이전트가 더욱 능숙해짐에 따라, 단순한 LLM 판단기나 코드 기반 평가만으로는 충분하지 않을 때가 많습니다. 에이전트는 이제 코드를 실행하고, 파일을 편집하며, 서비스와 인터페이스할 수 있습니다. 이러한 다단계(multi-step) 행동을 모델링하기 위해 벤치마크는 컨테이너 내에 격리된 인프라를 설정합니다. 이를 통해 개발자는 에이전트가 실제 운영 환경에서 작동하는 방식과 동일하게 오프라인으로 에이전트의 행동을 테스트할 수 있습니다.
벤치마크는 단순한 LLM 판단기 및 코드 기반 평가와 몇 가지 면에서 다릅니다:
태스크에 더 많은 단계가 포함됩니다. 단일 태스크를 완료하기 위해, 에이전트는 패키지를 설치하고, 파일을 편집하며, 수십 개의 툴 호출(tool calls)을 거쳐 명령어를 실행할 수 있습니다. 각 태스크는 환경을 가집니다. 에이전트는 이제 코드 저장소, 파일 및 도구와 같은 샌드박스(sandbox) 환경에서 행동을 취할 수 있습니다. 모든 태스크는 에이전트가 작업할 수 있는 자체 격리된 환경과 함께 제공됩니다. 점수화는 에이전트의 행동을 확인합니다. 테스트 스크립트는 실행 후 환경의 상태를 검사하며, 예를 들어 테스트가 통과했는지 또는 올바른 파일이 존재하는지 등을 점검합니다. 트레이스(trace)를 여전히 검토할 수는 있지만, 점수는 에이전트가 수행한 행동과 그 결과로 남긴 상태에서 나옵니다.
여행 비서의 경우, 벤치마크 과제는 에이전트에게 가상의 예약 시스템과 '폭풍으로 인해 여행자의 Denver행 항공편이 취소되었습니다. 재예약하고 호텔도 이에 맞춰 이동시키세요.'와 같은 요청을 제공할 수 있습니다. 에이전트가 작업을 완료하면, 테스트 스크립트는 데이터베이스의 예약 기록을 확인합니다.
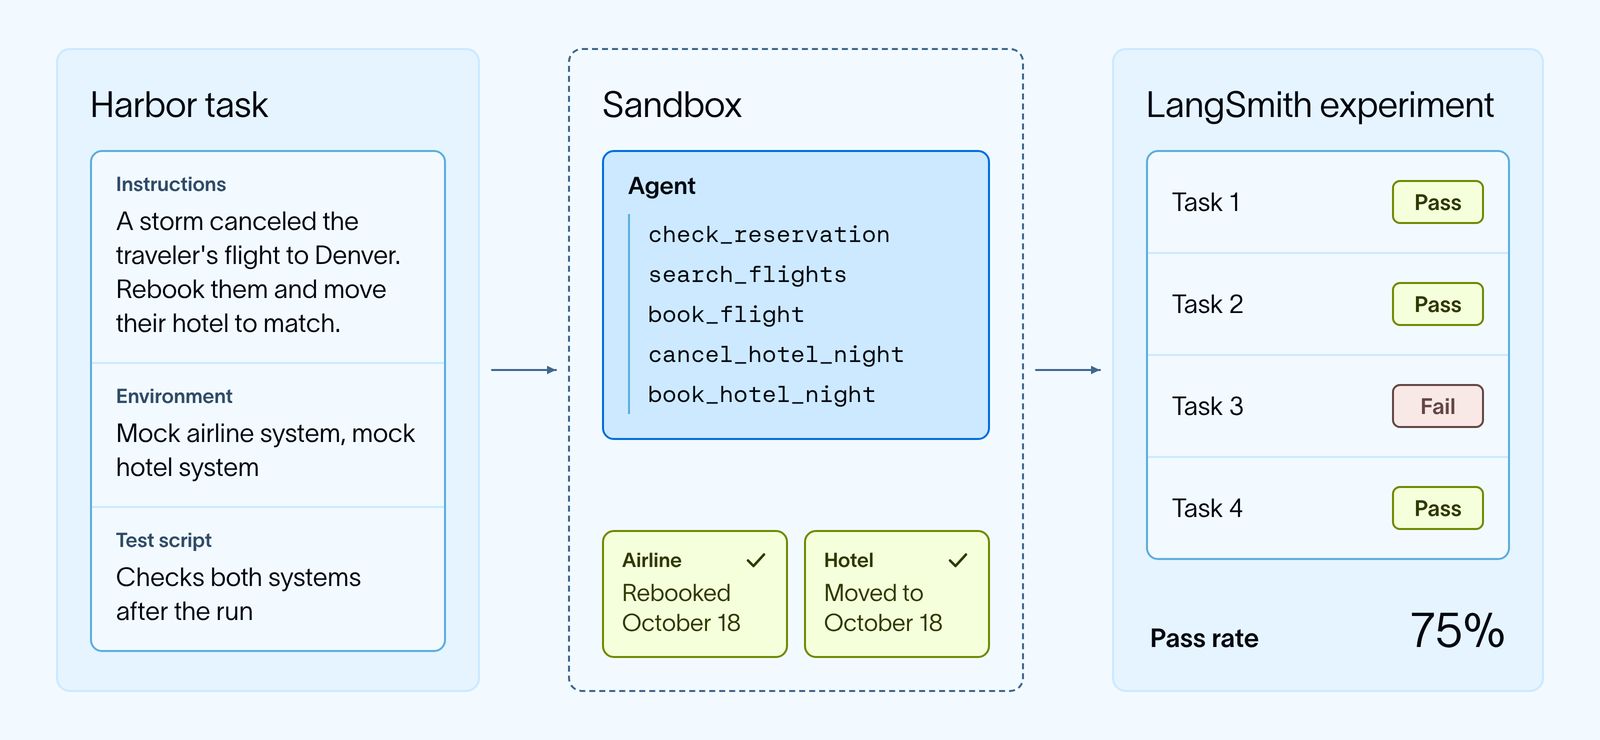
Harbor는 이러한 장기 과제에 대한 테스트를 위한 골격(scaffolding)을 제공하는 오픈 소스 평가 하네스입니다. 이는 Terminal-Bench의 기반이 되는 프레임워크이며, 동일한 과제 형식을 사용하여 자체 에이전트를 위한 벤치마크를 구축할 수 있습니다. LangSmith 통합 기능을 사용하면, 각 Harbor 실행은 LangSmith 실험으로 기록됩니다. Harbor는 각 과제를 위해 컨테이너를 구축하며, LangSmith 트레이스를 사용하여 각 환경을 에이전트가 프로덕션에서 보는 것과 가깝게 만들 수 있습니다. 벤치마크 결과는 다른 평가와 함께 배치되며, 어떤 실행이든 열어 점수 옆에 전체 트레이스를 볼 수 있습니다.
저희는 이 설정을 사용하여 실패 모드를 찾기 위해 트레이스를 검토하고 하네스를 변경함으로써 Deep Agents를 Terminal-Bench 2.0에서 개선했습니다. 또한 LangSmith Engine을 위한 벤치마크인 IssueBench를 구축하는 데 사용했습니다. 각 IssueBench 과제는 Engine에게 일련의 트레이스를 제공하고, 올바른 것들을 적절한 이슈 클러스터로 그룹화했는지 점수를 매깁니다.
자체 에이전트를 위한 벤치마크를 구축하는 것은 위의 평가와 동일한 단계를 따르지만 몇 가지 변경 사항이 있습니다:
AI 자동 생성 콘텐츠
본 콘텐츠는 LangChain Blog의 원문을 AI가 자동으로 요약·번역·분석한 것입니다. 원 저작권은 원저작자에게 있으며, 정확한 내용은 반드시 원문을 확인해 주세요.
원문 바로가기