
독립형 Nvidia Vera CPU, 오라클 클라우드 다중 기가와트 규모 배포에 상륙
요약
Nvidia가 Oracle Cloud Infrastructure(OCI) Superclusters에서 독립형 CPU인 Vera의 일반 사용 가능성을 발표했습니다. 이는 하이퍼스케일러들이 GPU 중심 클라우드와 별개로 Vera를 x86 경쟁 구도에 배치했다는 점에서 주목됩니다. 특히 Vera는 메모리 대역폭과 워크로드별 토폴로지 측면에서 강점을 보여줍니다.
핵심 포인트
- Nvidia Vera가 OCI Superclusters에서 독립형으로 제공되며, 하이퍼스케일러의 관심을 받음.
- Vera는 x86 경쟁 구도에 배치되어 CPU 컴퓨팅 분야에서의 입지를 강화함.
- 메모리 대역폭과 워크로드별 토폴로지 측면에서 기존 시스템 대비 우위를 주장함.
- AMD EPYC 등은 단일 소켓 밀도에서 여전히 선두를 유지하고 있음.
Nvidia와 Oracle은 화요일 Oracle AI World에서 Oracle Cloud Infrastructure (OCI) Superclusters에 [Nvidia’s Vera Rubin NVL72] 랙과 [Vera CPUs]의 일반 사용 가능(general availability)을 발표했습니다. 이 발표는 지난주 Google Cloud가 Vera Rubin의 일반 사용 가능성을 발표한 직후 이루어진 것으로, Nvidia에게 두 개의 주요 하이퍼스케일러(hyperscaler)로부터 주목받았음을 의미합니다. 하지만 Oracle의 발표는 특히 OCI Superclusters에서 독립형 Vera 인스턴스를 언급했다는 점에서 흥미롭습니다. 저희는 향후 리뷰를 위해 Vera 서버로 수행한 몇 가지 벤치마크를 포함하여 이 칩의 성능 특성 중 일부를 강조하고자 했으나, 참고로 이러한 테스트는 OCI 인프라 위에서 진행된 것은 아닙니다.
최근 몇 주 동안 Neoclouds들은 Vera에 대한 기대감을 높여왔으며, Nscale, CoreWeave, Nebius 등 여러 곳에서 이미 인스턴스가 운영되고 있어, Vera가 GPU 중심의 AI 전문 클라우드(neoclouds)에 등장하는 것은 자연스러운 흐름입니다. 하지만 Oracle과 같은 하이퍼스케일러에서의 독립형 배포는 다른 신호를 보냅니다.
하이퍼스케일러들은 대규모 하드웨어 플릿을 유지하며, 때로는 neoclouds로부터 임대하기도 하지만, CPU의 초점은 주로 x86에 맞춰져 있으며, OCI Superclusters는 그렇지 않을 경우 Arm 기반 인스턴스로 Ampere Altra를 제공합니다. 이는 GPU 컴퓨팅과 관계없이 Vera를 x86 경쟁 구도에 배치하며, Nvidia가 하이퍼스케일 데이터 센터에서 처음으로 독립형 CPU 푸시를 감행한 것입니다.
Vera는 x86 방어 체계를 완전히 무너뜨리려는 것은 아니지만, 적어도 단독으로는 그렇지 않다. Nvidia의 CUDA를 만든 핵심 인물이자 Nvidia AI 인프라 구축의 얼굴인 Ian Buck은 칩이 공개된 지난 3월에, 전 세계가 단일한 88코어 SKU만으로는 서비스를 제공할 수 없다고 말했다. 하지만 Vera는 Oracle과 같은 하이퍼스케일러(hyperscalers)들이 미래 CPU 세대에서 확장할 수 있는 문을 열고 있다.
AMD와 Intel은 단일 소켓 밀도(single-socket density) 측면에서 여전히 선두를 유지하고 있으며, 이는 다음 세대에서만 확장될 예정이다. 예를 들어, AMD의 곧 출시될 [EPYC Venice CPUs]는 단일 소켓에 최대 512개의 스레드를 탑재할 수 있다. 그러나 Vera는 워크로드에 따라 달라지는 토폴로지(topology) 덕분에 몇 가지 독특한 이점을 제공하며, 이는 에이전트 AI 시대(agentic AI era)에서 점점 더 중요해지고 있는 요소들이다.
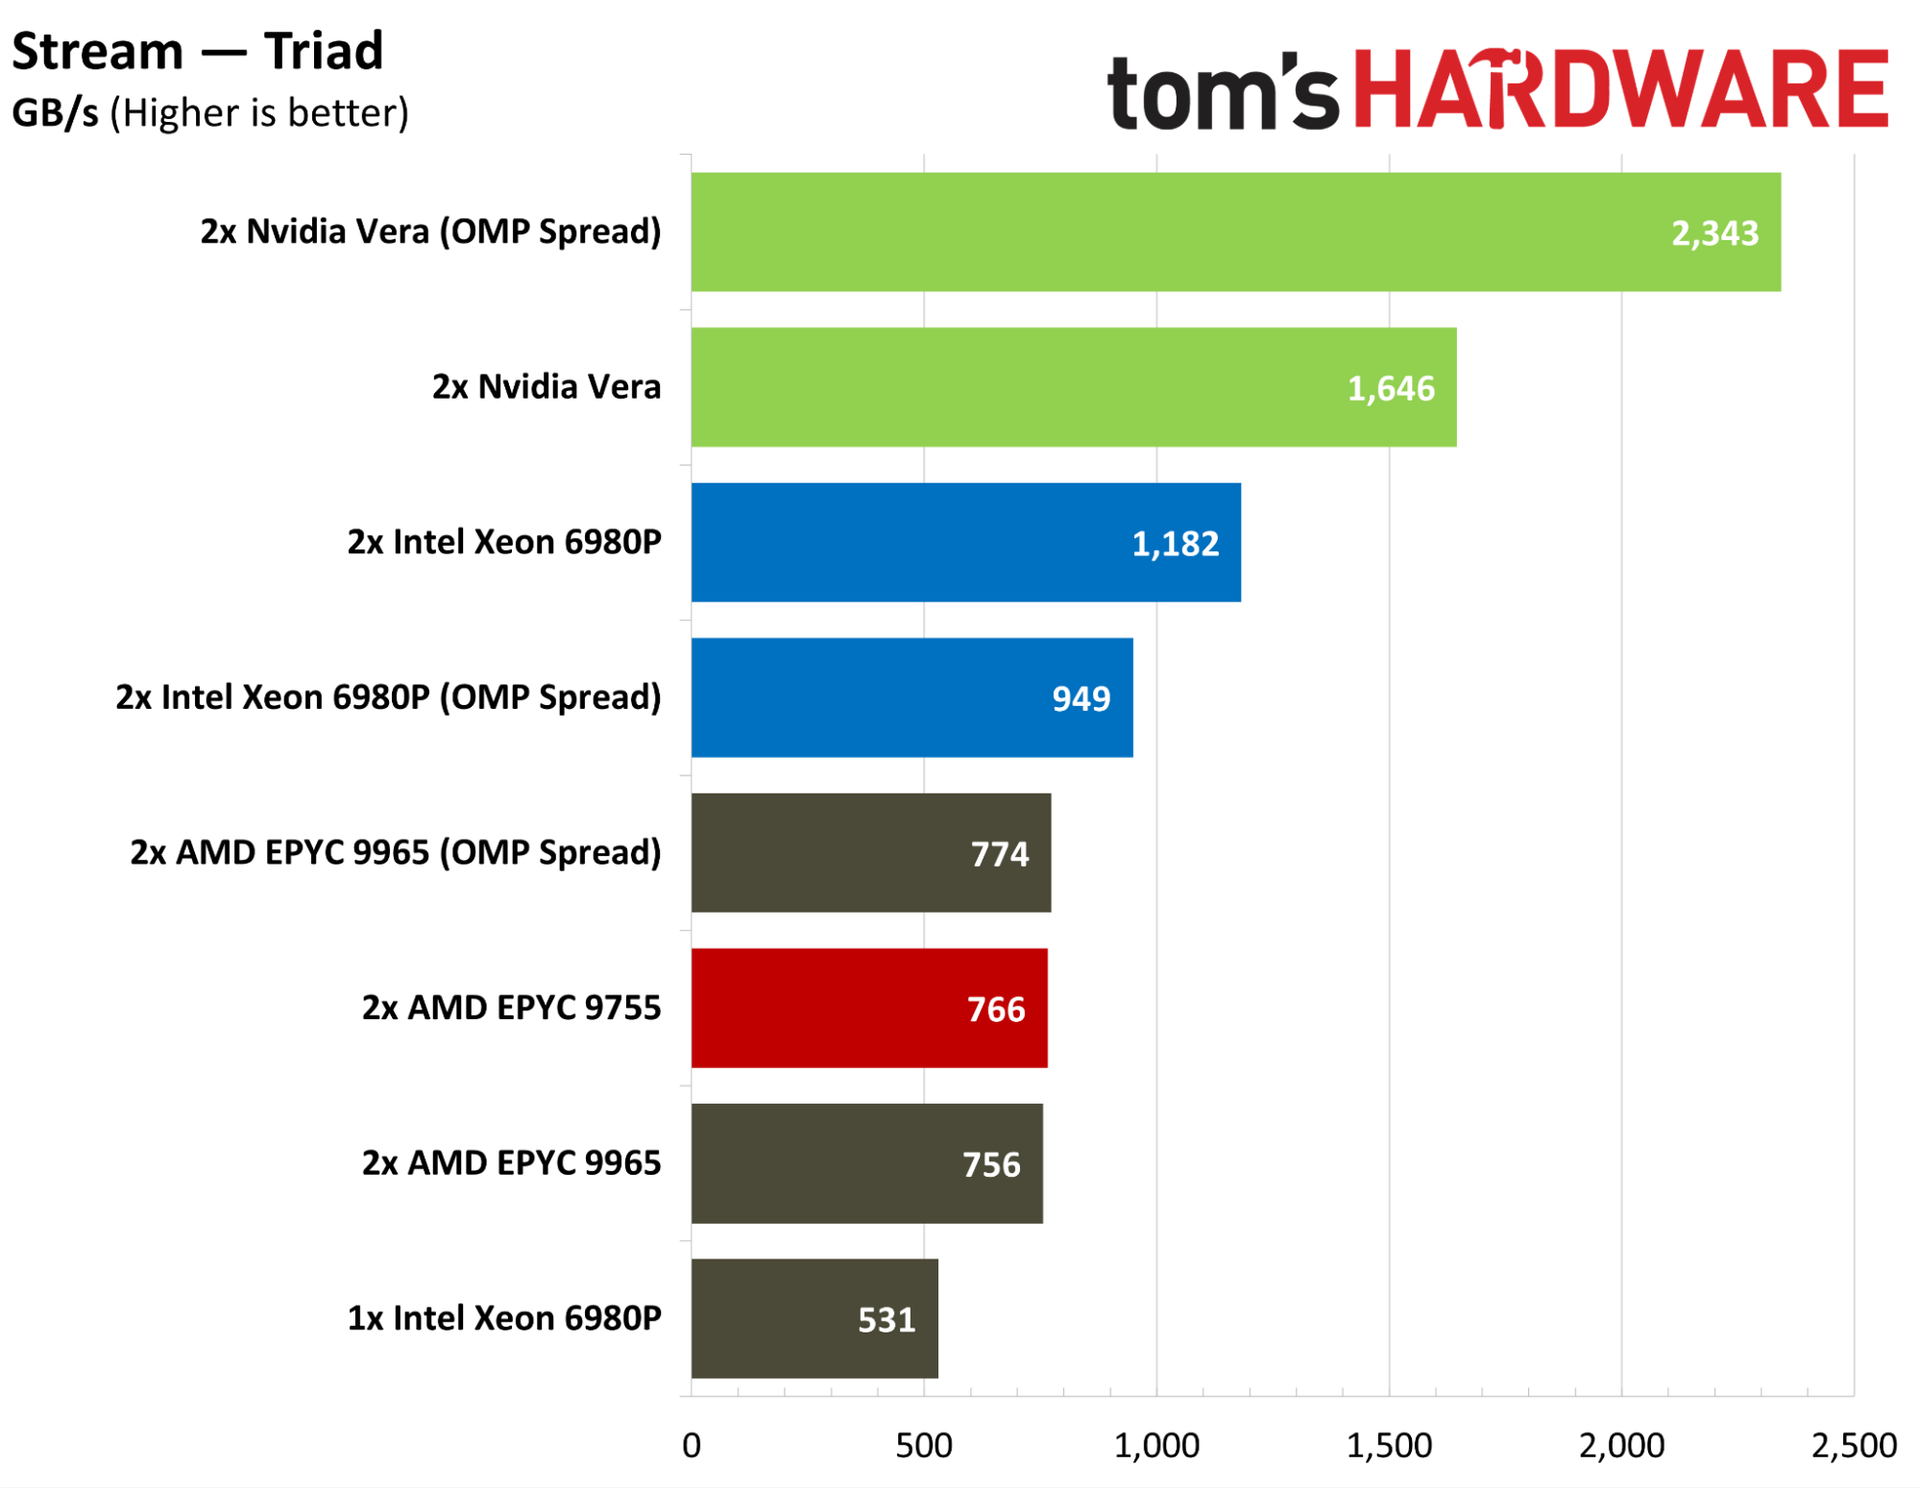
예를 들어 메모리 대역폭(Memory bandwidth)은 Vera의 강점 중 하나이며, 이는 단순한 마케팅 주장이 아니다. Nvidia는 메모리 시스템이 1.2 TB/s의 대역폭을 처리할 수 있다고 밝혔지만, 우리는 아래 테스트에서 이론적인 수치를 벗어난 Nvidia의 우위를 확인할 수 있다.
(이미지 출처: Tom's Hardware)
업계 표준인 Stream 벤치마크(benchmark)가 좋은 예시다. Nvidia는 LPDDR5X-9600을 사용하고 모놀리식 다이(monolithic die)와 캐싱용 분산 메시(distributed mesh)를 결합하여, 속도가 8,800 MT/s인 MRDIMM과 페어링되더라도 기존의 듀얼 Intel Xeon 6980P 시스템에서 사용 가능한 대역폭보다 두 배 이상을 제공한다. 여기서는 Stream 작업 중 가장 "부하가 큰(demanding)" 트라이애드(triad)를 보여주지만, Vera의 우위는 add, copy, scale 전반에 걸쳐 유사하다.
이 대역폭은 일부 에이전트 루프(agentic loops) 유형, 특히 대규모 데이터베이스 쿼리나 광범위한 문서 처리를 다루는 경우에 중요합니다. 또한 OpenMP의 "spread" 정책은 Vera의 메모리 대역폭에 엄청난 향상을 제공하는 것을 확인할 수 있습니다. AMD와 Intel 모두 중앙 집중식 메모리 제어 및 시스템 레벨 캐시를 유지하는 반면, Vera는 이를 다이 전체에 메시 형태로 분산합니다. 그 결과, 적어도 OpenMP가 적절하게 설정된 경우, 프로세스를 가능한 한 멀리 배치함으로써 훨씬 높은 메모리 대역폭을 얻게 됩니다.
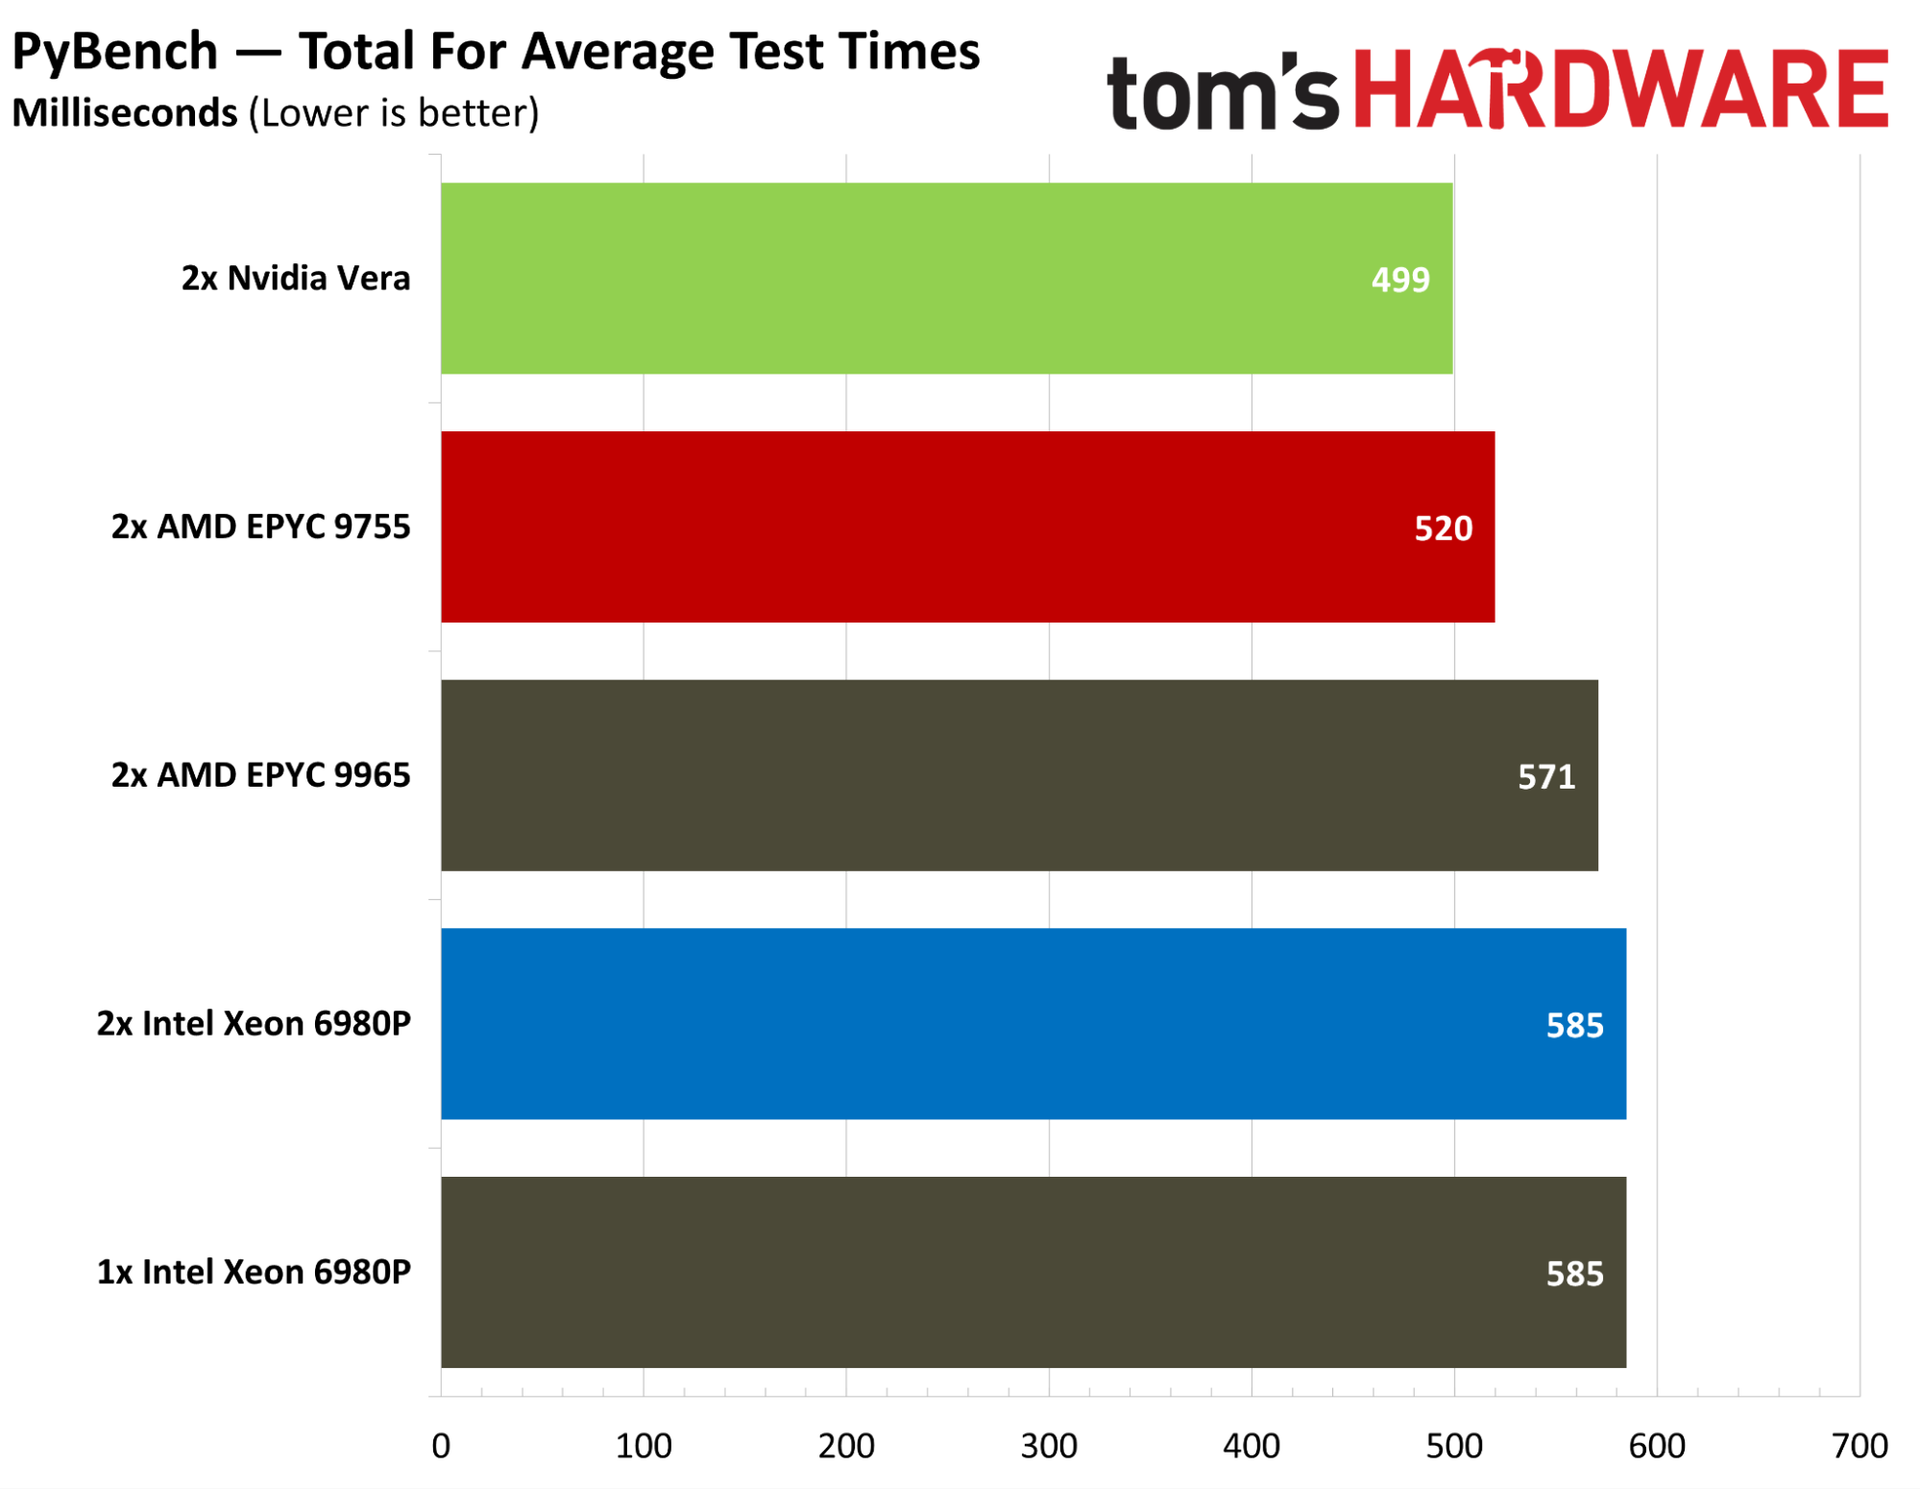
에이전트 AI의 또 다른 중요한 성능 요소는 Python입니다. 에이전트 분야는 확장되고 있지만, AI 소프트웨어 생태계의 많은 기반은 Python에 구축되어 있습니다. CrewAI나 LangGraph 같은 일반적인 에이전트 프레임워크는 Python으로 작성되었으며, Rust나 TypeScript와 같은 언어로 만들어지는 프레임워크가 늘어나고 있음에도 불구하고, Python 성능은 여전히 에이전트 루프에 매우 중요합니다.
(이미지 출처: Tom's Hardware)
그리고 놀랍지도 않게도, 이 부분 역시 Vera가 강점을 보이는 영역이며, 종이 위에서 훨씬 강력한 CPU들을 능가합니다. 인기 있는 에이전트 하네스들은 Python으로 구축되지만, PyTorch나 TensorFlow 같은 근본적인 AI 라이브러리를 포함하여 Python에서 실행되는 많은 애플리케이션들도 마찬가지입니다.
Nvidia의 에이전트 AI에 대한 초점은 우리가 살고 있는 시대를 고려할 때 타당해 보이지만, 전체를 놓칠 수 있습니다(miss the forest for the trees). Oracle이 Vera 독립형 인스턴스를 온라인화하면서 초점은 데이터 센터로 진입하는 Vera의 광범위한 영향으로 이동합니다. 에이전트 AI 워크로드의 특성을 나타내는 몇 가지 성능 측면이 있지만, 많은 에이전트 워크로드는 애초에 높은 동시성(high concurrency) 하에서 실행되는 일반적인 데이터 센터 워크로드입니다.
(이미지 출처: Tom's Hardware)
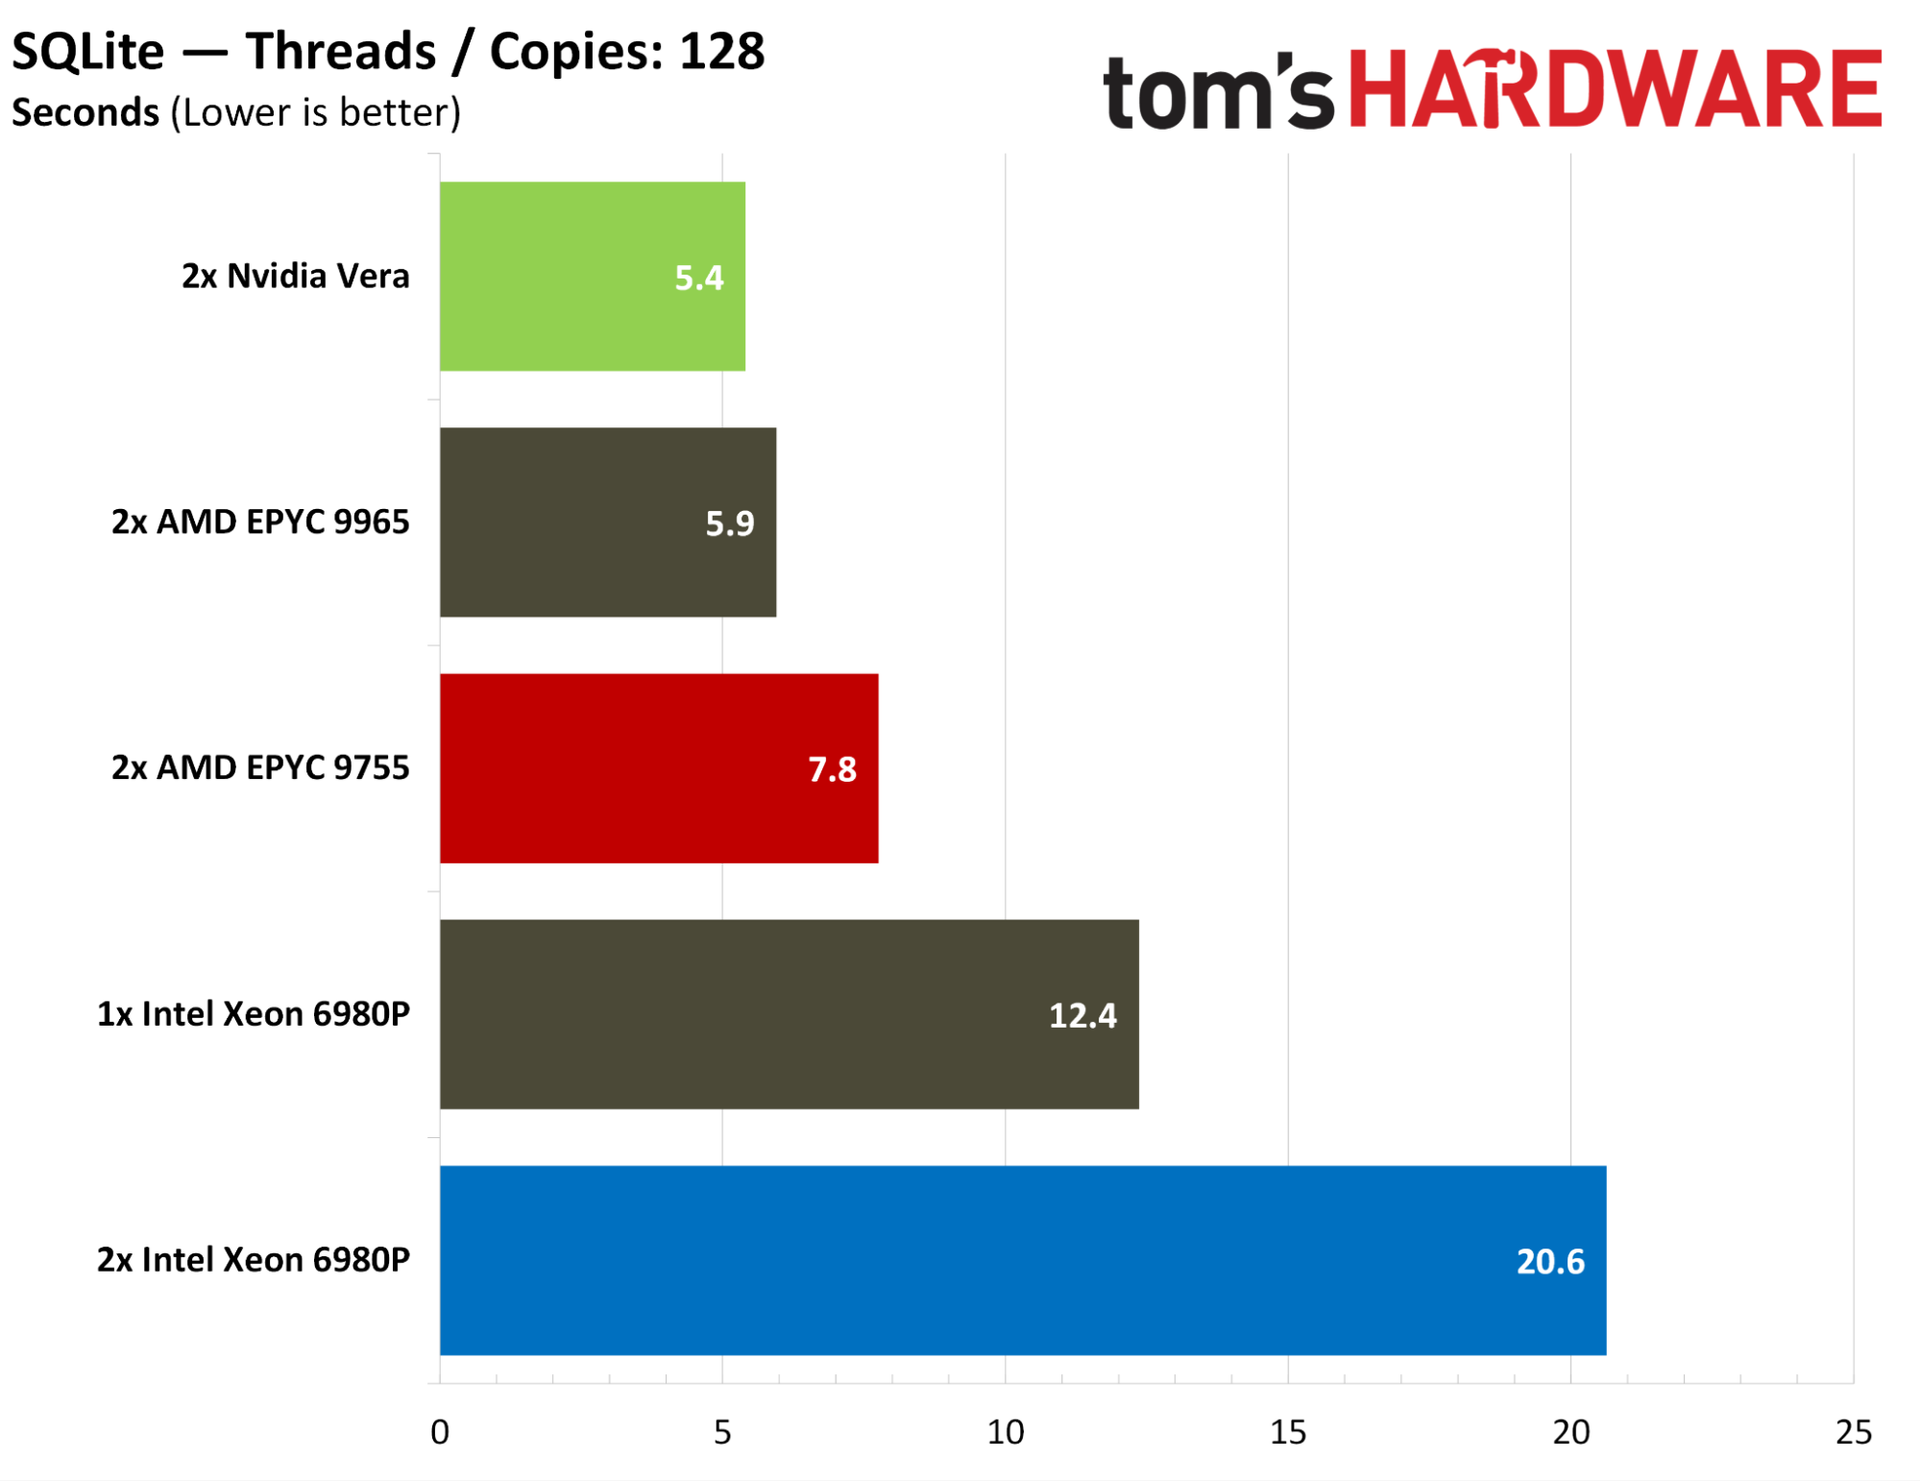
예를 들어, SQLite 성능은 로직, 사람 또는 AI 에이전트가 대규모 데이터베이스에 쿼리하는 모든 서버에게 중요합니다. Nvidia의 2세대 Scalable Coherency Fabric (SCF)는 Stream에서 확인했던 것처럼 실제 워크로드에서도 나타나며, 이러한 데이터베이스 쿼리는 시스템 전반의 데이터 이동에 크게 좌우됩니다.
이것이야말로 오라클의 발표 맥락에서 Vera가 매우 흥미로운 이유입니다. Nvidia에 따르면 Vera는 에이전트 AI(agentic AI)를 위해 구축된 CPU이지만, 일반 데이터 센터 워크로드와의 상호 작용(crosstalk) 또한 강력합니다. 단순히 Nvidia 가속기에 접근하기 위해 사용해야 하는 CPU가 아닙니다. 워크로드에 따라서는 x86 기반 시스템보다 더 나은 선택일 수도 있습니다.
궁극적으로 우리는 이러한 하이퍼스케일러의 고객들이 프로덕션 환경에서 Vera를 어떻게(혹은 어떻게 사용하지 않을지) 해야 할지 지켜봐야 합니다. Vera가 에이전트 AI 루프에서의 유용성을 입증했을 뿐만 아니라, 특정 범용 워크로드에서도 초기 잠재력을 보여주고 있습니다. 오라클의 독립형 배포는 Vera에 대한 수요가 Rubin GPU에만 국한되지 않음을 시사하는 신호입니다.
다만, 오라클은 다중 기가와트 규모의 배포를 진행할 때 모든 하이퍼스케일러가 그래야 하듯이 조심스럽게 접근하고 있습니다. 이 회사는 또한 Nvidia의 HGX NVL8을 제공하여 8개의 Rubin GPU를 클러스터로 구성하고, 이를 4TB DDR5 메모리를 갖춘 듀얼 64코어 Intel Xeon 6 호스트에 연결할 것이라고 밝혔습니다.
본 기사에서 공유된 Vera 테스트는 해당 칩으로 진행한 더 큰 규모의 벤치마킹 세션 중 일부이며, 테스트 환경의 기술적 세부 사항은 곧 발표될 리뷰에서 공유할 예정입니다. 전체 결과는 조만간 Tom’s Hardware에 게재될 것입니다.
AI 자동 생성 콘텐츠
본 콘텐츠는 Tom's Hardware의 원문을 AI가 자동으로 요약·번역·분석한 것입니다. 원 저작권은 원저작자에게 있으며, 정확한 내용은 반드시 원문을 확인해 주세요.
원문 바로가기