
WikiBench를 사용한 OpenWiki 평가
요약
OpenWiki는 코드베이스 문서를 생성/유지하는 오픈소스 에이전트이며, WikiBench는 이 에이전트를 평가하기 위해 구축된 벤치마크입니다. WikiBench는 근본적인 코드베이스 기반 질문을 사용하여 위키의 품질과 실제 도움 정도를 측정합니다. 특히 '리더 에이전트'와 LLM 심사위원(judges)을 활용하여 답변의 정확성과 출처 기반 여부를 엄격하게 평가하는 것이 특징입니다.
핵심 포인트
- WikiBench는 코드베이스 질문으로 위키를 평가하는 벤치마크입니다.
- 에이전트, 환경, 검증기로 구성된 Harbor 프레임워크에서 실행됩니다.
- 검증기는 '리더 에이전트'가 위키를 사용해 답변을 시도하며 정확성을 측정합니다.
- LLM 심사위원(judges)을 통해 답변의 사실 존재 여부와 출처 기반 여부를 점수화합니다.
OpenWiki는 코드베이스 문서를 생성하고 유지하는 데 사용되는 오픈 소스 에이전트입니다. 저희가 OpenWiki를 개선하면서 두 가지를 측정할 필요가 생겼습니다:
- 위키가 실제로 코딩 에이전트에 도움이 되는가?
- 우리가 진행하는 변경 사항들이 OpenWiki를 더 좋게 만들고 있는가?
저희는 이 두 질문에 답하기 위해 WikiBench를 구축했습니다. WikiBench는 근본적인 코드베이스에 기반한 질문들을 사용하여 생성된 위키를 평가합니다. 이렇게 함으로써 우리는 서로 다른 위키 간의 품질 차이뿐만 아니라, 해당 위키가 실제로 얼마나 도움이 되는지를 측정할 수 있습니다.
WikiBench는 Harbor에서 실행됩니다
저희는 에이전트를 장기 실행 작업에 대해 평가하는 프레임워크인 Harbor에서 이 벤치마크를 구축했습니다. Harbor 작업은 세 가지 구성 요소를 갖습니다:
환경(The environment): 작업의 컨텍스트를 제공합니다.
에이전트(The agent): 작업을 수행합니다.
검증기(The verifier): 결과를 평가합니다.
WikiBench에서 환경은 고정된 커밋으로 체크아웃된 저장소입니다. 에이전트는 해당 저장소에 OpenWiki 초기화를 실행하고 초기 위키를 생성합니다. 검증기는 이 저장소에 대한 질문들을 사용하여 생성된 위키를 평가합니다.
검증기(The verifier)
검증기는 WikiBench에서 가장 흥미로운 부분 중 하나입니다. 위키를 평가하기 위해, 검증기는 '리더 에이전트(reader agent)'를 사용합니다. 이 '리더 에이전트'는 위키(때로는 소스 코드와 함께, 때로는 자체적으로)를 사용하여 근본적인 저장소에 대한 질문에 답하려고 시도합니다. 이를 통해 우리는 위키가 실제 작업에서 얼마나 도움이 되는지를 기준으로 평가할 수 있습니다.
효율적으로 WikiBench를 구축하기 위해, 저희는 질문들을 자동으로 생성합니다. 저희는 두 가지 유형의 질문을 생성합니다: '커버리지(coverage)' 질문과 '검색(retrieval)' 질문입니다. 이를 위해, 저희는 고정된 커밋의 저장소를 검사하고 패키지나 서브시스템 같은 더 큰 주제별 영역들을 식별합니다.
'커버리지' 질문은 공유 템플릿을 사용합니다:
[area]가 어떻게 작동하는지에 변경 사항을 적용해야 합니다. 이 저장소에서 그것이 어디에 위치하며, 건드리기 전에 제가 알아야 할 상호작용 요소는 무엇이며, 무언가를 망가뜨리지 않았는지 어떻게 확인할 수 있을까요?
“Retrieval” 질문들은 특정 행동을 중심으로 개별적으로 작성됩니다:
Deep Agents 실행에서 도구 호출(tool call)은 컨텍스트에 담기에는 너무 많은 출력을 반환합니다. 모델이 실제로 그것 대신 무엇을 받는지, 실제 내용은 어디로 가는지, 그리고 이 경로가 전체 대화가 너무 커질 때 발생하는 것과 어떻게 다른지 궁금합니다?
우리가 생성하는 각 질문에 대해 답변의 루브릭(rubric) 역할을 하는 JSON 파일을 만듭니다. 이 JSON 파일에는 답변이 포함해야 할 사실들의 목록이 있습니다.
답변을 채점할 시간이 되면, 우리는 일련의 LLM 심사위원(LLM judges)을 사용하여 JSON 파일의 각 사실을 점수화합니다. 한 심사위원은 그 사실이 답변에 존재하는지 확인합니다. 두 번째 심사위원은 생성된 사실이 에이전트가 읽은 페이지에 근거하는지 살펴봅니다. 이를 통해 에이전트가 정확하고 근거 있는 방식으로 응답할 때만 점수를 부여하도록 합니다.
그런 다음 각 답변은 그 질문을 맞힌 사실들을 기반으로 종합 점수를 받습니다. 예를 들어, 하나의 답변이 5개의 사실을 예상했는데 3개만 제공했다면, 0.6점의 점수를 받게 됩니다.
이것이 우리가 단일 질문을 채점한 방식입니다. 전체 위키를 채점하기 위해, 우리는 모든 답변의 평균 점수를 계산했습니다.
검증기(verifier)를 이러한 방식으로 구성하는 이점은, ‘리더 에이전트(reader agent)’에게 원본 소스(raw source)를 제공하고 질문에 직접 답하도록 요청함으로써 위키가 도움이 되는지 여부를 확인할 수 있게 해준다는 것입니다. 따라서 이 벤치마크는 단순히 두 가지 다른 버전의 위키를 비교하는 것 이상의 유용성을 가집니다.
결과
우리는 다양한 하네스(harnesses)와 모델에 걸쳐 위키를 테스트하기 위해 이 벤치마크를 사용합니다. 몇 가지 실험을 진행했습니다:
다른 하네스 벤치마킹
첫 번째 실행에서는 세 가지 하네스, 즉 Bare DeepAgents, OpenWiki 0.2.5, 그리고 OpenWiki 0.3.0을 비교했습니다. 세 하네스 모두 동일한 모델(Luna)을 사용했습니다.
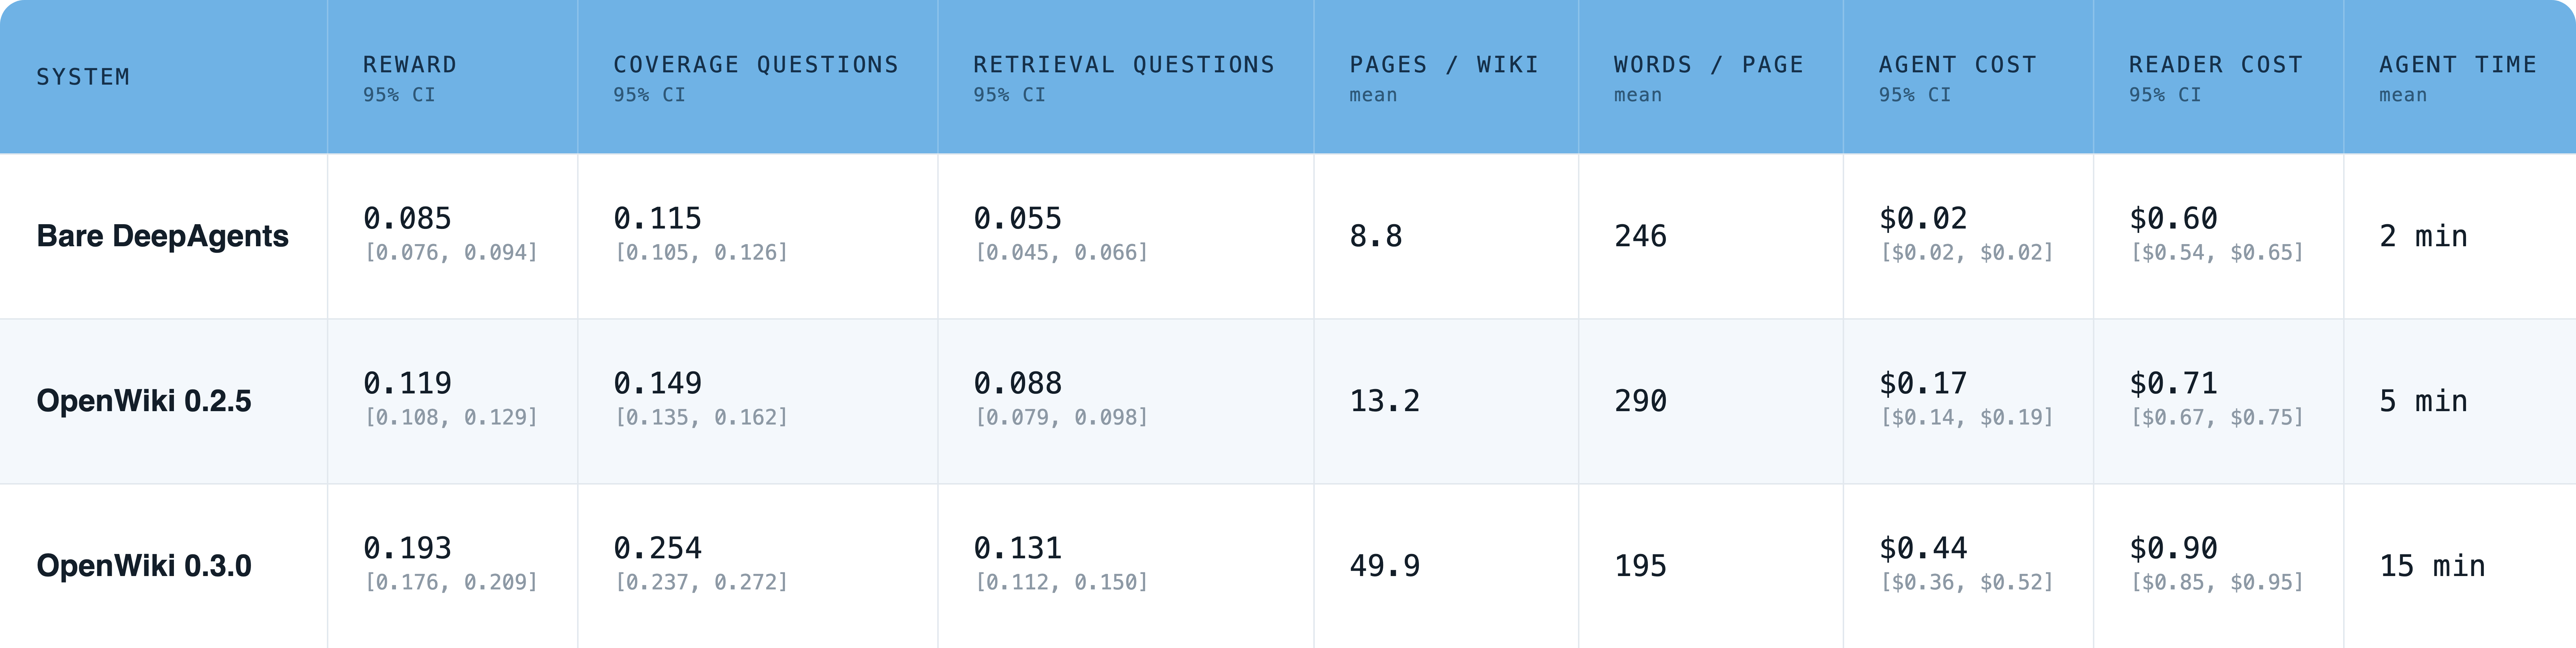
이 순위는 저희의 예상과 일치합니다. Deep Agents는 위키 생성에 전혀 맞춰지지 않은 범용 에이전트 하네스이기 때문에, 가장 낮은 성능을 보인 것은 놀라운 일이 아닙니다. OpenWiki 0.3.0은 위키를 생성하는 방식에서 상당한 개선을 이루었기 때문에, 이전 버전보다 더 좋은 성능을 보인 것 역시 놀랍지 않습니다.
구체적으로, OpenWiki 0.3.0은 시스템 프롬프트와 전용 서브 에이전트를 통해 플래닝(planning)에 더 중점을 두었습니다. 저희는 이것이 더 광범위한 위키를 생성할 것이라고 예상했습니다. 개선의 대부분은 '커버리지(coverage)' 질문에서 더 나은 성능을 보인 데서 왔으며, 이는 그 가설과 일치합니다. 페이지 작성 능력 향상에 덜 집중했기 때문에, '검색(retrieval)' 질문에서의 성능 향상은 적었습니다.
다양한 모델의 벤치마킹
다음으로 OpenWiki 0.3.0을 여러 모델로 실행해 보았습니다.
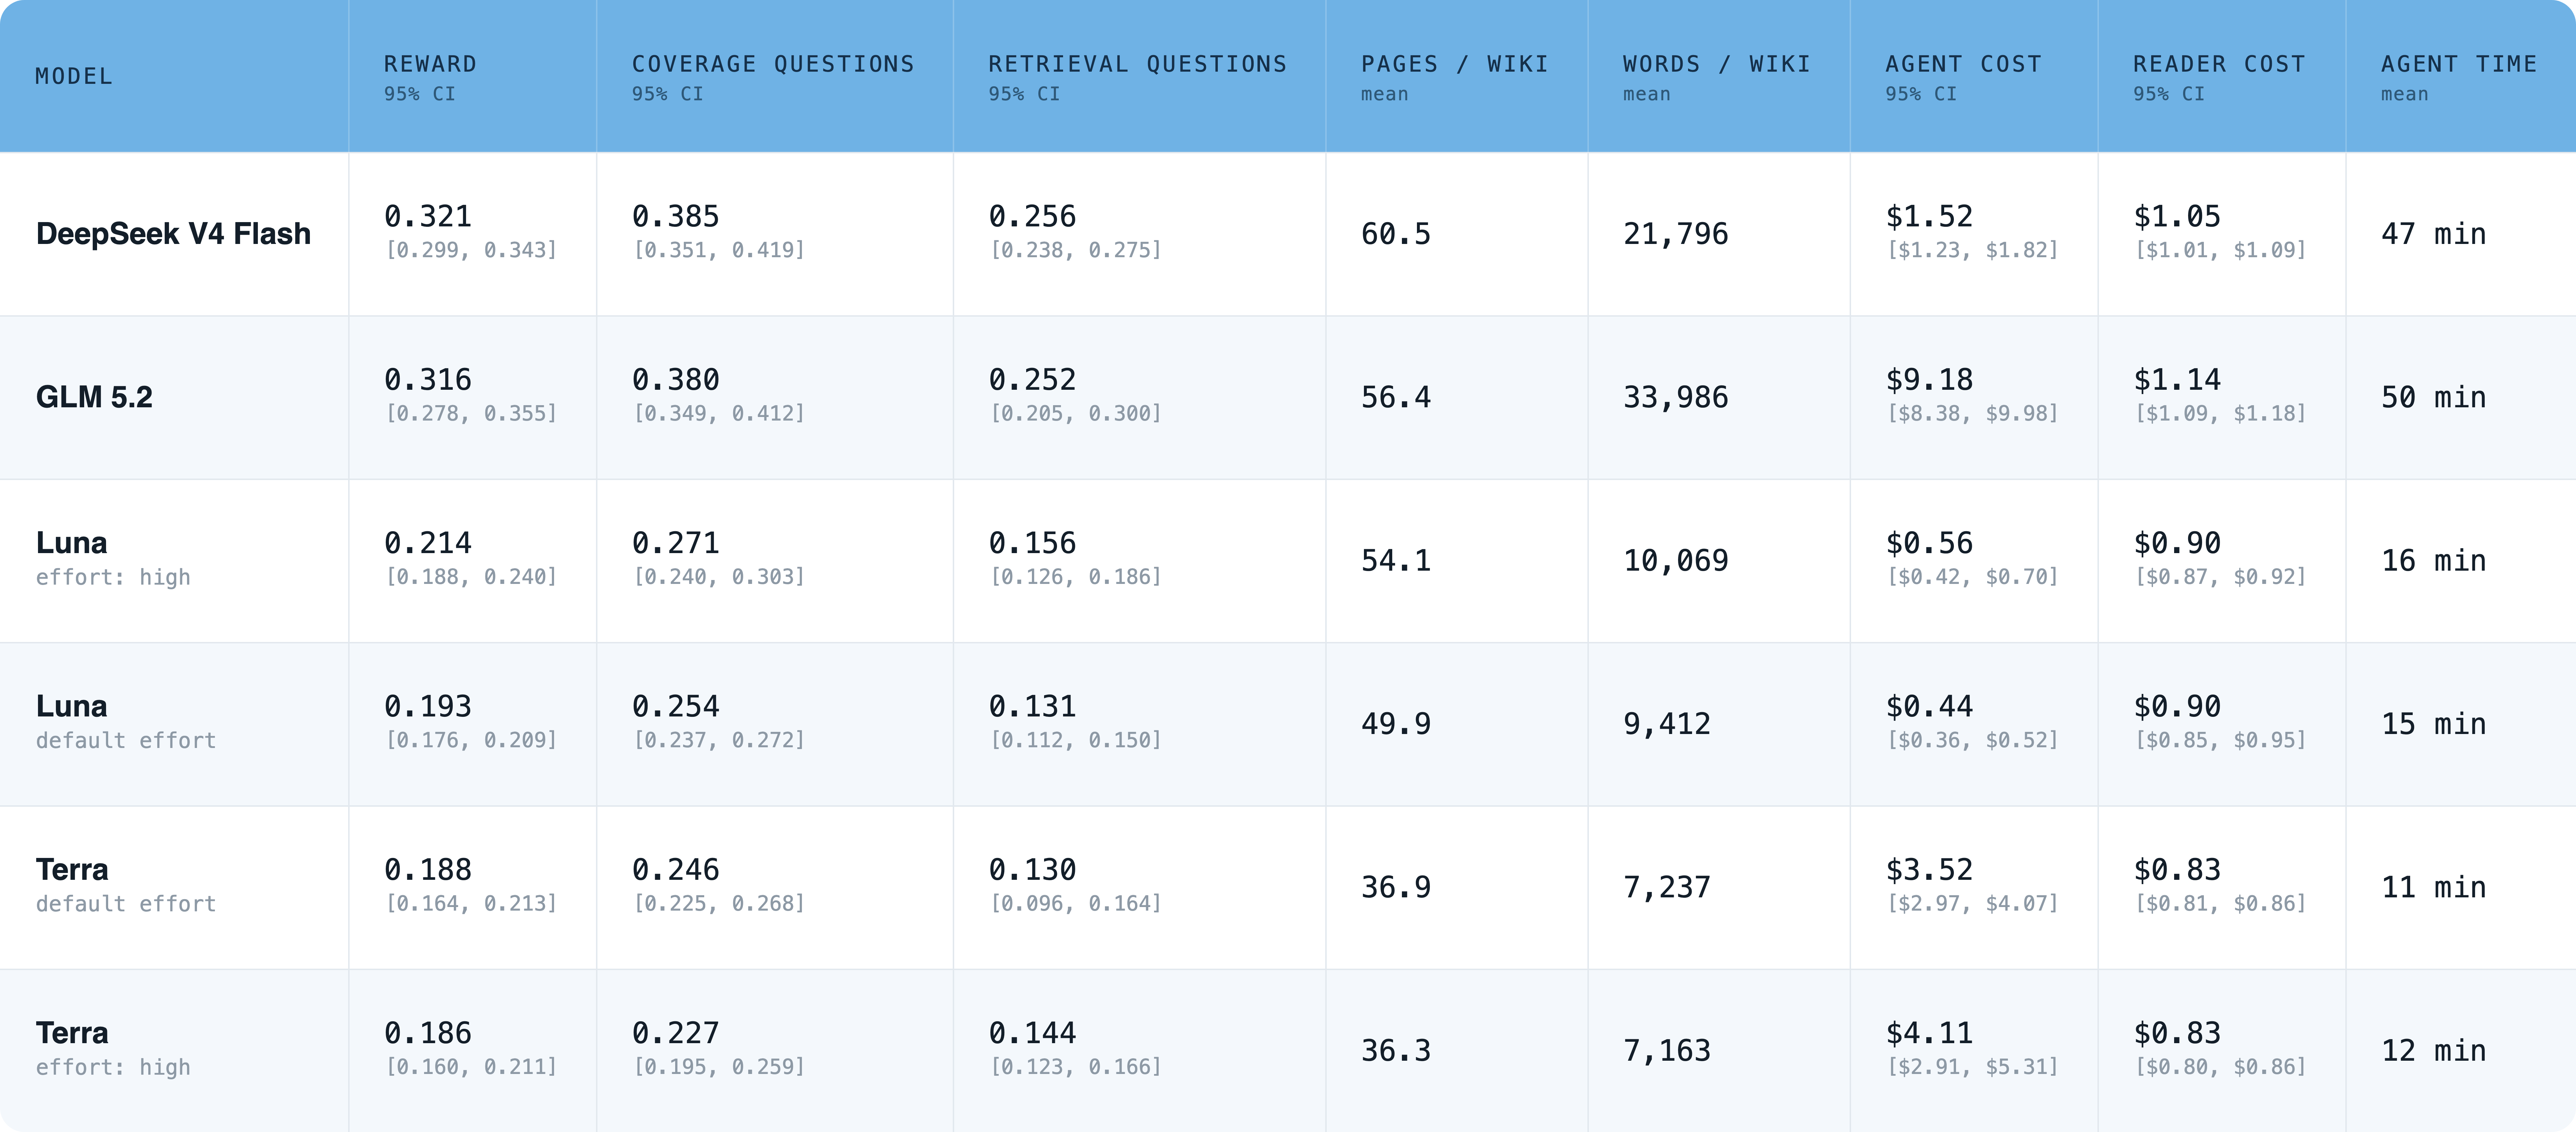
DeepSeek Flash와 GLM 5.2 모두 매우 좋은 성능을 보이지만, 비용 측면은 다릅니다. DeepSeek Flash는 GLM 5.2의 약 6분의 1 수준의 비용입니다.
전반적으로 이러한 여러 실행 간에는 성능뿐만 아니라 비용($9.18 for GLM 5.2, $0.44 for Luna)과 시간(Terra의 경우 11분, GLM 5.2의 경우 50분) 면에서도 큰 차이가 있습니다.
이 추가적인 비용과 시간은 어디에 쓰일까요? 에이전트가 무엇을 하는지 살펴보면 감을 잡기 시작할 수 있습니다:
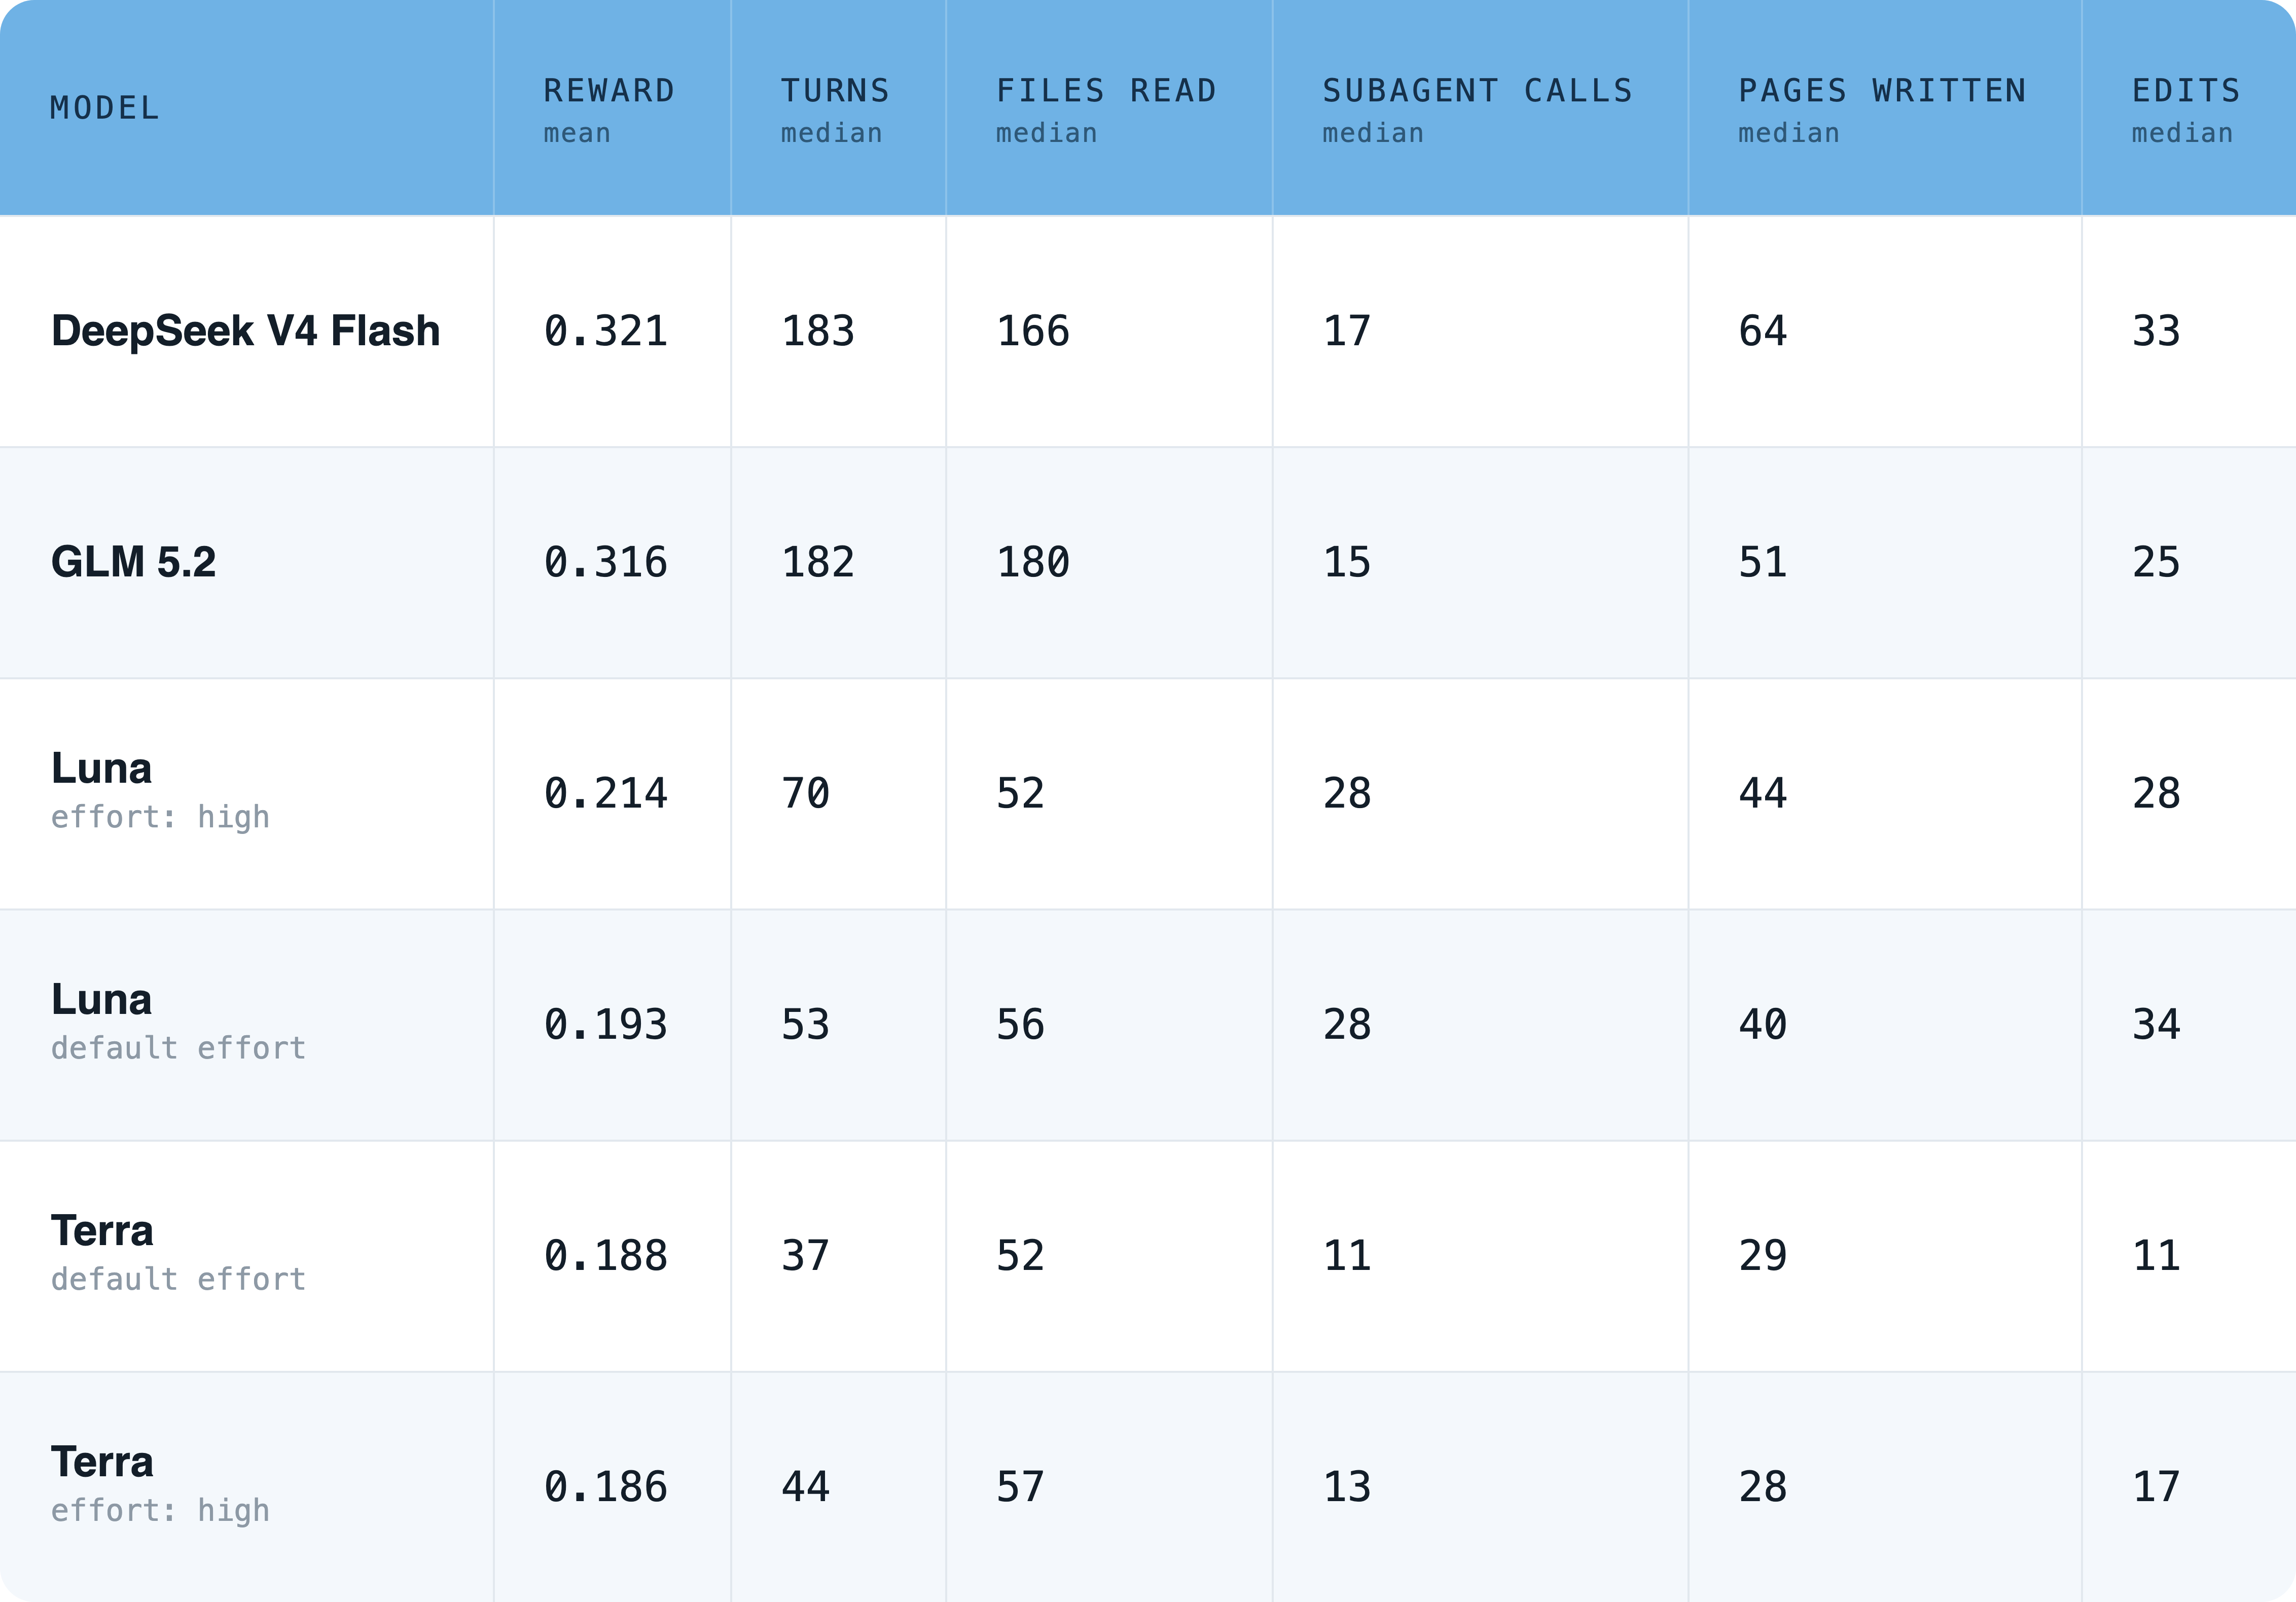
Luna와 비교했을 때, DeepSeek와 GLM은 파일은 약 3배 더 많이 읽지만 페이지는 겨우 1.2~1.5배만 작성합니다. 이들의 추가적인 작업은 더 많은 출력을 생성하는 것이 아니라 저장소(repository)를 이해하는 데 주로 사용됩니다.
위키가 도움이 될까요?
저희는 또한 위키가 실제로 더 나은 답변을 얻는 데 도움이 되는지 알고 싶었습니다. 이를 이해하기 위해 리더 에이전트(reader agent, 즉 검증기 verifier)를 세 가지 다른 설정에서 실행했습니다.
- 리더 에이전트는 위키에만 접근 가능
- 리더 에이전트는 소스(raw code)에만 접근 가능
- 리더 에이전트는 둘 다에 접근 가능
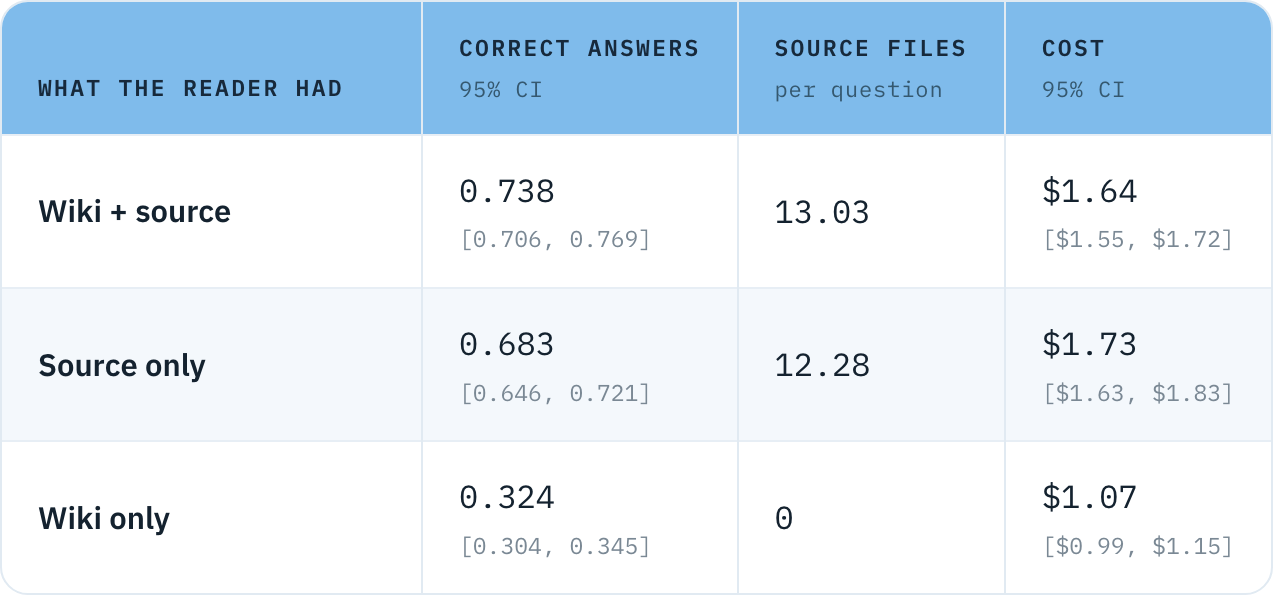
위키와 소스를 결합하면 소스만 사용하는 것보다 낮은 비용으로 가장 높은 평균 점수를 산출합니다. 위키는 인덱스 역할을 합니다. 독자가 저장소(repository)를 처음부터 재구성할 필요 없이 시작점을 제공해 줍니다.
위키만 사용했을 때는 성능이 훨씬 떨어졌는데, 이는 위키가 소스를 대체하기보다는 가이드로 작동하는 것이 가장 좋다는 것을 시사합니다. 함께 사용한 위키와 소스는 독자가 더 정확하고 비용 효율적으로 만들었습니다.
OpenWiki 개선 방안
WikiBench는 '리더 에이전트(reader agent)'를 사용하여 질문에 답하려고 시도함으로써 작동합니다. 특정 작업에서 위키의 점수는 그 리더 에이전트가 얼마나 잘 수행하는지에 달려 있습니다.
이러한 설정을 사용하여, 우리는 위키가 순수 소스 코드만 사용하는 에이전트에 비해 에이전트가 질문에 더 좋고 효율적으로 답할 수 있도록 한다는 것을 보여줍니다. 또한 다양한 하네스(harnesses)와 모델을 평가할 수 있게 해줍니다. 저희는 이를 OpenWiki 개발 방향을 안내하는 데 적극적으로 활용하고 있습니다.
AI 자동 생성 콘텐츠
본 콘텐츠는 LangChain Blog의 원문을 AI가 자동으로 요약·번역·분석한 것입니다. 원 저작권은 원저작자에게 있으며, 정확한 내용은 반드시 원문을 확인해 주세요.
원문 바로가기