"Venice" Epycs는 이전 AMD 서버 CPU와 비교하여 어느 정도인가
지난 10년 동안, AMD의 Epyc 프로세서 각 세대는 더욱 복잡해졌으며, 이러한 복잡성은 회사의 최고의 기술자들이 기이해서가 아니라, 현대 데이터센터에서 늘어나는 워크로드의 수와 종류에 대응하기 위해 실제적인 엔지니어링 구분이 필요하기 때문에 활용되고 있습니다.
오늘 출시된 "Venice" 세대 Epyc 칩은 AMD가 두 가지 다른 서버 소켓, 두 가지 다른 I/O 다이(die), 그리고 두 가지 다른 컴퓨트 다이를 투입하여 제품 라인을 구축하고 있습니다. 이 초기 제품군은 8코어부터 256코어까지, 130와트에서 600와트까지, $700에서 $14,904까지의 가격대(회사로부터 1,000개 단위 트레이로 구매 시)를 아우르는 초기 31가지의 서로 다른 CPU를 포함합니다.
저희는 이미 AMD가 Venice Epycs가 오늘날의 워크로드 요구 사항을 어떻게 해결한다고 믿는지, 그리고 X86 경쟁사인 Intel과 Arm 집단으로부터의 대안들과 어떻게 비교되는지에 대해 매우 일반적인 방식으로 논의했습니다. 이 기사는 Venice SKU 스택을 따라가며, 최고 사양(top bin) 부품과 중간 사양(middle bin) 부품이 이전 5세대 Epycs 및 2008년 11월 대불황(Great Recession) 초기에 출시된 기준점인 "Shanghai" 쿼드코어 Opteron 프로세서와 어떻게 비교되는지 살펴봅니다.
주요 사양 및 속도
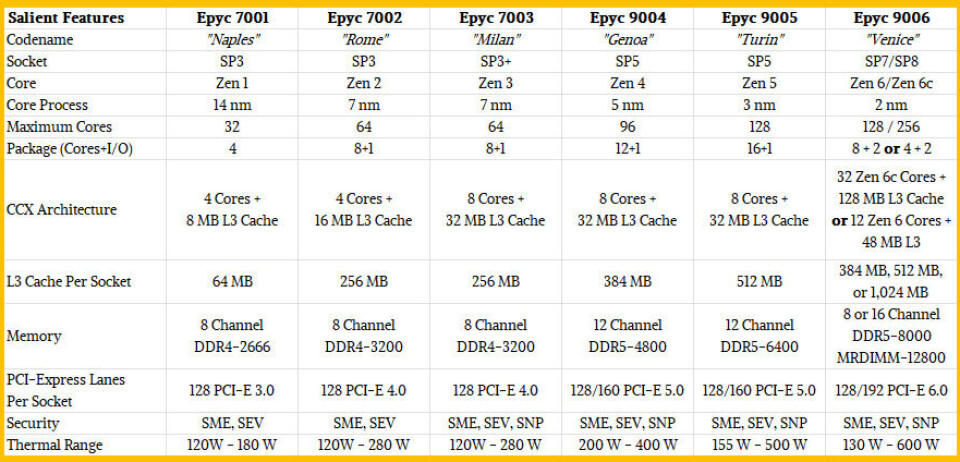
SKU에 대해 깊이 파고들기 전에, 약간의 기술적인 내용을 이야기해야 합니다.
AMD는 이전 'Genoa' 및 'Turin' 세대에서 수행했던 것처럼 Venice 라인 내에서 Zen 6과 Zen 6c 설계를 별개의 프로세서 패밀리로 유지하기보다는, 캐시 계층 구조(cache hierarchies)를 동일하게 유지하면서 두 코어 내부의 스케줄러(schedulers)를 다르게 최적화하여 Zen 6과 Zen 6 코어 간의 구분을 모호하게 만들기로 결정했습니다. 이전 Turin Zen 5c 코어에서는 AMD가 각 CCD의 L3 캐시를 절반으로 줄였고, 이는 더 많은 코어를 다이에 배치할 수 있게 했지만, 동시에 캐시에 민감한 워크로드(cache-sensitive workloads)에서의 성능을 저하시키기도 했습니다. 이러한 새로운 접근 방식은 합리적으로 보입니다. 48MB의 L3 캐시를 가진 12코어 CCD와 128MB의 L3 캐시를 가진 32코어 CCD 모두 Taiwan Semiconductor Manufacturing Co.에서 제작한 2 나노미터 공정으로 새겨졌습니다.
또 다른 큰 변화는 두 가지의 서로 다른 소켓이 존재하며, 이 두 종류의 CCD가 양쪽 소켓에서 일부 CPU SKU(Stock Keeping Unit)를 만드는 데 사용된다는 점입니다.
현재 출시되고 있으며 더 강력한 Venice 프로세서를 구현하는 SP7 소켓은 I/O 다이 한 쌍을 갖추고 있어, 12.8 GT/sec로 작동하는 MRDIMM을 사용하여 최대 1.6 TB/sec의 대역폭을 제공할 수 있는 16채널의 DDR5 메모리와, 8 GT/sec로 작동하는 일반 RDIMM을 사용하여 1 TB/sec의 대역폭을 제공합니다. 각 채널에는 하나의 메모리 스틱이 장착될 수 있으며 용량은 최대 512GB에 달할 수 있습니다. (만약 그것을 감당할 수 있다고 생각한다면 말입니다...) SP7 소켓은 각각 64 Gb/sec로 작동하는 96개의 PCI-Express 6.0 레인과 16 Gb/sec로 작동하는 8개의 PCI-Express 4.0 레인을 갖추고 있습니다. 두 개의 소켓 구성에서는 총 128개의 PCI-Express 6.0 레인과 16개의 PCI-Express 4.0 레인이 외부 세계에 노출되며, 이 PCI-Express 레인 중 64개는 CPU 소켓 쌍 사이에 NUMA 링크를 만드는 데 사용됩니다.
이 SP7 소켓 I/O(및 메모리) 다이는 Turin 세대의 I/O(및 메모리) 다이와 마찬가지로 TSMC의 6나노미터 공정을 사용하여 제작되었지만, 이는 명확히 다른 설계입니다. 과거에 지적했듯이, I/O는 컴퓨팅만큼 축소되지 않기 때문에 가장 진보된 공정을 사용하여 I/O 및 기타 신호(signaling) 칩렛을 식각하는 것에는 큰 이점이 없습니다. 이러한 축소는 신호를 더 어렵게 만들고 비용도 더 많이 발생시키므로, 제조 공정 측면에서 보수적으로 접근할 만한 두 가지 좋은 이유가 됩니다.
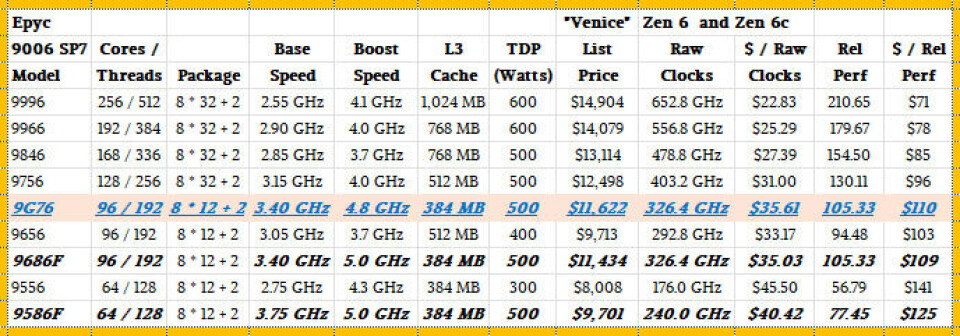
SP7 소켓에 장착되는 아홉 개의 Venice 칩은 다음과 같습니다:
과거 Epyc 프로세서에서와 마찬가지로, 우리는 정수 워크로드(integer workloads)에 대해 코어 수, 클럭 속도, 그리고 세대 간의 클럭당 명령어 증가분(Instructions per Clock, IPC)을 기반으로 Venice 칩의 상대적 성능을 계산했습니다. AMD에 따르면, 이번에는 Zen 6 코어가 Zen 5 코어와 비교했을 때 동일한 클럭 속도에서 코어당 평균 성능 향상률이 20퍼센트입니다. 이는 상당히 큰 도약이며, 매 사이클마다 코어가 더 많은 작업을 수행하도록 새로운 방법을 끊임없이 고안해내는 코어 설계자들의 증거라 할 수 있습니다.
참고로, 위 SP7 소켓 프로세서 표에서 파란색 글자와 빨간 배경으로 강조된 Epyc 9G76 프로세서는 AMD가 Helion AI 랙을 위해 특별히 만든 제품입니다. 이는 HPC(고성능 컴퓨팅) 워크로드를 목표로 하는 Epyc 9686F 칩과 크게 다르지 않지만, 저는 이들이 다르게 할인될 수 있도록 별개의 제품이라고 생각합니다. 하이퍼스케일러와 클라우드 빌더들은 구매하는 물량이 많다는 점을 고려할 때, 전 세계의 HPC 센터들보다 더 나은 거래를 할 것이 분명합니다.
SP8 소켓으로 넘어가 보겠습니다. 이 소켓은 보다 주류(mainstream)의 Venice Epyc 프로세서에 사용됩니다. 따라서 소켓당 DDR5 메모리 채널이 8개(I/O 다이당 4개)이며, 용량 증대를 위해 채널당 두 개의 DIMM을 인터리빙(interleaving) 방식으로 구성했습니다. SP8 소켓의 I/O 다이는 128개의 PCI-Express 6.0 레인과 8개의 추가 PCI-Express 4.0 레인을 갖추고 있습니다. 즉, 메모리 대역폭은 절반이지만 I/O는 33% 더 많습니다. 두 소켓의 NUMA(Non-Uniform Memory Access) 구성에서는 NUMA 일관성(coherency)을 위해 64개의 PCI-Express 6.0 레인이 사용되며, 외부 세계에는 192개 레인과 여기에 추가된 16개의 PCI-Express 4.0 보너스 레인이 노출됩니다. (물론 이는 I/O 다이 한 쌍에 대한 수치입니다.)
AMD는 저희에게 SP8 I/O(및 메모리) 다이가 예상했던 대로 TSMC 6 나노미터 공정으로 식각되었다고 확인해 주었습니다.
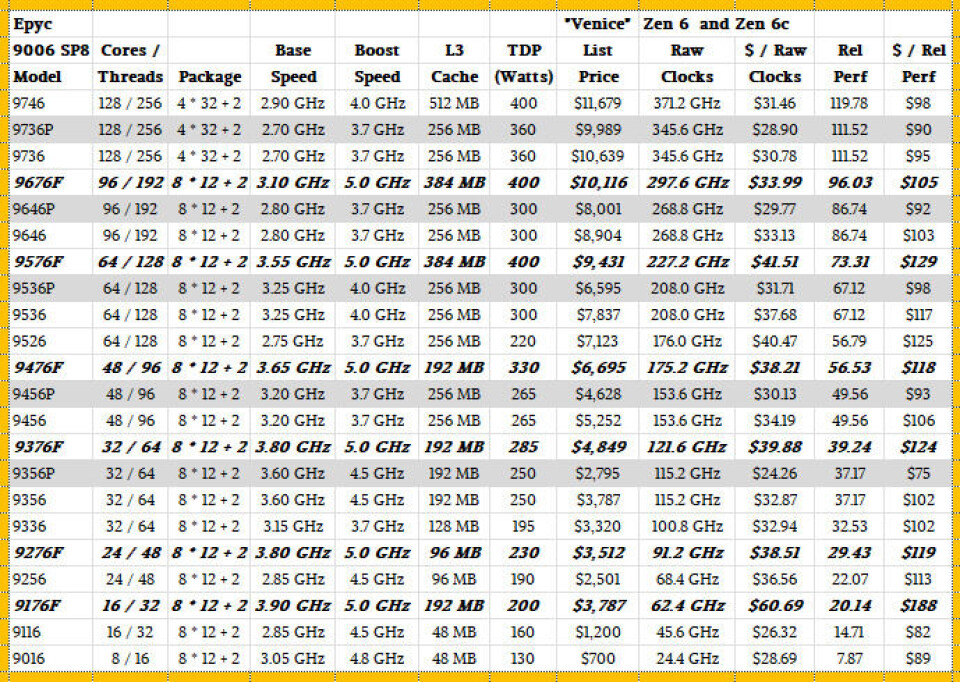
SP8 소켓용 Venice Epyc CPU 22가지 변형 모델은 다음과 같습니다:
SP8 소켓 버전의 Venice CPU는 내년이 되어서야 출하될 예정이며, AMD가 공식적으로 밝힌 바는 2027년 상반기 중 언제든 출시된다는 것이지만, 제 추측으로는 연초에 비교적 일찍 나올 것 같습니다.
비교는 전혀 나쁘지 않다
이것을 제외하고, Epyc 라인업의 역사 전반에 걸쳐 최고 등급(top bin) 부품과 중간 등급(middle bin) 부품들이 성능 및 가격 대비 성능 면에서 어떻게 구성되어 있는지 살펴보겠습니다. 그리고 늘 그렇듯이 모든 비교는 Shanghai Opteron 라인을 기준으로 삼고 있습니다. 이 모델들은 AMD가 출하했던 마지막 경쟁력 있는 Opteron이었으며, 인텔이 AMD의 숙제를 많이 베껴서 마침내 괜찮은 멀티코어 칩을 출시했을 무렵(대불황 시작 시점)과 AMD가 Opteron 문제에 직면했던 시기에 나온 제품들입니다.
AMD에게는 안 좋은 시기였고, 인텔에게는 좋은 시기였습니다. 하지만 그것은 이미 오래된 역사이며, 이번에는 AMD가 악용할 틈을 남겨두지 않고 있습니다. AMD는 계속해서 더 좋고 더 나은 서버 CPU를 만들고 매 분기마다 조금씩 시장 점유율을 잠식하고 있기 때문입니다. 솔직히 말해, 인텔이 얻는 시장 점유율을 유지할 수 있다는 것이 놀랍습니다.
최고 등급 부품부터 살펴보겠습니다:
이 비교에서는 AMD가 때때로 출시했던 특수 HPC(고성능 컴퓨팅) 변종은 무시했습니다. 이는 주파수 최적화용 F 표기와 패키지에 추가 수직 캐시를 갖춘 X 표기로 표시됩니다. 따라서 이것들은 최고 등급 표준 부품입니다.
또한, 저는 Venice 라인업의 SP7 및 SP8 변종 모두에 대해 최고 등급 부품을 비교에 포함했습니다.
위의 차트에서 즉시 명확하게 알 수 있듯이, 최고 등급 Epyc의 상대적 성능은 “Naples” Epyc 7001 시리즈부터 SP8 소켓을 사용한 Venice 9006 시리즈에 이르기까지 대체로 선형적으로 확장되었습니다. 코어 256개를 가진 SP7 소켓은 성능 향상 측면에서 완전히 이례적이며, 눈으로 직접 볼 수 있듯이 전체적인 성능을 기하급수적인 규모로 끌어올립니다.
또한 즉시 눈에 띄는 것은 첫 세대 Naples 프로세서의 가성비가 Shanghai Opteron과 비교하여 얼마나 개선되었는지입니다. 하지만 시간 간격이 9년이라는 것을 기억해야 합니다. 이 기간 동안 무어의 법칙(Moore’s Law)은 여전히 성능을 향상시키고 경제성을 개선할 수 있는 기회를 제공했습니다. (Shanghai Opteron은 TSMC 45 나노미터 공정으로 제작되었으며, Naples 칩은 GlobalFoundries 14 나노미터 공정을 사용했습니다.)
또한, AMD가 2세대 Epyc인 “Rome”을 통해 가격 대비 성능(price/performance) 면에서 얼마나 공격적으로 움직였는지도 알 수 있습니다. 이 시기에 회사는 처음으로 별도의 컴퓨팅 타일과 외부 세계에 연결되는 I/O 다이로 구성하는 방식을 도입했습니다.
Milan Epycs에서는 최상급 부품의 성능이 올라갔지만, 달러당 가치 개선은 둔화되었고, 4세대 “Genoa” 최상급 부품에서도 같은 현상이 발생했습니다. 하지만 Turin과 이제 Venice 부품을 통해 AMD는 다시 한번 가격 대비 성능 한계를 끌어올리고 있으며, 특히 처리량 중심의 SP7 변형 모델을 선택하는 고객들에게 큰 이점을 제공하고 있습니다. AMD는 코어 수는 절반이지만 약간 더 빠르게 작동하는 Venice의 SP8 버전에 대해 약간의 프리미엄을 부과하고 있습니다.
클럭 속도는 공정 축소 이후 코어 수를 늘리는 것보다 열을 더 빠르게 발생시키기 때문에 항상 프리미엄이 붙습니다.
그 결과, Epyc 9996 SP7 부품은 Opteron 2393 SE보다 190배 더 강력한 성능(oomph)을 가지며, 이와 같은 성능을 단위당 비용으로 14.9배 낮게 제공합니다. AMD에게는 이 칩이 12.8배 저렴하게 들면서도 기업들이 서버 통합 및 에이전트형 AI(agentic AI), 전통적인 고성능 컴퓨팅(HPC) 워크로드에 사용하기 위해 기꺼이 지불할 의향이 있다는 장점이 있습니다.
Venice Epyc 9746 SP8 칩의 경우, Shanghai Opteron 2393 SE 대비 성능 점프는 108.2배이며, 가성비(bang for the buck)는 10.8배 개선되었고, 칩당 가격은 10배 더 높습니다.
AMD의 중급 서버 CPU 곡선은 일부 면에서 약간 평평하지만 유사해 보입니다:
하지만 다시 한번, Venice가 제공하는 달러당 가치는 이전 Epyc CPU 세대와 비교했을 때 훨씬 뛰어납니다.
AMD는 인텔에 대한 압박을 유지하는 것만으로 끝나지 않습니다. 더욱 강화하고 있습니다. 그리고 현재 서버 시장의 절반을 차지하는 하이퍼스케일러 및 클라우드 구축 기업들 사이에서 부상하는 Arm 생태계와 경쟁하려면 그렇게 해야 합니다.