SQL 데이터베이스 벡터 검색
.NET 10
Minimal API
Blazor
블레이저 웹 앱(Blazor Web App)과 미니멀 API(Minimal API)를 사용하여 Azure SQL Database 또는 SQL Server 2025의 네이티브 VECTOR 타입을 이용한 RAG (검색 증강 생성, Retrieval Augmented Generation) 및 벡터 검색을 수행합니다. 또한 Azure OpenAI와 Microsoft Agent Framework도 사용합니다.
목차
개요 (Overview)
이 애플리케이션을 통해 다음 작업을 수행할 수 있습니다:
- 문서 로드 (PDF, DOCX, TXT, MD)
- 임베딩(embeddings) 생성 및 Azure SQL Database 또는 SQL Server 2025에 벡터로 저장
- Azure OpenAI와 Microsoft Agent Framework 에이전트를 사용한 시맨틱 검색 및 RAG 수행
- Blazor Web App을 통한 상호 작용 또는 Minimal API를 통한 프로그래밍 방식 접근
네이티브 VECTOR 타입은 Azure SQL Database와 SQL Server 2025 모두에서 사용할 수 있으므로 외부 벡터 저장소가 필요하지 않습니다.
임베딩 및 채팅 완료는 Microsoft Agent Framework로 조정됩니다. 이 애플리케이션은 문서 가져오기를 위한 임베딩 워크플로우, 대화 컨텍스트를 이용해 후속 질문을 재작성하는 리포메이션 에이전트(reformulation agent), 그리고 SQL 벡터 검색 컨텍스트 제공자에 연결된 RAG 에이전트를 사용합니다.
스크린샷 (Screenshots)
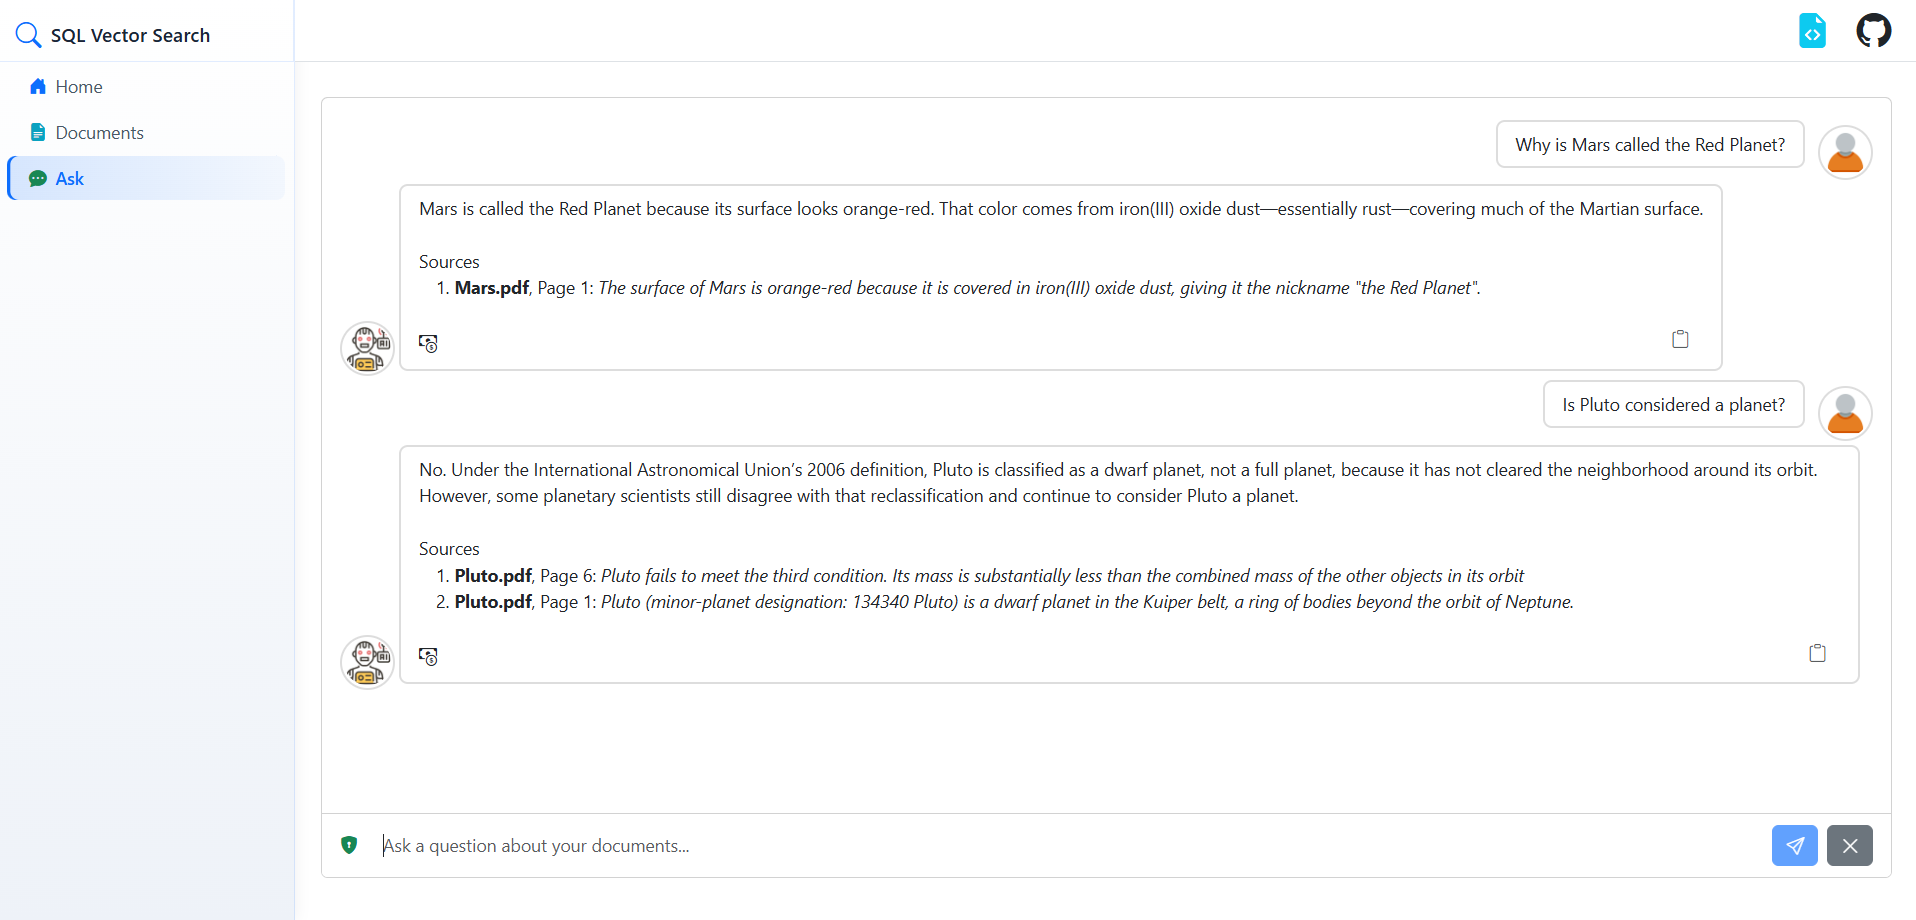
웹 앱 (Web App)
SQL Database Vector Search Web App
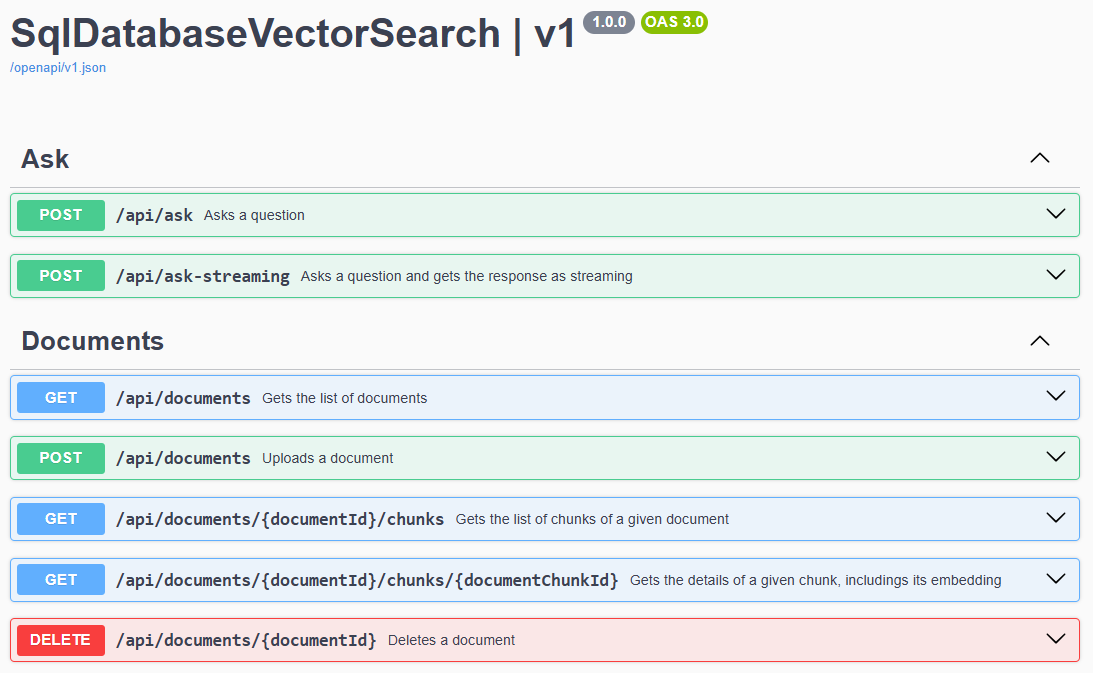
웹 API (Web API)
SQL Database Vector Search API
필수 요구 사항
- .NET 10 SDK
- 다음 중 하나를 지원하며, 둘 다 네이티브
VECTOR 타입을 지원해야 합니다:
- Azure OpenAI 리소스 및 API 키
프로젝트 구조
SqlDatabaseVectorSearch/ - 메인 Blazor 웹 앱 및 API
Components/ - Blazor UI 컴포넌트ContentDecoders/ - PDF, DOCX, TXT 및 MD 파일에서 텍스트를 추출하는 디코더Data/ - EF Core 컨텍스트, 마이그레이션 및 엔티티Endpoints/ - 최소 API(Minimal API) 엔드포인트Extensions/ - 확장 메서드 및 헬퍼Models/ - 요청 및 응답 모델Services/ - 비즈니스 로직 및 통합 서비스Settings/ - 구성 클래스TextChunkers/ - 텍스트 분할 유틸리티Validations/ - 요청 검증기Workflows/ - 문서 가져오기 및 임베딩 생성을 위한 Microsoft Agent Framework 워크플로우 실행기
설정
-
저장소 클론하기
git clone https://github.com/marcominerva/SqlDatabaseVectorSearch.git
-
데이터베이스 및 OpenAI 설정 구성
SqlDatabaseVectorSearch/appsettings.json 파일을 편집하고 연결 문자열(Azure SQL Database 또는 SQL Server 2025)과 OpenAI 설정을 지정합니다.- 중요:
ChatCompletion 및 Embedding 모두에 대한 ModelId 값은 Microsoft.ML.Tokenizers를 통한 토큰 계산에만 사용되며, 서비스로의 실제 호출에는 Deployment 값이 사용됩니다. 따라서 ModelId는 토크나이저 라이브러리가 인식하는 모델 이름(예: gpt-5, gpt-4.1, gpt-4o, gpt-4, gpt-3.5-turbo, text-embedding-3-small, text-embedding-3-large, text-embedding-ada-002)이어야 하며, 이는 일반적으로 Azure OpenAI에서 선택한 배포 이름과 다릅니다. 모델이 인식되지 않으면, TiktokenTokenizer.CreateForModel은 시작 시 오류를 발생시키므로, 이 경우 동일한 인코딩을 공유하는 가장 가까운 지원 모델로 폴백(fall back)해야 합니다 (예: 최신 GPT 모델의 경우 gpt-4o).
- 축소(shortening)가 적용된 임베딩 모델(예:
text-embedding-3-small 또는 text-embedding-3-large)을 사용하는 경우, 해당에 맞게 Dimensions 속성을 설정합니다. text-embedding-3-large의 경우, 1998 이하의 값을 지정해야 합니다.
- 벡터(VECTOR) 크기를 변경하는 경우,
[ApplicationDbContext] (SqlDatabaseVectorSearch/Data/ApplicationDbContext.cs)와 [Initial Migration] (SqlDatabaseVectorSearch/Data/Migrations/00000000000000_Initial.cs) 둘 다를 업데이트해야 합니다.
-
애플리케이션 실행
dotnet run --project SqlDatabaseVectorSearch/SqlDatabaseVectorSearch.csproj
-
웹 앱 접속
https://localhost:7025 (또는 콘솔에 표시된 포트)로 이동합니다.
지원되는 기능
- Microsoft Agent Framework 오케스트레이션: 문서 가져오기는 워크플로우로 구현되며, 질문 재구성(question reformulation)과 RAG는 에이전트로 구현됩니다.
- 질문 재구성을 갖춘 대화 기록: 재구성 에이전트는 벡터 검색을 수행하기 전에 대화 컨텍스트를 사용하여 각 질문을 다시 작성합니다.
- SQL 벡터 검색 컨텍스트 제공자: RAG 에이전트는 네이티브 VECTOR 검색을 기반으로 하는
TextSearchProvider를 통해 Azure SQL Database 또는 SQL Server 2025에서 관련 청크를 받습니다.
- 토큰 사용량 정보: Blazor 채팅 페이지와 API 응답은 재구성 및 최종 답변 생성을 위한 토큰 사용량을 노출합니다.
- 응답 스트리밍: Blazor 채팅 페이지와
/api/ask-streaming 엔드포인트는 도착하는 대로 토큰을 추가하며 답변을 스트리밍합니다.
- 마크다운 출처 인용: 인용은 소스 이름, 사용 가능한 경우 페이지 번호, 그리고 짧은 근거 발췌문이 포함된 지역화된 출처 섹션으로 생성된 마크다운 답변에 직접 포함됩니다.
사용 방법 (How to Use)
- 웹 앱 (Web App): Blazor 인터페이스를 사용하여 문서를 관리하고 인덱싱된 콘텐츠로 채팅합니다. 이 채팅 페이지는 답변을 스트리밍하고, 토큰 사용량을 표시하며, 대화 초기화를 지원하고, 마크다운 답변의 일부로 출처 인용을 렌더링합니다.
- API:
POST /api/documents를 통해 문서를 가져오고, POST /api/ask 또는 POST /api/ask-streaming을 통해 질문합니다.
작동 방식 (How it works)
- 문서는 API를 통해 업로드되고
EmbeddingWorkflow에 의해 처리됩니다.
- 이 워크플로우는 업로드된 파일을 텍스트로 변환하고, 청킹(chunking)하며, 임베딩을 생성한 다음, Azure SQL Database 또는 SQL Server 2025에 문서, 청크, 그리고 벡터 임베딩을 저장합니다.
- 질문이 들어오면,
RagAgent (실제 RAG 에이전트를 감싸는 KnowledgeSearchAgent)가 내부적으로 ReformulationAgent에게 위임하는데, 이 에이전트는 현재 대화 컨텍스트를 사용하여 질문을 재작성할 수 있습니다. 이러한 방식으로 단일 에이전트 실행만으로 재작성과 답변을 모두 수행하며, 대화 세션은 재작성된 질문과 관련 답변만을 계속 저장합니다.
RagAgent는 TextSearchProvider를 통해 관련 SQL 벡터 검색 결과를 받고, 제공된 컨텍스트만을 사용하여 답변합니다.- 출처(Sources)는 별도의 JSON 컬렉션으로 반환되지 않습니다. 마크다운(Markdown) 형식의 답변에 직접 포맷되어 포함됩니다.
예시 API 요청
POST /api/ask
Content-Type: application/json

...
예시 API 응답
{
  "conversationId": "3d0bd178-499d-433a-b2bc-c35e488d9e2c",
  "originalQuestion": "why is mars called the red planet?",
...
응답 스트리밍 작동 방식
/api/ask-streaming 엔드포인트를 사용할 때, 답변은 Server-Sent Events로 스트리밍됩니다. 각 이벤트는 streamState 값과 일치하는 이름을 가지며, data 필드에 JSON Response 페이로드를 포함합니다. 형식은 다음과 같습니다:
이벤트 흐름에 대한 설명
- 첫 번째 이벤트는 다음과 같은 특징을 가집니다:
- SSE(Server-Sent Events) 이벤트 이름은
Start입니다.
- streamState 속성은
Start로 설정됩니다.
- 질문과 그 재구성된 질문(reformulatedQuestion)을 포함합니다 (요청되지 않은 경우, reformulatedQuestion은 originalQuestion과 동일합니다).
- tokenUsage 섹션에는 재구성을 위해 사용된 토큰 정보가 담깁니다.
- 다음으로, 실제 답변에 필요한 만큼의
Delta 이벤트가 있습니다:
- 각 이벤트는 answer 속성에 토큰 또는 생성된 텍스트 청크를 포함합니다.
- streamState 속성은
Delta로 설정됩니다.
- originalQuestion, reformulatedQuestion, 그리고 tokenUsage는 항상
null입니다.
- 스트림은
End 이벤트가 수신되면 종료됩니다. 이 이벤트에는 최종 답변에 대한 토큰 사용 정보가 포함되어 있습니다.
- 소스(Sources)는 Markdown 형식의 답변 텍스트에 포함됩니다.
제한 사항 및 FAQ (Limitations & FAQ)
- 데이터베이스: Azure SQL Database 또는 SQL Server 2025(또는 그 이후 버전). 두 데이터베이스 모두 이 샘플에서 사용되는 네이티브
VECTOR 타입을 제공합니다.
- VECTOR 컬럼 크기: 최대 허용 크기는 1998입니다.
text-embedding-3-large의 경우, Dimensions를 ≤ 1998로 설정해야 합니다.
- 지원 파일 형식: PDF, DOCX, TXT, MD.
- 알려진 문제 (Known Issues): Issues를 참조하십시오.
기여 (Contributing)
기여는 환영합니다! 이슈(issue)나 풀 리퀘스트(pull request)를 열어주십시오. 주요 변경 사항의 경우, 먼저 이슈를 통해 논의해 주십시오.
라이선스 (License)
이 프로젝트는 MIT 라이선스(MIT License)에 따라 라이선스가 부여되었습니다. 자세한 내용은 [LICENSE] 파일을 참조하십시오.
[!NOTE]
순수 SQL을 사용하고 싶다면, sql 브랜치를 확인해 보세요.