
Salience Labs, 실리콘 포토닉스 광 스위치로 AI 확장 추진
요약
Salience Labs는 실리콘 포토닉스 기반의 광 회로 스위치를 개발하여 고성능 컴퓨팅 클러스터의 네트워크 확장(scale up)에 활용하고자 합니다. 기존 MEMS나 LCoS 방식보다 훨씬 빠른 온칩 도파관 스위칭 기술을 통해 AI 데이터센터 백본 네트워크의 성능 향상을 목표로 합니다. 이 기술은 상변화 광전자공학 연구를 기반으로 하며, 32포트부터 대규모 AI 네트워킹을 위한 128포트 OCS 제공을 목표하고 있습니다.
핵심 포인트
- 실리콘 포토닉스 기반의 광 스위치로 AI 클러스터 네트워크 확장 추진
- 기존 MEMS/LCoS 방식보다 빠른 온칩 도파관 스위칭 기술 사용 예상
- 상변화 광전자공학 연구를 바탕으로 차세대 OCS 개발 중
- 32포트부터 128포트까지 대규모 AI 네트워킹 솔루션 목표
CONNECT
Salience Labs, 실리콘 포토닉스 광 스위치로 AI 확장 추진
광 회로 스위치는 새로운 기술은 아니며, 지난 25년 동안 네트워크 기술 연구실과 통신 산업에서 사용되어 왔습니다. 하지만 Salience Labs에 따르면, 이제 이 기술이 고성능 컴퓨팅 클러스터의 규모 확장(scale up) 네트워크 영역으로 진입할 때가 왔습니다. Salience Labs는 실리콘 포토닉스 기술만을 기반으로 하는 광 회로 스위치를 구축했는데, 이는 아이러니하게도 포토닉스 컴퓨팅 플랫폼을 구현하려는 첨단 연구에서 파생된 것입니다.
현재 상용화되어 사용되는 광 스위치 유형은 두 가지가 있습니다. 하나는 마이크로-전기-기계 시스템(MEMS) 거울 기술에 기반하며, 이 방식에서는 작은 기계식 거울 배열이 회전하여 광섬유 케이블 가닥들을 연결하는 회로를 만듭니다. Google은 자체 TPU AI 가속기 시스템의 첫 세대 3개를 직접 하드와이어링했습니다(Nvidia가 지금까지 노드 스케일 및 랙 스케일 GPU 디자인으로 한 것처럼). 하지만 2015년 이후 지난 네 세대에 걸쳐 Google은 'Apollo' OCS의 일부인 'Palomar' MEMS 장치를 TPU 클러스터의 백본으로 사용해 왔습니다. 이 OCS는 클러스터를 실시간으로 재구성할 수 있게 하며, 최대 9,216개의 TPU를 일관된 메모리 클러스터로 연결하는 것도 가능하게 합니다.
다양한 광학 기술을 위해 Nvidia와 파트너십을 맺은 Lumentum 역시 MEMS 기반 OCS 장비를 판매하며 통신 분야 외 AI 데이터센터에서도 야심을 품고 있습니다. 상용화된 또 다른 OCS 기술은 리퀴드 크리스탈 온 실리콘(LCoS)으로, 이 접근 방식은 Coherent가 자사의 OCS 장치에서 사용합니다. 놀랍지 않게도 Nvidia 역시 다양한 광학 기술을 위해 Coherent와 파트너십을 맺었습니다.
Salience Labs는 구체적인 스위칭 메커니즘을 공개하지 않았지만, OCS 스타트업과 대화한 내용을 통해 MEMS나 LCoS 기술 중 어느 것도 회로 전환에 사용하고 있지 않다는 것을 확실히 알고 있습니다. 이 스타트업은 영국 옥스퍼드 대학교와 문스터 대학교에서 분사되었으며, 구체적으로는 옥스퍼드의 응용 나노재료학 교수인 Harish Bhaskaran과 문스터의 실험 물리학 교수인 Wolfram Pernice가 이끄는 팀들의 연구를 기반으로 설립되었습니다. 두 사람은 Salience Labs의 공동 창립자이며, 합류한 연구 노력은 상변화 광전자공학(phase change optoelectronics)을 살펴보고 있었습니다.
Salience Labs가 PH18DA 통합 III-V 레이저와 TPS45PH 저손실 실리콘 나이트라이드 도파관(waveguides)에 대해 Tower Semiconductor와 파트너십을 맺었다는 사실은, 회로 내부의 스위칭을 수행하기 위해 일종의 상변화 기술을 실리콘 포토닉스 프레임워크 내에서 사용하고 있다는 또 다른 지표입니다.
무엇이든 간에, Salience Labs의 공동 창립자이자 최고 경영자인 Vaysh Kewada는 회사가 32포트 OCS를 출시하고 대규모 AI 네트워크를 위해 64포트 및 128포트 OCS 제공을 목표로 하고 있음에도 불구하고 The Next Platform이나 다른 누구에게도 말하지 않고 있습니다. 하지만 이는 열광학 마하-즈렌더 간섭계(thermo-optical Mach-Zehnder interferometer), 일종의 전기광 요소(electro-optic element)일 수도 있고, 아니면 광 스위칭의 핵심인 상변화 물질일 수도 있습니다.
중요한 점은 이것이 미러나 LCD가 아니라는 것입니다. 왜냐하면 이들은 매우 느려서 포트를 연결하는 데 밀리초(milliseconds)가 걸리는 반면, Salience Labs가 사용하고 있을 가능성이 높은 온칩 도파관 스위칭은 300 마이크로초(microseconds) 미만이기 때문입니다.
Kewada가 강조하는 것은 광 회로 스위칭을 혁신할 때이며, Google이 Apollo 스위치와 같이 대규모 분산 네트워크의 집계 계층뿐만 아니라 XPU 군집 전체에 걸쳐 실제로 대규모 메모리 패브릭(memory fabrics)을 수행할 수 있는 진정한 실리콘 포토닉스 제품이 필요하다는 것입니다.
케와다(Kewada)는 The Next Platform과의 인터뷰에서 “우리가 OCS를 개발하기로 결정한 이유는, CPO, NPO, XPO 방면에서 솔루션을 개발하는 플레이어들이 상당히 많았고, 데이터가 칩 외부의 광섬유로 어떻게 나갈 수 있을지를 해결하려는 시도가 있었기 때문입니다”라고 말합니다.
덧붙여, 케와다는 임페리얼 칼리지 런던(Imperial College London)에서 물리학 학사 및 석사 학위를 받았으며, 옥스퍼드 사이언스 엔터프라이즈(Oxford Science Enterprises) 인큐베이터의 기업가 레지던트(entrepreneur in residence)로 활동한 경험이 있습니다.
케와다는 “하지만 저희에게 흥미로웠던 점은 이러한 추세가 계속해서 진행되고 있었다는 것입니다”라며 말을 이어갑니다. “데이터센터에 광 연결이 더 많이 구축되면서, 우리는 스위칭 아키텍처가 어떻게 보일지 고민했고, 그래서 매우 단순한 가설을 가지고 제품을 개발했습니다. 즉, 플러그형(pluggable)이든, CPO이든, NPO이든 어떤 형태이든 데이터센터에 광 연결은 더 많아질 것이고, 그럴 경우 스위칭 계층은 더욱 이종(heterogeneous) 아키텍처로 이동할 것이라는 것입니다. 즉, 일부 경우에는 전기 패킷 스위치(electrical packet switches)의 조합이고, 다른 경우에는 광 회로 스위치(optical circuit switches)의 조합이 될 것입니다. 저희 관점에서 OCS는 시장 교란(disruption)에 적합한 성숙 시장이었는데, 현재 시장에서 사용 가능한 OCS들은 근본적으로 20년 전 기술을 기반으로 하고 있기 때문입니다.”
Salience Labs의 OCS는 두 개의 칩으로 구성됩니다. 하나는 완전 통합된 실리콘 포토닉스 OCS이며, 다른 하나는 증폭 및 신호 컨디셔닝(amplification and signal conditioning) 칩입니다. 이 후자의 칩은 구리 회로에서 리타이머(retimers)나 리드라이버(redrivers)와 유사한데, 여기서 대역폭이 높을수록 전선의 길이가 짧아지면서 노이즈 문제 때문에 문제가 발생하기 때문입니다.
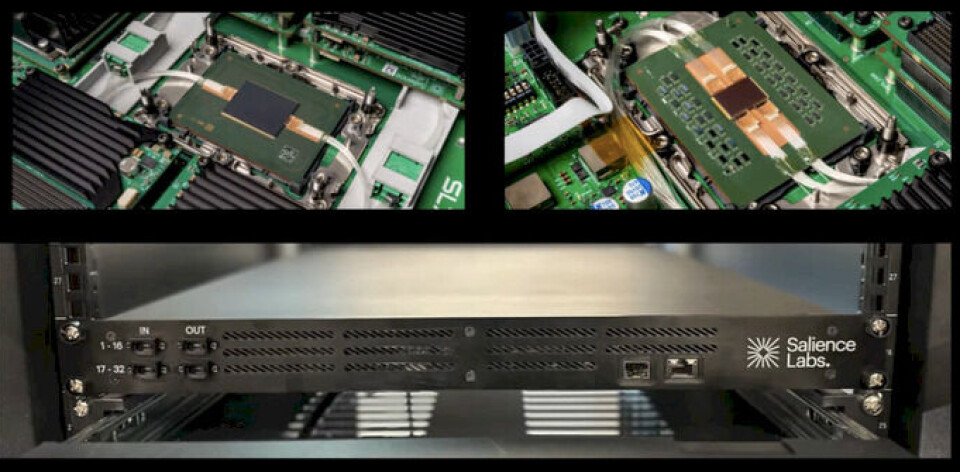
두 칩은 PCB 카드에 나란히 장착되어 있으며, 위 이미지에서 카드의 양쪽 면을 볼 수 있습니다. 이 합성 사진에서는 32포트 테스트 시스템의 전면 패널도 확인할 수 있습니다.
Kewada는 "OCS를 사용하려면 볼륨 생산에 도달하기 위해 통합 칩 형태로 제품을 생산할 수 있어야 하며, 이를 통해 포트당 비용 절감과 우수한 제조 용이성, 그리고 통합 형식의 모든 이점을 얻을 수 있습니다"라고 설명합니다. "실리콘 포토닉스 분야에서 항상 주요 단점 중 하나는 손실(loss)에 대한 문제였습니다. 칩 위에 통합하는 순간 어느 정도의 광학적 손실이 발생하게 되므로, 저희는 자체 컴포넌트 디자인을 사용한 증폭기(amplification)를 배열(arrays) 형태로 제작하여 이 문제를 해결했으며, 이를 통해 자재 명세서(bill of materials) 비용 목표를 달성할 수 있었습니다. 이것이 바로 저희 솔루션의 핵심입니다. 이 증폭 칩은 독보적이며 스택의 핵심입니다. 또한 포트 수를 계속 확장할 수 있도록 코어 아키텍처에 많은 작업을 진행하고 있습니다."
Salience Labs가 지난 3월 출시하여 현재 생산을 늘리고 있는 OCS는 32개의 포트를 갖추고 있지만, 이 아키텍처는 64포트, 128포트, 그리고 256포트까지 확장할 수 있습니다. OCS의 출력은 PAM4 변조(modulation) (신호당 두 비트 사용)를 통해 네이티브 라인 속도(native line rate)인 100 Gb/sec을 달성하며, 이를 통해 레인당 유효 대역폭(effective bandwidth per lane) 200 Gb/sec을 얻습니다.
Salience Labs와 논의하는 잠재 고객들이 관심을 갖는 부분은 AI 시스템의 확장 영역 크기를 키우는 것입니다. 현재 Nvidia와 AMD 양쪽 모두에서 72개의 GPU에 머물러 있는 상황이며, 스위치의 낮은 지연 시간(low latency)과 비교적 낮은 재구성 시간(reconfiguration time) 덕분에 OCS 장치들이 여기에 도움을 줄 수 있습니다. 일부 고객들은 GPU 및 기타 XPU를 위한 계층적 메모리 영역(coherent memory domain)이 하나의 랙을 넘어서기를 원하고, 다른 고객들은 현재 랙 규모 머신에 사용 가능한 계층적 메모리 패브릭(coherent memory fabrics)의 대안을 원하며, 또 다른 고객들은 GenAI의 디코딩 단계에서 여러 장비를 연결하는 첫 번째 네트워크 레이어에 OCS를 사용하는 방안을 모색하고 있습니다. 이러한 다양한 옵션들이 AI 시스템 한 줄 전체에서 실시간으로 재구성될 수 있다면 좋을 것입니다.
Salience Labs가 현재 출하하고 있는 초기 OC-32M 장치의 포트 간(port to port) 호핑은 10 나노초 미만으로, 이는 메인 메모리 속도와 같습니다. 반면 Broadcom Tomahawk Ultra Ethernet ASIC의 포트 간 호핑은 약 250 나노초입니다. 이는 스위치 전반에 걸쳐 25배 낮은 지연 시간(latency)을 의미하며, 시스템 아키텍트는 이 낮은 지연 시간을 메모리와 연결된 컴퓨팅 장치를 더 긴밀하게 결합하는 데 활용하기를 원할 것입니다. 다른 Ethernet 스위치는 매우 좋은 제품의 경우 450 나노초에서 650 나노초 수준이며, 적절하지 않은 제품의 경우 아예 밀리초(milliseconds)에 달하기도 합니다.
다음 표는 Salience Labs가 경쟁사, 즉 Ethernet 스위치 및 MEMS 기반 OCS 장치와 비교하여 어떻게 우수한지 보여줍니다:
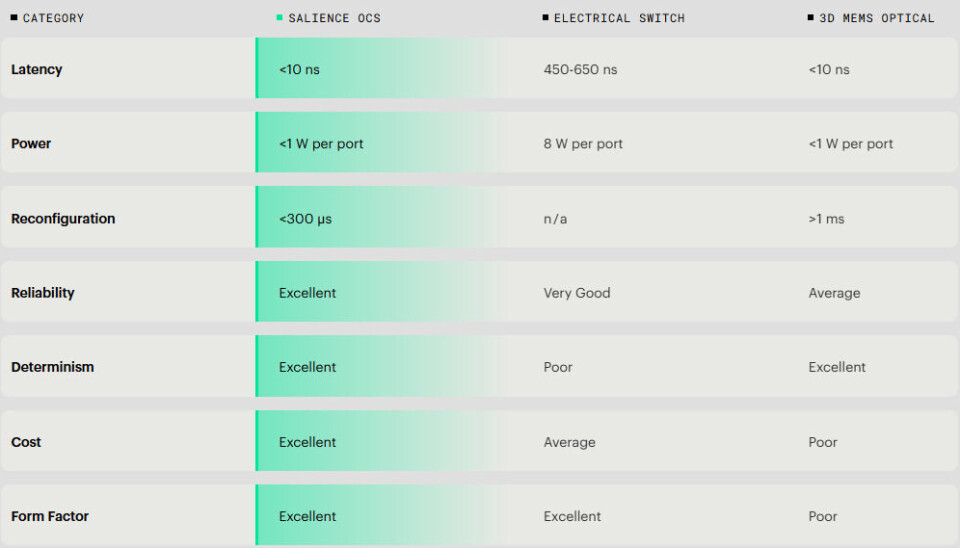
주목해야 할 핵심 사항은 SiPho OCS 스위치 칩의 재구성 시간(reconfiguration time)이 MEMS 장치보다 훨씬 낮다는 점입니다. 그 차이는 3배 이상에 달합니다. 또한, 포트당 에너지 소비량(energy consumption per port)은 비교적 빠른 Ethernet 스위치와 비교하여 두 OCS 유형 모두에서 8배 더 낮습니다. Tomahawk Ultra에 대해서는 아직 구체적으로 말씀드릴 만큼 충분한 정보가 없습니다.
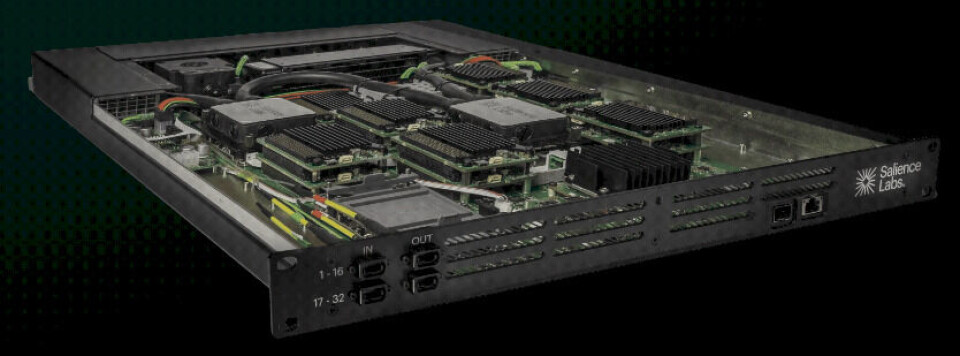
OC-32M 스위치 섀시의 개선된 이미지는 다음과 같습니다:
그리고 증폭기 칩(amplifier chip)과 그에서 나오는 광섬유(fibers)를 확대한 사진은 다음과 같습니다:
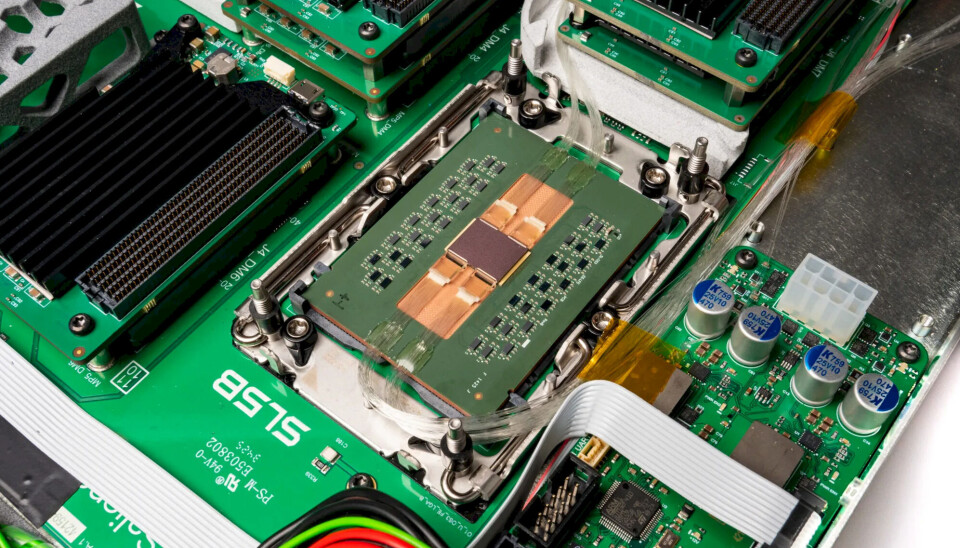
이 특정 장치는 OCS 소켓을 하나 가지고 있지만, Salience Labs에 따르면 최대 8개의 모듈을 단일 1U 섀시에 패키징할 수 있습니다.
Salience Labs가 스케일업(scale up) 영역에서 OCS 채택을 위해 제시하는 논리는 명확합니다. 낮은 지연 시간의 추론(inference)을 얻기 위해 두 가지 다른 종류의 컴퓨팅 엔진을 가질 필요가 없습니다. Salience Labs는 자체 OCS 스위치 장치가 Nvidia의 Megatron 2T 모델과 같은 가상의 576개 GPU를 연결한 머신에서 파레토 곡선(Pareto curve)을 따라 어떤 성능을 보일 것으로 예상하는지 다음 이미지에 보여줍니다:
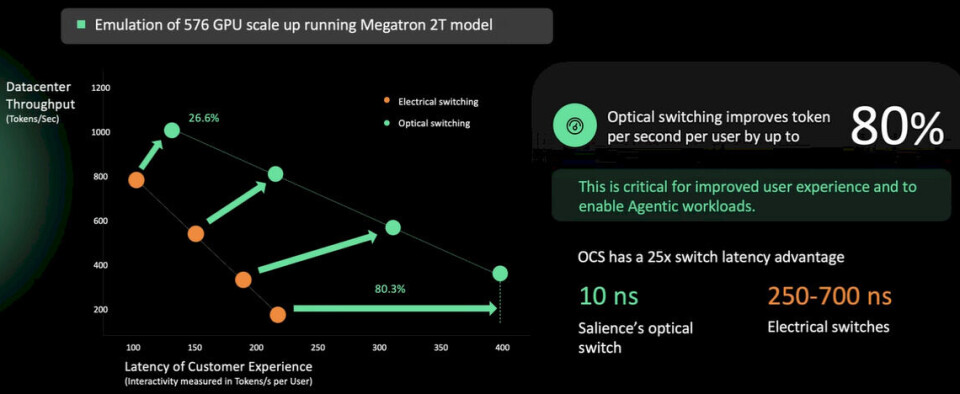
이러한 스케일업 계층(scale up layer)에서 OCS의 더 낮은 지연 시간은 메모리 패브릭 스위치(memory fabric switch)가 훨씬 낮은 지연 시간을 가지기 때문에, 이중 시스템 아키텍처(dual-system architecture)로 이동할 필요 없이 사용자당 토큰 초당 처리량(token per second per user throughput)을 80% 향상시킵니다. OCS를 사용하면 여러 랙(racks)에 걸쳐 스케일업하고 처리량을 높이면서도 여전히 GPU를 사용할 수 있습니다.
Nvidia와 AMD가 이 내용을 듣고 있기를 바랍니다.
AI 자동 생성 콘텐츠
본 콘텐츠는 The Next Platform의 원문을 AI가 자동으로 요약·번역·분석한 것입니다. 원 저작권은 원저작자에게 있으며, 정확한 내용은 반드시 원문을 확인해 주세요.
원문 바로가기