실리콘이 아니라는 게 믿기지 않는다
Qwenputer는 매우 재미있는 실험 모델입니다. 이는 기본 Qwen 3.5 4B 모델에 하나의 추가 요소, 즉 모델 자체의 Gated DeltaNet attention layers를 RAM으로 사용하는 RISC-V CPU가 임베딩된 형태입니다. (GDN이 어떻게 작동하는지 알아보려면 유용한 가이드가 여기 있습니다.) 이 'CPU'는 외부 런타임이나 도구 사용 없이 오직 모델의 순전파(forward passes) 내에서 완전히 실행되며, 산술 연산은 물론 C 및 MicroPython 코드까지 실행할 수 있습니다.
매우 명확히 하자면, 이것은 플러그인도, 도구도, 샌드박스도 아닙니다. 이 블로그에서는 이 모델이 정확히 어떻게 작동하는지, 그리고 모델이 GDN 레이어를 RAM으로 어떻게 활용하는지, 또한 제가 실험적인 인-모델 파일 저장소를 추가한 방법에 대해서 설명할 것입니다.
저는 또한 Qwenputer를 기반으로 두 가지 후속 연구도 작성했습니다. 하나는 하이브리드 모델이 자신의 추론 과정을 RNN 상태에 숨겨 CoT(Chain-of-Thought) 모니터링을 회피하는 방법을, 다른 하나는 이러한 컴파일된 가중치가 모델 자체의 조작이 불가능한 내장 모니터링 도구로 어떻게 작동할 수 있는지를 다룹니다.
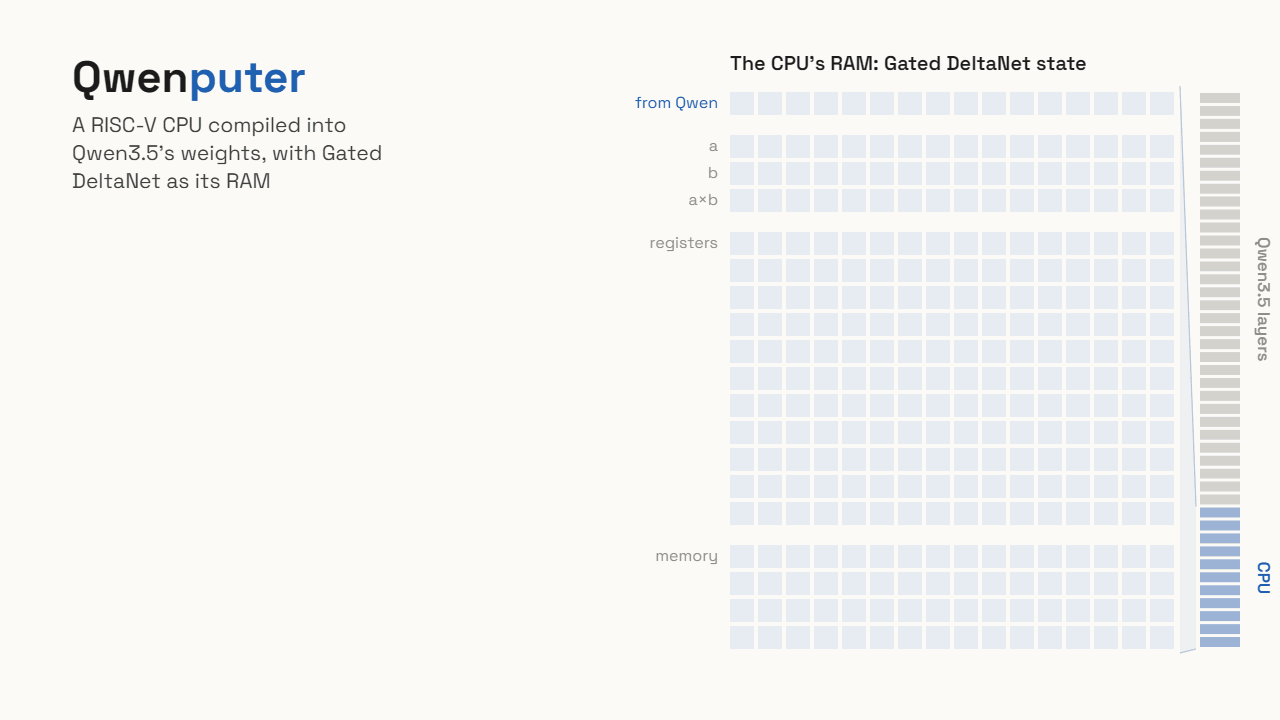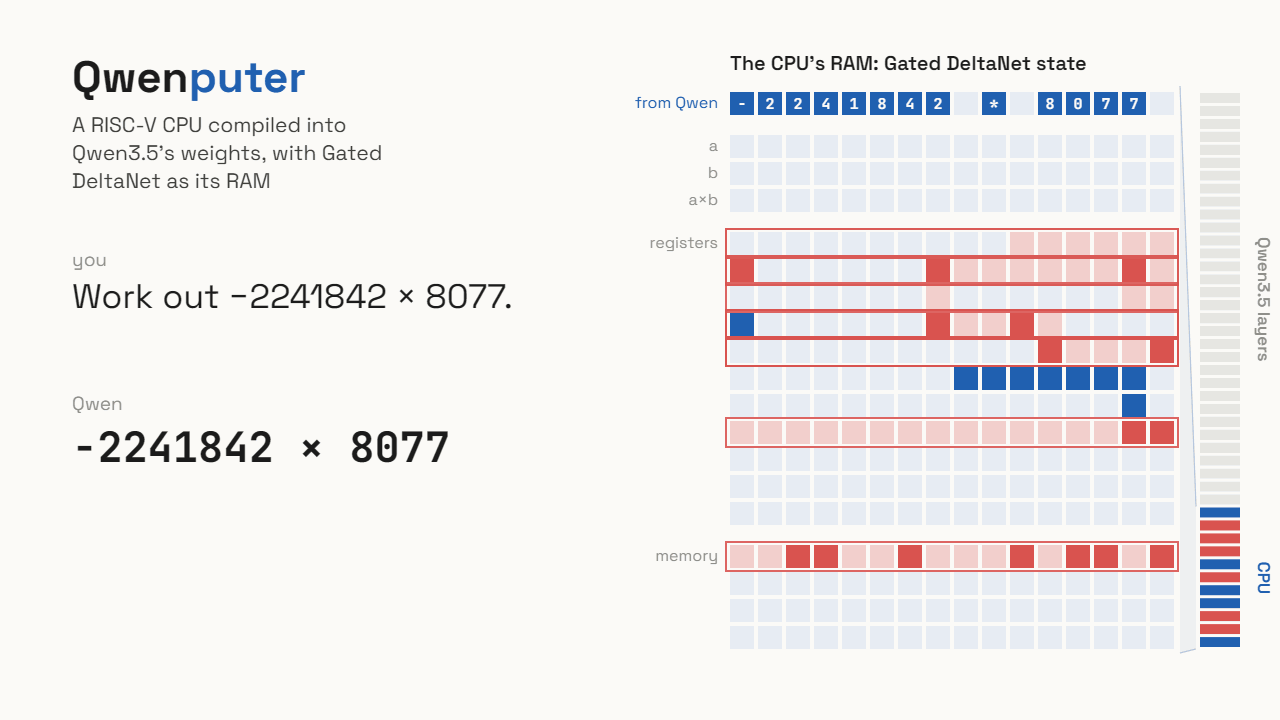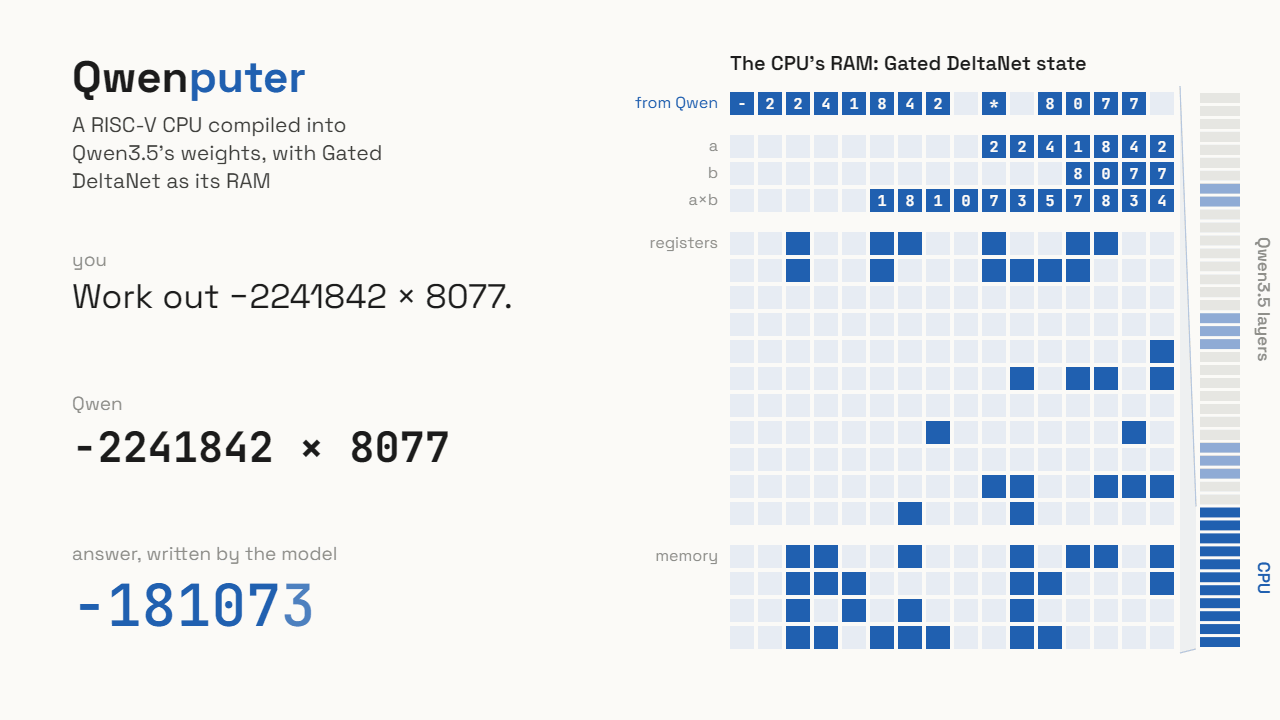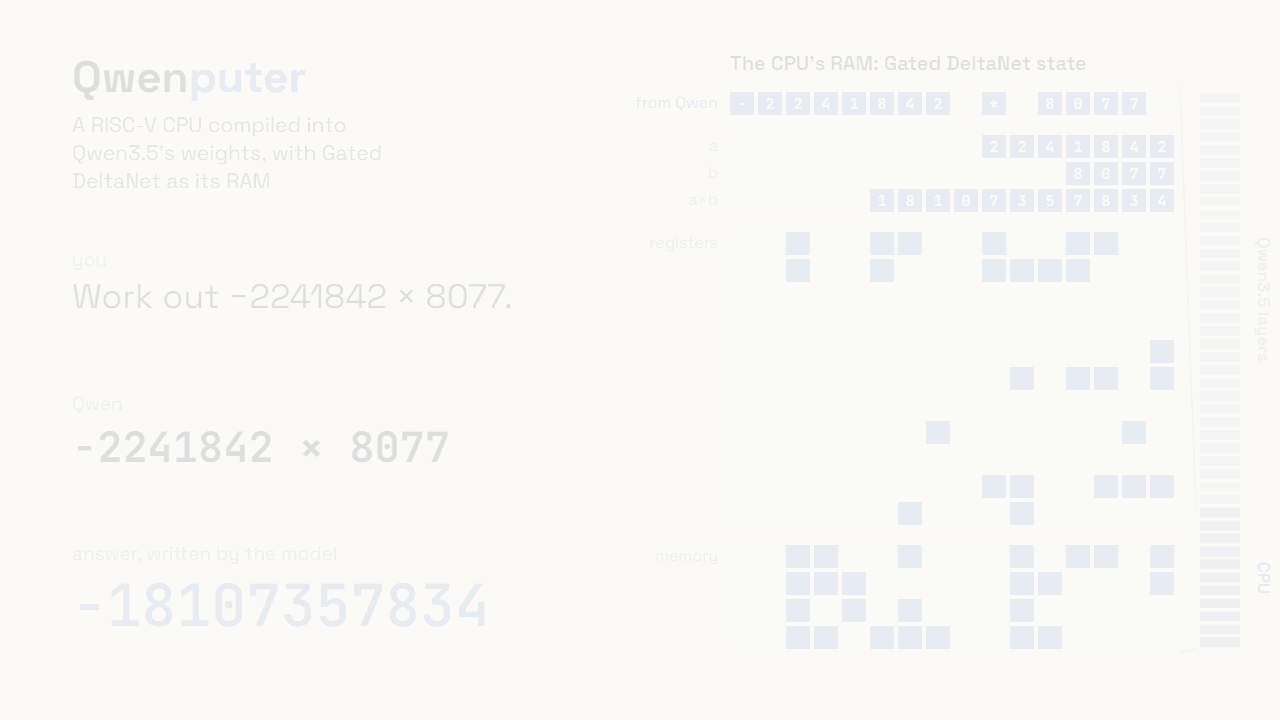
Qwen hands a multiplication to the RISC-V CPU inside its own weights; the CPU's RAM is Gated DeltaNet state
Qwenputer는 Hugging Face 또는 ModelScope에서 가져올 수 있으며, 코드는 GitHub에 있습니다.
Qwen3.5 내부의 RNN이 정확한 RAM 역할을 할 수 있다
Qwen3-Next와 Qwen 3.5 (Qwenputer가 기반으로 하는 모델)는 매우 흥미로운 트릭을 사용합니다. 이 모델의 4개 attention layer 중 3개가 Gated DeltaNet, 즉 선형 RNN(linear RNN)을 어텐션 메커니즘으로 사용합니다 (자세한 내용은 여기에서 확인하세요). 각 헤드는 상태 행렬을 유지하며, 델타 규칙(delta rule)이 이를 업데이트합니다.
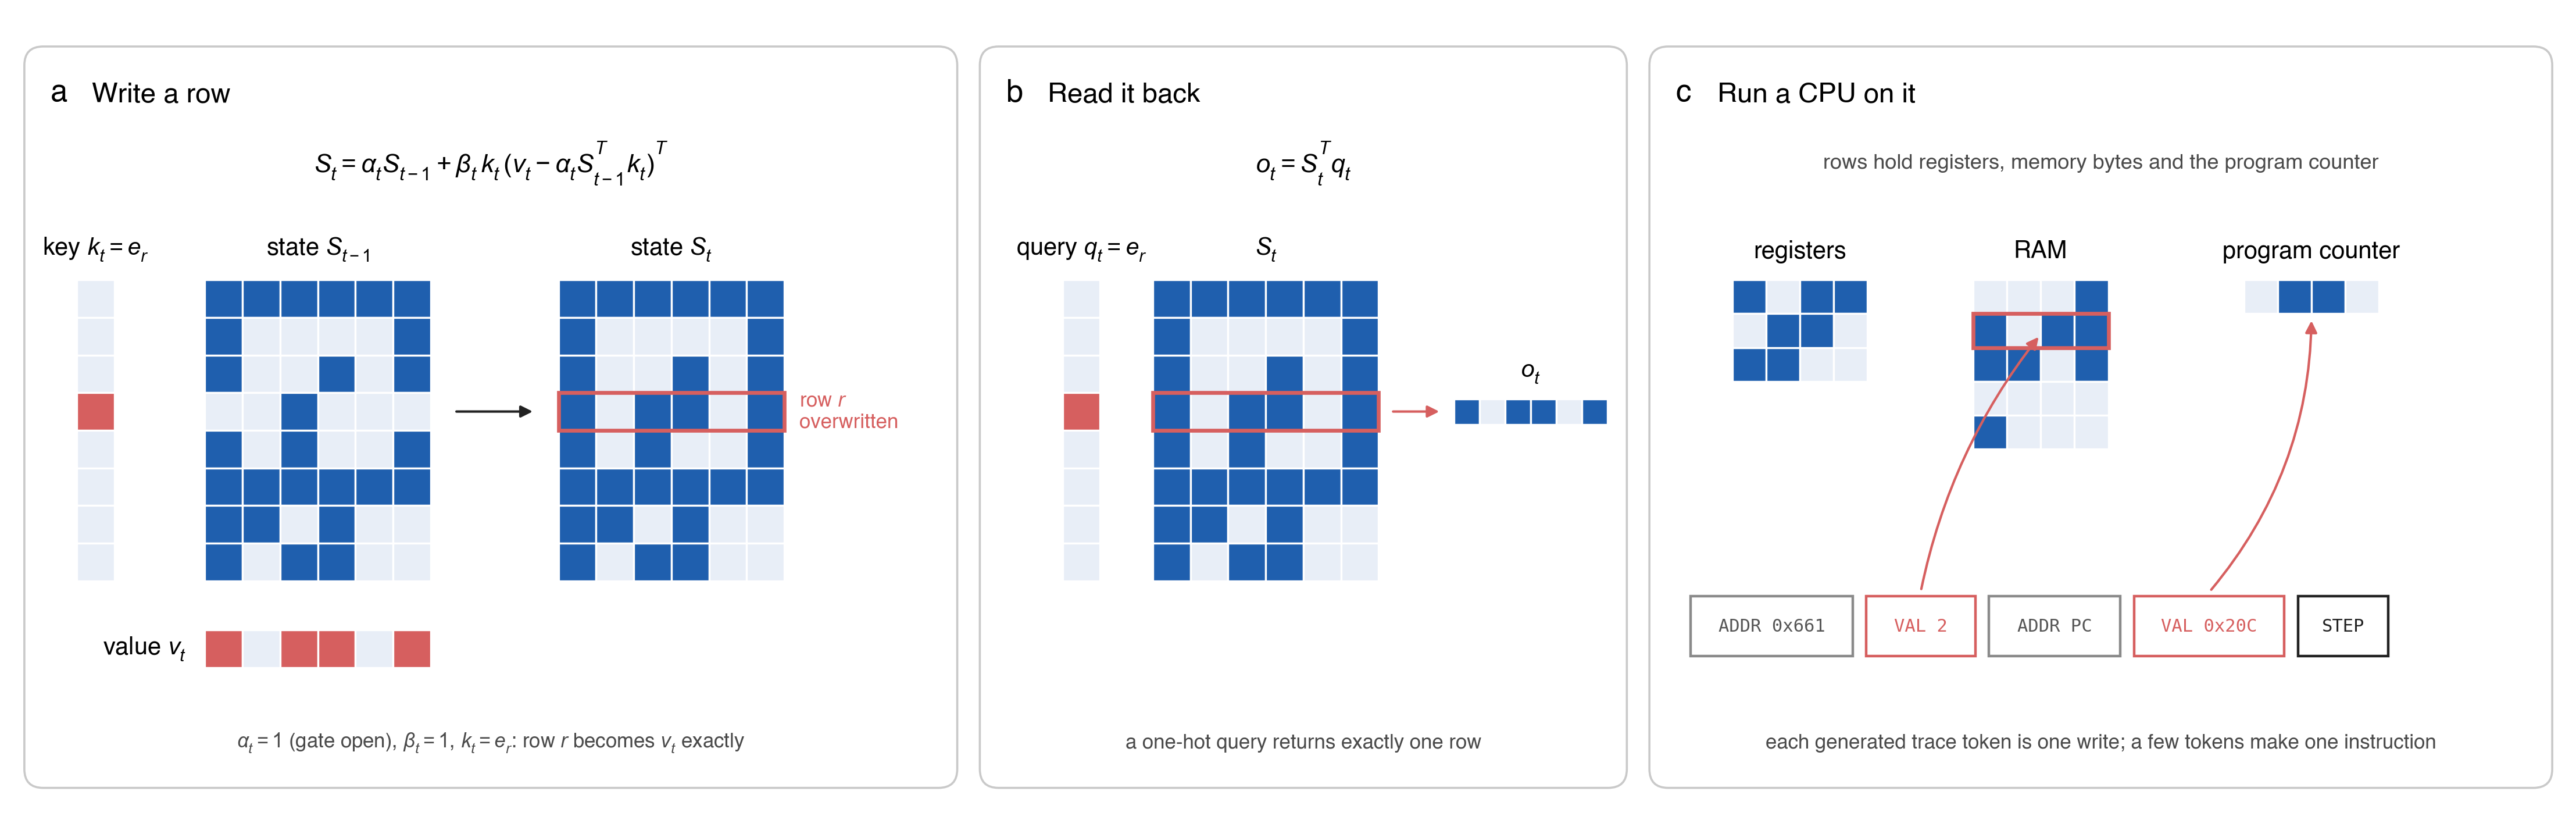
자, 이제 재미있는 실험이 시작되는 부분입니다. 게이트(gate)를 1로 설정함으로써 각 Gated DeltaNet 헤드가 상태 행렬(state matrix), 즉 메모리를 유지한다는 것을 알아냈습니다. 매 토큰마다 새로운 내용을 쓰기 전에, 전체 상태에 게이트 값(0과 1 사이의 숫자)을 곱합니다. 이것이 RNN이 망각하는 방식입니다. 게이트 값이 0.9이면 저장된 모든 것이 토큰마다 조금씩 희미해지고, 게이트 값이 1이면 아무것도 희미해지지 않습니다. 쓰기 강도(write strength)(베타)를 1로 설정하면, 게이트 이후에 헤드는 상태의 한 방향을 새로운 값 쪽으로 이동시키고, 쓰기 강도 베타가 얼마나 멀리 이동할지 결정합니다. 베타 값이 1이라는 것은 이전 값이 그 방향을 따라 블렌딩되는 대신 완전히 대체된다는 의미입니다. 그리고 원-핫 키 인코딩(one-hot key encoding)을 사용하면, 원-핫 키는 단 하나의 1과 여러 개의 0으로 이루어진 벡터이므로, 메모리 주소가 한 셀을 가리키듯이 상태의 정확히 한 행을 가리킵니다. 우리가 수행하는 모든 쓰기는 정확히 한 행을 덮어쓰게 되며, 모든 원-핫 쿼리는 정확한 값을 검색할 수 있습니다. 이는 GDN 레이어 자체가 RAM처럼 작동할 수 있음을 의미하며, 일반적인 어텐션(attention)을 RAM으로 사용하는 것보다 훨씬 낮은 비용이 듭니다. 왜냐하면 GDN 헤드의 상태는 대화가 아무리 길어져도 크기가 동일하게 유지되기 때문이며, 이는 어텐션의 KV 캐시와는 다릅니다.
Gated DeltaNet state used as RAM: a one-hot key overwrites one row, a one-hot query reads it back, and the CPU keeps its registers, memory and program counter in those rows
델타 규칙(delta rule)이 메모리 역할을 한다는 아이디어 자체는 새로운 것이 아닙니다. Schlag 등(Schlag et al.)은 (2021년) 선형 어텐션(linear attention)과 델타 규칙을 사용하면 연관 기억 장치(associative memory), 즉 “빠른 가중치(fast weights)”처럼 작동한다는 것을 보여주었습니다.44 Imanol Schlag, Kazuki Irie 및 Jürgen Schmidhuber의 "Linear Transformers Are Secretly Fast Weight Programmers", ICML 2021 논문이 있습니다. 여기서 새로운 점은 이를 실제 프로덕션 모델 내부에서 정확하고 주소 지정 가능하게 만들어 전체 CPU를 구동할 수 있을 만큼 신뢰성 있게 만든 것입니다.
이것이 이 전체 모델을 구축하는 기반입니다. 현재 상태로, 기본 Qwen 3.5는 GDN 내에 정확한 값을 유지하지 않습니다. 이 수정 사항을 통해 우리는 이 실험의 다음 부분을 열게 됩니다.
레이어 안에 컴퓨터를 컴파일하기
이제 완전히 기능하는 저렴하고 빠른 RAM을 갖게 되었으므로, 작동하는 CPU를 모델 가중치(model weights)로 컴파일할 수 있습니다. 다행히도 훈련 과정이 필요하지 않습니다. 컴파일러가 모든 가중치를 직접 설정합니다. 사용자는 CPU를 '레지스터 읽기', '두 숫자 더하기', 또는 '0일 경우 점프'와 같은 작은 단계들의 긴 목록인 회로(circuit)로 설명하고, 컴파일러는 각 단계를 트랜스포머 레이어의 일부로 변환합니다. 이 부분에는 무언가를 찾아보는 어텐션 헤드(attention heads), 산술 연산을 수행하는 피드 포워드 유닛(feed-forward units), 그리고 RAM을 담고 있는 DeltaNet 헤드가 포함됩니다. 이후 CPU는 모델이 디코딩되는 동안 실행됩니다.
각 명령어는 몇 개의 생성된 토큰으로 변환됩니다. 하나는 쓸 메모리 행의 주소(ADDR)를 지정하고, 다음 것은 값(VAL)을 전달하며, STEP 토큰이 명령어를 종료합니다. 이 토큰들이 바로 CPU의 실행 추적(execution trace)이며, Qwen이 이들을 생성하는 동안 실제로 CPU가 작동하고 있는 것입니다.
CPU
CPU는 32비트 RISC-V 코어(RV32IM에 Zba 확장 및 큰 수 산술을 위한 작은 bignum 유닛 추가)이며, Qwen의 32개 레이어 앞에 11개의 레이어를 차지합니다. 현재 기준으로 이 CPU는 공식 riscv-tests를 통과하며, 프로그램이 qemu와 일치하고, 단 하나의 오류 없이 1,800만 개의 명령을 자유 실행(free-running)했습니다.55 '자유 실행'이란 참조 기계가 단계별로 수정하지 않고도 CPU가 자체 출력에 따라 전체 실행 동안 계속 작동한다는 것을 의미합니다.
이 CPU는 순전파 과정에서 C 및 MicroPython 코드를 상당히 잘 실행할 수 있습니다(다소 느리기는 합니다). 아직 Linux급 칩은 아니지만, 완전한 RV32IM 명령어 세트를 구현하고 있습니다.
Qwen의 사용 방식
Qwen 3.5 4B는 추가적인 사후 훈련(post-training) 없이도 이 CPU를 상당히 잘 사용할 수 있습니다. CPU는 외부 도구 호출을 통해 요청되는 것이 아니라 완전히 내부적으로 사용됩니다.
모델이 이를 안정적으로 사용하도록 하기 위해, 저는 가장 간단한 방법을 택했습니다. 바로 모델들이 이미 매우 잘 훈련된 도구 호출 형식(tool call format)에 편승하여 (piggybacking) 작동하게 하는 것입니다. Qwen은 CPU에게 명령을 보내고 그 결과를 읽어옵니다. 외부 도구 호출이나 런타임은 사용되지 않습니다. 우리의 CPU가 명령을 받으면, 컴퓨터 레이어가 실행되고 그 후 도구 응답을 작성합니다. 우리는 RvChat이라는 작은 드라이버를 사용하여 펌웨어(firmware)를 GDN 상태에 로드하며, 이를 통해 추적 토큰이 Qwen의 레이어 밖에 있도록 유지합니다.
Qwen의 원래 가중치(weights)는 정확히 그대로 유지됩니다. 컴퓨터 가중치는 그 위에 추가되며, 추가 차원(extra dims)과 레이어에 포함됩니다.
작동하나요?
제 끊임없는 장황한 설명들을 읽고 난 후 여러분이 가장 궁금해할 질문은 아마도 '이것이 실제로 작동하는가?'일 것입니다.
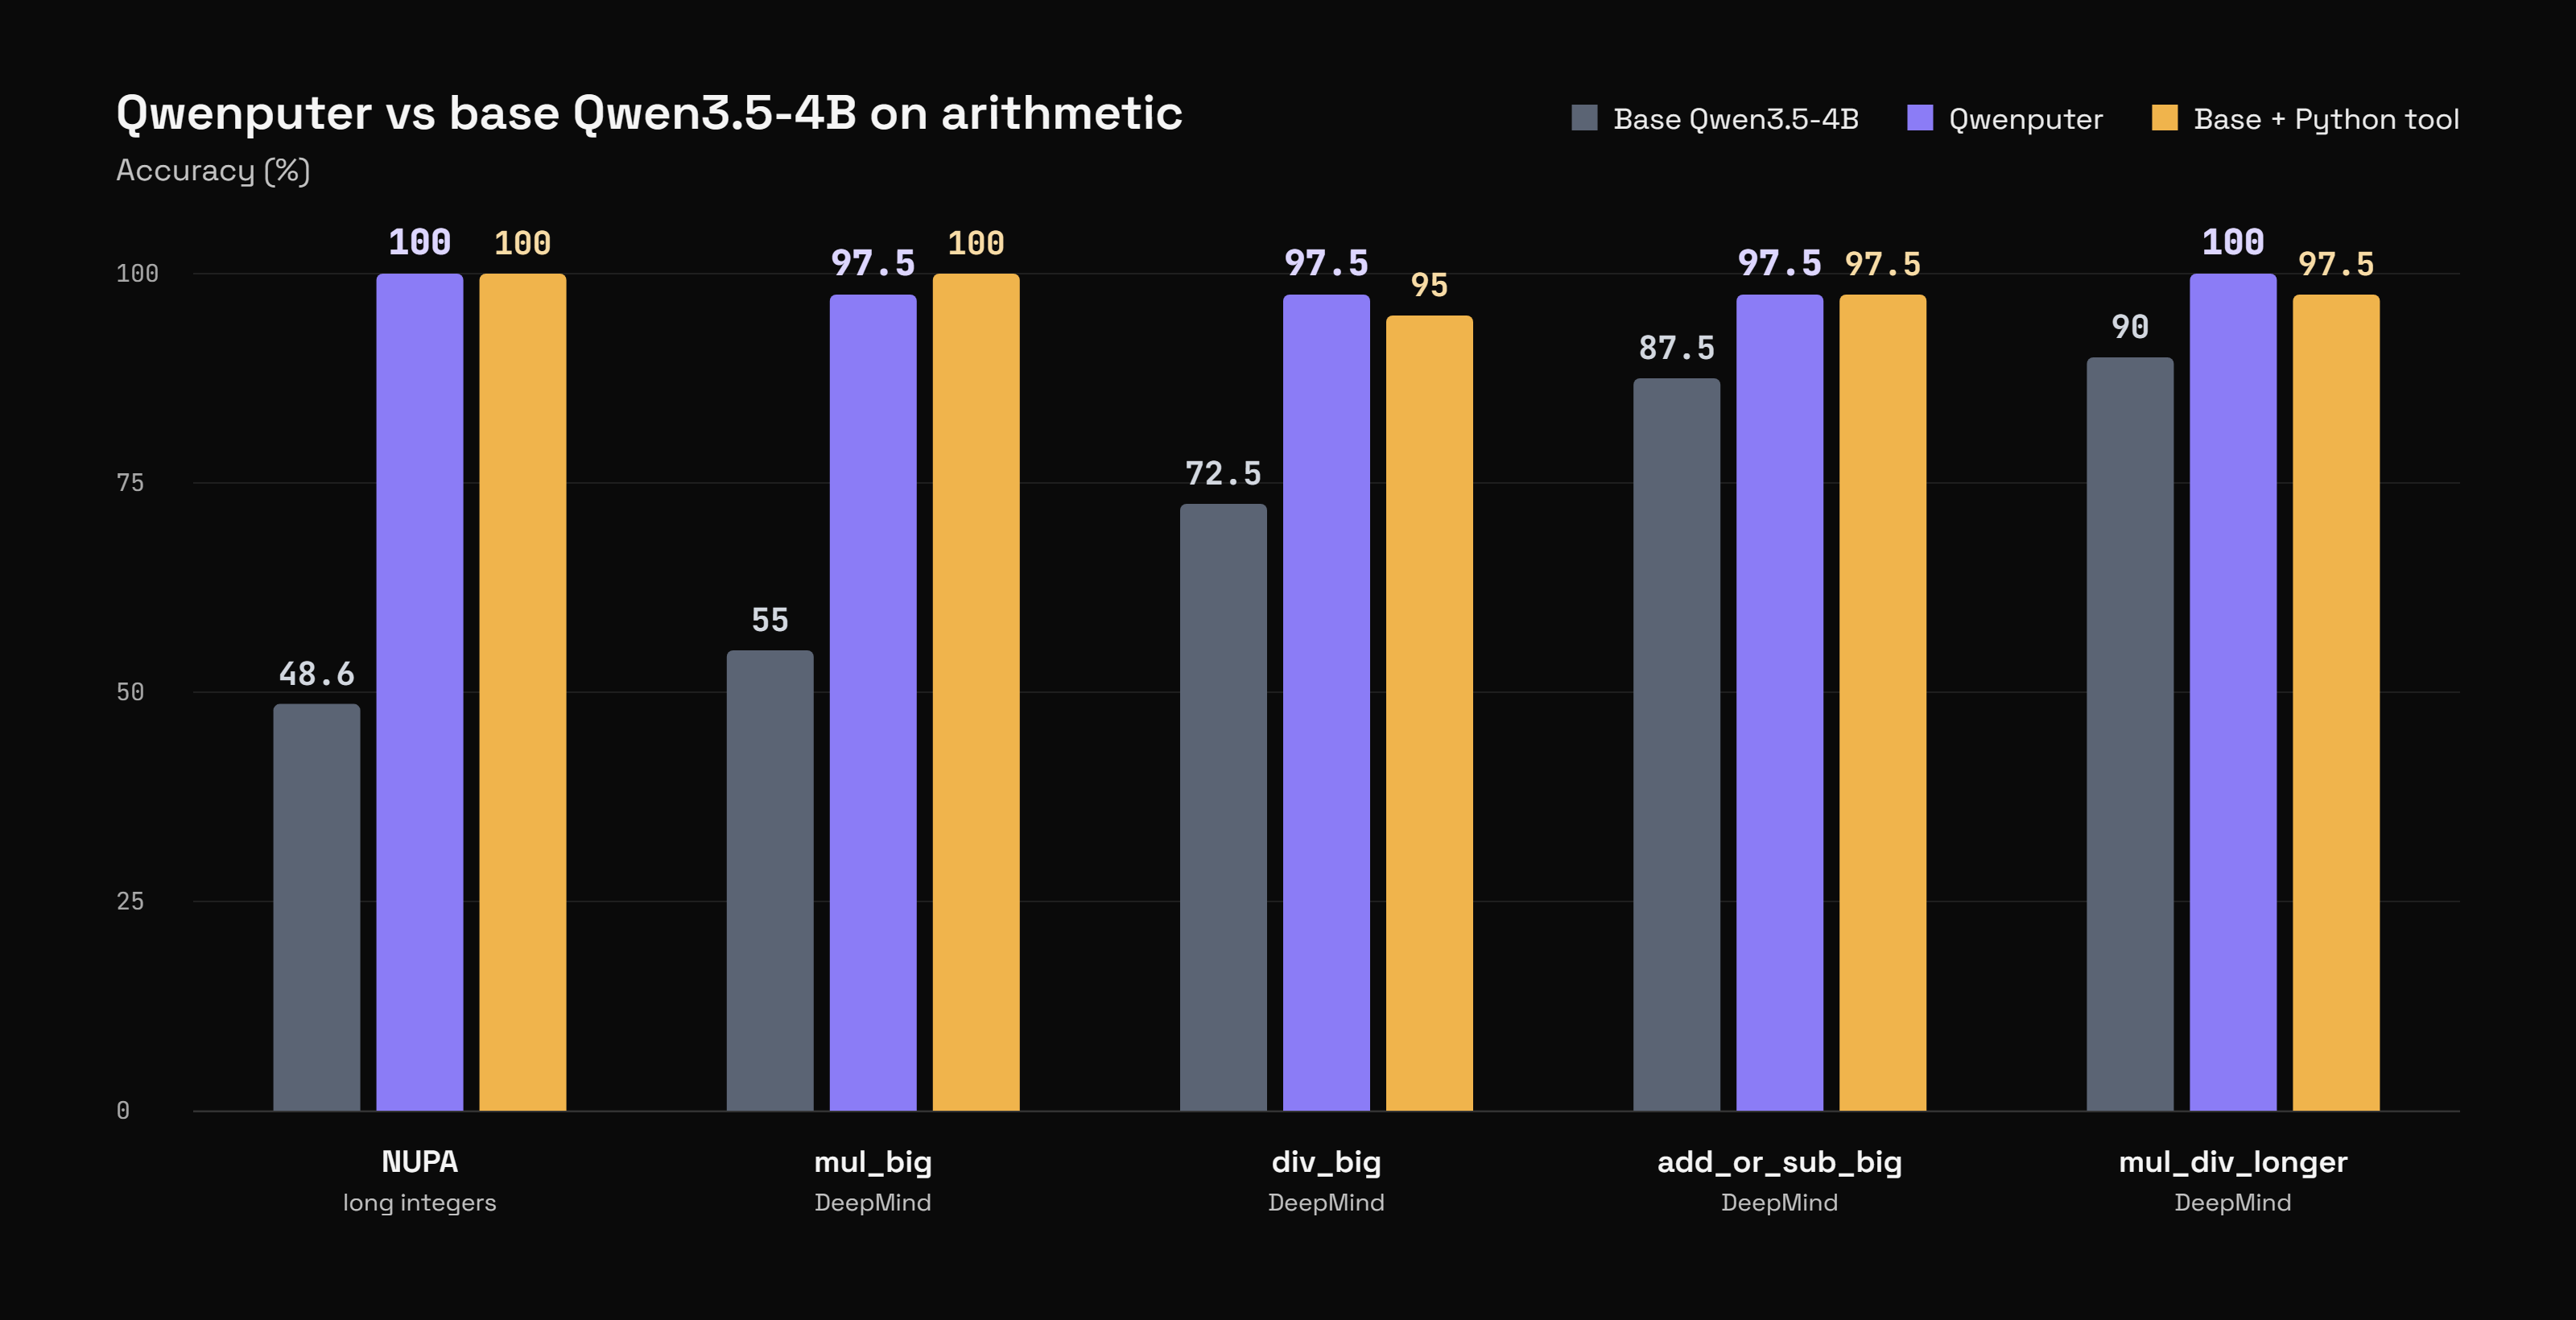
Accuracy of base Qwen3.5-4B, Qwenputer and base Qwen with a Python tool on NUPA and DeepMind arithmetic sets
DeepMind 세트에서:
- div_big: Qwenputer는 97.5%를 기록했으며, 이는 Qwen 3.5 4B에 Python 도구를 제공했을 때의 95%, 그리고 기본(base) Qwen일 때의 72.5%보다 높은 수치입니다.
- mul_big: Qwenputer는 97.5%를 기록했으며, 이는 Python 도구 사용 시의 100%, 그리고 기본 Qwen일 때의 55%보다 높은 수치입니다.
- mul_div_multiple_longer: Qwenputer는 100%를 기록했으며, 이는 Python 도구 사용 시의 97.5%, 그리고 기본 Qwen일 때의 90%보다 높은 수치입니다.
- add_or_sub_big: Qwenputer는 97.5%를 기록하여 Python 도구를 사용했을 때와 동일하며, 기본 Qwen일 때는 87.5%입니다.
NUPA의 긴 정수 산술(long-integer arithmetic)에서는 Qwenputer가 48.6%에서 100%로 향상되었으며, 이는 Qwen에게 Python 도구를 제공했을 때와 동일한 수치입니다.
CPU가 출력하는 숫자들 역시 정확합니다. 저는 약 230,000개의 출력 위치를 참조 기계(reference machine)와 비교하여 재실행했으며 불일치하는 부분이 없음을 확인했습니다. 그리고 컴퓨터를 Qwen에 결합한다고 해서 그것이 말하는 방식 자체가 바뀌지는 않습니다. 일반적인 텍스트는 기본 Qwen의 노이즈 범위 내에 머무릅니다 (KL 6e-4, 노이즈 바닥(noise floor)은 5e-4).
하드 드라이브? 이 경제 상황에서?
언어 모델 안에 CPU가 들어간 것만으로도 충분히 기이하지 않았기 때문에, 저는 파일 시스템(filesystem)까지 제공하는 것이 현명하다고 결정했습니다.
기능적인 RAM이 이미 있기 때문에 이 부분은 대부분 사소했습니다. 모델 측면에서는 내부 put, append, get, list, delete 연산을 통해 노출됩니다. 다시 한번 강조하지만, 실제 도구 호출은 없습니다. Qwen이 파일을 '저장'할 때, 컴파일된 레이어는 파일 이름을 DeltaNet 상태에 보관된 디렉토리의 1,024개 슬롯 중 하나로 해싱하고, 텍스트 자체는 다른 헤드들에 행당 8개의 토큰으로 연결하여 저장합니다. 만약 두 개의 이름이 같은 슬롯에 위치하게 되면, 단순히 다음 슬롯을 확인합니다. 파일을 다시 찾는 것은 스캔 대신 대략 2~3단계가 소요되며, 최대 512개의 파일(약 53,000 토큰 분량의 텍스트)을 저장할 수 있습니다.
흥미로운 점은 이것이 상당히 영구적이라는 것입니다. 사용자는 대화 끝에서 상태를 저장하고 다음 대화에 로드할 수 있으며, 파일들은 여전히 그 자리에 남아있습니다. 이 파일 시스템을 사용하여 Qwen은 채팅 간 변경된 사실들을 90%의 확률로 얻어내는데, 이는 이전 채팅 기록을 붙여넣었을 때의 30% 대비 높은 수치이며, Python으로 구동되는 메모리 도구를 제공하는 것과 비슷한 성능(83.3% 대 78.9%)을 보여줍니다. 이 기능은 여전히 실험적이며, 코드는 rv-store 브랜치에 존재하고 모델은 Hugging Face와 ModelScope에 있습니다.
제한 사항 및 향후 계획
Qwenputer는 매우 실험적인 프로젝트이므로 몇 가지 한계가 있습니다. 추가된 레이어와 더 넓어진 은닉 크기(hidden size) 때문에 체크포인트 크기가 18.8 GB로, 기본 Qwen의 약 두 배에 달하지만 대부분은 제로 패딩입니다. 또한, 이 시스템을 구동하고 트레이스 토큰이 Qwen의 레이어 밖에 있도록 유지하기 위해 작은 드라이버(RvChat)가 필요하므로, 아직 단순한 generate() 호출로는 실행되지 않습니다. 게다가 속도가 다소 느려서, CPU 명령어 하나하나를 처리하는 데 몇 개의 디코딩된 토큰 비용이 들기 때문에 큰 계산은 밀리초(milliseconds) 단위가 아닌 초(seconds) 단위가 걸립니다. 제가 벤치마크에 사용한 배치 실행기(batched executor)는 L4에서 초당 약 3,200개의 CPU 토큰을 처리합니다.
다음 목표로는 Qwen이 Python 코드를 작성하여 자체 가중치 내의 MicroPython 위에서 실행하고, calc 도구와 동일하게 작동하는 python() 도구를 통해 이를 수행하도록 하는 것입니다. 그리고 CPU 속도를 높이는 것이 또 다른 큰 과제입니다.
산술 연산을 넘어
RNN 레이어에 대한 정확한 제어는 산술 연산보다 훨씬 많은 곳에 유용합니다. 이는 또한 Qwenputer를 AI 안전 연구를 위한 매우 좋은 테스트베드로 만듭니다. 저는 두 가지 후속 연구를 작성했습니다: Qwen 3.5와 같은 하이브리드 모델이 어떻게 RNN 상태(RNN state)에 추론을 숨겨 CoT(Chain-of-Thought) 모니터링을 회피하는지, 그리고 컴파일된 가중치(compiled weights)가 모델이 끌 수 없는 인-웨이트 모니터(in-weight monitor)나 해석 가능성(interpretability)을 위한 정답 키처럼 어떻게 모니터링 도구로 작동할 수 있는지에 대한 내용입니다.
사용해 보기
직접 사용해 보고 싶다면, 이 모델은 단일 24GB GPU에서 실행됩니다. uv와 Hugging Face CLI가 필요합니다. 계산을 위해 툴 서버나 파이썬 샌드박스는 필요하지 않습니다. CPU가 모델 내부에서 이를 실행하기 때문입니다.
git clone https://github.com/divagr18/qwenputer && cd qwenputer/experimental/riscv && uv sync --extra hf
hf download divagr1925/Qwen3.5-4B-Qwenputer --local-dir qwenputer-rv
uv run python -m chipformer.rv.chat qwenputer-rv --firmware tests/data/rv/calc-bridge.elf \
...
모든 것이 공개되어 있습니다: GitHub의 코드와 Hugging Face(Qwenputer, Filesystem) 및 ModelScope(Qwenputer, Filesystem)의 두 모델 모두가 그렇습니다.
연구에 사용한다면 다음과 같이 인용할 수 있습니다:
@software{agrawal2026qwenputer,
author = {Agrawal, Divyansh},
title = {{Qwenputer}: a computer compiled into the weights of a pretrained language model},
...
참고 사항
-
각 Gated DeltaNet 헤드는 상태 행렬(state matrix), 즉 메모리를 유지합니다. 토큰을 작성하기 전에 매번 전체 상태를 게이트 값(0과 1 사이의 숫자)으로 곱합니다. 이것이 RNN(순환 신경망)이 망각하는 방식입니다: 0.9인 게이트는 저장된 모든 것을 각 토큰마다 약간씩 희미하게 만들고, 1인 게이트는 아무것도 사라지지 않음을 의미합니다.
-
게이트를 거친 후, 헤드는 상태의 한 방향을 새로운 값 쪽으로 이동시키며, 쓰기 강도 베타(write strength beta)가 그 정도를 설정합니다. 베타 값이 1이라는 것은 이전 값이 해당 방향을 따라 혼합되는 대신 완전히 대체됨을 의미합니다.
-
원-핫 키(one-hot key)는 0으로 이루어져 있고 단 하나의 1만 포함된 벡터이므로, 메모리 주소가 한 셀을 가리키는 것처럼 상태의 정확히 한 행을 가리킵니다.
-
Imanol Schlag, Kazuki Irie 및 Jürgen Schmidhuber, "Linear Transformers Are Secretly Fast Weight Programmers", ICML 2021.
-
자유 실행(Free-running)이란 CPU가 전체 실행 과정 동안 자체 출력만을 사용하여 진행하며, 단계 사이에 참조 기계(reference machine)의 수정이 없는 것을 의미합니다.