
Prophet과 시계열 기반 모델로 전력 수요를 예측하기: 효과적이었던 것은 모델이 아닌 기온이었다
요약
전력 수요 예측에서 Prophet 같은 시계열 모델 자체의 성능보다, 기온을 공변량(covariate)으로 활용하는 것이 훨씬 효과적임이 입증되었습니다. 특히 단순한 일평균 기온 대신 냉방도일(CDD)이나 난방도일(HDD)과 같이 임계값 기반 변환을 사용했을 때 예측력이 극대화됩니다.
핵심 포인트
- 전력 수요 예측은 모델 자체보다 공변량 활용이 중요함.
- 단순 일평균 기온 대신 냉방/난방도일을 사용해야 효과적임.
- 기온과 전력 수요의 관계는 V자 형태를 띠므로 변환 필요.
본 기사는 Neurogica Tech Blog의 재가공(転載)입니다.
'수요 예측은 Prophet으로 충분하다'라고 생각하는 사람도 있을지 모릅니다. 도쿄전력 파워그리드가 공개한 일별 최대 전력 9년치를 대상으로 검증했을 때, Prophet (Meta에서 공개한 시계열 예측 라이브러리)는 '7일 전 값을 그대로 복사하는' 예측에 대해 통계적으로 유의미한 차이를 보이지 못했습니다(p=0.107).
도전(東電) 지역의 일 최대 전력 9년치를 대상으로, 14일 앞 예측을 26회 반복하여 평가했습니다. 결론은 다음 세 가지입니다.
- 기온을 공변량으로 제공하는지 여부가 모델 차이보다 효과적이다.
공변량(예측하려는 값 외적인 변수. 여기서는 기온)을 넣으면 Prophet, Chronos-2, TimesFM 2.5 모두 오차가 41~46% 감소했습니다. 공변량이 있는 모델들 간의 차이는 최대 19%에 불과합니다. - 순수한 기온 자체를 제공해도 효과가 없다.
일평균 기온을 그대로 설명 변수로 사용하면 평일 수요의 변동성을 2.8%밖에 설명하지 못합니다. 냉방도일(冷房度日) 또는 난방도일에 변환하면 최대 80.1%까지 상승합니다. - 순수한 Prophet은 '7일 전 값을 복사하는' 예측에 유의미한 차이를 보이지 못한다.
p=0.107로, 26 fold(검증 분할) 중 18승을 거두었습니다. 모델을 사용하고 있다는 것과 실제로 예측이 가능하다는 것은 별개의 문제입니다.
기온과 수요는 V자 형태를 이룬다
검증 설계에 들어가기 전에, 이 시계열의 특성을 파악해 둘 필요가 있습니다. 전력 수요와 기온의 관계는 선형적이지 않습니다. 아래 그림 1은 9년치 일별 데이터를 기온 순으로 정렬한 것입니다.
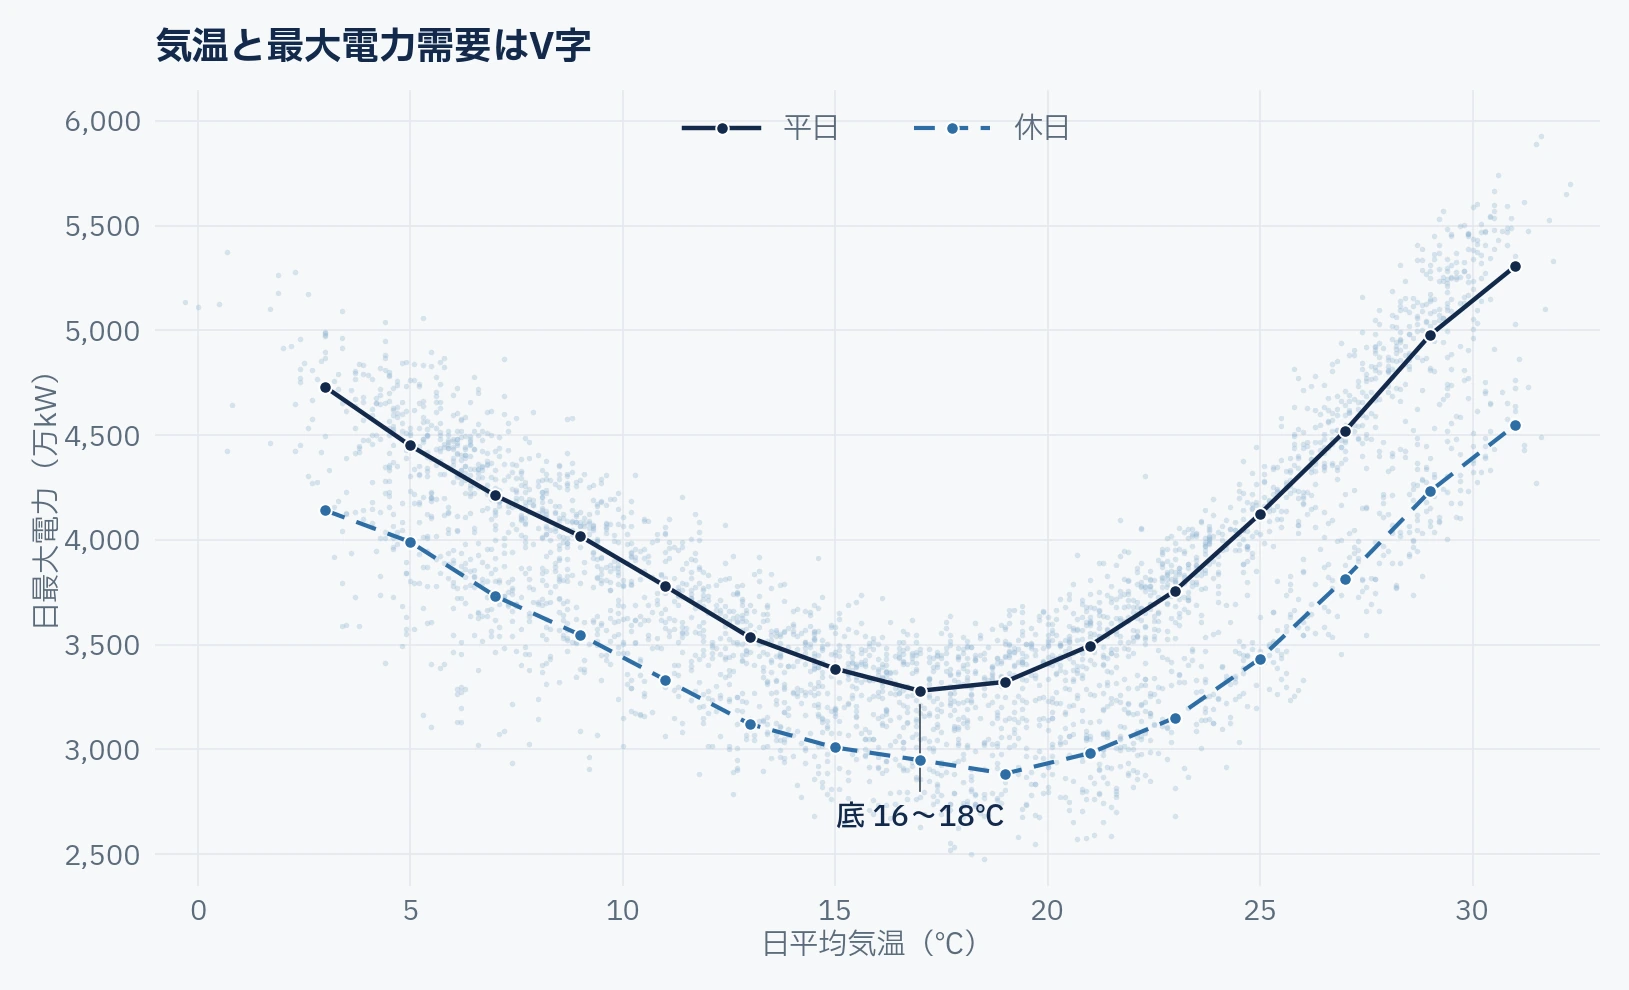
그림 1: 도전 지역의 일 최대 전력(시간대별 실측 일일 최대값)과 도쿄의 일평균 기온. 2016년 4월부터 2025년 7월까지 3,399일. 선은 기온 2℃ 간격의 빈 평균으로, 각 빈에 20일 이상 있는 경우만 표시했습니다. 평일 수요는 1618℃에서 바닥을 치고, 거기서부터 3032℃에서는 61.8%, 2~4℃에서는 44.2% 높아집니다(작도).
바닥을 중심으로 양쪽으로 솟아오르기 때문에, 기온을 그대로 설명 변수로 주더라도 직선으로는 포착할 수 없습니다. 실제로 평일만 가지고 단회 회귀를 걸면 다음과 같습니다. 이후 표에서는 열 이름의 ↑가 값이 높은 쪽이 좋은 지표이고, ↓가 낮은 쪽이 좋은 지표임을 나타냅니다.
| 설명 변수 | 상관계수 r ↑ | 결정계수 R² ↑ |
|---|---|---|
| 일평균 기온(그대로), 1개 | +0.169 | 0.028 |
| 냉방도일과 난방도일을 더해 1개 | +0.895 | 0.801 |
냉방도일 및 난방도일은 임계값으로부터의 편차를 한쪽만 취하는 변환입니다. 냉방도일은 20℃를 초과한 분량만 계산하므로, 25℃인 날은 5가 되고, 18℃인 날은 0이 됩니다. 난방도일은 12℃ 미만인 분량만 계산하므로, 8℃인 날은 4가 되고, 18℃인 날은 0이 됩니다. V자 양팔을 접어 되돌리는 처리로 설명력이 2.8%에서 80.1%로 바뀝니다. 임계값은 냉방 측 1627℃, 난방 측 619℃를 1℃ 간격으로 전수 조사하여 선택했습니다.
위 표는 둘 다 설명 변수 1개의 단회 회귀이므로, r은 단순 상관계수입니다. 냉방도일과 난방도일은 더해서 1개로 통합했습니다. 반면 이후의 검증에서는 이 두 가지를 별도의 설명 변수로 모델에 전달하고 있습니다. 2개로 나누어 중회귀를 걸 경우 결정계수는 0.802로, 합쳐서 1개로 한 0.801과 거의 차이가 없습니다. 중회귀의 상관은 다중 상관계수가 되므로, r은 병기하지 않았습니다.
데이터
사용된 것은 모두 공개 데이터입니다. 출처와 기간을 다음에 제시합니다.
| 항목 | 내용 |
|---|---|
| 종속 변수 | 도전 지역의 일 최대 전력(만kW) |
| ... |
평균은 휴일 평균보다 15.2% 높습니다. 그림 1에서 진한 남색과 파란색 선이 위아래로 떨어져 있는 것이 이 차이입니다.
검증은 2026년 8월에 실시했습니다. 수요 측은 24시간 모두 갖춰진 날만 채택했습니다. 기간이 2025년 7월 21일에서 끊겨 있는 것은, 검증에 준비한 시간대별 실측 파일이 여기까지였기 때문입니다. 따라서 평가 기간은 이 기사 공개 시점으로부터 약 1년 전까지를 대상으로 하고 있습니다.
검증 방법
실측 파일이 여기까지였기 때문입니다. 따라서 평가 기간은 이 기사 공개 시점으로부터 약 1년 전까지를 대상으로 하고 있습니다.
검증 방법
| 항목 | 설정 |
|---|---|
| 예측 호라이즌 (한 번에 몇 일 앞까지 예측할지) | 14일 앞 |
| ... | |
| MASE는 예측의 평균 절대 오차를 '학습 기간 내에서 7일 전 값을 복사했을 때의 평균 절대 오차'로 나눈 값입니다. Hyndman 등이 [1] 제안한 지표로, 단위에 의존하지 않으며, 1.0은 '학습 기간의 주간 Naive와 동일 수준'을 의미합니다. 이 분모는 fold마다 학습 기간에서 계산했으며, 이번에는 26 fold의 평균으로 342.7만 kW (범위 339.8~345.1)였습니다. 지표 자체 선택이 결론에 영향을 미치는 문제에 대해서는 본 블로그에 오차 지표와 의사결정을 다룬 글이 있습니다. |
비교한 것은 다음의 7 구성입니다.
SeasonalNaive(7)
: 7일 전 값을 그대로 복사합니다. 하한선 베이스라인입니다. 본문에서는 이후 '주간 Naive'라고 부르며, 표와 그래프에서는 SeasonalNaive(7)로 표기합니다.
-Prophet
과Prophet +XReg:
: 연 주기・주 주기・일본 공휴일, 승법 계절성 (계절 변동을 수준에 더하는 것이 아니라 곱하는 형태로 설정). XReg는 외생 설명 변수(예측하고 싶은 값의 바깥에서 영향을 주는 변수)의 약자입니다. XReg가 있는 구성에서는 냉방 일수・난방 일수를 add_regressor로 추가했습니다.
-Chronos-2
과Chronos-2 +Cov:
: amazon/chronos-2 (약 1.2억 파라미터). 공변량을 모델 내부에서 다루도록 설계했기 때문에 접미사도 API의 용어에 맞춰 +Cov로 했습니다.
-TimesFM-2.5
과TimesFM-2.5 +XReg:
: google/timesfm-2.5-200m-pytorch (약 2.3억 파라미터)
공변량을 넣는 방식은 두 모델에서 다릅니다. Chronos-2는 모델 내부의 입력으로 받고, TimesFM 2.5의 XReg는 공변량에 대한 리지 회귀(계수가 너무 커지지 않도록 억제한 선형 회귀)를 외부에 두고, 그 잔차를 본체가 예측합니다.
결과
그림 2에 평균 MASE를 보여줍니다. 진한 남색이 기온을 준 구성이고, 연한 하늘색이 주지 않은 구성입니다.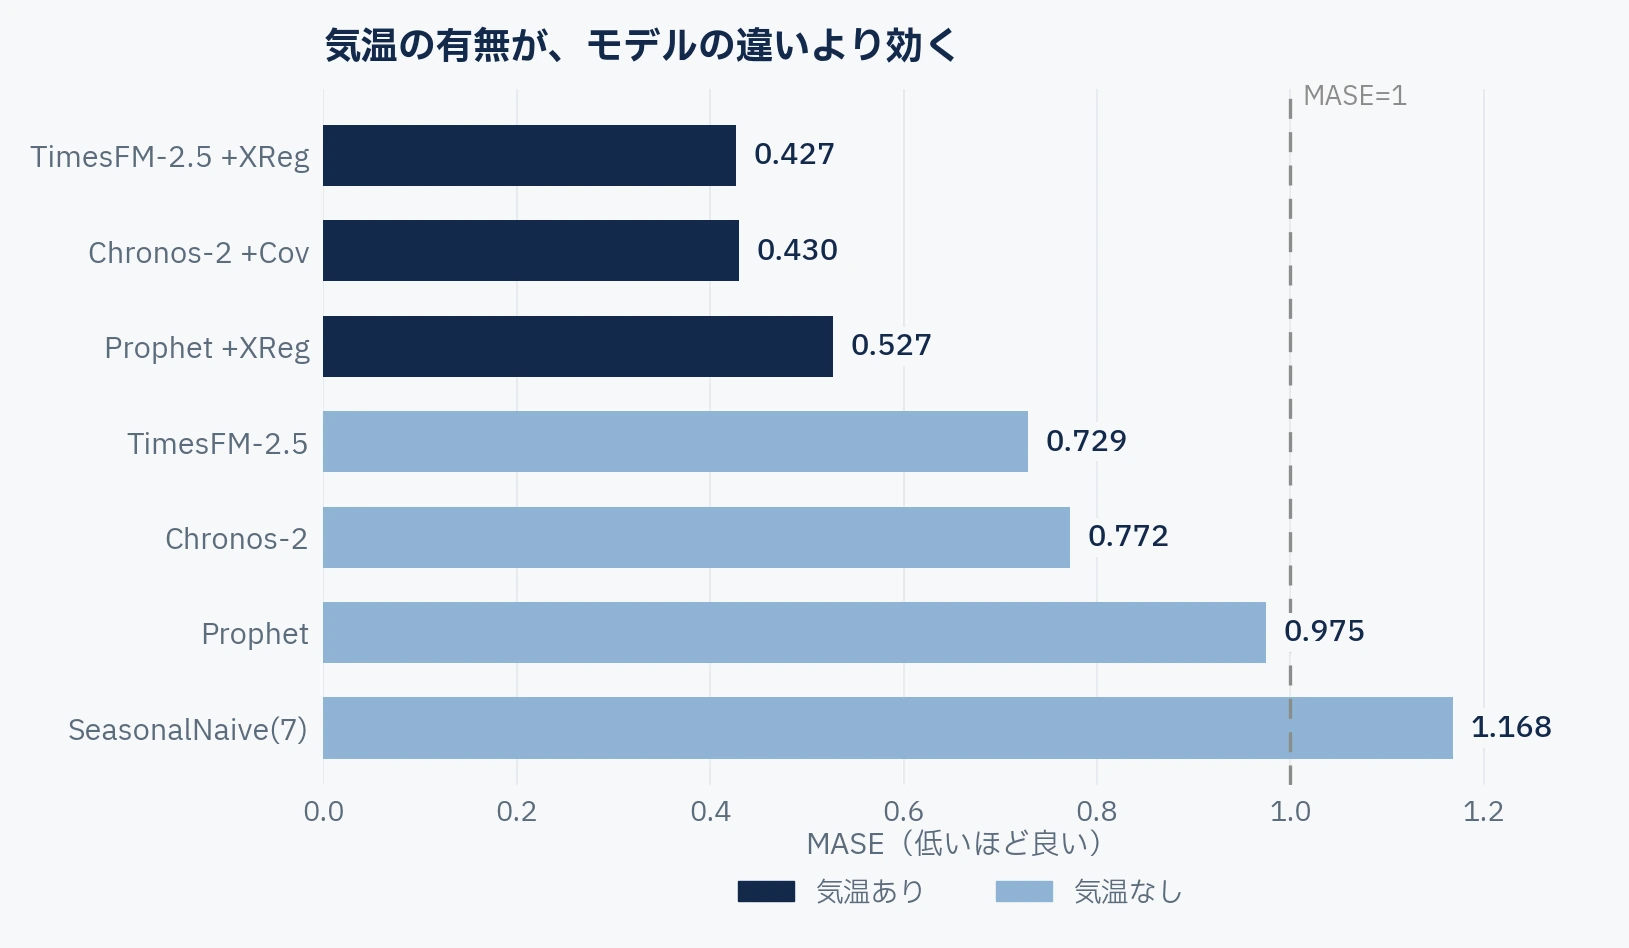
그림 2: 26 fold의 평균 MASE. 낮을수록 좋습니다. 점선 MASE=1은 학습 기간의 주간 Naive와 동일 수준 위치를 나타냅니다. 기온을 준 3구성(진한 남색)이 0.4270.527에 모여 있고, 주지 않은 4구성(연한 하늘색)은 0.7291.168로 나뉘어 있습니다 (작도)
수치로 나열하면 다음과 같습니다. 각 열의 최저값을 굵게 표시하고, MASE가 좋은 순서대로 아래에서 나열했습니다.
| 모델 | MASE ↓ | sMAPE ↓ | MAE(만kW) ↓ | RMSE ↓ | WQL ↓ |
|---|---|
SeasonalNaive(7) | 1.168 | 10.34% | 399.8 | 493.5 | 해당 없음 |
| ... | 147.2 | 187.0 | 0.0304 | |
| TimesFM-2.5 +XReg | 0.427 | 3.79% | 146.2 | 177.6 | 해당 없음 |
MAE(평균 절대 오차) 146.2만kW는 평가 기간의 평균 수요에 비례하여 3.83%에 해당합니다. 참고로 병기한 sMAPE는 오차를 실측값과의 비율로 본 지표, RMSE는 큰 이상치를 무겁게 계산하는 지표, WQL은 예측 구간의 적중도를 측정하는 지표이며, 모두 낮을수록 좋습니다. 순위는 MASE와 변함이 없습니다.
26 fold 예측에 걸린 시간(CPU만, 가중치 로딩 제외)은 Prophet이 6.6초, Prophet +XReg가 10.0초, 기반 모델은 4.2~8.8초였습니다. 기반 모델로 바꿔도 느려지지는 않습니다.
차이가 우연이 아님을 확인하기
평균값의 차이만으로는 우연히 좋았던 해의 영향을 부정할 수 없습니다. 그래서 26 fold의 오차를 쌍으로 만들어 순열 검정(분포 모양을 가정하지 않고 '차이가 우연히 이 정도가 될 확률'을 계산하는 방법)을 했습니다.
Prophet에 기온을 주자, MASE는 0.975에서 0.527로 떨어졌고, 26 fold 중 24승, p값은 0.0001 미만이었습니다. 우연이라고 생각하기 어렵습니다. Chronos-2와 TimesFM 2.5도 마찬가지로 각각 23승, p값은 0.0001 미만입니다. 개선율은 41~46%였고, 이에 비해 공변량끼리 비교한 차이는 19%에 그쳤습니다.
반면 순수 Prophet과 주간 Naive의 차이는 평균에서 0.975와 1.168이지만, 18승에 p=0.107에 머물렀습니다. fold별 변동을 생각하면 차이가 있다고 말하기 어렵습니다.
여름은 어떤 모델도 오차가 벌어진다
図3은 26 fold의 MASE를 시간 순서대로 나열한 것입니다. 음영 처리된 부분은 여름 기간을 나타냅니다.
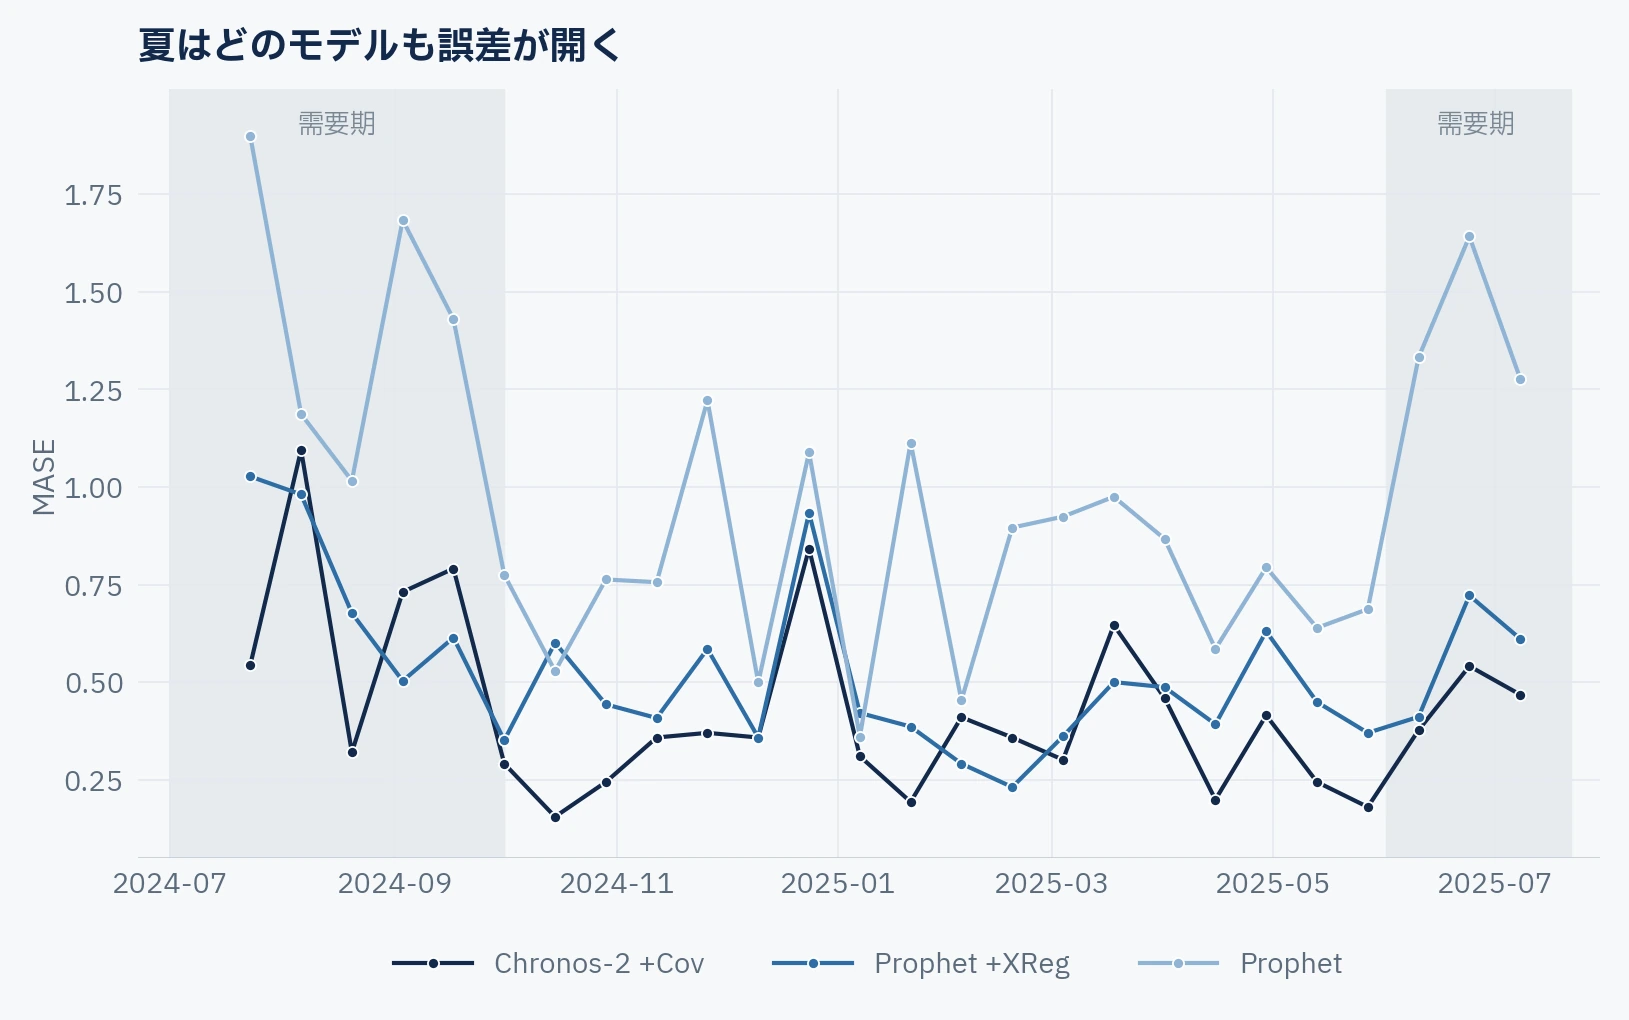
그림 3: 각 fold의 시작일을 가로축으로 한 MASE 추이. '수요기'와 음영 처리된 구간은 2024년 7월부터 9월, 그리고 2025년 6월부터 7월 21일입니다. 이 구간에서 세 구성 요소 모두가 상향 조정되었으며, 공변량(covariate)이 없는 Prophet (옅은 하늘색)의 변동폭이 큽니다. 가독성을 위해 7개 구성 중 3개를 표시했습니다 (작도)
fold 시작 월을 6월~8월로 하여 여름으로 간주하고, 이를 4개의 계절에 할당했을 때, 계절별 평균 MASE는 다음과 같습니다. 행의 순서는 결과표와 동일하게 전체 MASE가 좋은 순서이며, 계절별로 보면 순위가 바뀝니다. 그림 3의 음영 처리된 부분은 수요가 증가하는 시점에 가져온 것이기 때문에, 이 표의 계절 구분과는 범위가 일치하지 않습니다.
| 모델 | 봄 (3월~5월 시작) ↓ | 여름 (6월~8월 시작) ↓ | 가을 (9월~11월 시작) ↓ | 겨울 (12월~2월 시작) ↓ |
|---|---|---|---|---|
| SeasonalNaive(7) | 0.956 | 1.399 | 1.078 | 1.287 |
| ... | 0.544 | 0.427 | 0.412 | |
| TimesFM-2.5 +XReg | 0.383 | 0.532 | 0.392 | 0.412 |
여름이 약점이 되는 점은 7개 구성 요소 모두에 공통적입니다. 공변량이 없는 Prophet은 여름에 MASE가 1.385까지 악화되며, 주간(weekly) Naive의 1.399에 근접합니다. 폭염일의 수요 급증은 주 주기와 연 주기 분해만으로는 표현할 수 없습니다.
공변량은 최악의 경우에도 효과를 발휘했습니다. 공변량이 없는 3개 구성 요소는 최악의 fold에서 MASE가 1.421.90까지 떨어졌으나, 공변량이 있는 경우에는 0.781.10에 머물렀습니다. 운영(operation)에서 오차의 상한을 보장해야 하는 상황에서는 평균보다 이쪽이 중요하다고 생각합니다.
구간 여부에 따라 나뉜다
공변량을 넣는 방식은 정확도뿐만 아니라 출력 형태도 변화시킵니다. TimesFM 2.5의 XReg는 공변량에 대한 회귀를 본체 외부에 붙이는 구성이므로, 공변량을 사용하면 분위수점(quantile; 분포 내에서 '아래부터 몇 %'에 해당하는 값)을 얻을 수 없고 점 예측(point forecast)만 반환합니다. Chronos-2는 공변량을 모델 내부에서 처리하기 때문에, 공변량이 있어도 예측 구간이 남아 있습니다.
점 예측의 정확도는 두 가지가 거의 비슷했습니다 (MASE 0.427과 0.430). 하지만 수급 계획처럼 '상향 조정(upward swing)이 몇 % 확률로 일어날지'를 사용하는 상황에서는, 구간을 얻을 수 있는지 여부가 의사결정을 가릅니다. 구간까지 필요하다면, 이번 구성에서 선택할 것은 Chronos-2가 됩니다.
이 검증의 한계
기온은 실측값(actual value)을 제공한다. 실제 운영에서는 기상 예보를 사용하므로, 예보 오차만큼 악화됩니다. MASE 0.43은 실제 운영 기대값이 아닙니다 -
임계치(threshold; 20℃・12℃)는 전 기간에서 선택했다. 다만 각 fold의 학습 기간만으로 다시 정해도 같은 값이 나왔기 때문에, 결론은 변하지 않습니다 -
Prophet은 고정값이다. changepoint_prior_scale
등을 채워 넣으면 Prophet +XReg는 발전할 여지가 있습니다. 일별/단일 계열의 결과이므로, 시간 값처럼 일내 주기(intra-day cycle)가 들어가는 계열에서는 달라질 수 있습니다 -
기반 모델은 제로샷(zero-shot)으로 사용했다. 사전 학습 데이터에 평가 기간과 겹치는 공개 데이터가 포함될 가능성을 배제할 수 없습니다
요약
- 대상 계열이 기온 같은 외생 변수(exogenous factor)로 움직인다면, 모델을 바꾸기 전에 공변량을 설계해야 합니다. 이번에는 공변량 유무에 따라 41~46%, 모델 차이에 따라 19%였습니다.
- 다만 원시 변수(raw variable)를 그대로 주어도 효과가 없는 경우가 있습니다. V자형이라면 냉방일/난방일처럼 접어 넣어야 합니다. 결정 계수 0.028과 0.801의 차이는 여기서 생겼습니다.
- 공변량을 넣는 방식은 출력 형태도 변화시킵니다. 외부에 붙여 회귀로 넣으면, 예측 구간이 없어질 수 있습니다.
순수한 Prophet이 주간 Naive와 유의미한 차이를 보이지 않았던 점은 이번 검증에서 예상 밖이었습니다. 모델을 배치하는 것과 예측할 수 있는 것은 별개입니다. 단순한 베이스라인이 정교한 기법과 나란히 놓이는 구도는 시계열 예측에서는 반복적으로 보고됩니다. 본 블로그의 LLM(Large Language Model)을 이용한 시계열 예측 관련 글에도, LLM 부분을 제거해도 정확도가 떨어지지 않았던 검증이나, 선형 1층 모델이 Transformer 계열을 능가했다는 보고 등이 정리되어 있습니다. 자신이 가진 모델을 주간 Naive 같은 단순한 베이스라인과 나란히 테스트(backtest)하지 않았다면, 거기서 시작할 가치가 있다고 생각합니다.
절차로 하면 다음의 순서가 됩니다.
우리가 가진 모델과 주간 나이브(weekly naive) 예측을 backtest로 비교하여 그 차이가 우연의 범위인지 확인합니다.
목표 변수를 움직이는 외생 변수(exogenous variables)를 찾아냅니다.
그 변수와 목표 변수의 관계를 산점도(scatter plot)로 보고, 비선형적이라면 뒤집은 후 공변량(covariate)으로 넣습니다.
참고문헌
[1] Rob J. Hyndman, Anne B. Koehler. "Another look at measures of forecast accuracy." International Journal of Forecasting(예측 연구의 국제 학술지), 22(4), 679-688, 2006. DOI: 10.1016/j.ijforecast.2006.03.001
논의

AI 자동 생성 콘텐츠
본 콘텐츠는 Zenn ML의 원문을 AI가 자동으로 요약·번역·분석한 것입니다. 원 저작권은 원저작자에게 있으며, 정확한 내용은 반드시 원문을 확인해 주세요.
원문 바로가기