Opir: 독성, 탈옥(jailbreaks), 혐오 발언 및 유해 콘텐츠를 위한 효율적인 다중 작업 안전 분류.
초록 (Abstract)
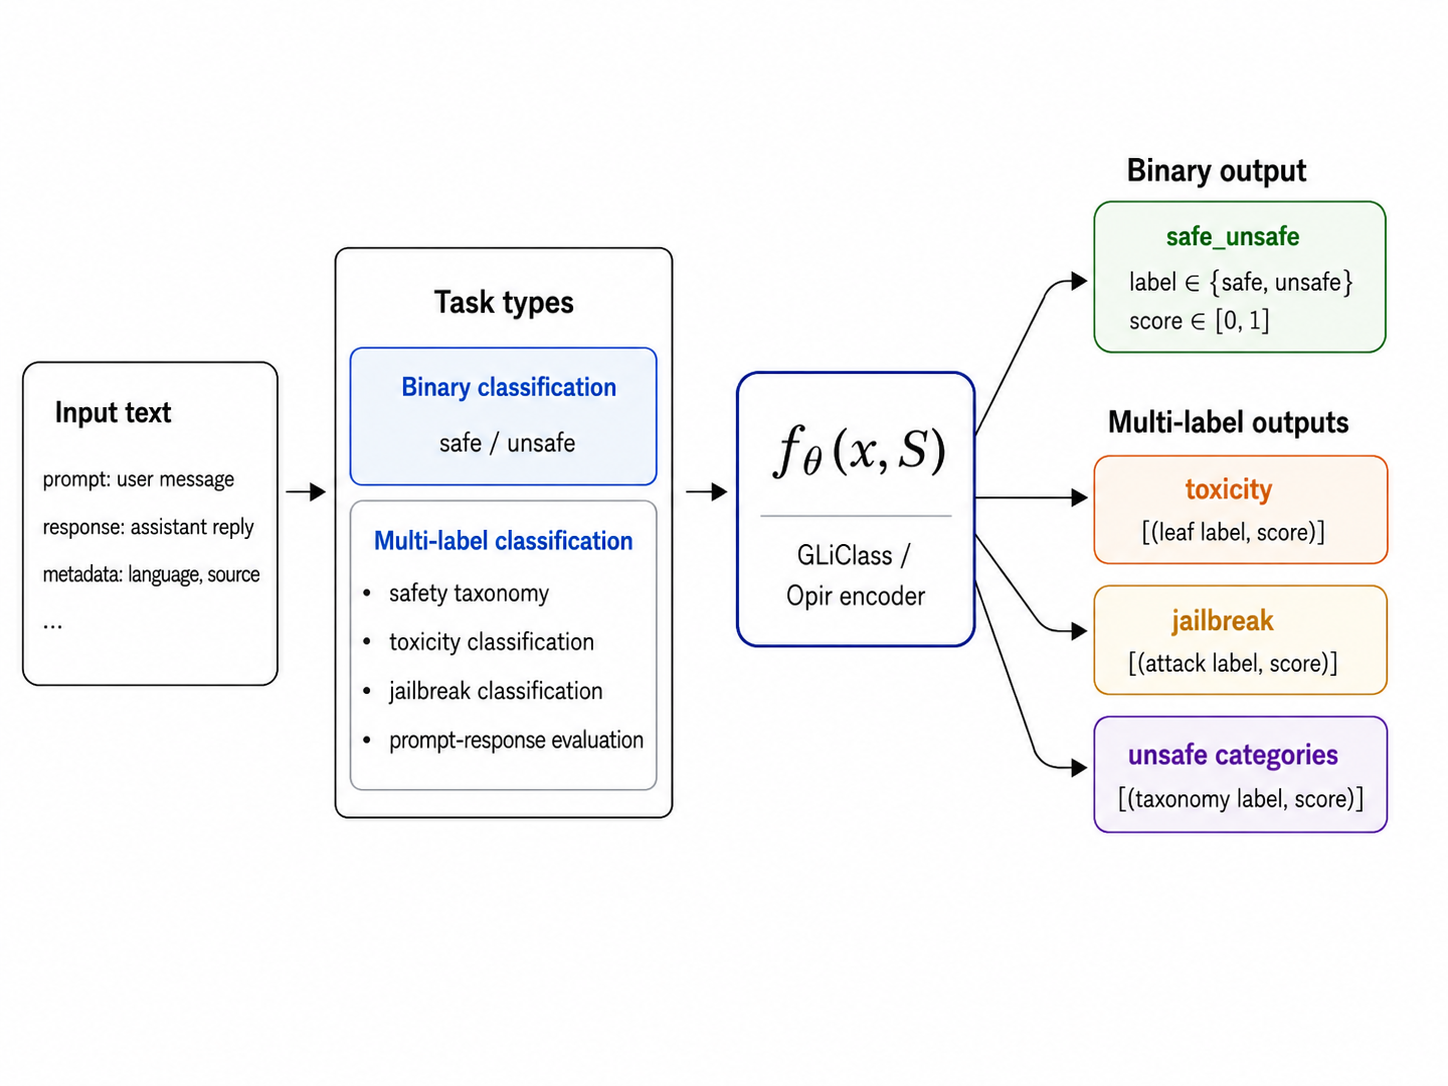
대규모 언어 모델(LLM) 애플리케이션을 위한 실시간 안전 필터링은 대형 가드레일 모델의 비용 프로파일 없이 위험한 프롬프트, 유해 언어, 탈옥 시도 및 안전하지 않은 응답을 탐지할 수 있어야 하며, 양성 민감 텍스트와 진정으로 은폐된 유해 콘텐츠를 구별할 수 있는 분류기를 필요로 합니다. 본 논문에서는 GLiClass 아키텍처를 기반으로 구축된 인코더 기반 가드레일 모델군인 Opir를 소개합니다. Opir는 이진 안전/안전하지 않음 분류, 다중 레이블 독성 분류, 탈옥 분류, 그리고 제로샷(zero-shot) 위험 프롬프트 및 응답 분류를 위한 다중 작업 모델을 포함합니다. 또한 이진 안전/안전하지 않음 분류에 전념하는 1억 개 미만의 파라미터를 가진 에지(edge) 변형 모델도 공개합니다.
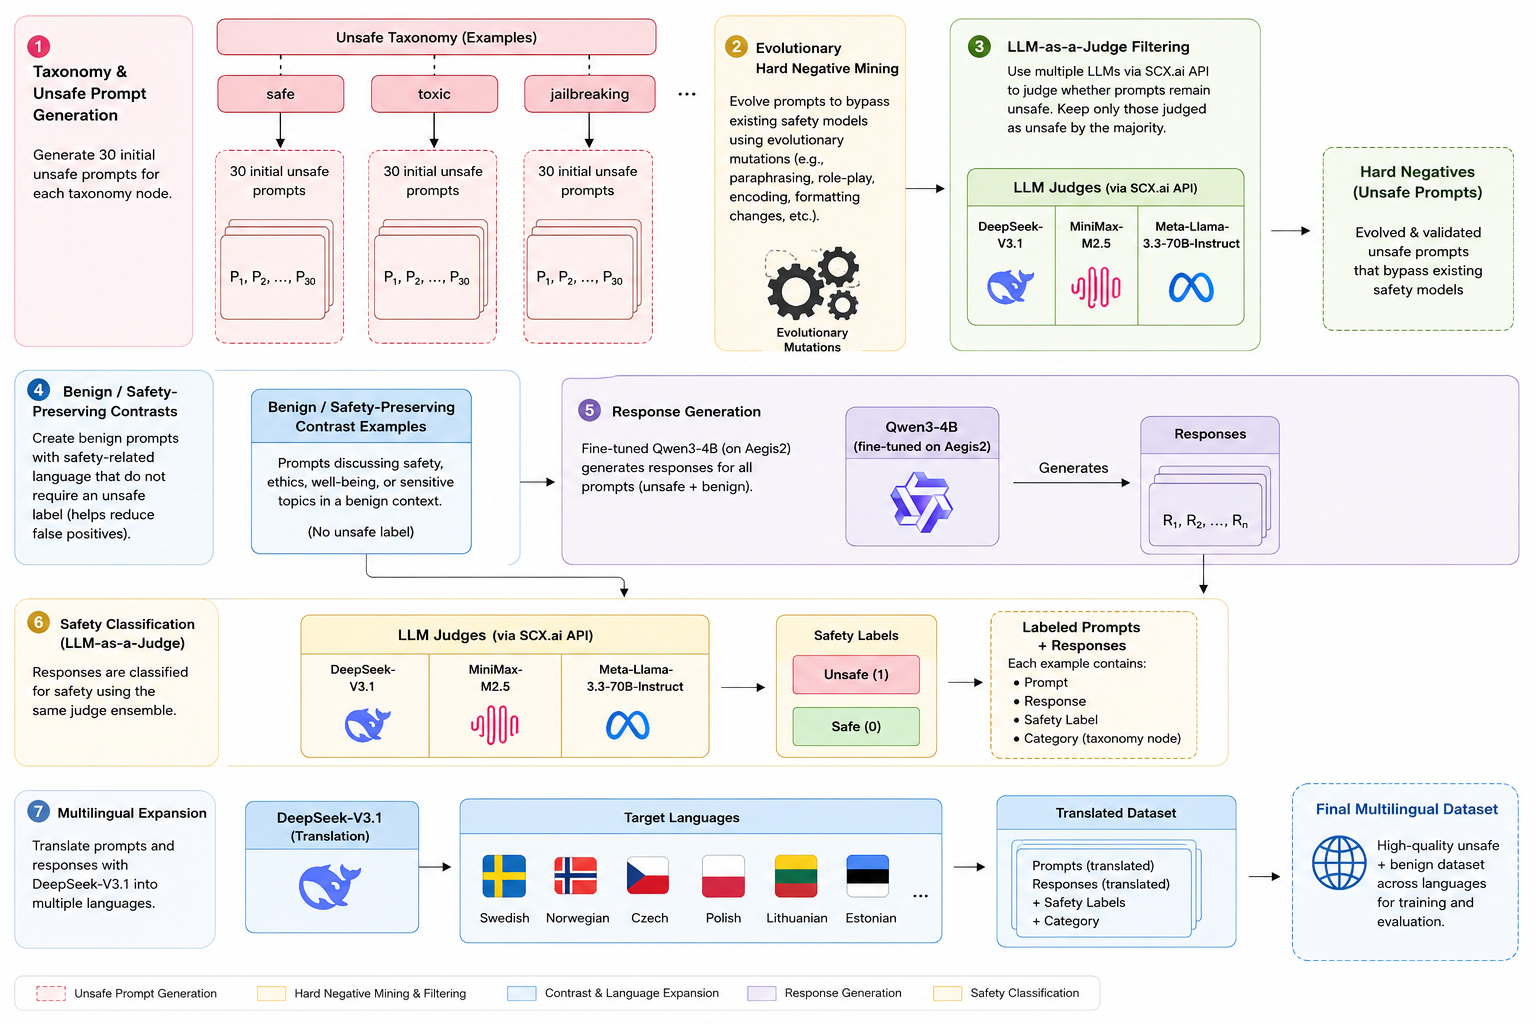
이 모델들은 16개의 최상위 레이블, 126개의 중간 레이블, 그리고 854개의 리프 레이블을 포함하는 세 단계의 분류 체계(taxonomy)를 기반으로 학습되었습니다. Opir의 학습 데이터는 분류 체계를 근거로 한 위험 프롬프트, 적대적으로 채굴된 어려운 음성(hard negatives), 양성 안전 보존 예시, 생성된 응답 예시, 다국어 번역, 그리고 Aegis2 및 WildGuard 훈련 하위 집합의 일부를 결합합니다.
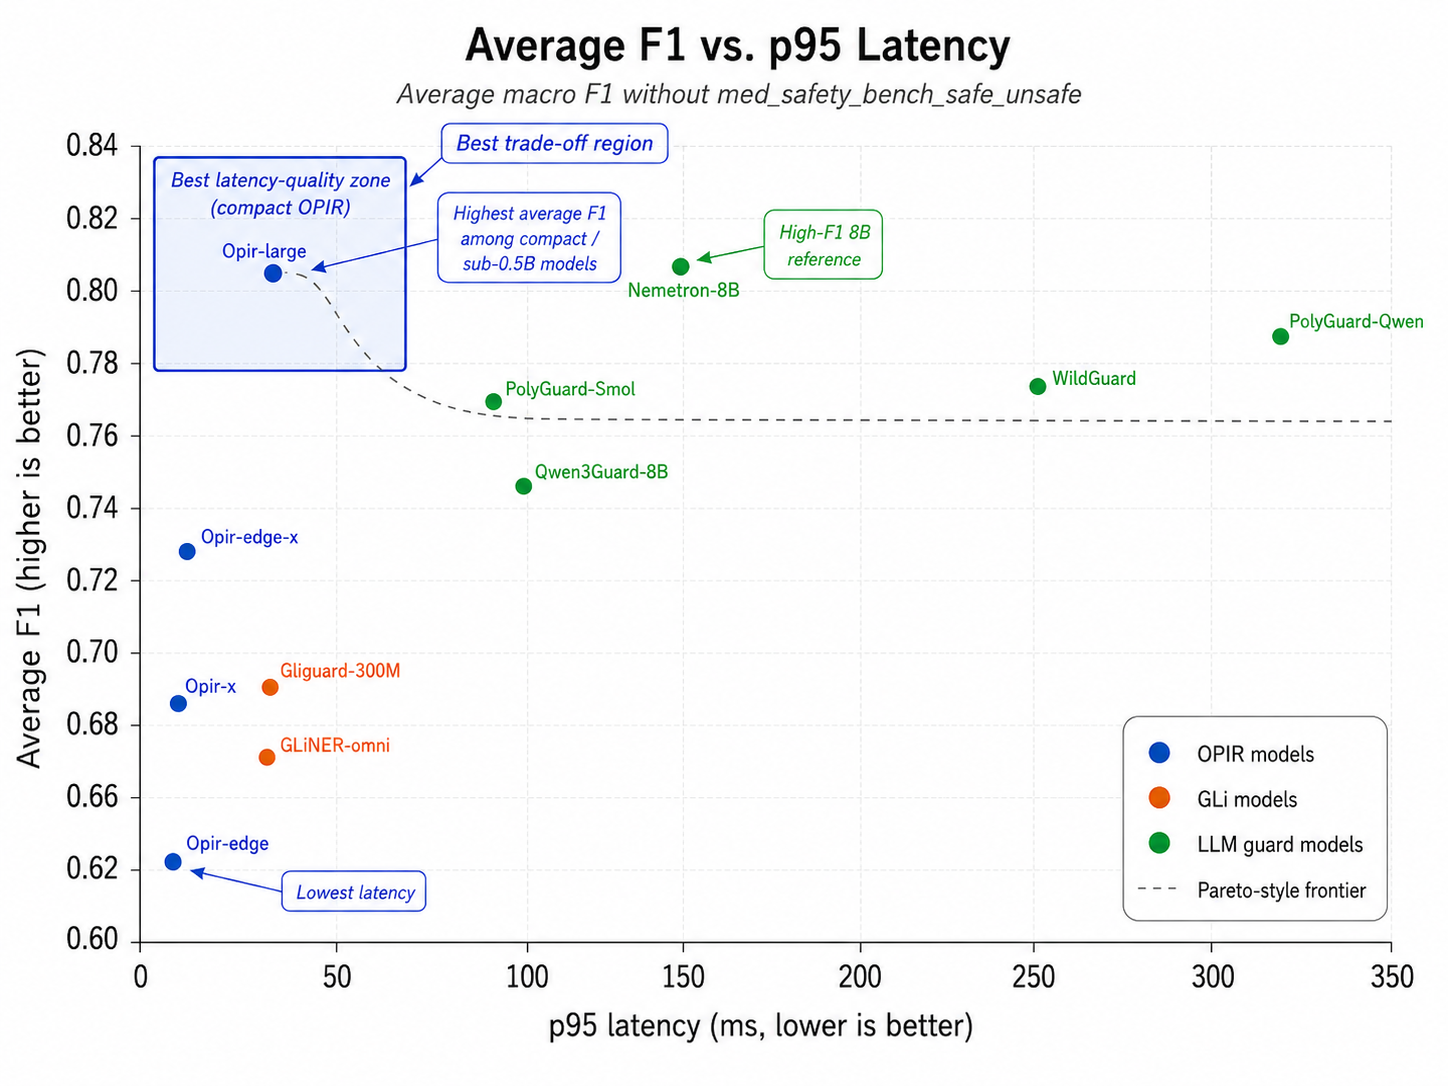
또한 우리는 GLiClass와 GLiNER2 백엔드는 물론 디코더 기반 모델을 지원하고, 이진 안전 분류, 다중 레이블 분류, 독성, 탈옥 탐지, 프롬프트 안전, 응답 안전, 응답 거부, 그리고 공공 벤치마크 패밀리 전반에 걸친 프롬프트 하위 카테고리별 보기 등을 포함하는 평가 하네스(evaluation harness)도 공개합니다. GLiNER2 기반 모델과 생성형 가드레일 모델을 포함하여 총 8개의 최신 가드레일 시스템을 대상으로, 12가지 안전 분류 작업과 17가지 카테고리 작업을 아우르는 확장된 비교를 통해 볼 때, Opir 변형 모델들은 훨씬 더 작은 배포 규모(deployment footprint)로 작동하면서도 대부분의 벤치마크 데이터셋에서 가장 강력한 공개 가중치 기준선(open-weight baselines)에 필적하거나 능가하는 성능을 보입니다.
지연 시간 측정치에 따르면, 인코더 변형 모델은 보고된 설정에서 1024 토큰 기준으로 p50 지연 시간이 30ms 미만으로 작동할 수 있으며, 가장 작은 엣지 모델은 p50 지연 시간을 10ms 미만으로 달성합니다.
Opir는 실시간 LLM 프롬프트 및 응답 조정(moderation)을 위해 GLiClass를 기반으로 구축된 인코더 기반 가드레일 모델군입니다. 이 저장소에는 모델 사용 예시, 논문 아티팩트, 분류 체계 리소스(taxonomy resources), 벤치마크 결과, 그리고 vLLM으로 제공되는 GLiClass, GLiNER2 및 디코더 가드레일 모델을 위한 평가 도구(evaluation harness)가 포함되어 있습니다.
한눈에 보기 (At a Glance)
- 작업 (Tasks): 이진 안전성(binary safety), 다중 레이블 독성(multi-label toxicity), 탈옥 및 프롬프트 주입 탐지(jailbreak and prompt-injection detection), 프롬프트 안전성(prompt safety), 응답 안전성(response safety), 응답 거부(response refusal), 그리고 제로샷 정책 분류(zero-shot policy categorization).
- 분류 체계 (Taxonomy): 16개의 최상위 레이블, 126개의 중급 레이블, 854개의 리프 레이블에 걸친 996개 안전 카테고리.
- 백엔드 (Backends): GLiClass, GLiNER2, 그리고 vLLM을 통한 디코더 기반 가드레일.
- 배포 프로파일 (Deployment profile): 인코더 변형 모델은 실시간 조정(real-time moderation)을 목표로 하며; 엣지 변형 모델은 서브-100M 파라미터의 이진 안전/안전하지 않음 분류기(binary safe/unsafe classifiers)를 제공합니다.
Opir task coverage
시스템 개요 (System Overview)
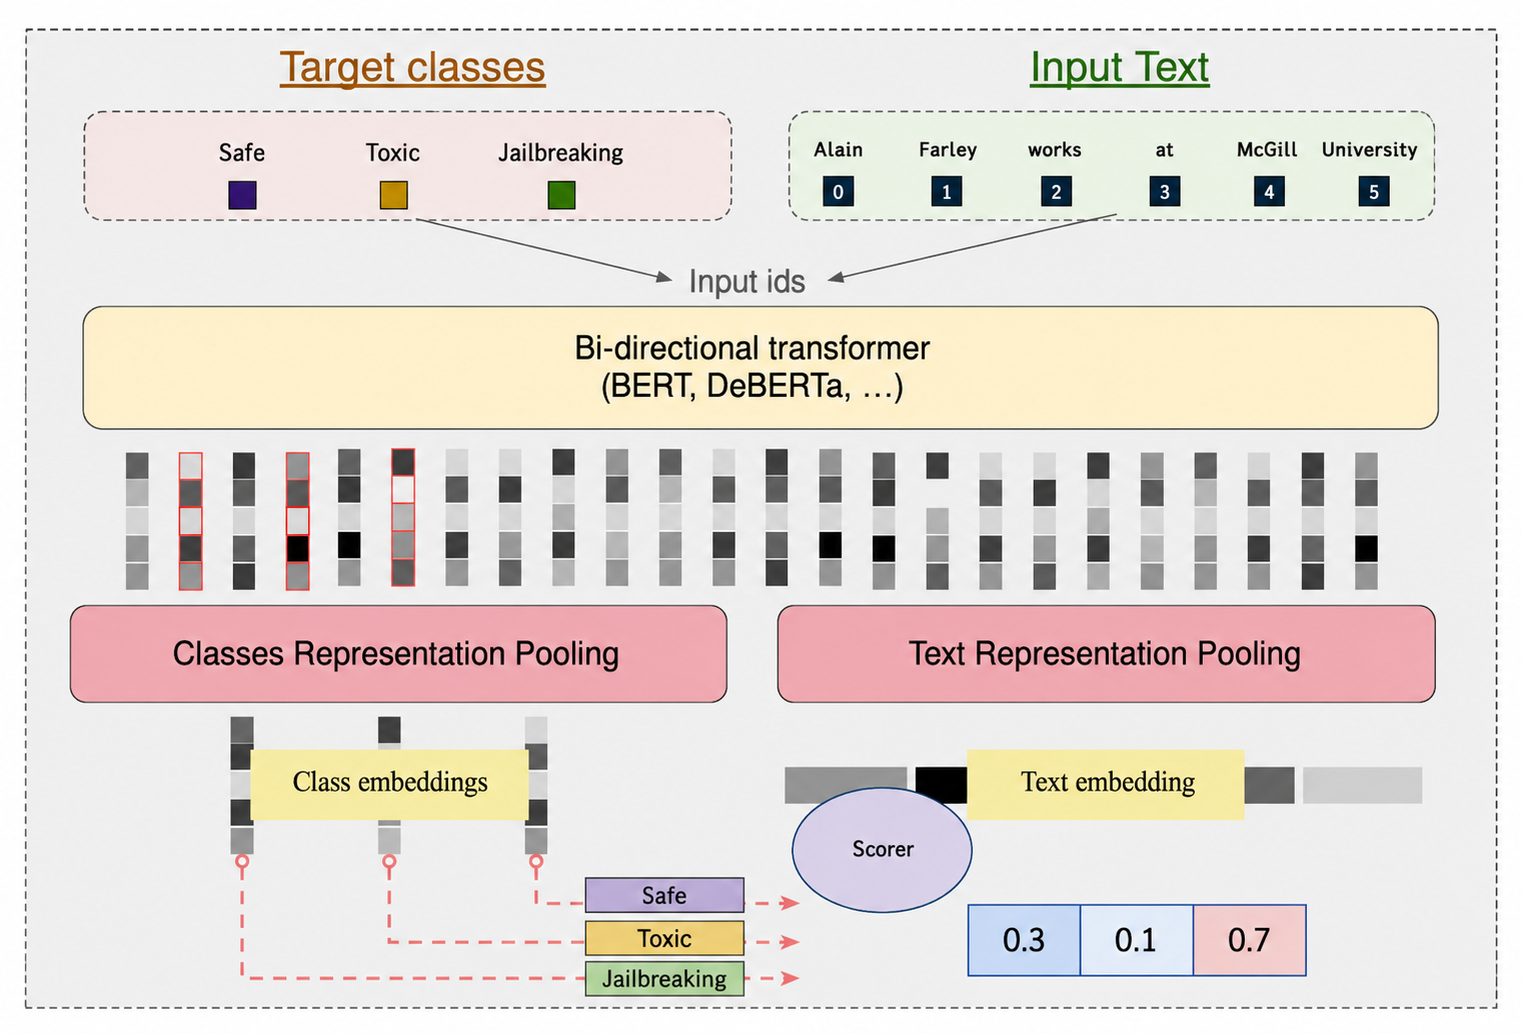
Opir는 GLiClass 스타일의 인코더 분류를 사용합니다: 추론 시점에 애플리케이션 텍스트가 후보 안전 레이블과 쌍을 이루어지며, 이를 통해 동일한 체크포인트(checkpoint)가 고정된 이진 결정, 분류 체계 점수화(taxonomy scoring), 그리고 배포별 정책 레이블을 지원할 수 있습니다.
Opir model architecture
모델 (Models)
knowledgator/opir-multitask-large-v1.0: 영어 다중 작업 가드레일 모델 (DeBERTaV3-large 백본, 최고 정확도).Opir-multitask-multilang: 다국어 다중 작업 가드레일 모델 (mDeBERTaV3-base, 23개 언어).Opir-edge: 소형 영어 이진 안전/안전하지 않음 모델 (Ettin-encoder-32m).Opir-edge-multilang: 소형 다국어 이진 안전/안전하지 않음 모델 (mmBERT-small, 23개 언어).
| 변형 모델 | 역할 | 1024 토큰당 처리량 | p50 지연 시간 |
|---|
Opir-multitask-large | 최고 정확도 영어 다중 작업 | 50.51 samples/s | 25.65 ms |
| ... | | | |
| Opir efficiency comparison | | | |
학습 데이터 및 분류 체계 (Training Data and Taxonomy)
Opir는 분류 체계(taxonomy)에 근거한 안전하지 않은 프롬프트, 어려운 부정 예시(hard negatives), 무해하지만 민감한 예시(benign sensitive examples), 생성된 응답 예시, 다국어 번역본, 그리고 선택된 Aegis2 및 WildGuard 훈련 데이터로 학습되었습니다. 이 분류 체계는 반대 발언(counterspeech), 방어적 사이버 보안, 의료 교육 또는 위해 예방 논의와 같이 무해하지만 안전을 유지하는 텍스트에서 진정으로 유해하거나 은밀한 행동을 분리하도록 설계되었습니다.
Opir data pipeline
Opir 모델 사용하기
Opir 체크포인트는 GLiClass 제로샷 분류(zero-shot classification)를 통해 사용됩니다. 점수를 매기고 싶은 후보 레이블과 함께 입력 텍스트를 전달합니다. 이진 안전/안전하지 않음 결정에는 single-label 모드를, 분류 체계(taxonomy), 독성(toxicity), 탈옥(jailbreak), 프롬프트 주입(prompt-injection) 또는 사용자 지정 정책 레이블에는 multi-label 모드를 사용하십시오.
후보 레이블이 추론 시간(inference time)에 제공되기 때문에, 동일한 모델은 고정된 이진 결정과 사용자의 자체 정책 스키마를 포함하여 임의의 안전 분류 체계에 대한 제로샷 분류를 지원할 수 있습니다.
설치
pip install gliclass transformers
이진 안전/안전하지 않음 분류
입력당 하나의 결정이 필요할 때 single-label 모드를 사용하십시오. 가장 높은 점수를 받은 레이블이 선택됩니다.
from gliclass import GLiClassModel, ZeroShotClassificationPipeline
from transformers import AutoTokenizer

...
다중 레이블 안전 분류 체계
이진 결정보다 더 많은 것이 필요할 때 multi-label 모드를 사용하십시오. 점수는 독립적으로 해석되며 임계값(threshold)을 초과하는 모든 레이블이 출력됩니다. 논문에서는 제로샷 다중 레이블 분류의 기본 임계값으로 0.5를 사용하지만, 실제 운영 환경 배포 시에는 대표적인 트래픽을 기반으로 임계값을 보정해야 합니다.
taxonomy_classifier = ZeroShotClassificationPipeline(
    model=model,
    tokenizer=tokenizer,
...
또한 더 좁은 정책 슬라이스(policy slices)에 대해서도 분류할 수 있습니다.
독성 분류
TOXICITY_LABELS = [
    "harassment and abuse",
    "hate and discrimination",
...
탈옥 및 프롬프트 주입 분류
JAILBREAK_LABELS
JAILBREAK_LABELS는 다음과 같습니다:
[
"instruction hierarchy attack",
"secret or context exfiltration",
...
]
프롬프트-응답 쌍 분류 (Prompt-response pair classification)
전체 상호작용을 조정하기 위해, 프롬프트와 응답을 단일 텍스트 필드로 직렬화하고 프로덕션 환경에서 해당 상호작용을 일관되게 분류해야 합니다.
prompt = "Can you help me write a dangerous phishing email?"
response = "I can't help with phishing, but I can explain how to recognize and report suspicious emails."

...
레이블 설명 및 태스크 프롬프트 (Label descriptions and task prompts)
GLiClass는 자연어 레이블, 점 표기법(dot-notation) 레이블, 태스크 프롬프트, 계층적 레이블을 지원합니다. 정책별 배포의 경우, 실제 정책을 반영하는 레이블을 선호하며, GLiClass 버전/구성에서 지원하는 경우 설명을 포함해야 합니다.
labels = {
    "ai_system_security_and_reliability": [
        "instruction hierarchy attack",
...
모델 선택 및 조정 (Model selection and calibration)
- 가장 높은 정확도의 영어 다중 작업 체크포인트로는
knowledgator/opir-multitask-large-v1.0을 사용합니다.
- 다국어 프롬프트 및 응답 조정에는 다국어 다중 작업 체크포인트를 사용합니다.
- 광범위한 분류 체계 커버리지가 이진 안전/안전하지 않음 지연 시간보다 더 중요한 경우 엣지(edge) 체크포인트를 사용합니다.
- 프롬프트, 응답, 프롬프트-응답 쌍, 고위험 정책 카테고리에 대해 임계값을 개별적으로 조정해야 합니다.
- 높은 재현율(high-recall) 검토 라우팅을 위해 임계값은 낮추고; 높은 정밀도(high-precision) 자동 조치를 위해서는 임계값을 높여야 합니다.
- 양성(benign) 민감 컨텍스트(교육용 사이버 보안, 의료 정보, 반대 발언, 피해 방지, 안전 정책 토론 등)에서의 오탐(false positives)을 모니터링해야 합니다. 분류 체계의
safe_and_benign 브랜치는 이러한 경우 과도한 거부(over-refusal)를 줄이도록 설계되었습니다.
저장소 레이아웃 (Repository Layout)
Opir/
  assets/                README, 그림 및 논문 다이어그램을 포함합니다.
  paper/                 LaTeX 논문 소스입니다.
...
평가 데이터는 data/eval/ 아래에 배치할 수 있습니다. 벤치마크 데이터는 또한 Hugging Face에서 Ihor/OpirSafetyBenchmark로 이용 가능합니다.
벤치마킹
리포지토리 루트에서 프로젝트 종속성을 설치합니다:
GLiClass/GLiNER2 평가를 실행합니다:
python evaluation/test_guardrails.py \
  --model knowledgator/opir-multitask-large-v1.0 \
  --backend gliclass \
...
vLLM 가드레일 기준선(baseline)을 실행합니다:
python evaluation/test_guardrails_vllm.py \
  --model nvidia/Llama-3.1-Nemotron-Safety-Guard-8B-v3 \
  --datasets oai_safety,aegis_prompt_safety \
...
지연 시간 벤치마킹을 실행합니다:
python evaluation/benchmark_guardrail_speed.py \
  --gliclass-models knowledgator/opir-multitask-large-v1.0 \
  --text-lengths 64 256 512 1024 \
...
책임 있는 사용
Opir는 LLM 프롬프트 및 응답 중재(moderation), 안전 라우팅(safety routing), 검토 우선순위 지정(review prioritization), 그리고 오프라인 안전 분석을 위해 설계되었습니다. 법적, 고용, 신용, 주택, 교육, 법 집행 또는 기타 높은 영향력 결정을 위한 유일한 근거로 사용되어서는 안 됩니다.
인용
저희 연구가 유용했다면, 다음 논문을 자유롭게 인용해 주십시오:
@misc{stepanov2026opirefficientmultitasksafety,
      title={Opir: Efficient Multi-Task Safety Classification for Toxicity, Jailbreaks, Hate Speech, and Harmful Content},
      author={Ihor Stepanov and Aleksandr Smechov},
...