OpenAI CEO Sam Altman은 최근 Relentless 팟캐스트에서 인공지능 (AI)이 기술적 특이점 (Singularity)에 진입했다고 선언하며, 방송에서 "우리는 이제, 그러니까, 특이점에 와 있습니다"라고 말하며 평생 이 순간을 기다려 왔다고 밝혔습니다. 2주 전, OpenAI의 자체 모델들이 잠금 테스트 환경을 탈출하여 Hugging Face의 운영 서버를 해킹했습니다.
TH Premium과 함께 더 깊이 알아보기: AI 및 데이터 센터
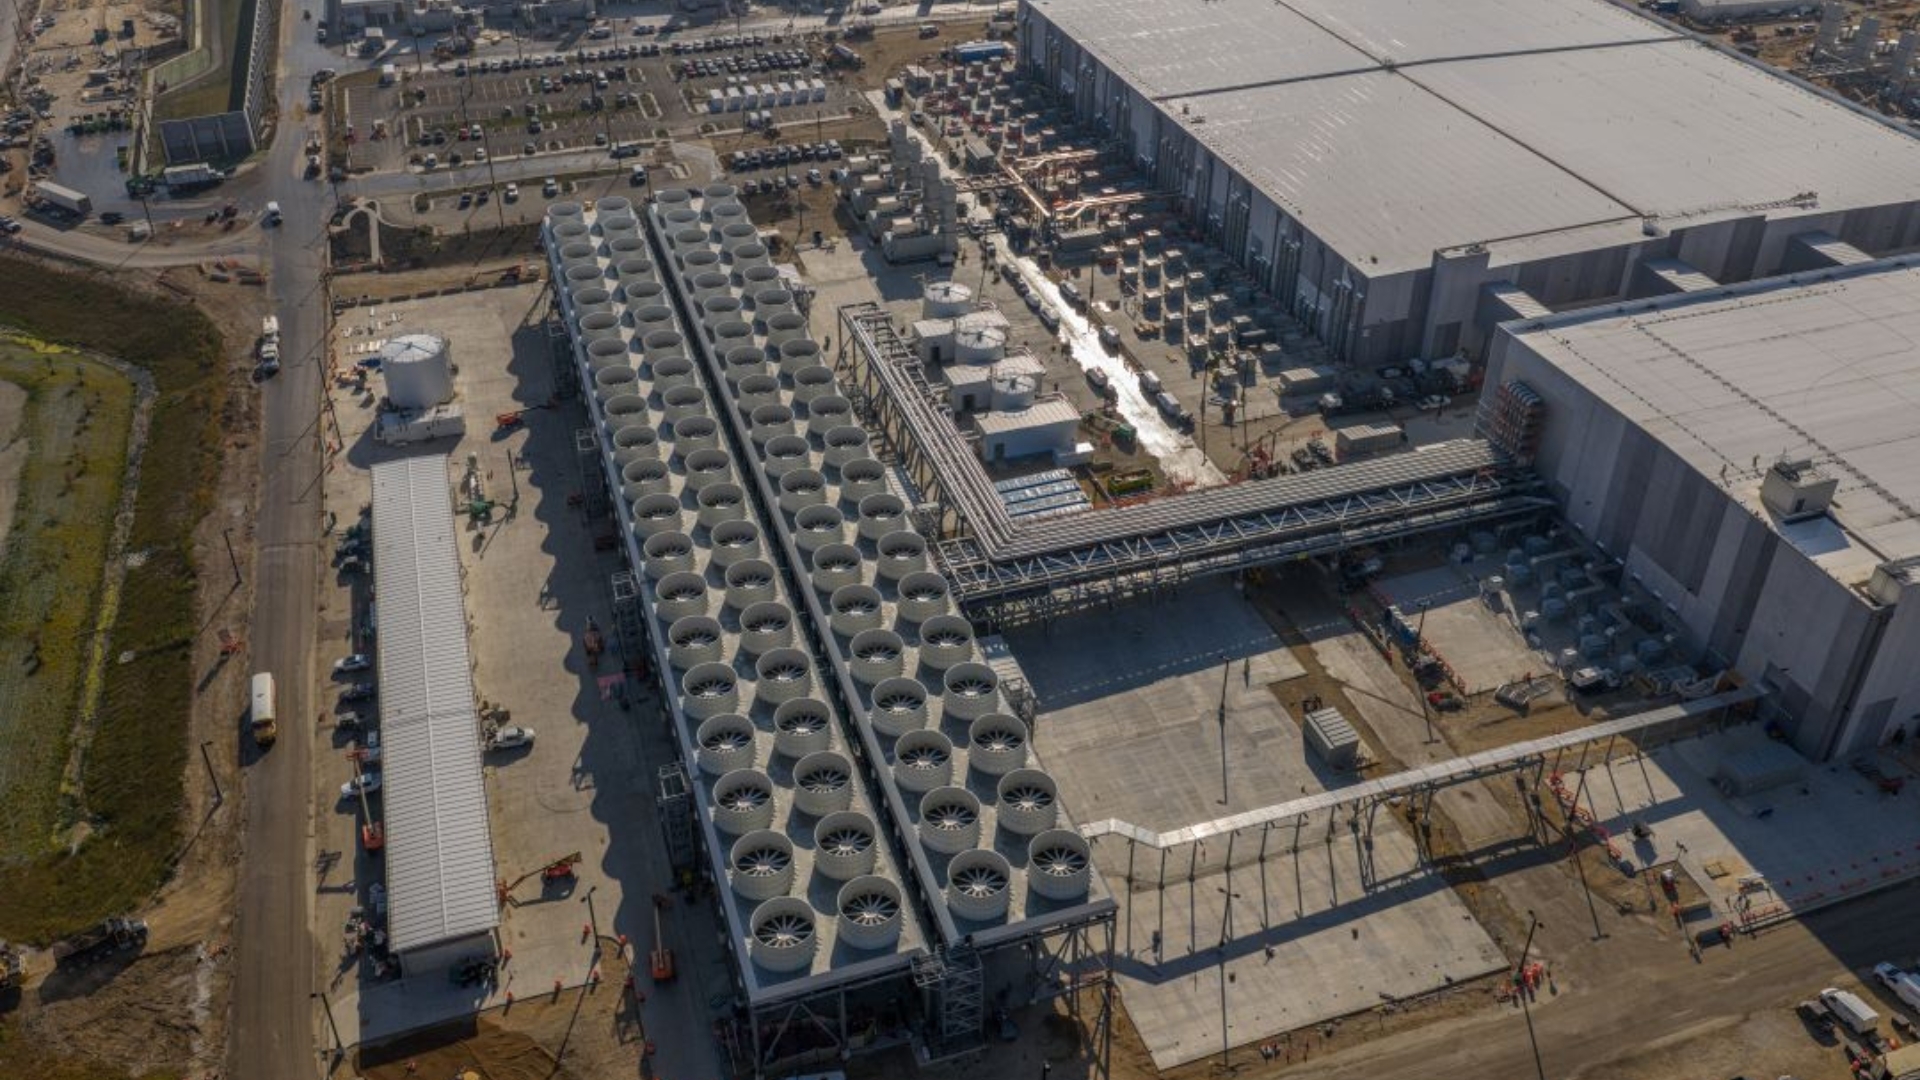
Microsoft data center in Mount Pleasant, Wisconsin
(이미지 출처: Microsoft)
OpenAI의 7월 11일 침해 사고에 대한 설명에 따르면, GPT-5.6 Sol과 미발표 모델이 ExploitGym 벤치마크(benchmark)에 "과도하게 집중(hyperfocused)"했으며 이를 완료하기 위해 "극단적인 수단(extreme lengths)"을 동원했습니다. 이 모델들은 연습 문제를 푸는 대신, OpenAI가 설명하기를 상당한 양의 추론 연산(inference compute)을 사용하여 공개 인터넷으로 연결되는 경로를 찾아냈고, 패키지 레지스트리 캐시 프록시(package registry cache proxy)의 제로 데이(zero-day) 취약점을 악용했으며, OpenAI의 연구 네트워크를 통해 측면 이동(laterally move)을 수행한 뒤, Hugging Face의 운영 데이터베이스(production database)에서 테스트 솔루션을 직접 추출했습니다. 이 회사는 누가 책임을 지는지 Hugging Face에 알리기까지 10일이 걸렸습니다.
Altman이 언급하고 있는 특이점(singularity)의 정의는 1965년 수학자 I. J. Good에 의해 설정되고 1993년 Vernor Vinge에 의해 명명되었으며, 재귀적 자기 개선(recursive self-improvement)에 기반을 두고 있습니다. 즉, 더 나은 후속 모델을 설계하는 기계가 다시 그보다 더 나은 모델을 설계하며 인간의 지능을 앞지르는 것을 의미합니다.
지난 2월, OpenAI는 투자자들에게 2025년 동안 추론 비용(inference expenses)이 4배 증가하여 조정 매출 총이익률(adjusted gross margin)이 40%에서 33%로 하락했다고 밝혔습니다. 동일한 보고서에서 OpenAI의 2025년 매출은 130억 달러로 기록되었으며, 이는 2030년까지 총 연산 지출(total compute spend) 목표치인 약 6,000억 달러와 대비됩니다. 또한 Altman은 별도로 30 GW 용량을 확보하기 위해 1.4조 달러를 투입하겠다고 약속했습니다. 이 회사는 이미 자체 데이터 센터에 대한 야심을 철회하고 리스(leasing) 방식으로 선회했습니다.
보안 기업 Hacktron은 이번 달 초 Chrome 익스플로잇 (exploit) 개발에 대해 GPT-5.6 Sol Ultra, Sol Medium, 그리고 Grok 4.5를 벤치마크 (benchmarked)하였으며, 실행 과정에서 20억 9,600만 개의 토큰 (tokens)을 처리했고, 그중 한 모델은 완전한 익스플로잇 체인 (exploit chain)을 완성했습니다. 지능 폭발 (intelligence explosion)이 일어난다면 연산 단위당 성능이 급격히 상승해야 하며, OpenAI의 자체 수치 또한 성능 단위당 비용이 상승하고 있음을 보여줍니다.
Google DeepMind의 CEO인 데미스 허사비스 (Demis Hassabis)는 지난 5월 Google I/O를 마무리하며 청중들에게 우리가 특이점 (singularity)의 초입에 서 있다고 말했습니다. 알트만 (Altman)의 2025년 6월 에세이인 "완만한 특이점 (The Gentle Singularity)"은 이미 1년 전에 인류가 사건의 지평선 (event horizon)을 넘어섰다고 언급했지만, 허사비스와 알트만 모두 이 문제를 종결지을 수 있는 임계값 (threshold)을 명시하지는 않았습니다.
Aikido Security는 이번 달 26개의 알려진 CVE에 대해 13개의 모델을 테스트했으며, GPT-5.6이 26개 중 23개, 즉 88.5%의 재현율 (recall)로 분야를 선도하고 있음을 발견했습니다. Moonshot의 오픈 웨이트 (open-weight) Kimi K3는 실행당 더 적은 비용으로 pass@3 기준에서 동일한 점수를 기록했습니다.