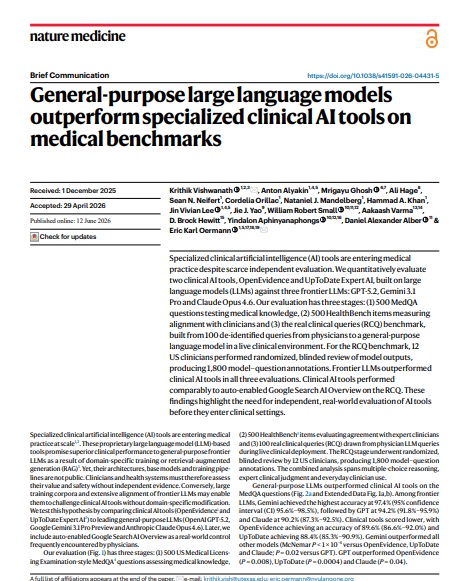
NYU Langone 연구진, 병원이 비용을 지불하는 AI 도구가 무료 범용 AI에 뒤처짐을 입증
요약
NYU Langone 연구진이 발표한 논문에 따르면, 병원에서 비용을 지불하는 전문 임상 AI 도구들이 최신 범용 대규모 언어 모델(LLM)에 비해 의학 벤치마크에서 성능이 떨어진 것으로 나타났습니다. 특히 실제 환자 치료 관련 질문에서는 무료로 제공되는 Google의 자동 활성화된 AI Overview와 비교해도 우위를 점하지 못했습니다.
핵심 포인트
- 범용 LLM이 전문 임상 도구보다 의학 지식 벤치마크에서 더 높은 정확도를 보임.
- 실제 임상 질의에 대해서도 범용 모델들이 무료 서비스 수준을 능가하기 어려웠음.
- 전문 AI 도구는 비용 부담(예: UpToDate Pro Plus 연간 $699)이 크지만, 성능 우위가 입증되지 않음.
- 연구 과정에서 OpenAI와 Google 등 관련 기업과의 이해 상충 가능성이 제기됨.
🚨속보: NYU Langone 연구진이 병원이 돈을 내고 사용하는 AI 도구들이 무료 범용 AI에 패배했음을 증명했습니다. 동료 심사(Peer-reviewed)를 거쳐 Nature Medicine에 게재되었습니다.
'범용 대규모 언어 모델(General-purpose large language models)이 전문 임상 AI 도구보다 의학 벤치마크에서 우수하다.'는 내용입니다.
테스트 항목:
의사들이 이미 사용하는 두 가지 전문 임상 AI 도구: OpenEvidence와 UpToDate Expert AI.
세 가지 최첨단 범용 모델: GPT-5.2, Gemini 3.1 Pro, 그리고 Claude Opus 4.6.
테스트 방법:
→ 미국 의사 면허 시험 스타일의 질문 500개
→ 전문가 임상의 기준에 맞춰 채점된 HealthBench 항목 500개
→ 실제 환자 치료 중 의사들이 실제로 했던, 익명화된 질문 100개
미국 의사 12명이 어떤 AI가 어떤 답변을 작성했는지 알지 못한 상태에서 총 1,800개의 개별 평가를 수행했습니다.
결과:
최첨단 범용 모델들이 전문 임상 도구들을 이겼습니다. 세 가지 테스트 모두에서 말입니다.
면허 시험 질문의 경우, Gemini는 97.4%의 정확도를 기록했습니다. 반면 임상 도구들은 각각 89.6%와 88.4%를 기록했습니다.
전문가 임상의 판단과 일치하는 정도에서는 GPT가 88.0%를 기록했습니다. 임상 도구들은 각각 62.6%와 61.3%를 기록했습니다.
반전:
가장 중요한, 실제 임상 질의에 대해서는 전문 임상 도구들이 검색에 내장된 무료 기능인 Google의 자동 활성화된 AI Overview보다 더 나은 성능을 보이지 못했습니다.
병원이 우려해야 할 수치:
→ UpToDate Expert AI가 실제 의사 질문 19%를 답변 거부함
→ 다른 모든 모델들은 1%에서 6% 사이의 비율로 답변을 거부함
→ UpToDate Pro Plus는 임상의당 연간 약 $699의 비용이 발생합니다.
연구진이 밝힌 사항:
선임 저자는 Google을 포함한 AI 회사들과의 지분 및 컨설팅 관계를 공개했습니다. 이 중 모델은 면허 시험 벤치마크에서 우승했습니다.
세 가지 벤치마크 중 하나인 HealthBench는 OpenAI가 구축했으며, 자체 모델이 여기서 가장 높은 점수를 받았습니다.
저자들은 이러한 편향을 줄이기 위해 단일 모델 대신 여러 모델의 패널로 응답을 평가했다고 직접 언급하며 이를 밝히고 있습니다.
핵심 요약:
병원들은 의학에 특화하여 구축된 AI 도구에 비용을 지불하고 있습니다.
이 동료 검토를 거친 연구는 이미 사용자가 접근할 수 있는 범용 모델이 실제 의사들의 질문에 더 잘 작동할 수도 있음을 보여줍니다.
의학에 특화되어 구축된 기술은 기성품 AI(off-the-shelf AI)를 능가하지 못했습니다. 오히려 무료로 제공되는 Google 기능과 비슷한 수준을 보였습니다.
댓글에서 링크를 확인하세요.
AI 자동 생성 콘텐츠
본 콘텐츠는 X @thewhizzai (자동 발견)의 원문을 AI가 자동으로 요약·번역·분석한 것입니다. 원 저작권은 원저작자에게 있으며, 정확한 내용은 반드시 원문을 확인해 주세요.
원문 바로가기