2023년 11월에 시작했을 때, 우리는 우리가 야심 찬 여정을 시작하고 있다는 것을 알고 있었습니다. 우리가 완전히 예상하지 못했던 것은 우리가 얼마나 빨리 확장해야 할지, 혹은 궤도에 올랐을 때 얼마나 극적으로 비용을 최적화할 수 있을지였습니다. 이것은 지난 2년 동안 벡터 검색 (vector search) 인프라를 10배 확장하는 동시에 비용을 90% 절감한 이야기입니다.
벡터 검색 (vector search)이란 무엇이며 Notion AI는 왜 이를 사용하는가?
전통적인 키워드 검색 (keyword search)은 정확한 단어를 매칭하기 때문에, "team meeting notes"와 같은 쿼리는 의미가 같음에도 불구하고 "group standup summary"라는 제목의 콘텐츠를 놓칠 수 있습니다.
벡터 검색 (vector search)은 텍스트를 의미론적 임베딩 (semantic embeddings)으로 변환하여 이 문제를 해결합니다. 임베딩은 유사한 아이디어들이 함께 모여 있는 고차원 공간 (high-dimensional space)의 점들입니다. 이를 통해 우리는 정확한 문구에 국한되지 않고 의미를 기반으로 관련 콘텐츠를 검색할 수 있습니다.
이는 사용자의 워크스페이스 전반과 Slack, Google Drive와 같은 연결된 도구의 콘텐츠를 검색하여 자연어 질문에 답하는 Notion AI에 필수적입니다.
파트 1: 수백만 개의 워크스페이스로의 확장
2023년 11월에 출시했을 당시, 우리의 인제스션 인덱싱 파이프라인 (ingestion indexing pipeline)에는 두 가지 경로가 있었습니다:
오프라인 경로 (Offline path): Apache Spark에서 실행되는 배치 작업 (Batch jobs)으로, 기존 문서를 청킹 (chunking)하고 API를 통해 임베딩 (embeddings)을 생성하며, 벡터를 벡터 데이터베이스 (vector database)에 벌크 로드 (bulk-load)합니다.
온라인 경로 (Online path): 개별 페이지 편집이 발생하는 즉시 처리하는 Kafka 컨슈머 (Kafka consumers)를 통한 실시간 업데이트
이 이중 경로 아키텍처 (dual-path architecture)를 통해 우리는 대규모 워크스페이스를 효율적으로 온보딩하는 동시에, 라이브 워크스페이스를 1분 미만의 지연 시간 (latency)으로 최신 상태로 유지할 수 있었습니다.
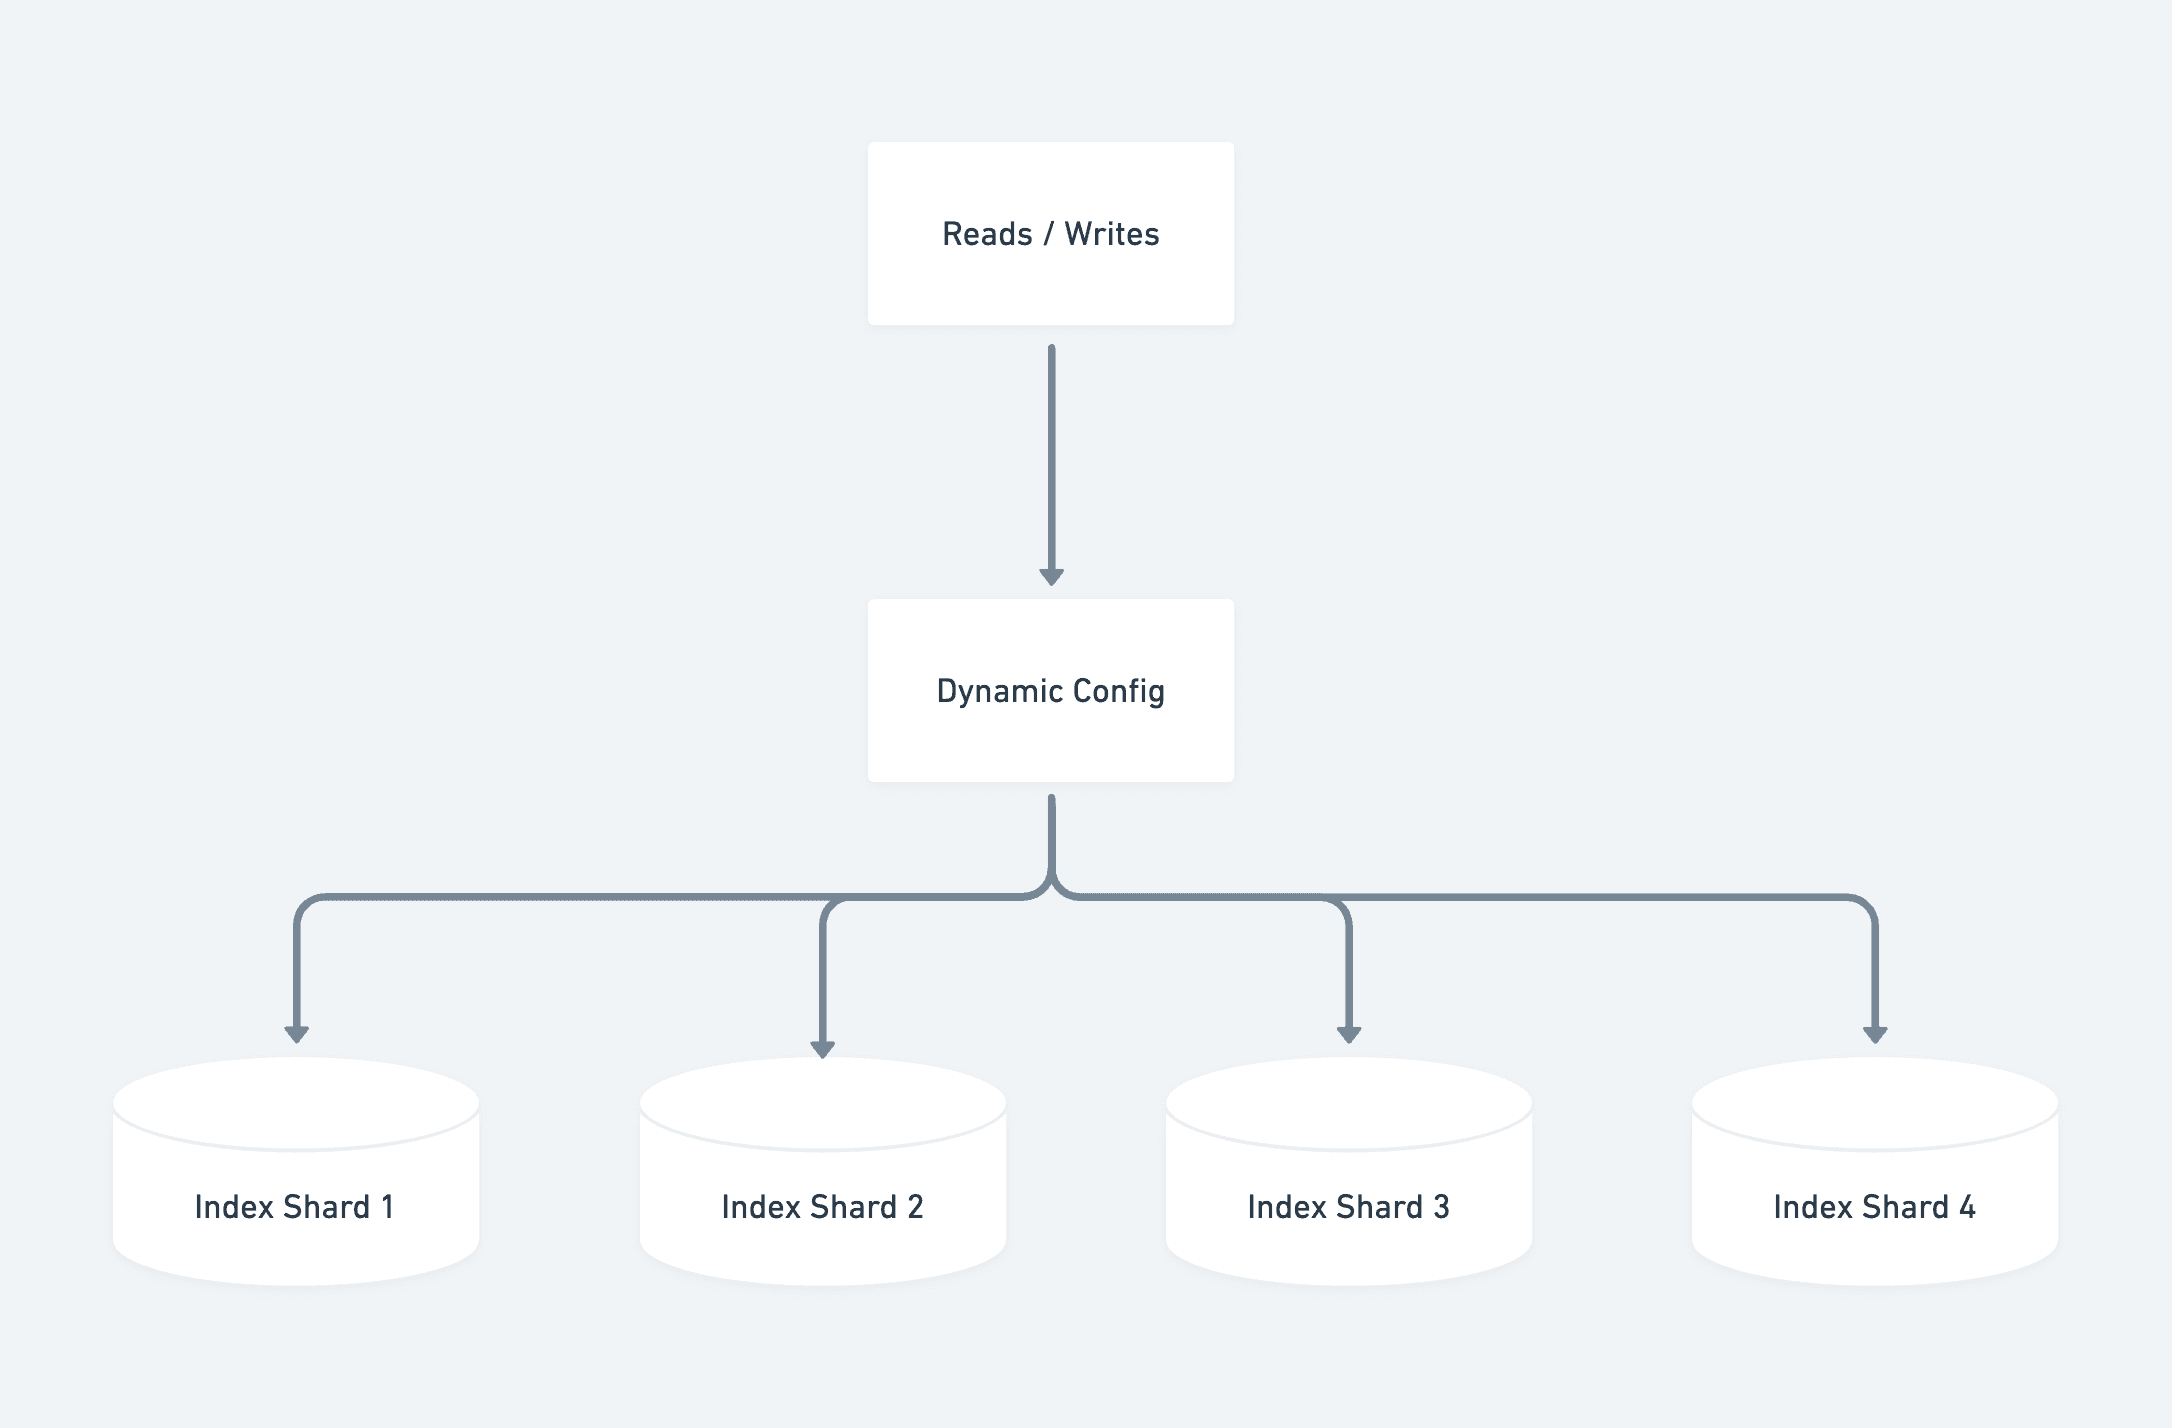
우리의 벡터 데이터베이스 (vector database)는 스토리지 (storage)와 컴퓨팅 (compute)이 결합된 전용 "포드 (pod)" 클러스터에서 실행되었으며, 대규모 멀티 테넌트 (multi-tenant) 워크로드를 처리할 수 있었습니다. 우리는 workspace ID를 파티셔닝 키 (partitioning key)로 사용하고 범위 기반 파티셔닝 (range based partitioning)을 사용하여 올바른 인덱스로 라우팅하는, 유사한 샤딩 (sharding) 전략을 설계했습니다. 단일 설정 (config)이 모든 샤드 (shards)에 대한 참조를 보유했습니다.
launch architecture nov 2023
출시와 동시에 즉각적이고 압도적인 수요가 발생했습니다. Q&A 기능을 사용하고자 하는 **수백만 개의 워크스페이스 (workspaces)**가 대기 명단 (waitlist)에 빠르게 쌓였고, 우리는 품질과 성능을 유지하면서 이들을 최대한 빨리 온보딩 (onboarding)해야 했습니다.
공간 부족 문제
출시 단 한 달 만에 기존 인덱스 (indexes)들이 용량 한계에 도달했습니다. 만약 공간이 부족해진다면 온보딩을 중단해야만 했고, 이는 AI 기능의 출시를 늦추고 신규 사용자들에게 가치를 전달하는 것을 지연시킬 것이었습니다. 우리는 전형적인 확장 (scaling) 딜레마에 직면했습니다:
점진적 재샤딩 (Re-shard incrementally): 데이터를 다른 인덱스로 복제하고, 절반을 삭제한 뒤, 새로운 고객을 온보딩할 때마다 2주마다 이 과정을 반복함
최종 예상 볼륨으로 재샤딩 (Re-shard to final expected volume): 우리가 선택한 벡터 데이터베이스 (vector database) 제공업체는 데이터베이스 가동 시간 (uptime)에 따라 비용을 청구했기 때문에, 과다 프로비저닝 (over-provisioning)은 비용이 지나치게 많이 들었음
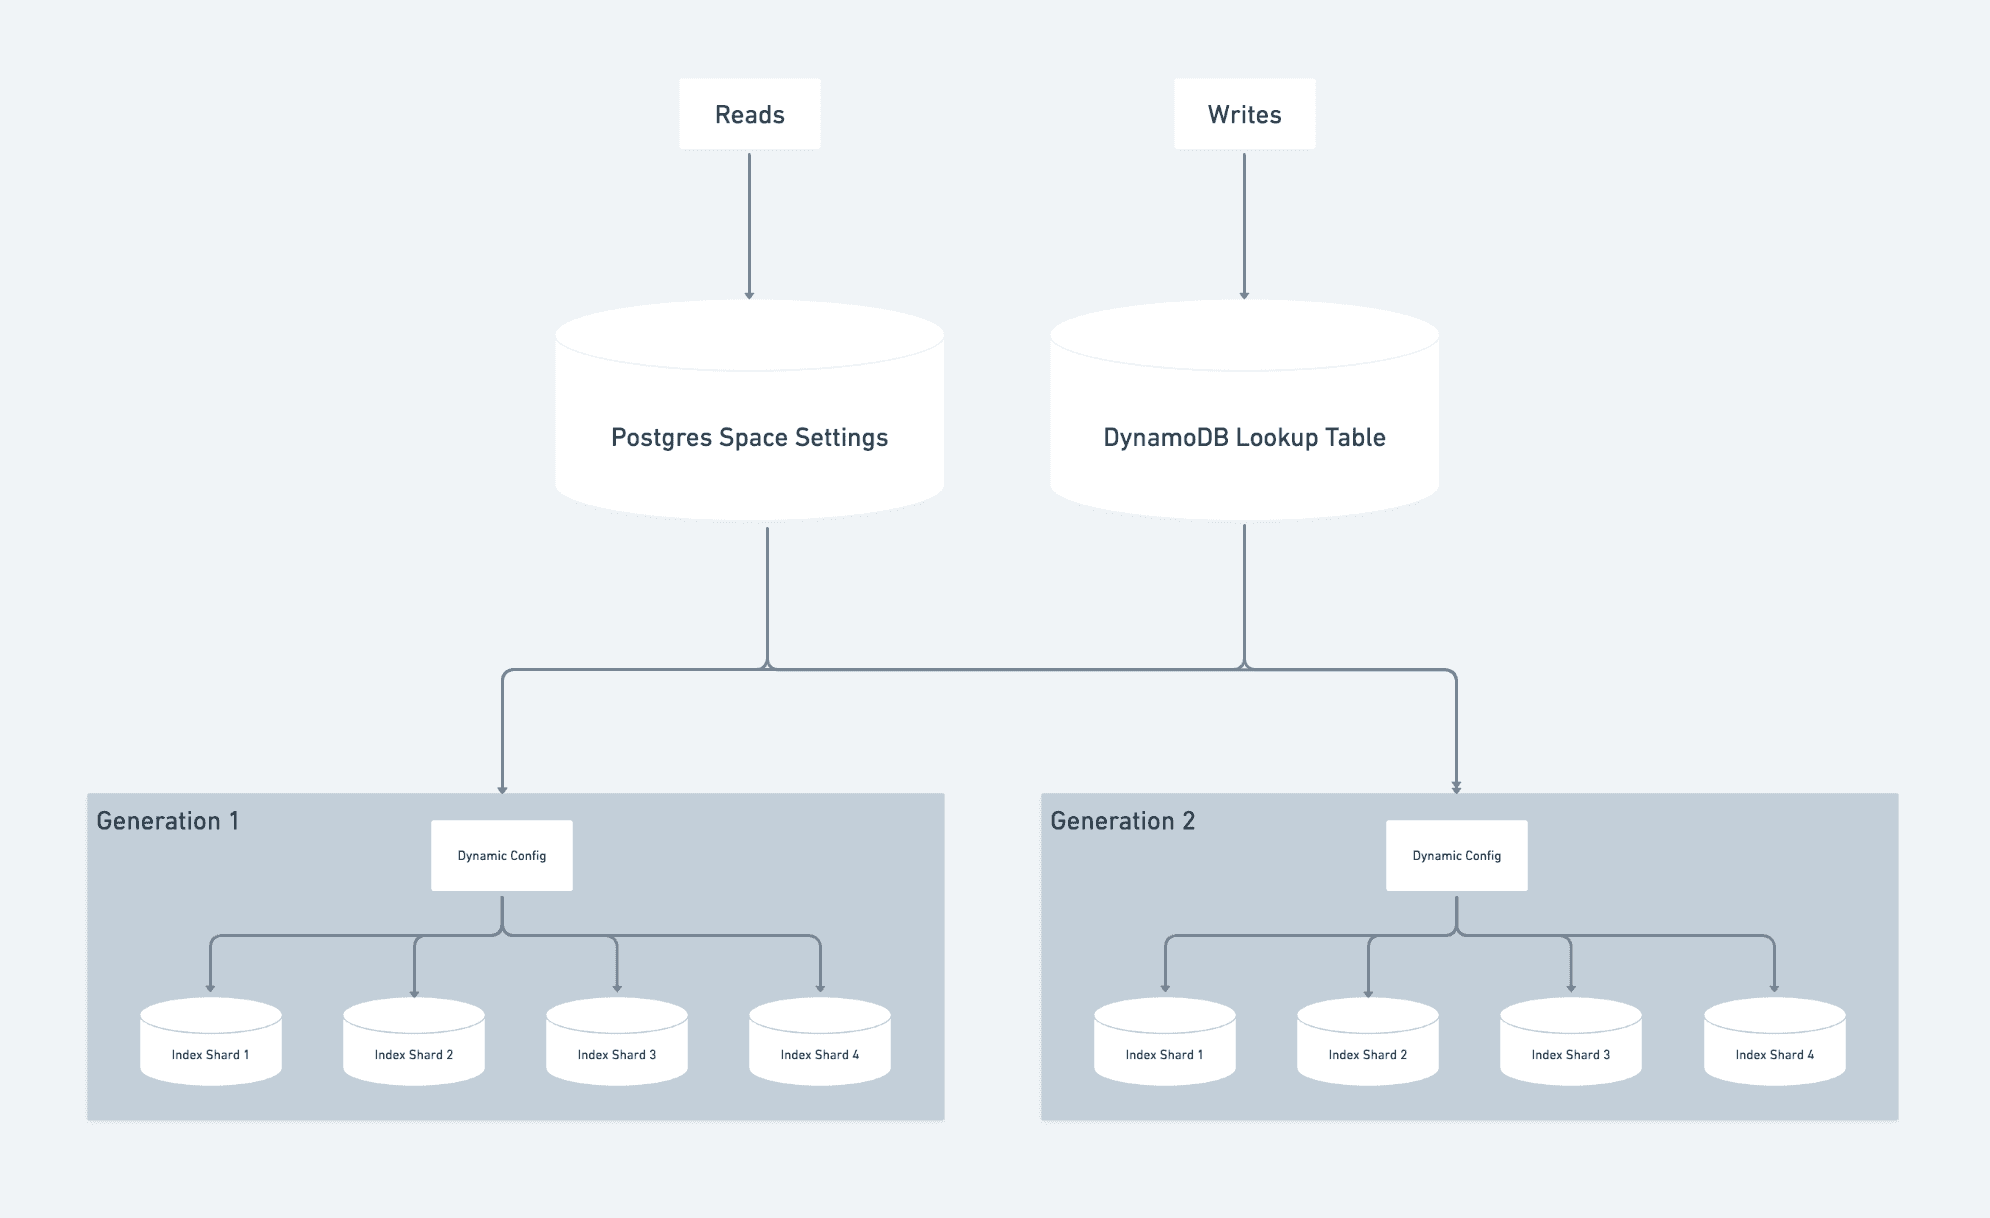
우리는 기존의 Postgres 샤딩 (sharding) 설정과는 다른 길을 선택했습니다. 대신, 인덱스 세트가 용량에 도달하면 새로운 세트를 프로비저닝 (provision)하고 모든 새로운 워크스페이스 온보딩을 그곳으로 유도했습니다. 각 세트에는 읽기 및 쓰기 작업이 어디로 향할지를 결정하는 "세대 (generation)" ID가 부여되었습니다. 이를 통해 재샤딩 (re-shard) 작업을 위해 멈출 필요 없이 계속해서 작업을 진행할 수 있었습니다.
running low on space
규모 확장 (Scaling up)
출시 당시에는 하루에 수백 개의 워크스페이스만 온보딩할 수 있었습니다. 그 속도라면 수백만 명의 대기 명단을 해소하는 데 수십 년이 걸릴 것이었습니다. Airflow 스케줄링 (scheduling), 처리량 (throughput)을 극대화하기 위한 파이프라이닝 (pipelining), 그리고 Spark 작업 튜닝 (job tuning)을 통해 온보딩 속도를 가속화했습니다:
일일 온보딩 용량:
600배 증가
활성 워크스페이스:
15배 성장
벡터 데이터베이스 용량:
8배 확장
2024년 4월, 우리는 Q&A 대기 명단을 모두 해소했습니다! 하지만 여러 세대의 데이터베이스를 관리하는 방식은 초고속 성장 (hyper growth) 단계를 통과하게 해주었지만, 운영 측면에서 복잡해지고 비용이 많이 들게 되었습니다. 우리는 더 나은 아키텍처 (architecture)가 필요했습니다.
2부: 비용 절감
2024년 5월, 우리는 기존의 전용 하드웨어 "pod" 아키텍처에서 스토리지 (storage)와 컴퓨팅 (compute)을 분리하고 가동 시간 (uptime)이 아닌 사용량에 따라 비용을 청구하는 새로운 서버리스 (serverless) 아키텍처로 전체 임베딩 (embeddings) 워크로드를 마이그레이션 (migration)했습니다.
그 효과는 즉각적이고 상당했습니다. 피크 (peak) 사용량 대비 50%의 비용 절감을 달성했으며, 결과적으로 연간 수백만 달러를 절약할 수 있었습니다. 서버리스 설계의 추가적인 이점으로는 주요 확장 병목 현상 (bottleneck)이었던 스토리지 용량 제한의 제거와, 수요에 앞서 용량을 미리 할당 (provision)할 필요가 없게 되어 운영이 단순화된 점 등이 있었습니다.
이러한 인상적인 절감에도 불구하고, 벡터 데이터베이스 (vector database) 비용만으로도 연간 실행 속도 (run rate)는 여전히 수백만 달러에 달했습니다. 우리는 더 많은 최적화 (optimization) 잠재력을 끌어낼 수 있다는 것을 알고 있었습니다.
turbopuffer 평가 및 마이그레이션 (2024년 5월 - 2025년 1월)
초기 벡터 데이터베이스 비용 절감 노력과 병행하여, 우리는 대안적인 검색 엔진 (search engine)들에 대한 종합적인 평가를 실시했으며, 그 과정에서 예상 비용이 실질적으로 훨씬 낮은 매력적인 옵션으로 turbopuffer가 부상했습니다.
당시 turbopuffer는 성능과 비용 효율성을 위해 오브젝트 스토리지 (object storage)를 기반으로 처음부터 구축된 검색 분야의 신규 진입자였습니다. 이들은 관리형 (managed) 및 클라우드 직접 가져오기 (bring-your-own-cloud) 배포 모델을 모두 지원할 뿐만 아니라, 저장된 벡터 오브젝트 (vector objects)를 대량으로 수정하기 쉽게 만드는 등 우리의 요구 사항과 일치했습니다. 성공적인 평가를 거친 후, 우리는 2024년 말에 수십억 개의 오브젝트로 구성된 전체 워크로드를 turbopuffer로 마이그레이션하기로 결정했습니다.
공급업체를 전환하는 기회였기에, 우리는 전체 아키텍처를 종합적으로 개편하는 기회로 삼았습니다:
전체 재인덱싱 (Full re-indexing): turbopuffer에서 코퍼스 (corpus)를 재구축하기 위해 오프라인 인덱싱 파이프라인 (indexing pipeline)의 쓰기 처리량 (writes throughput)을 높였습니다.
임베딩 모델 업그레이드 (Embeddings model upgrade): 마이그레이션 과정에서 더 새롭고 성능이 뛰어난 임베딩 모델로 교체했습니다.
아키텍처 단순화 (Architecture simplification): turbopuffer는 샤딩 (sharding)이나 생성 라우팅 (generation routing)을 걱정할 필요 없이 각 네임스페이스 (namespace)를 독립적인 인덱스로 취급합니다.
단계적 전환 (Gradual cutover): 생성 (generations)을 하나씩 마이그레이션하며, 다음 단계로 넘어가기 전에 정확성을 검증했습니다.
결과:
검색 엔진 지출 비용 60% 절감
AWS EMR 컴퓨팅 비용 35% 절감
p50 운영 쿼리 지연 시간 (latency) 개선: 70-100ms에서 50-70ms로 단축
페이지 상태 프로젝트 (Page State Project, 2025년 7월)
우리의 다음 주요 최적화 작업은 인덱싱 파이프라인 (indexing pipeline)의 근본적인 비효율성을 해결하는 것이었습니다. Notion 페이지는 매우 길 수 있으므로, 우리는 각 페이지를 스팬 (spans) 단위로 청킹 (chunk)하고, 각 스팬을 임베딩 (embed)한 뒤, 작성자 및 권한과 같은 메타데이터 (metadata)와 함께 벡터 데이터베이스 (vector database)에 로드합니다.
base example v3
기존 구현 방식에서는 페이지나 그 속성이 수정될 때마다, 단 한 글자만 바뀌더라도 해당 페이지의 모든 스팬을 다시 청킹 (re-chunk), 다시 임베딩 (re-embed), 그리고 다시 업로드 (re-upload)해야 했습니다. 우리의 과제는 무엇이 변경되었는지, 그리고 어떤 작업을 다시 수행해야 하는지를 빠르게 식별하는 것이었습니다.
우리가 변경하고자 했던 것은 두 가지였습니다:
실제 페이지 텍스트: 임베딩 (embedding)을 업데이트해야 함
페이지 또는 텍스트의 메타데이터: 메타데이터를 업데이트해야 함
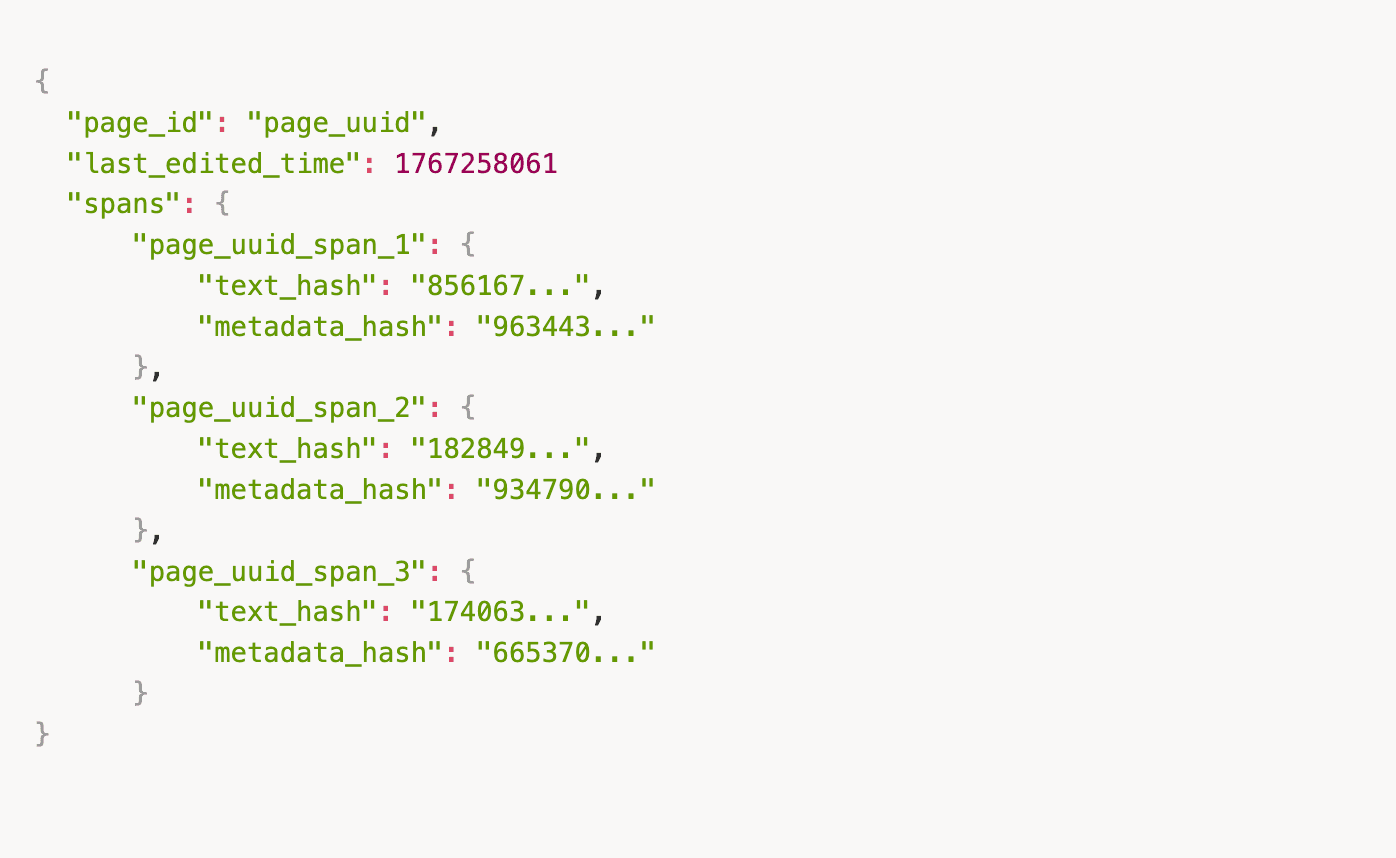
변경 사항을 감지하기 위해, 우리는 스팬 (span)당 두 개의 해시 (hash)를 추적했습니다. 하나는 스팬 텍스트에 대한 것이고, 다른 하나는 모든 메타데이터 필드에 대한 것입니다. 우리는 사용 편의성, 속도, 낮은 충돌률(collision)과 저장 공간 점유율 사이의 균형을 맞추기 위해 xxHash 알고리즘의 64비트 변형을 사용했습니다.
우리는 빠른 삽입 (inserts)과 조회 (lookups)를 제공하는 DynamoDB를 캐싱 솔루션으로 선택했습니다. 페이지당 하나의 레코드를 보유하며, 해당 페이지의 모든 스팬과 그 텍스트 및 메타데이터 해시를 포함하는 구조체 (struct)를 가집니다.
Screenshot 2026-02-18 at 2.19.11 PM
케이스 1: 페이지 텍스트가 변경되는 경우
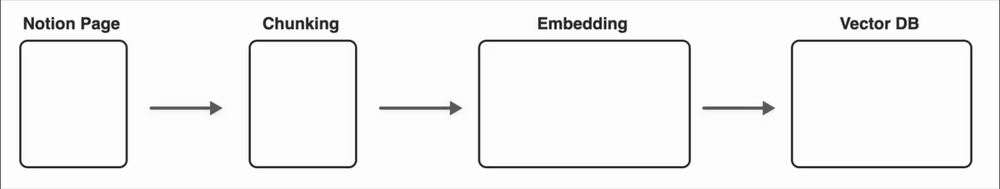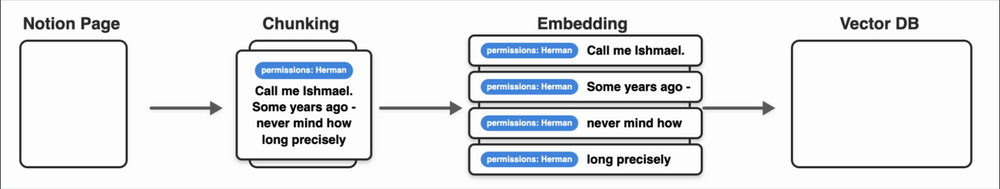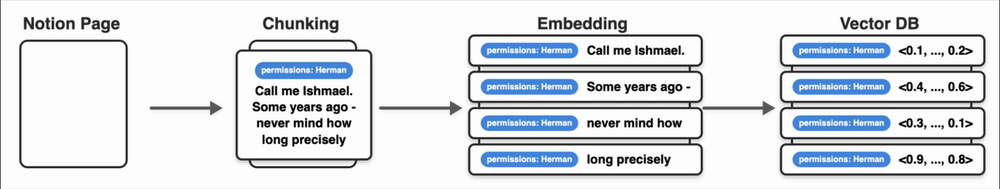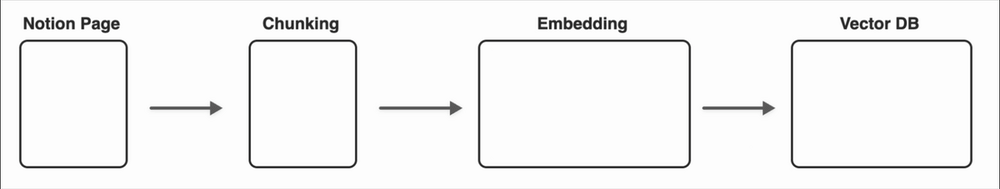
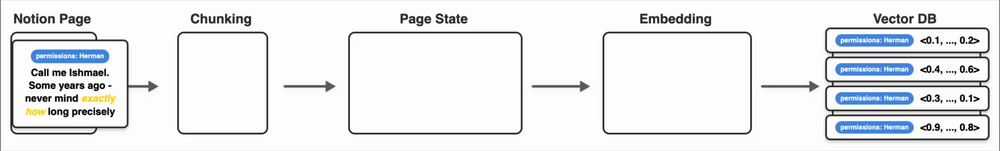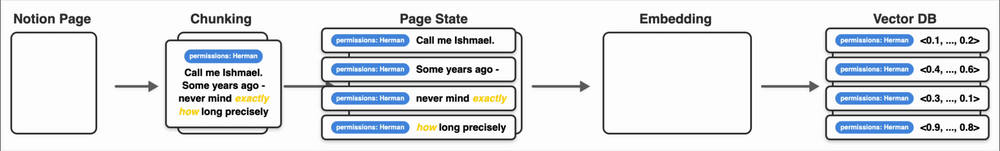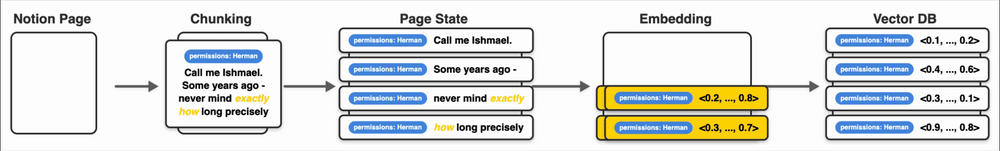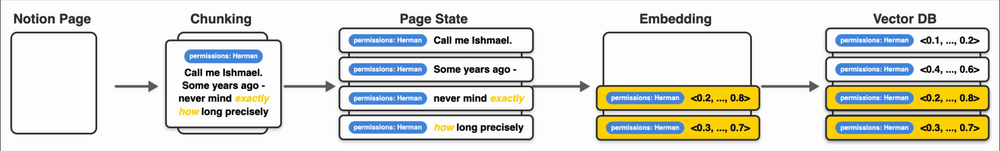
Herman Melville이 Moby Dick을 집필하던 중 페이지 중간에서 수정을 가한다고 상상해 보세요. 이전에는 페이지 전체를 다시 임베딩 (embedding) 하고 로드해야 했습니다. 이제 우리는 페이지를 청크 (chunk) 단위로 나누고, DynamoDB에서 페이지의 이전 상태를 가져와 모든 텍스트 해시 (hash)를 비교합니다. 우리는 정확히 어떤 스팬 (span)이 변경되었는지 감지하며, 변경된 스팬들만 다시 임베딩하여 벡터 데이터베이스 (vector database)에 로드합니다.
case 1
케이스 2: 메타데이터가 변경되는 경우
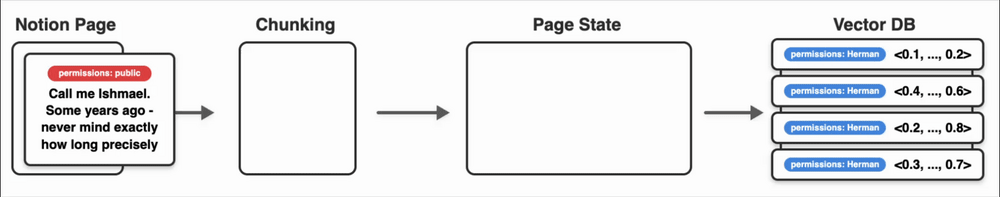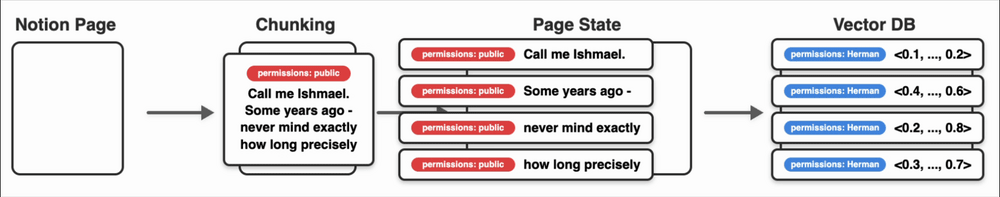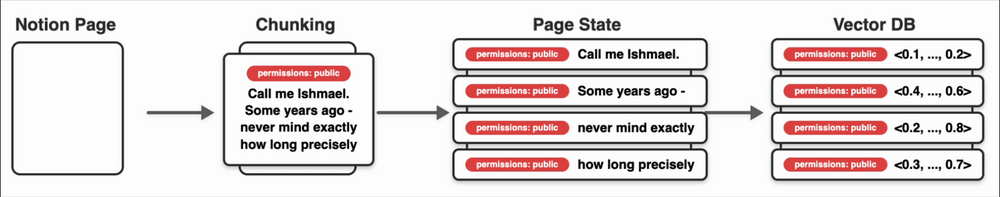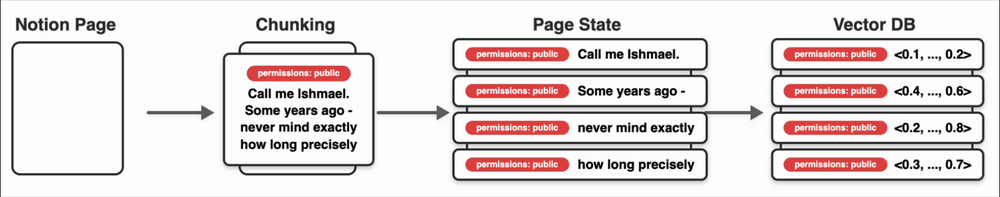
이제 Melville이 Moby Dick을 출판할 준비가 되었습니다. 그는 권한 설정을 본인 전용에서 모두에게 공개로 수정합니다. 우리는 모든 스팬에 권한과 같은 메타데이터 (metadata)를 저장하지만, 이를 변경한다고 해서 임베딩 (embedding)에 영향을 주지는 않습니다. 이전 방식이었다면 여전히 페이지 전체를 다시 임베딩하고 로드해야 했을 것입니다. 하지만 이제 우리는 페이지를 청크 (chunk) 단위로 나누고, DynamoDB에서 페이지의 이전 상태를 가져와 모든 텍스트 및 메타데이터 해시를 비교합니다. 우리는 모든 텍스트 해시는 동일하지만, 모든 메타데이터 해시는 다르다는 것을 감지합니다. 이는 임베딩 과정을 완전히 건너뛰고, 벡터 데이터베이스에 메타데이터 업데이트를 위한 PATCH 명령만 내리면 된다는 것을 의미하며, 이는 훨씬 더 저렴한 작업입니다.
case 2
이 두 가지 변경 사항을 통해 우리는 데이터 볼륨을 70% 감소시켰으며, 이를 통해 임베딩 API 비용과 벡터 DB 쓰기 비용을 모두 절감했습니다.
Ray를 이용한 임베딩 인덱싱 (2025년 7월 – 현재)
이러한 전략적 전환은 여러 가지 고충 (pain points)을 동시에 해결했습니다:
"이중 컴퓨팅 (Double Compute)" 문제. 전처리를 위해 EMR에서 Spark를 실행하면서 (청킹, 변환, API 호출 오케스트레이션), 동시에 임베딩 API 제공업체에 토큰당 비용을 지불해야 하는 문제
임베딩 엔드포인트 신뢰성 (Embeddings Endpoint Reliability). 검색 인덱스를 최신 상태로 유지하기 위해 제공업체의 API 안정성에 의존해야 했던 문제
번거로운 파이프라이닝 (Clunky Pipelining). 의존 중인 엔드포인트로의 트래픽을 원활하게 조절하고 API 속도 제한 (rate limits)을 피하기 위해, 온라인 인덱싱 Spark 작업을 S3를 통해 데이터 배치를 전달하는 여러 작업으로 분할하는 자체 파이프라이닝 설정을 구현해야 했던 문제
그렇다면 왜 Ray와 Anyscale인가요?
모델 유연성 (Model flexibility): Ray를 사용하면 외부 제공업체에 종속되지 않고 오픈 소스 임베딩 모델 (embedding models)을 직접 실행할 수 있습니다. 새로운 모델이 출시될 때마다 즉시 실험하고 도입할 수 있습니다.
통합 컴퓨팅 (Unified compute): 전처리 (preprocessing)와 추론 (inference)을 단일 컴퓨팅 레이어로 통합함으로써, 이중 컴퓨팅 (double-compute) 문제를 해결했습니다.
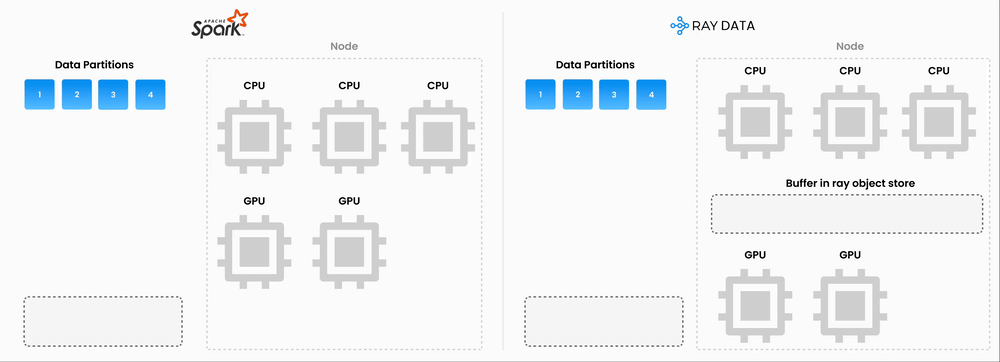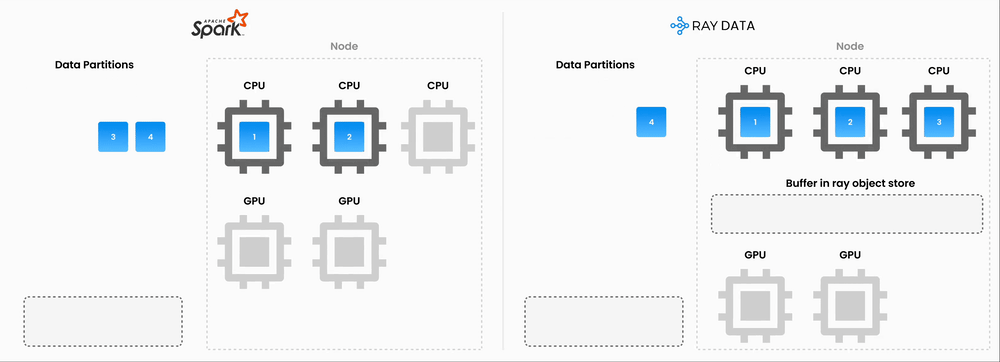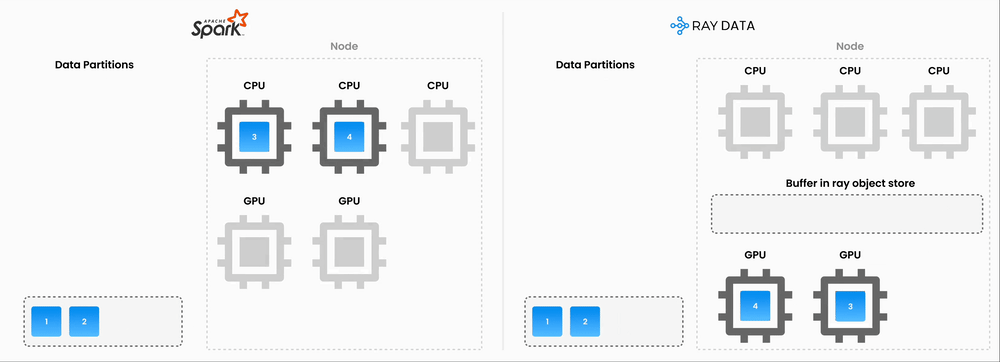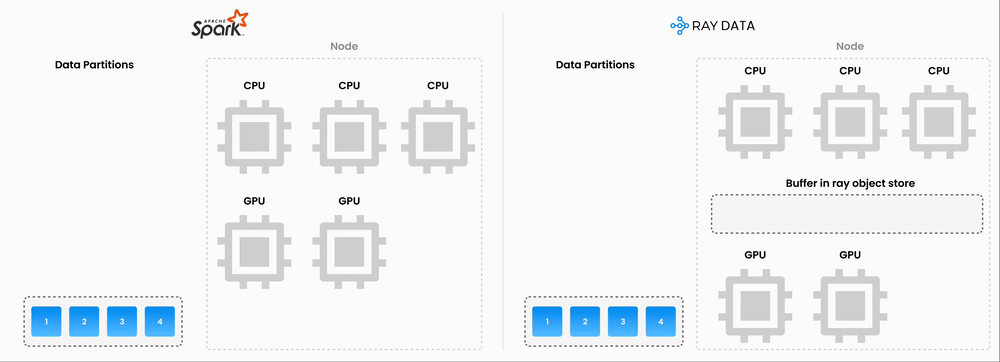
GPU/CPU 파이프라이닝 (GPU/CPU pipelining): Ray는 동일한 머신에서 CPU 기반 전처리와 GPU 기반 추론을 파이프라이닝하는 것을 네이티브로 지원하여, 높은 활용도 (utilization)를 유지합니다.
개발자 생산성 (Developer productivity): Anyscale의 통합 워크스페이스를 통해 엔지니어들은 인프라를 직접 프로비저닝할 필요 없이 선호하는 도구 (Cursor, VSCode 등)에서 데이터 파이프라인을 작성하고 테스트할 수 있습니다.
쿼리 시간 지연 시간 감소 (Lower query-time latency): 임베딩을 자체 호스팅함으로써 크리티컬 패스 (critical path)에서 제3자 API 홉 (hop)을 제거하였고, 이는 사용자 대상 검색의 엔드 투 엔드 지연 시간 (end-to-end latency)을 실질적으로 줄여주었습니다.
Ray natively supports pipelining CPU bound tasks (chunking, detecting page state) with GPU bound embeddings generation within the same node. Source: Anyscale. https://www.anyscale.com/glossary/ray-vs-apache-spark-technical-differences
임베딩 생성 파이프라인을 Spark에서 Ray로 마이그레이션함으로써, 임베딩 인프라 비용을 90% 이상 절감할 수 있을 것으로 기대합니다. 현재 순차적으로 적용 중이며, 초기 결과는 매우 유망합니다.
Ray 기반 임베딩 서빙 (2025년 7월 – 현재)
사용자나 에이전트가 Notion을 검색할 때, 쿼리를 즉석에서 임베딩해야 합니다. 해당 계산이 완료될 때까지 벡터 DB (vector DB)를 검색할 수 없으므로, 이 단계에서는 지연 시간에 매우 민감합니다. 하지만 (Hugging Face에서 볼 수 있는 것과 같은) 대규모 파라미터 임베딩 모델을 호스팅하는 것은 까다로울 수 있습니다. 효율적인 GPU 할당부터 인그레스 라우팅 (ingress routing), 복제 (replication), 확장 (scaling)에 이르기까지 모든 것을 고려해야 합니다.
[Ray는] 이 기능의 대부분을 즉시 사용할 수 있도록 제공합니다. 이를 통해 오픈 소스 임베딩 모델을 GPU에 로드된 상태로 유지되는 지속적인 배포 (persistent deployment) 형태로 래핑할 수 있습니다. 동적 요청 배치 (dynamic request batching)부터 복제에 이르기까지 모든 것을 구성할 수 있습니다. 모델 서빙 코드는 일반적인 Python처럼 보이며, 컴퓨팅, 복제 및 오토스케일링 (autoscaling) 설정은 단순한 yaml 형식입니다.
향후 전망
규모를 계속 확장함에 따라, 우리는 다음과 같은 미래의 기회들에 대해 기대하고 있습니다: