nanochat
nanochat logo
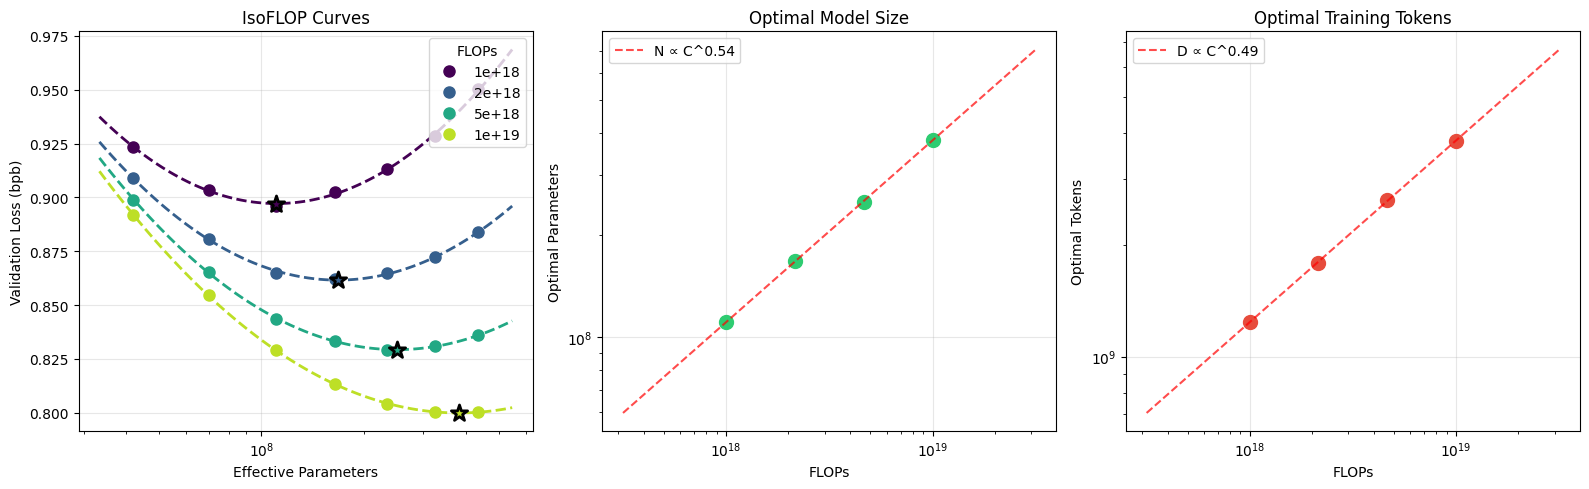
scaling laws
nanochat은 LLM(대규모 언어 모델) 훈련을 위한 가장 간단한 실험용 하네스입니다. 이는 단일 GPU 노드에서 실행되도록 설계되었으며, 코드는 최소화되어 있어 수정하기 쉽고(minimal/hackable), 토큰화(tokenization), 사전 학습(pretraining), 미세 조정(finetuning), 평가(evaluation), 추론(inference)을 포함한 모든 주요 LLM 단계를 다룹니다. 예를 들어, 2019년 기준 약 $43,000이 들었던 GPT-2급 능력을 가진 자체 LLM을 단지 $48만으로(8XH100 GPU 노드에서 약 2시간) 훈련한 다음 간단한 CLI를 통해 대화할 수 있습니다. 스팟 인스턴스의 경우, 총 비용은 $15에 더 가까울 수 있습니다. 더 일반적으로, nanochat은 --depth라는 단일 복잡도 다이얼(complexity dial)을 설정하는 것만으로 전체 컴퓨팅 최적 모델 시리즈를 훈련하도록 구성됩니다. 이 깊이는 GPT 트랜스포머 모델의 레이어 수를 의미합니다 (GPT-2급 능력은 깊이가 약 26인 경우에 해당합니다). 다른 모든 하이퍼파라미터들(트랜스포머의 너비, 헤드 수, 학습률 조정, 훈련 기간, 가중치 감쇠 등...)은 최적으로 자동으로 계산됩니다.
리포지토리 관련 질문은 Devin/Cognition에서 제공하는 DeepWiki를 사용하여 질문하거나, Discussions tab을 이용하거나, Discord의 #nanochat 채널로 오시면 됩니다.
Time-to-GPT-2 Leaderboard
현재 개발의 주요 초점은 가장 많은 컴퓨팅 자원을 소모하는 사전 학습 단계에 맞춰져 있습니다. modded-nanogpt 리포지토리에서 영감을 받아 진척과 커뮤니티 협업을 장려하기 위해, nanochat은 'GPT-2 스피드런'에 대한 리더보드를 유지하고 있습니다. 이는 DCLM CORE 점수로 측정되는, nanochat 모델을 GPT-2급 능력으로 훈련하는 데 필요한 실시간(wall-clock) 시간을 의미합니다. runs/speedrun.sh 스크립트는 항상 GPT-2급 모델을 훈련하고 대화하는 참조 방식을 반영합니다. 현재 리더보드는 다음과 같습니다:
| # | time | val_bpb | CORE | Description | Date | Commit | Contributors |
|---|
| 0 | 168 hours | - | 0.2565 | Original OpenAI GPT-2 checkpoint | 2019 | - | OpenAI |
| ... | | | | | | | |
우리가 중요하게 생각하는 주요 지표는 'GPT-2까지의 시간(time to GPT-2)'입니다. 이는 8XH100 GPU 노드에서 GPT-2 (1.6B) CORE 지표를 능가하는 데 필요한 실시간 경과 시간(wall clock time)을 의미합니다. GPT-2 CORE 점수는 0.256525입니다. 2019년, GPT-2 훈련 비용은 약 $43,000이었습니다. 따라서 지난 7년간 스택 전반에 걸친 많은 발전 덕분에, 우리는 이제 훨씬 더 빠르고 $100보다 훨씬 적은 비용으로 이를 수행할 수 있다는 것은 놀랍습니다 (예: 현재 ~$3/GPU/hr 기준으로, 8XH100 노드는 약 $24/hr이며, 따라서 2시간은 약 $48입니다).
레더보드 해석 및 기여 방법에 대한 더 많은 문서는 dev/LEADERBOARD.md를 참조하십시오.
시작하기 (Getting started)
설정 (Setup)
nanochat은 의존성 관리를 위해 uv를 사용합니다. 설치하려면 다음을 실행하세요:
uv sync --extra gpu
uv sync --extra cpu
source .venv/bin/activate
개발을 위해 (pytest, matplotlib, ipykernel, transformers 등을 추가):
uv sync --extra gpu --group dev
GPT-2 재현 및 대화하기 (Reproduce and talk to GPT-2)
가장 재미있는 경험은 자신만의 GPT-2를 훈련하고 그 모델과 대화하는 것입니다. 이를 수행하기 위한 전체 파이프라인은 단일 파일 runs/speedrun.sh에 포함되어 있으며, 이는 8XH100 GPU 노드에서 실행되도록 설계되었습니다. 선호하는 제공업체(예: 저는 Lambda를 사용하고 좋아합니다)로부터 새로운 8XH100 GPU 박스를 부팅한 다음, 훈련 스크립트를 시작하세요:
이 과정은 약 1.5시간이 소요되므로 screen 세션에서 실행하는 것이 좋습니다. 완료되면 CLI를 통해 모델과 대화할 수 있습니다. 로컬 uv 가상 환경이 활성화되어 있는지 다시 한번 확인하고( source .venv/bin/activate 실행), 다음 명령어로 채팅을 시작하세요:
python -m scripts.chat_cli
이야기를 쓰거나 시를 쓰게 하세요. 환각(hallucination)을 확인하려면 자신에 대해 물어보세요. 하늘이 왜 파란지, 혹은 왜 초록색인지 물어보세요. speedrun은 4e19 FLOPs 역량 모델이기 때문에 아기에게 말하는 것과 약간 비슷합니다 :). speedrun 모델과의 예시 대화:
사용자: 안녕하세요, 무슨 일이에요?
어시스턴트: 안녕하세요! 오늘 무엇을 도와드릴까요?
사용자: 하늘이 왜 파란가요?
어시스턴트: 하늘은 대기 중의 미세 입자를 통과하는 햇빛에 의해 발생하는 레일리 산란(Rayleigh Scattering of Light)이라는 광학적 착각 때문에 파란색입니다. 이 입자들은 빛을 특정 방식으로 굴절시키는 작은 파란색 및 보라색 입자로 구성되어 있습니다.
사용자: 멋지네요. 이것에 대한 시를 써주세요.
어시스턴트: 황혼의 빛 속에서, 하늘은 푸르다,<br>
펼쳐지는 하늘의 반짝이는 푸른 캔버스 위에,<br>
푸른색의 세계, 푸른색과 더 깊은 푸른색이<br>너무나 섬세한 태피스트리 속에 짜여져서,<br>모든 색조가 이야기를 노래하는 듯하다.<br>
...
몇 가지 추가 참고 사항:
- 코드는 Ampere 8XA100 GPU 노드에서도 잘 실행되지만, 약간 느립니다.
torchrun을 생략하고 단일 GPU로만 코드를 실행해도 문제없으며, ~동일한 결과를 생성합니다 (코드가 자동으로 그래디언트 누적(gradient accumulation)으로 전환됨). 하지만 8배 더 오래 기다려야 합니다.- GPU 메모리가 80GB 미만인 경우, 하이퍼파라미터 중 일부를 조정해야 OOM (Out Of Memory) 또는 VRAM 부족 현상이 발생할 수 있습니다. 스크립트에서
--device-batch-size를 찾아 값이 들어갈 때까지 줄여보세요. 예: 기본값 32에서 16, 8, 4, 2, 또는 심지어 1로. 그보다 적게 설정하려면 자신이 무엇을 하는지 좀 더 잘 알고 창의적이어야 합니다.
- 대부분의 코드는 비교적 표준적인 PyTorch이므로 xpu, mps 등 이를 지원하는 모든 장치에서 실행되어야 하지만, 제가 이 모든 코드 경로를 직접 테스트하지 않았기 때문에 날카로운 부분이 있을 수 있습니다.
연구
연구원으로서 nanochat 개선에 기여하고 싶다면, 주목할 만한 두 스크립트는 runs/scaling_laws.sh와 runs/miniseries.sh입니다. 관련 문서는 Jan 7 miniseries v1를 참조하십시오. 빠른 실험을 위해(~5분 사전 학습 실행) 제가 선호하는 규모는 12개 레이어 모델(GPT-1 크기)을 훈련하는 것입니다. 예를 들어 다음과 같습니다:
OMP_NUM_THREADS=1 torchrun --standalone --nproc_per_node=8 -m scripts.base_train -- \
    --depth=12 \
    --run="d12" \
...
이것은 wandb(실행 이름 "d12")를 사용하며, 마지막 단계에서 CORE 메트릭만 실행하고 중간 체크포인트를 샘플링하거나 저장하지 않습니다. 저는 코드를 변경하고 d12(또는 d16 등)를 재실행하여 반복 루프 내에서 도움이 되는지 확인하는 것을 좋아합니다. 실행이 도움이 되었는지 확인하려면, 저는 다음 항목에 대한 wandb 플롯을 모니터링하는 것을 좋아합니다:
val_bpb(어휘 크기 불변 단위의 bits per byte로 측정된 검증 손실)를 step, total_training_time, total_training_flops의 함수로 확인합니다.core_metric(DCLM CORE 점수).- VRAM 활용률,
train/mfu(모델 FLOPS 활용률), train/tok_per_sec(훈련 처리량).
예시는 여기를 참조하십시오.
주목할 만한 점은 nanochat이 단 하나의 복잡성 조절기, 즉 트랜스포머의 깊이(depth)를 중심으로 작성되고 구성되었다는 것입니다. 이 단일 정수 값은 다른 모든 하이퍼파라미터들(트랜스포머의 너비(width), 헤드 수(number of heads), 학습률 조정(learning rate adjustments), 훈련 기간(training horizons), 가중치 감쇠(weight decays) 등)을 자동으로 결정하여, 결과적으로 훈련된 모델이 계산상 최적화되도록 만듭니다. 아이디어는 사용자가 이러한 요소들을 생각하거나 설정할 필요가 없다는 것입니다. 단지 --depth를 사용하여 더 작거나 큰 모델을 요청하기만 하면 모든 것이 "자동으로 작동(just works)"합니다. 깊이를 변화시키면서, 다양한 크기의 계산상 최적화된 nanochat 미니 시리즈를 얻게 됩니다. (현재 가장 관심이 높은) GPT-2 수준의 성능을 가진 모델은 현재 코드로 볼 때 d24~d26 범위 근처에 위치합니다. 하지만 이 저장소(repo)에 대한 모든 후보 변경 사항들은 깊이의 모든 설정에서 작동할 만큼 충분히 원칙적이어야 합니다.
CPU / MPS에서 실행하기
스크립트 runs/runcpu.sh는 CPU 또는 Apple Silicon에서 실행하는 매우 간단한 예시를 보여줍니다. 이 스크립트는 훈련 시간을 몇 분 정도로 합리적인 간격에 맞추기 위해 훈련되는 LLM을 극적으로 축소합니다. 이러한 방식으로 강력한 결과를 얻지는 못할 것입니다.
정밀도 / dtype
nanochat은 torch.amp.autocast를 사용하지 않습니다. 대신, 정밀도는 단일 전역 변수인 COMPUTE_DTYPE(nanochat/common.py에 정의됨)을 통해 명시적으로 관리됩니다. 기본적으로 이는 하드웨어에 따라 자동 감지됩니다:
| 하드웨어 | 기본 dtype | 이유 |
|---|
| CUDA SM 80+ (A100, H100, ...) | bfloat16 | 네이티브 bf16 텐서 코어 |
| ... | | |
다음과 같이 NANOCHAT_DTYPE 환경 변수를 사용하여 기본값을 재정의할 수 있습니다:
NANOCHAT_DTYPE=float32 python -m scripts.chat_cli -p "hello"
NANOCHAT_DTYPE=bfloat16 torchrun --nproc_per_node=8 -m scripts.base_train
작동 방식: 모델 가중치(model weights)는 fp32 (최적화기 정밀도용)로 저장되지만, 커스텀 Linear 레이어는 순전파 과정(forward pass)에서 이를 COMPUTE_DTYPE으로 캐스팅합니다. 메모리 절약을 위해 임베딩(Embeddings)은 COMPUTE_DTYPE에 직접 저장됩니다. 이는 autocast와 동일한 혼합 정밀도(mixed-precision) 이점을 제공하지만, 어떤 부분이 어느 정밀도로 실행될지 완전히 명시적으로 제어할 수 있다는 장점이 있습니다.
참고: float16 훈련은 기울기 언더플로우(gradient underflow)를 방지하기 위해 base_train.py에서 자동으로 GradScaler를 활성화합니다. SFT도 이를 지원하지만, RL은 현재 지원하지 않습니다. fp16에서의 추론(Inference)은 모든 곳에서 문제없이 작동합니다.
가이드(Guides)
도움이 될 만한 정보가 담긴 여러 가이드를 게시했습니다. 최신순으로 나열합니다:
파일 구조(File structure)
.
├── LICENSE
├── README.md
...
기여(Contributing)
nanochat의 목표는 1,000달러 미만의 예산으로 엔드투엔드(end to end) 작업이 가능한 마이크로 모델(micro models) 분야의 최신 기술 수준(state of the art)을 개선하는 것입니다. 접근성은 전반적인 비용뿐만 아니라 인지적 복잡성(cognitive complexity)에 관한 것도 포함합니다. nanochat은 광범위하게 구성 가능한 LLM "프레임워크"가 아닙니다. 즉, 거대한 설정 객체(configuration objects), 모델 팩토리(model factories), 또는 코드베이스 내의 if-then-else 구조의 괴물 같은 코드는 없습니다. 이것은 시작부터 끝까지 실행되어 대화할 수 있는 ChatGPT 모델을 생성하도록 설계된 단일하고 응집력 있으며 최소한적이고 읽기 쉬우며 해킹 가능하고 최대적으로 포크(fork) 가능한 "강력한 기본선(strong baseline)" 코드베이스입니다. 현재 개인적으로 가장 흥미로운 부분은 GPT-2의 지연 시간(latency)을 줄이는 것입니다 (즉, CORE 점수를 0.256525 이상으로 확보하는 것). 현재 이 작업에는 약 1.5시간이 소요되지만 (3시간에서 감소), 사전 학습 단계(pretraining stage)를 개선함으로써 이를 더욱 향상시킬 수 있습니다.
현재 AI 정책: 공개(disclosure). PR을 제출할 때는 상당한 LLM 기여가 있었던 부분 중 자신이 작성하지 않았거나 완전히 이해하지 못하는 부분이 있다면 반드시 명시해 주십시오.
감사의 글 (Acknowledgements)
- nanochat이라는 이름은 오직 사전 학습만을 다루었던 저의 초기 프로젝트 nanoGPT에서 유래했습니다.
- nanochat은 또한 nanoGPT 레포지토리를 명확한 지표와 리더보드로 게임화(gamified)했던 modded-nanoGPT에서도 영감을 받았으며, 사전 학습을 위한 많은 아이디어와 일부 구현 방식을 차용했습니다.
- fineweb과 smoltalk에 대해 HuggingFace에 감사드립니다.
- 이 프로젝트 개발에 사용된 컴퓨팅 자원에 대해 Lambda에 감사드립니다.
- 조언/지침을 제공해 준 최고 LLM 위스퍼러 🧙♂️ Alec Radford님께 감사드립니다.
- nanochat의 이슈 관리, 풀 리퀘스트(pull requests), 토론 관리를 도와준 레포지토리 관리자 Sofie @svlandeg님께 감사드립니다.
인용 (Cite)
연구에서 nanochat이 도움이 되었다면 다음처럼 간단히 인용해 주십시오:
@misc{nanochat,
  author = {Andrej Karpathy},
  title = {nanochat: The best ChatGPT that $100 can buy},
...
라이선스
MIT