
Microsoft의 'Clea' Maia 300 추론 XPU는 대역폭 괴물
요약
Microsoft는 AI 추론 비용 문제 해결을 위해 자체 개발한 Maia 계열 맞춤형 XPU 가속기를 선보였습니다. 특히 'Clea' Maia 300은 대규모 에이전트 워크로드와 다양한 모델 구동에 최적화되어 있습니다. 이 칩들은 Azure 클라우드에서 Copilot 및 Microsoft Foundry 등 핵심 서비스의 AI 인프라 기반으로 활용될 예정입니다.
핵심 포인트
- Maia 300은 대규모 에이전트 워크로드를 위해 설계된 XPU 가속기이다.
- Azure 클라우드는 Maia 200을 통해 Copilot 및 Microsoft Foundry에 적용 중이다.
- Microsoft는 Maia를 기반으로 다 기가와트 규모의 AI 인프라 구축을 목표하고 있다.
Microsoft의 'Clea' Maia 300 추론 XPU는 대역폭 괴물
모두가 AI 추론 문제를 안고 있지만, 최첨단 GPU와 XPU 가속기에서도 토큰을 생성하는 비용이 여전히 너무 비싸기 때문에, Microsoft는 아마도 세계에서 가장 큰 추론 문제를 가지고 있을 것입니다.
한 가지 이유는 OpenAI ChatGPT 모델에 대한 추론 실행뿐만 아니라 AI 모델 빌더가 자신의 모델을 훈련하도록 돕는 것이 거대한 작업이기 때문입니다. 그리고 마이크로소프트의 모든 직원 생산성 및 백오피스 애플리케이션에 AI 루틴이 주입되고 있으며, 이는 사용량을 급격하게 증가시키고 있습니다.
그렇기 때문에 Microsoft는 자체 개발한 Maia 계열 맞춤형 XPU 가속기로 전력을 다하고 있으며, 고객들에게 회사가 이 문제에 대해 작업하고 있다는 것을 알리기 위해 이번 주 Open Compute Project Summit 2026이 시작됨에 따라 미래의 'Clea' Maia 300 가속기에 대한 기능과 속도를 공개했습니다.
Maia 300 칩은 훨씬 개선된 장치이며, GenAI 추론이 단순히 더 빠르게 실행될 수 있도록 설계되었을 뿐만 아니라, 수십 개에서 수백 개의 모델로 구성된 대규모 에이전트 워크로드(agentic workloads)가 효율적이고 낮은 지연 시간으로 작동하기 위해 동일한 네트워크 및 메모리 공간을 공유해야 하는 경우까지 확장되도록 설계되었습니다 – 이는 전문가 혼합 기반 모델(mixture of experts foundation model), 실제로 물리적으로 구별되는 독립적인 모델, 또는 이 둘의 조합일 수 있습니다.
Microsoft는 칩 설계에 있어서 만만치 않은 회사이며, 종종 두 번째나 세 번째 시도에서 올바른 것을 만들어냅니다. 소프트웨어 및 클라우드 거대 기업은 2023년 11월 'Athena' Maia 100 XPU로 물에 발을 담갔습니다. 당시 Microsoft는 Cobalt 100 맞춤형 Arm 서버 CPU도 공개하고 있었으며, 두 맞춤형 칩의 아키텍처에 대해서는 거의 언급하지 않았습니다.
올해 1월에 처음 공개된 2세대 “Braga” Maia 200은 훨씬 더 진지한 XPU이며, 올해 Azure 클라우드에서 생산 단계에 접어들고 있는 제품입니다.
Microsoft의 Cloud 및 AI 담당 부사장인 Scott Guthrie가 별도의 발표를 통해 “다세대 Azure Maia 프로그램이 Microsoft의 AI 인프라 전략의 기반 요소가 되었다”고 말하며, Maia 200 칩은 Copilot 추론에 사용되고 있으며, 이를 통해 Microsoft AI 팀은 새로운 모델을 개발하고 있고, GitHub Copilot과 Microsoft Foundry는 연말까지 Maia 200으로 전환될 것이라고 밝혔습니다. (GitHub Copilot은 이전에 Maia 100의 지원을 받았습니다.) Maia 200은 Microsoft Foundry를 통해 OpenAI의 다양한 모델, Microsoft 자체 모델, 그리고 다양한 오픈 소스 모델을 구동할 것입니다. OpenAI의 GPT API 서비스 중 얼마나 많은 부분이 Maia 100 또는 Maia 200에서 실행되는지는 명확하지 않습니다.
소문으로는 Microsoft가 최소 1백만 개의 Maia 소켓을 현장에 배치하고자 하며, Guthrie는 성명에서 Maia가 Azure 클라우드에 “다 기가와트 규모의 배포”를 갖게 될 것이라고 말했습니다. Maia 300의 1기가와트는 각 가속기와 시스템 호스트, 스토리지 및 확장 네트워킹 부분이 각각 1.74킬로와트를 소비하는 약 57만 5천 개 장치에 해당합니다. (Microsoft는 Maia 300으로 구성된 랙이 약 167킬로와트를 소모하며 96개의 XPU가 상호 연결되어 있다고 밝혔습니다.)
이 Braga 칩은 온-칩 SRAM 캐시를 줄였음에도 불구하고 훨씬 더 많은 HBM 메모리 용량과 대역폭을 갖추고 있었다. 더욱이, 이 칩은 AI Transport Layer (ATL)의 맞춤형 RoCE Ethernet 구현을 크게 개선하여 2.3배 더 많은 대역폭을 제공했으며, 전력 소비는 1.5배 증가시키는 데 그치면서 Maia 클러스터의 클러스터 일관성 도메인(cluster coherence domain)을 2.7배 확장하여 6,144개의 장치를 지원했다. 6비트 MX6 데이터 형식에서 4비트 MXFP4로 전환하고 컴퓨팅 코어 수를 1.5배 늘리는 동시에 클럭 속도까지 높임으로써, Braga 칩은 대체한 Athena 칩보다 3.4배 더 많은 부동 소수점 성능(floating point oomph)을 갖게 되었다.
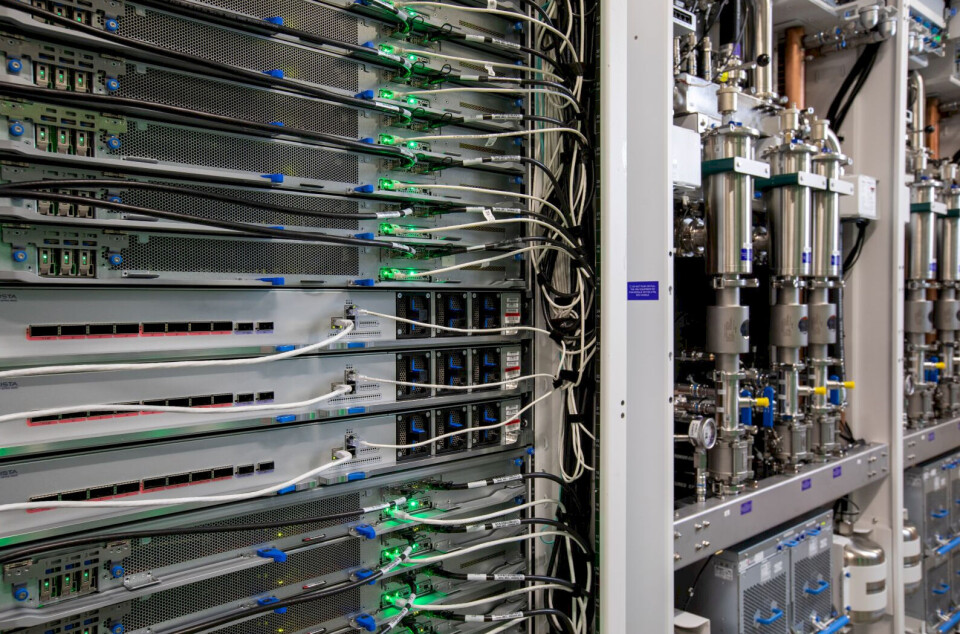
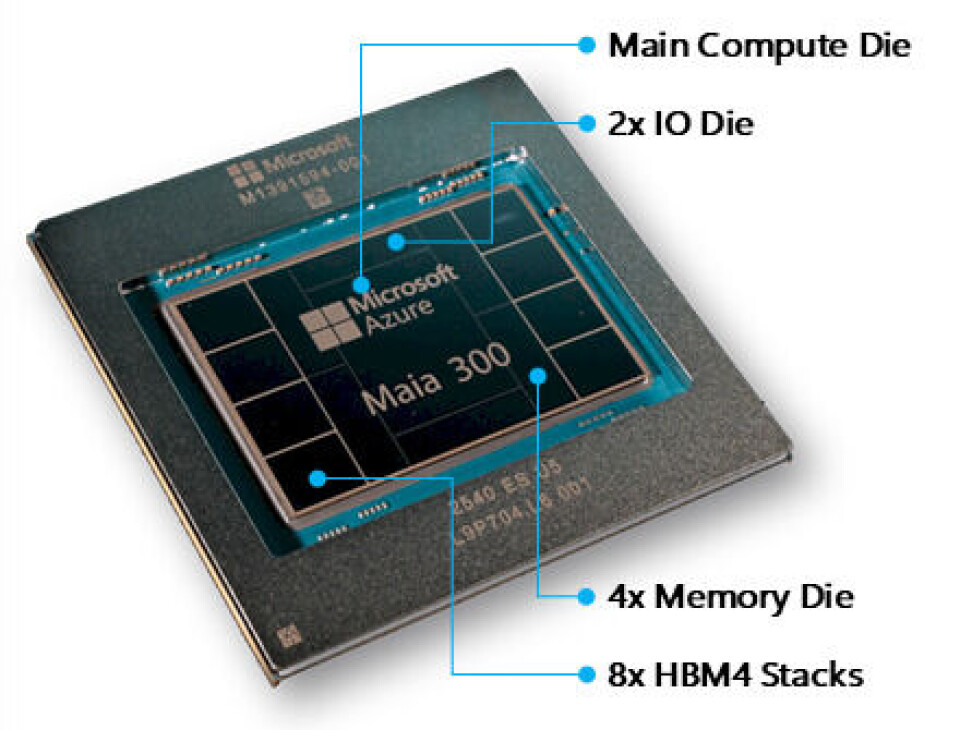
Clea Maia 300 칩 – 엄밀히 말해 시스템 온 칩(System on a Chip, SoC)이라기보다는 소켓에 들어가는 복합 칩, 어쩌면 소켓에 들어가는 시스템 자체라고 할 수 있다. Microsoft가 기술 심층 분석에서 언급하는 바와 같이, 이 칩은 실제로는 인터포저 위에 배치된 일곱 개의 칩과 여덟 개의 HBM 스택의 집합체이기 때문이다 – 는 모든 사양 면에서 한계를 밀어붙이고 있지만, 단순히 속도와 스펙 시트 우월성을 위해 플롭스(flops)를 소켓에 채워 넣는 것이 아니라 실제 전반적인 생성형 AI 추론 워크로드에서의 효과적인 성능에 초점을 맞추고 있다. 더욱이, Microsoft는 ATL 이더넷 네트워크를 변경하여 더 많은 XPU를 랙에, 그리고 더 많은 랙을 일관성 도메인에 채워 넣어 더 큰 에이전트 기반(agentic) 워크로드를 처리할 수 있게 했다.
Maia 300 “소켓 내 시스템”과 이를 구성하는 장치들의 랙들은 컴퓨팅, 메모리, 네트워킹의 계층 구조를 가지고 있으며, 이러한 용량들을 결합하여 생성형 AI 작업에 투입한다.
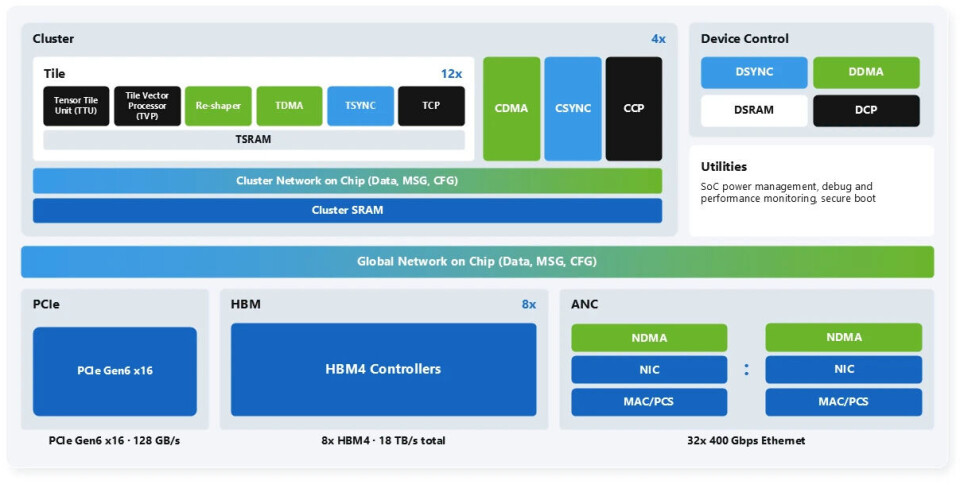
Clea 컴퓨트 타일은 Athena 및 Braga 전신과 구성되는 타일과는 약간 다릅니다. 세 XPU 모두 타일 텐서 유닛(TTU)과 타일 벡터 프로세서(TVP)를 가진 코어와, 타일 데이터 이동 엔진(TDMA), 타일 제어 프로세서(TCP)는 물론 이 단위들이 공유할 L1 SRAM 캐시 메모리를 갖추고 있습니다. (얼마만큼은 공개되지 않았습니다.) Athena XPU는 이러한 코어 4개를 하나의 타일에, 그리고 16개의 타일을 클러스터로(소켓 내 클러스터라는 의미입니다) 구성하여 총 64개의 코어를 확보했습니다. Braga 타일과 타일 클러스터의 구성은 지난 1월에 공개되지 않았으나, 작년 8월 arXiv에 논문이 게재되어 이를 알게 되었고, 이는 Maia 라인업의 주요 특징 테이블을 업데이트할 수 있게 해주었습니다.
알려진 바에 따르면 Braga XPU는 Athena 유닛보다 행렬 크기가 두 배 큰 텐서 유닛을 가지고 있어, 지난 1월 기사에서 예상했던 장치 처리량(throughput)을 달성하기 위해 필요한 코어 수가 생각보다 적었습니다. Braga XPU는 온칩 클러스터당 10개의 타일을 가지며 총 4개의 클러스터를 구성하여 총 40개의 코어를 가집니다. 이들은 2 GHz로 작동하며, Taiwan Semiconductor Manufacturing Co.가 칩을 에칭하는 데 사용한 3 나노미터 N3P 공정에서 수율(yield)을 확보하기 위해 클러스터당 단 9개의 코어만 활성화됩니다. Athena와 Braga 칩은 모놀리식 디자인이었으며, 리소그래피 장비의 레티클 한계에 근접했습니다.
Clea XPU를 통해 Microsoft는 TSMC의 2 나노미터 N2P 공정으로 이동하고 있으며, 컴퓨팅 및 SRAM 캐시 요소와 분리된 I/O 및 HBM 컨트롤러를 분리하는 칩렛 아키텍처로도 전환하고 있습니다. Maia 300에는 Maia 200과 마찬가지로 네 개의 타일 클러스터가 있지만, 각 온칩 클러스터는 12개의 타일을 가지고 있습니다. 또한, 올해 초에 알지 못했던 네트워크부터 서버 노드를 거쳐 타일까지 전체 시스템에 걸친 데이터 흐름을 돕기 위해 리셰이퍼(reshaper)와 타일 동기화기(tile synchronizer)라는 두 가지 요소가 아키텍처에 추가되었습니다.
타일당 (L1) 및 클러스터당 (L2) SRAM 용량은 공개되지 않았습니다. 제가 추측하자면 – 그리고 저는 추측합니다 – Clea 칩 패키지 중앙의 컴퓨팅 타일에 약 400MB의 SRAM 캐시가 분산되어 있고, I/O 칩렛에 또 다른 200MB가 내장되어 들어오는 네트워크 데이터와 나가는 컴퓨팅 데이터를 캐싱하는 데 사용될 것입니다.
상대적으로 큰 HBM 컨트롤러 다이에도 로직뿐만 아니라 SRAM이 내장되어 있을 수 있습니다. 제가 추측하기로는 Clea 패키지의 두 I/O 다이에 200MB의 SRAM이 있을 것입니다.
Clea 복합체 전체에서 약 166.2 TB/sec의 총 SRAM 대역폭을 갖추고 있으며, 이는 장치에 있는 여덟 개의 HBM4 스택의 18 TB/sec HBM 메모리 대역폭과 균형을 이룹니다. Clea XPU는 288GB의 HBM 4를 가지고 있으며, 이는 Braga XPU의 경우와 마찬가지로 SK Hynix 제품인 것으로 추정됩니다.
Clea 패키지의 면적과 트랜지스터 개수에 관해서는 HBM 메모리 크기가 알려져 있고 세 가지 Maia 칩 모두의 칩 패키지 이미지와 공정 노드를 가지고 있기 때문에 대략적인 추정이 가능합니다. 참고로, Clea에 사용된 HBM 메모리 컨트롤러 및 I/O 다이가 2 나노미터가 아닌 5 나노미터 공정을 사용할 것이라고 가정하겠습니다. 그렇게 되면 성능이 더 좋고 제조 비용도 더 저렴해질 것입니다. (I/O 회로를 축소한다고 해서 반드시 성능이 향상되는 것은 아니며, 확실히 비용을 증가시키고 수율을 떨어뜨립니다.) Clea 패키지는 면적이 약 1,980 mm²인 것으로 보이며, 이는 제가 생각하기에 Braga 패키지의 면적 810 mm²보다 2.4배 더 큰 것입니다. 몇 가지 숫자를 가지고 놀아보니, HBM4 메모리를 제외하고 트랜지스터 개수는 약 2,800억 개 정도로 추정됩니다 (±10% 오차).
직접 살펴보시고 자신만의 추측을 해보세요:
세 가지 Maia XPU의 피드와 속도는 다음과 같으며, 평소처럼 제가 밝은 빨간색 굵은 이탤릭체로 추정치를 표시했습니다:
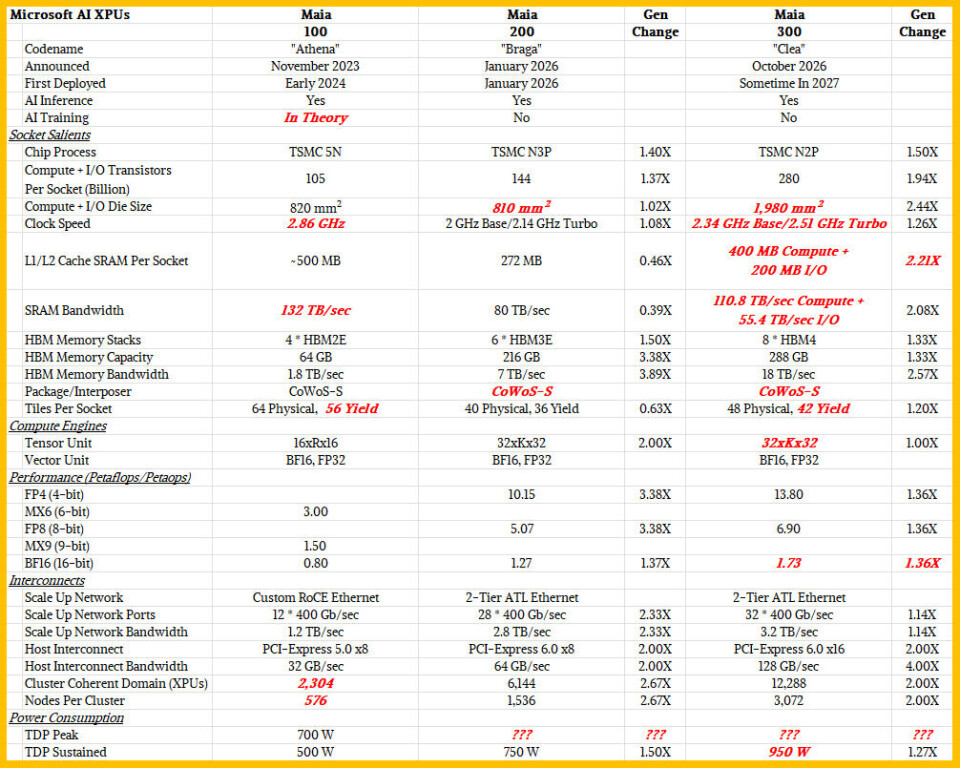
Microsoft는 Maia 300의 칩 공급업체가 누구인지 말하지 않았지만, TSMC의 가까운 패키징 파트너인 대만 Global UniChip (GUC)이 몇 년 전 Maia 100의 공급업체 역할을 맡았다고 알려졌습니다. 모두가 GUC가 Maia 200과 Maia 300도 담당하고 있다고 추측하지만, 2년 전에는 Marvell이 Maia 라인에 진출하려 한다는 소문이 돌았고, 그 직후 Broadcom이 Microsoft의 맞춤형 실리콘 사업 일부를 차지하려고 한다는 소문이 있었습니다.
Braga XPU의 경우와 마찬가지로 Clea XPU는 네 개의 가속기 마더보드를 서로 연결하여 서버 폼팩터에 배치합니다. Braga의 경우 CPU 호스트가 XPU 랙 외부에 있었습니다. 하지만 Clea XPU의 경우, (저희가 두 경우 모두 Microsoft가 설계하고 Arm이 어떤 방식으로 관리하는 것으로 추정하는) 132코어 Cobalt 200 시리즈 Arm 서버 CPU인 호스트 서버 자체가 CPU 노드 내부로 끌려 들어옵니다. 어느 쪽이든, 저희는 CPU와 XPU가 Ethernet 포트가 아닌 PCI-Express 스위치로 연결된다고 가정합니다. 하지만 어쩌면 아닐 수도 있습니다.
Arm이 자체 AGI 프로세서를 판매하게 되면서 Microsoft가 다른 CPU 칩을 선택할 수도 있습니다. 작년에 Broadcom에 대한 소문이 돌았던 것이 그 예입니다.
Maia 300 서버는 다음과 같은 모습입니다:
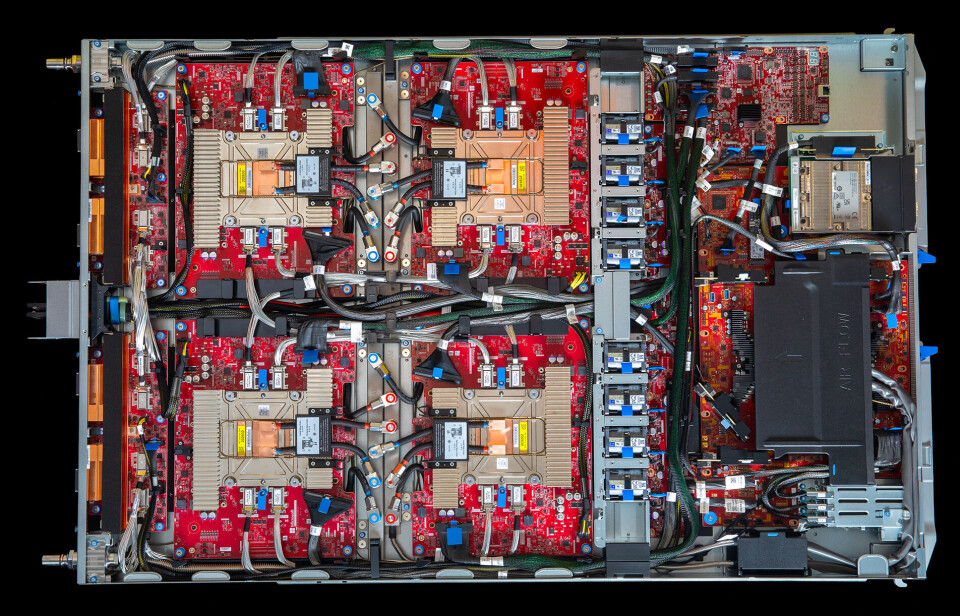
눈을 가늘게 뜨고 보면 Maia 100 및 Maia 200 서버와 매우 유사해 보이며, CPU가 섀시 내부에 배치되어 있습니다. 하지만 눈에 보이는 차이점들이 더 많습니다. 세 가지 Maia 세대 모두 배선 방식이 다릅니다. Maia 100이 노드 내부에서 서로 연결되고, 이후 랙을 가로질러 다른 노드와 연결되는 RoCE Ethernet 배선 가속기 방식은 다음과 같습니다:
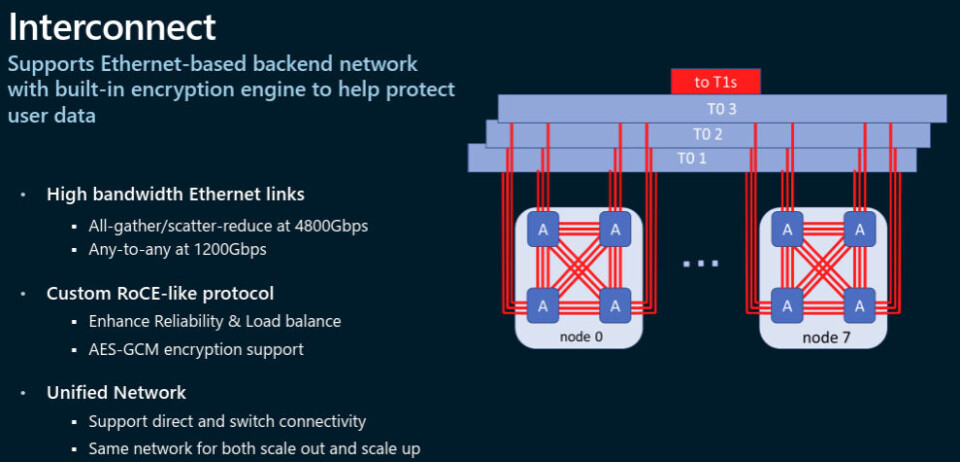
총 12개의 400 Gb/sec 링크 중 9개가 Maia 100 네 개를 매우 밀접하게 연결하는 데 사용되었고, 나머지 링크 세 개는 네트워크의 첫 번째 계층(물론 T0입니다)인 3개 평면 Ethernet 패브릭에 연결되는 데 사용되었습니다. 이 첫 번째 계층은 최대 32개의 가속기를 서로 연결할 수 있었으며, 두 번째 계층의 Ethernet 스위치가 시스템을 확장하여 단일 일관성 도메인 내에서 576개 노드와 2,304개 Athena XPU를 구현하는 데 사용되었습니다.
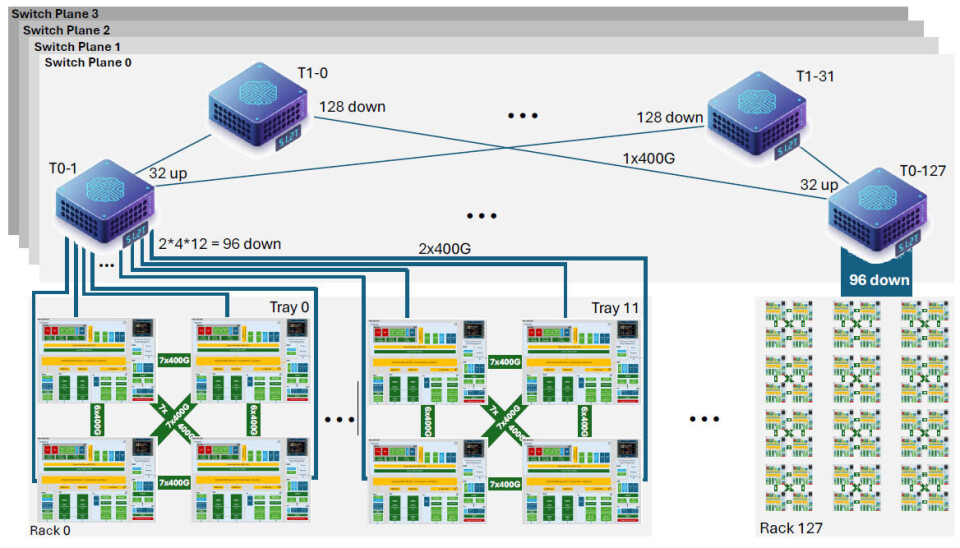
Maia 200의 경우, 칩의 I/O 부분은 총 2.8 TB/sec의 집계 양방향 대역폭을 제공하기 위해 400 Gb/sec로 작동하는 28개의 Ethernet 포트를 구현했습니다. 이 포트들이 어떻게 사용되었는지 다음 그림에서 확인할 수 있습니다:
AI 자동 생성 콘텐츠
본 콘텐츠는 The Next Platform의 원문을 AI가 자동으로 요약·번역·분석한 것입니다. 원 저작권은 원저작자에게 있으며, 정확한 내용은 반드시 원문을 확인해 주세요.
원문 바로가기