
Microsoft Surface Laptop Ultra에 RTX Spark Superchip을 테스트하다
요약
Nvidia가 RTX Spark 플랫폼을 통해 PC의 재창조를 선언하며, Microsoft Surface Laptop Ultra에 탑재된 Superchip 성능을 테스트했습니다. 이 시스템은 로컬 AI 에이전트 구동 능력을 중점적으로 평가했으며, 기존 토큰 생성 속도 측정 대신 전체 작업 완료 시간을 측정하는 새로운 벤치마크 [AgentPerf-local]의 중요성을 강조합니다.
핵심 포인트
- RTX Spark 플랫폼으로 PC가 자율적인 동반자로 진화할 전망입니다.
- Superchip은 20 CPU 코어, 6144 CUDA 코어를 갖추고 있습니다.
- 로컬 AI 성능 측정 시 전체 에이전트 워크플로우 시간을 측정해야 합니다.
- 새로운 벤치마크 [AgentPerf-local]을 통해 작업 완료 시간을 평가합니다.
Nvidia CEO Jensen Huang은 Computex 2026에서 'PC를 재창조한다'는 거대한 포부를 담아 RTX Spark 플랫폼을 발표했습니다. GB10 Superchip과 로컬 AI 에이전트의 안전하고 격리된 실행에 맞게 조정된 Windows on Arm 버전을 결합함으로써, Nvidia와 Microsoft, Dell, HP, MSI, Lenovo, Asus 등 파트너사들은 PC가 업무와 창작을 위한 능동적이고 자율적인 동반자가 되는 미래를 열기를 기대하고 있습니다.
이러한 미래 비전의 하드웨어 기반이 이제 마련되었습니다. 지난주 저희는 샌프란시스코로 날아가 RTX Spark 플랫폼에 대한 모든 세부 정보를 얻었고, 최고 사양의 Microsoft Surface Laptop Ultra를 가지고 돌아와 모든 것을 테스트해 보았습니다.
이 시스템은 20개의 CPU 코어와 6144 CUDA 코어를 갖춘 전체 RTX Spark Superchip과 128GB의 LPDDR5X-9400 RAM을 탑재하고 있으며, 저는 지난주 동안 이 기기를 혹독하게 사용하며 무엇을 할 수 있는지 알아보고 있습니다.
RTX Spark 출시 관련하여 금지된 정보(embargoes)가 다소 특이합니다. 오늘 저희는 Spark 플랫폼에 대한 전반적인 경험과 경쟁 성능 평가를 공유할 것이지만, 배터리 수명, 빌드 또는 디스플레이 품질 등 시스템별 특정 결과나 그와 같은 세부 사항은 공유하지 않을 것입니다. Tom’s Hardware 연구실에는 다른 RTX Spark 노트북들이 있으며, 해당 시스템들에 대한 자세한 리뷰는 곧 공개될 예정입니다.
아닙니다. 모바일 플랫폼의 경험은 특정 노트북 디자인에 이 칩이 구현되는 방식과 매우 밀접하고 불가분의 관계에 있기 때문에, 이러한 접근 방식은 많은 의미가 없습니다. 그리고 저희는 이 플랫폼에 관심 있는 많은 사람들이 배터리 수명을 가장 중요하게 생각한다는 것을 알고 있습니다. 하지만 다시 말씀드리지만, 그 모든 정보는 곧 공개될 예정입니다.
이번 첫 번째 테스트 라운드에서는 Microsoft Surface Laptop Ultra와 RTX Spark를 Apple의 최고 사양 M5 Max SoC가 탑재된 14인치 MacBook Pro 두 시스템과 비교했습니다. 해당 Mac은 40코어 GPU와 18코어 CPU, 그리고 128GB LPDDR5X RAM을 갖추고 있습니다. 현재 저희 연구실에는 모바일 Ryzen AI Max+ 395 시스템은 없지만, 최신 ROCm 스택과 llama.cpp 빌드를 통해 신선한 데이터를 얻기 위해 AMD의 소형 Ryzen AI Halo를 활용할 수 있습니다.
로컬 AI 성능
로컬 AI 성능을 측정하는 것은 끊임없이 변화하는 목표이며, 이 리뷰도 예외는 아닙니다. 저희의 과거 테스트는 프롬프트 처리 및 토큰 생성 단계를 개별적으로 수행해 왔으며, 두 단계 모두에서 빠른 시스템이 최고의 경험을 제공한다는 이해를 바탕으로 했습니다.
하지만 에이전트 워크플로우(agentic workflow)에서는 그러한 벤치마킹 기법으로는 특정 목표에 도달하는 데 필요한 모든 추론 턴(inference turns) 전반에 걸쳐 작업을 완료하는 데 필요한 총 시간을 포착할 수 없습니다. 이 전체 엔드투엔드 시간(end-to-end time)을 측정하기 위해 Artificial Analysis의 연구진은 여러 에이전트 AI 작업에 걸쳐 추론 트레이스(inference traces)를 정확하게 재현하는 새로운 벤치마크인 AgentPerf-local을 개발했습니다. 이 접근 방식의 가치는 즉각적으로 이해될 것입니다. AI 에이전트가 작업을 더 빨리 완료할수록 시스템은 더 생산적일 수 있기 때문입니다.
따라서 과거에 제시했던 '최초 토큰까지 걸리는 시간(time-to-first-token)'과 '초당 토큰 수(tokens-per-second)' 수치 대신, 보다 전통적인 CPU 및 콘텐츠 제작 벤치마크에서처럼 '완료까지 걸리는 시간(time-to-completion)' 값을 공유할 예정입니다.
다시 말씀드리지만, 로컬 AI 벤치마킹은 지속적으로 발전하는 과정이므로, 이 접근 방식에 대한 여러분의 의견을 알려주시면 저희가 방법론을 계속 개발하는 데 반영하겠습니다.
우리는 두 가지 호환 가능한 모델, 즉 크기 대비 가장 지능적인 로컬 모델 중 하나로 인기 있는 고밀도 Qwen 3.8-27B와, 지능도는 낮지만 광범위한 시스템에서 빠르게 실행하기 쉬운 Qwen 3.6 35B A3B Mixture-of-Experts(MoE) 모델을 사용하여 AgentPerf-local을 실행했습니다. 추론 백엔드로는 최신 llama.cpp 빌드를 사용했으며, 적절하게 CUDA, Metal 또는 ROCm 가속을 활용하기 위해 각 테스트 시스템에서 소스 코드로 직접 구축했습니다.
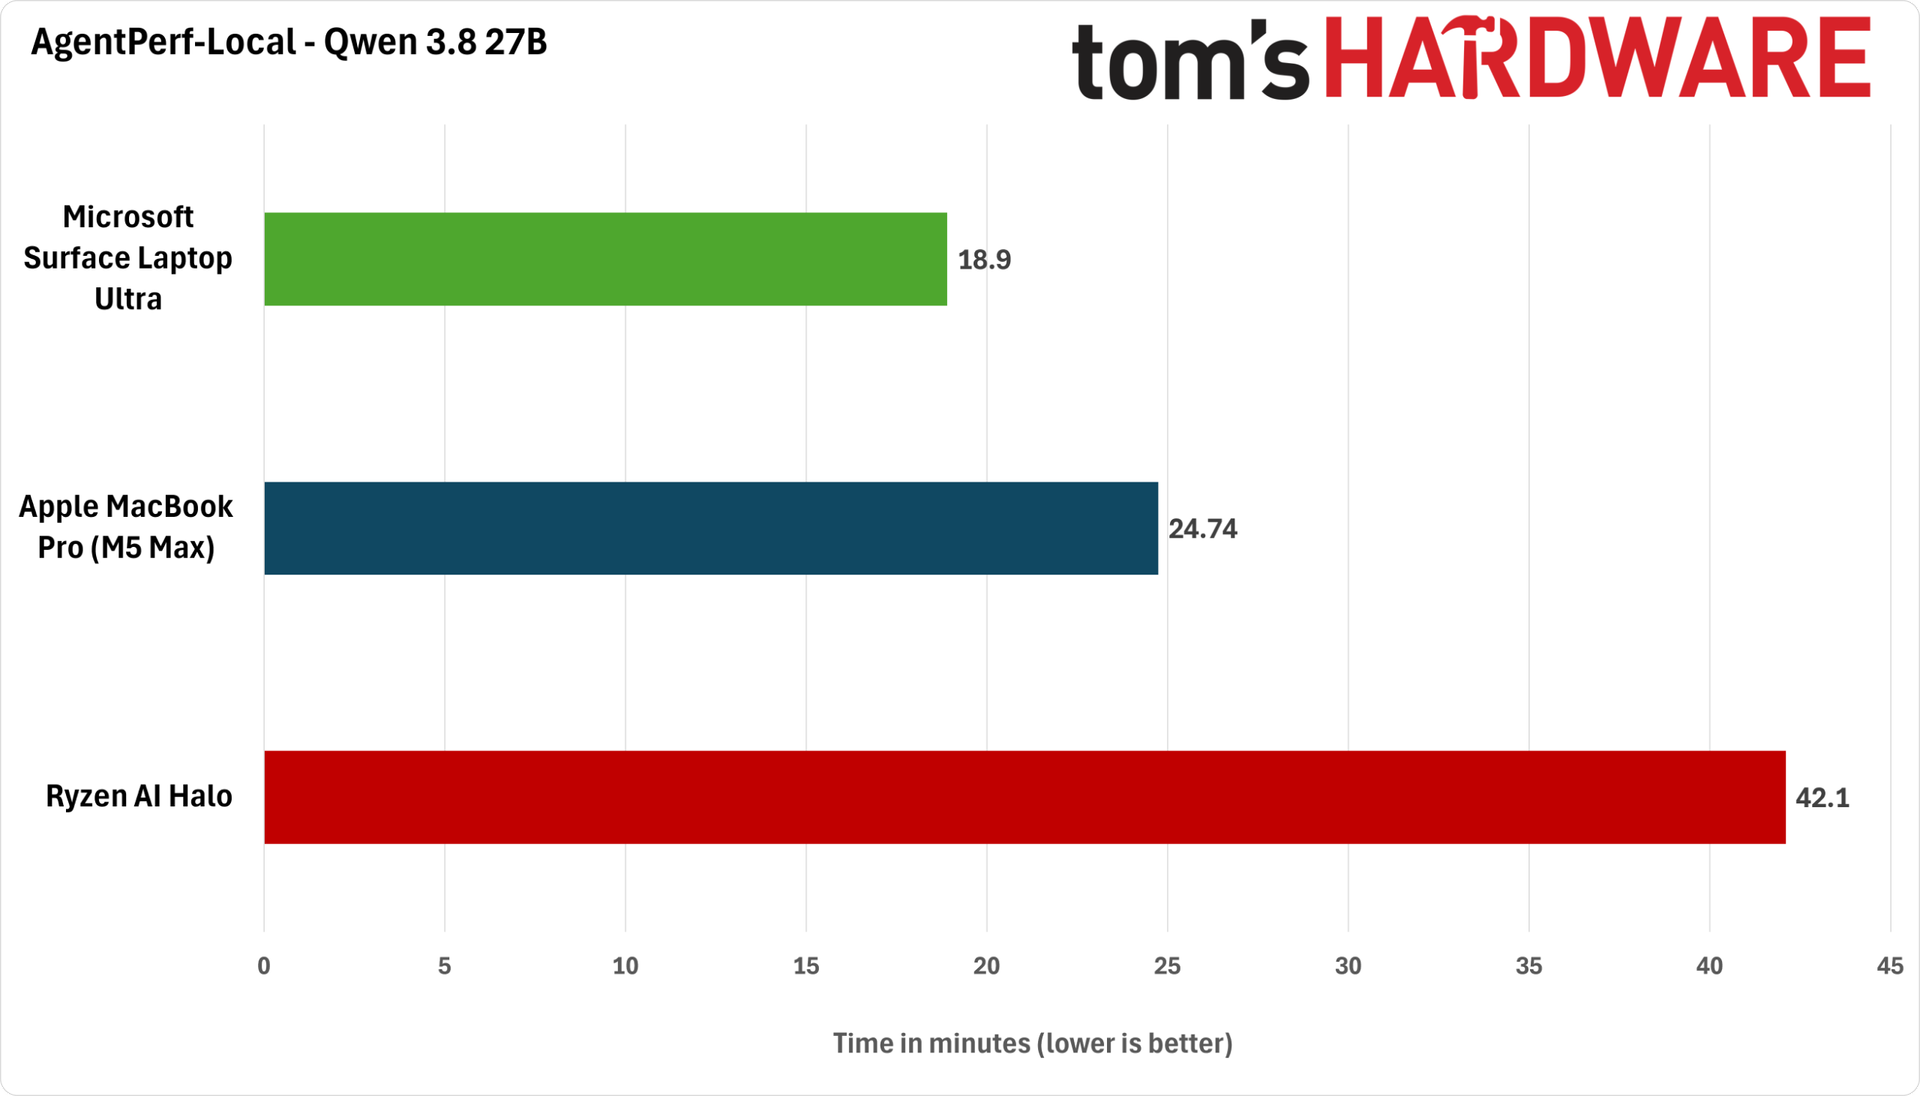
먼저 Qwen 3.8 27B의 동작을 살펴보겠습니다. 이 모델은 Unsloth의 Q4_K_M 양자화(quantization)를 사용했습니다. RTX Spark 및 MacBook Pro에서는 DFlash2 추측 디코딩(speculative decoding)과 함께 실행했고, Ryzen AI Halo에서는 최고의 성능을 위해 Qwen 3.8 27B에 내장된 MTP를 사용했습니다.
(이미지 출처: Future)
Apple의 Mac Studio와 M4 Max SoC로 수행한 벤치마크에서 알 수 있듯이, 메모리 대역폭(memory bandwidth)은 로컬 AI 성능을 제약하는 유일한 요소가 아닙니다. 이론적인 메모리 대역폭 우위에도 불구하고, M5 Max MacBook Pro는 Qwen 3.8 27B를 사용한 AgentPerf 벤치마크를 Surface Laptop Ultra (RTX Spark 탑재)보다 약 25% 더 오래 완료하는 경향을 보였습니다.
그 원인 중 일부는 소프트웨어 성숙도에 기인할 수 있지만, 저희의 Surface Laptop Ultra가 140W 전원 어댑터를 갖춘 15인치 시스템이고, MacBook Pro의 96W 충전기와 비교했을 때 더 크다는 점을 기억하는 것도 중요합니다.
16인치 M5 Max MacBook Pro 역시 140W 어댑터가 제공되므로, 이 시스템이 가진 더 큰 섀시(chassis)가 제공하는 추가 전력과 높은 열 여유 공간(thermal headroom)이 여기서 격차를 줄이는 데 도움이 될지 궁금합니다. 하지만 어떤 경우든, RTX Spark 플랫폼이 현재까지는 이 작업에서 가장 빠릅니다.
한편, AMD의 거의 2년 된 Ryzen AI Max+ 395는 이 까다로운 테스트에서 두 최신 시스템 어느 쪽도 따라잡을 수 없습니다. Qwen 3.8 27B를 사용한 에이전트 기반(agentic) 테스트를 완료하는 데 RTX Spark나 MacBook Pro보다 약 두 배의 시간이 걸리는 무려 40분이 소요되었습니다.
Ryzen AI Halo가 노트북이 아닌 미니 데스크톱 폼팩터라는 사실은 이 결과에 큰 영향을 주지 않습니다. 왜냐하면 그 디자인이 제공할 수 있는 어떤 전력 및 열 여유분도 여기서의 성능 격차를 극복할 수는 없기 때문입니다.
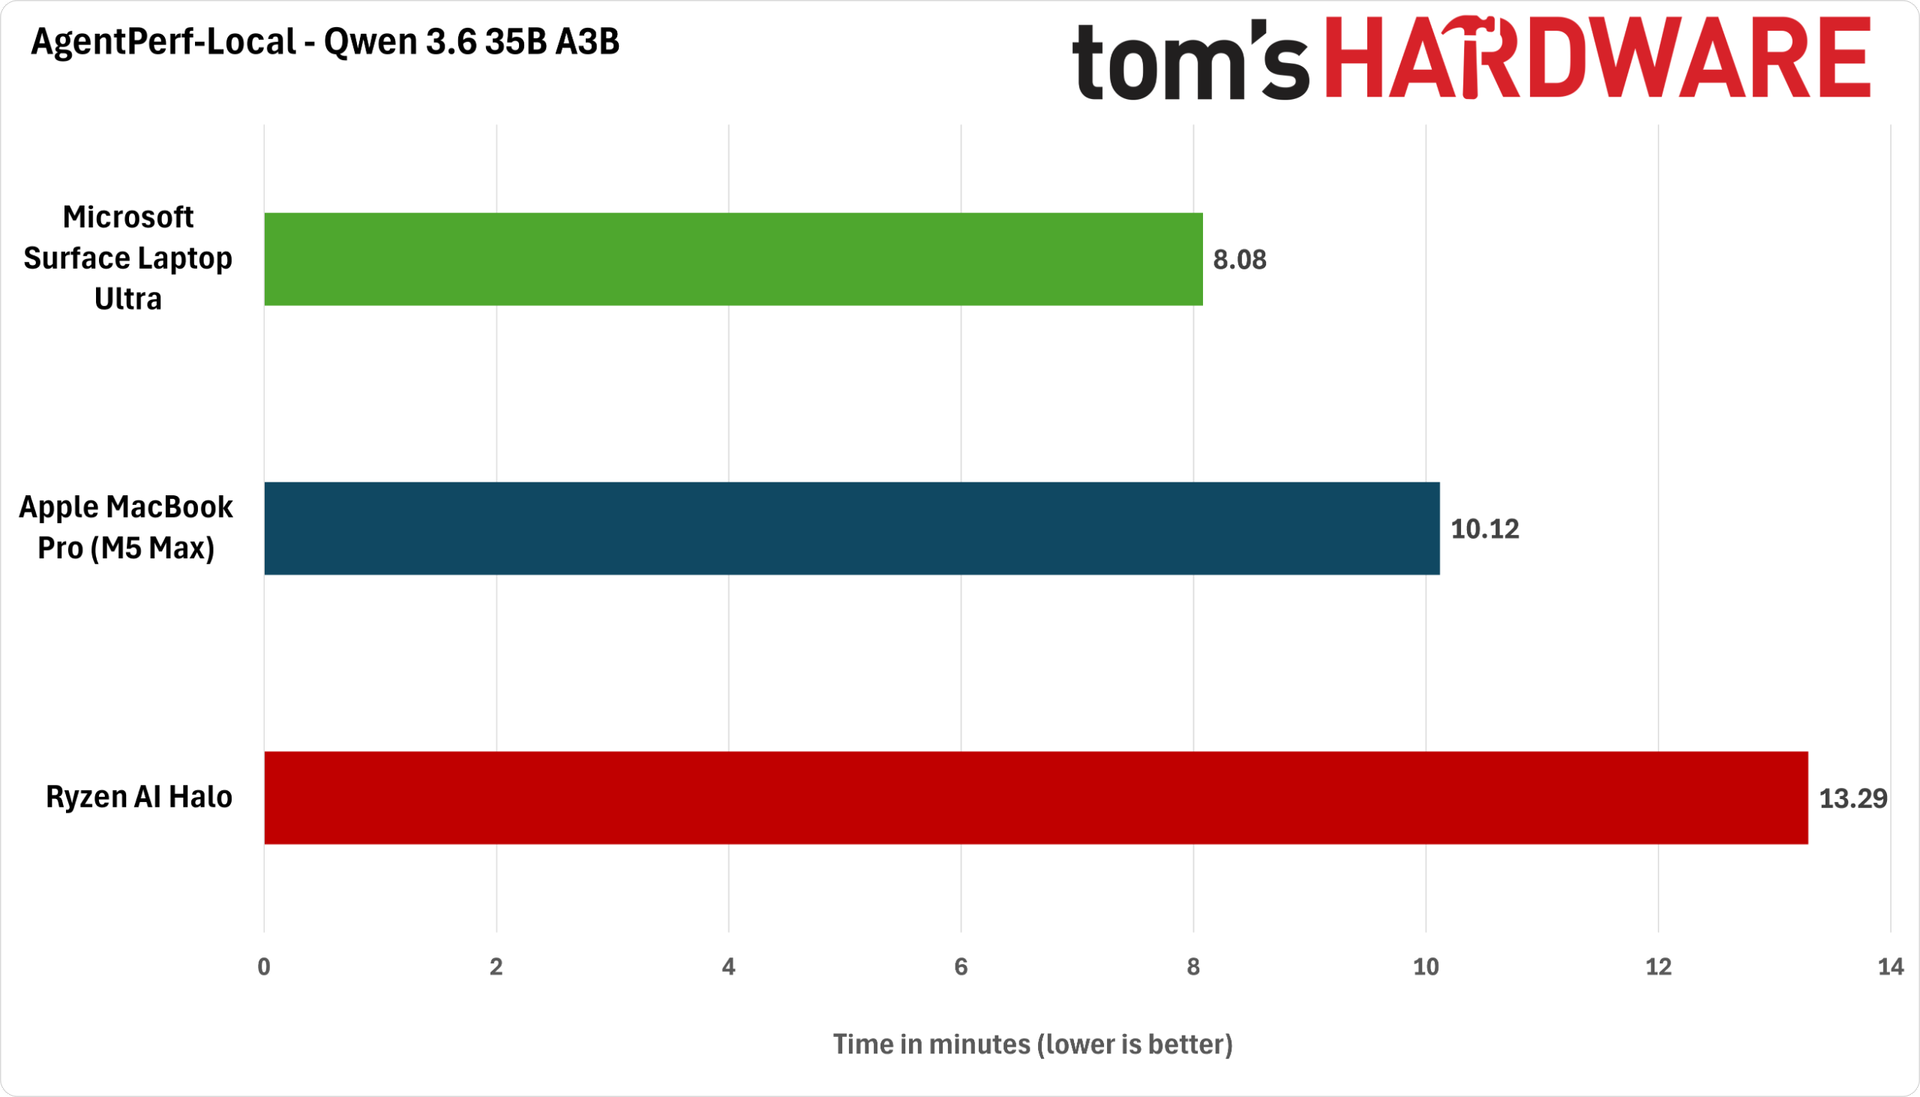
다음으로, 더 가벼운 Qwen 3.6 35B A3B 모델을 테스트했습니다. 이 모델은 MTP(Model Text Processing) 기능을 활성화한 상태에서 Unsloth의 Q4_K_M 양자화(quantization)를 거쳤습니다.
(이미지 출처: Future)
Surface Laptop Ultra는 이 테스트를 단 8분 만에 완료하여, 14인치 MacBook Pro의 10분보다 약 25% 더 빠릅니다. 이 테스트는 또한 상대적으로 합리적인 시간인 13분 만에 벤치마크를 마친 Ryzen AI Halo에게도 훨씬 유리합니다. 하지만 이는 Strix Halo에서 합리적인 수준의 성능을 얻으려면 모델 지능을 포기해야 함을 강조할 뿐입니다.
AMD는 최근 Strix Halo 시스템이 DGX Spark 데스크톱이나 RTX Spark 노트북에 비해 상대적으로 낮은 진입 비용을 가지고 있음을 홍보하고 있습니다. 하지만 시간이 곧 돈이고, 로컬 AI 시스템에서 더 많은 지능적인 토큰을 더 빠르게 얻는 것이 잠재적으로 수익성 있는 에이전트 작업(agentic work)의 증가를 의미한다면, 초기 투자 비용이 더 비싼 시스템이 그 작업을 더 많이 수행하고 시간이 지남에 따라 더 큰 가치를 창출할 수 있을 것입니다.
게이밍 성능: 첫인상
RTX 브랜딩과 Nvidia가 강조하는 6144-CUDA 코어 GPU(또는 48 SM)에도 불구하고, RTX Spark 플랫폼은 게이밍에서 몇 가지 어려운 도전에 직면합니다. 오늘날 사용 가능한 대부분의 게임은 이 Arm CPU용으로 네이티브하게 컴파일되지 않았으며, 설령 그렇게 될 수 있는 경우라도, 이 플랫폼이 제공하는 최대 300 GB/s의 공유 메모리 대역폭은 26 SM에 전력을 공급하는 RTX 5060 Mobile의 전용 384 GB/s보다 훨씬 낮습니다.
전체 GB10 SoC가 비교적 적은 양의 메모리 대역폭을 놓고 경쟁하고 있으며, 그래픽 작업이 일반적으로 메모리 대역폭 제한(memory-bandwidth-bound) 워크로드이기 때문에, 이는 게임에서 모든 SM에 전력을 공급하는 데 좋지 않은 출발점입니다.
게이밍 탐험은 _Gears of War: E-Day_로 시작했습니다. 이 예외적으로 CPU 의존도가 높은 게임에서, Grace CPU 코어의 기본 성능과 Prism x86 에뮬레이터가 추가하는 오버헤드가 이 타이틀에 전혀 도움이 되지 않는다는 것이 분명합니다.
GPU 활용도는 High 프리셋 및 2X 프레임 생성(framegen)을 적용하고 거의 1080p (1908x1272) 렌더링 해상도에서 평균적으로 85% 수준에 머물렀으며, 게임 진행 중 맵 전환 시에는 몰입감 있는 경험을 하기에 부족한 주요 끊김 현상을 적어도 한 번 목격했습니다.
<table><caption>Gears of War: E-Day (1908x1272, High Preset, Mega Geometry On, MFG 2X)</caption><tbody><tr><td class="firstcol empty"></td><td><p><strong>평균 FPS</strong></p></td><td><p><strong>1% 최저 FPS</strong></p></td><td><p><strong>평균 PC 지연 시간 (ms)</strong></p></td></tr><tr><td class="firstcol "><p><strong>RTX Spark가 탑재된 Microsoft Surface Laptop Ultra</strong></p></td><td><p>77.7</p></td><td><p>39.9</p></td><td><p>83.5</p></td></tr></tbody></table>_Gears_는 CPU 의존도가 높기 때문에 이 플랫폼의 최악의 시나리오일 수 있지만, 여전히 좋은 경험은 아니며, 설정을 낮추거나 업스케일링 입력 해상도를 낮추는 것은 이 타이틀의 CPU 경계(CPU-boundedness) 문제를 더욱 악화시킵니다. 만약 어떤 게임이 네이티브 Arm 빌드를 사용할 수 있다면, 바로 이 게임입니다.
_Control Resonant_는 CPU 의존도가 현저히 낮지만, 이는 RTX Spark Superchip의 다른 잠재적인 게이밍 단점들이 나타난다는 것을 의미합니다.
DLSS 업스케일링을 사용했음에도 불구하고 Surface Laptop Ultra의 네이티브 3270x2180 출력 해상도에서 안정적인 프레임 속도와 입력 지연 시간을 달성하는 데 다소 어려움을 겪은 후, 저는 게임을 창 모드(windowed mode)로 설정하고 2560x1440 해상도에 DLSS Performance 업스케일링, High 프리셋, 그리고 프레임 속도를 Surface Laptop Ultra의 120Hz 주사율 근처로 유지하기 위해 MFG 3X를 적용하여 실행했을 때 더 나은 결과를 얻었습니다. (이 시스템의 긴 3:2 화면 비율 때문에 16:9 전체 화면 게임이 깔끔하게 확장되지 않습니다.)
하지만 그럼에도 불구하고 입력 지연 시간(input latency)은 저희 표준 GPU 테스트 장비에서 허용 가능한 수준을 넘었으며, 레이 트레이싱(ray tracing)을 활성화하는 것은 프레임 속도를 떨어뜨리고 입력 지연 시간을 더욱 급격하게 증가시켰기 때문에, 저는 최고의 결과를 얻기 위해 래스터 전용 렌더링(raster-only rendering)에 머물러야 했습니다.
전반적으로, 저의 초기 RTX Spark 게이밍 평가는 이 플랫폼으로도 충분히 게임을 즐길 수 있고 괜찮은 시간을 보낼 수는 있지만, 이것이 이 플랫폼의 주된 초점은 아니라는 것입니다. RTX Spark Superchip의 상대적으로 제한적인 메모리 대역폭(memory bandwidth)과 시스템의 CPU 성능, 그리고 Prism 에뮬레이션 오버헤드가 결합되어, 기본 프레임 속도, 업스케일링(upscaling), 이미지 품질, 그리고 프레임 생성(frame generation)을 통한 부드러움 향상 모두가 허용 가능한 입력 지연 시간을 제공하는 좁은 설정 범위 내에서 찾아야 함을 의미합니다.
이 플랫폼에서 게이밍에 접근했을 때, 저는 DLSS 업스케일링이 경험의 필수적인 부분이 될 것이라고 예상했지만, 실제로는 추가적인 부드러움(예: Gears of War)이나 개발자의 내부 선택으로 인한 부드러함과 Nvidia Reflex의 이점 모두를 위해 DLSS 프레임 생성에 의존해야 합니다 (예: Control Resonant).
하지만 Reflex가 있음에도 불구하고, Grace CPU는 일반적으로 저희 Ryzen 7 9800X3D 테스트 장비에서 익숙했던 것보다 훨씬 높은 입력 지연 시간을 제공하는 경향이 있으며, 설정을 조정하더라도 이러한 AAA 타이틀에서 이를 훨씬 더 낮추기는 어렵습니다.
최첨단 게임에서 가장 낮은 입력 지연 시간과 최고의 성능을 요구하고, 특히 RT(레이 트레이싱)를 활성화할 계획이라면, 전용 RTX 50 시리즈 GPU가 탑재된 별도의 게이밍 노트북이 여전히 더 뛰어난 경험을 제공할 것입니다. 그리고 로컬 AI에 전혀 신경 쓰지 않는다면, 이 조언은 더욱 강력하게 적용됩니다.
요약하자면
Nvidia의 RTX Spark는 오늘날의 전통적인 워크로드와 내일의 잠재적인 에이전트형 AI(agentic AI) 작업을 위한 야심 찬 새로운 PC 플랫폼입니다. 이렇게 광범위한 비전을 가지고 앞으로 PC가 어떻게 사용될지에 대한 접근 방식을 제시하는 완전히 새로운 플레이어가 혼잡하고 경쟁적인 PC 공간에 끼어들려고 시도하는 것을 얼마나 자주 볼 수 있을까요? 이것은 점진적인 움직임이 아닙니다.
AI 자동 생성 콘텐츠
본 콘텐츠는 Tom's Hardware의 원문을 AI가 자동으로 요약·번역·분석한 것입니다. 원 저작권은 원저작자에게 있으며, 정확한 내용은 반드시 원문을 확인해 주세요.
원문 바로가기