
Marvell이 Radix, 저지연성 및 대역폭을 Teralynx T100과 함께 제공하다
요약
Marvell은 HPC 및 AI 시스템의 핵심인 스위치 ASIC 성능을 극대화한 Teralynx T100을 공개했습니다. 이 칩은 높은 라딕스, 낮은 지연성, 높은 대역폭이라는 세 가지 요소를 모두 충족시키며, TSMC의 첨단 공정(N3E 추정)을 활용하여 리티클 한계에 도전하는 모놀리식 설계를 보여줍니다.
핵심 포인트
- Teralynx T100은 고성능 컴퓨팅 및 AI 시스템용 스위치 ASIC입니다.
- TSMC의 3나노미터 공정을 사용하여 높은 대역폭과 라딕스를 구현했습니다.
- 총 집계 대역폭 100.4 Tb/sec을 달성하며 성능 한계를 끌어올렸습니다.
CONNECT
Marvell이 Radix, 저지연성 및 대역폭을 Teralynx T100과 함께 제공하다
현대 HPC(고성능 컴퓨팅) 및 AI 시스템에서 높은 스위치 라딕스(switch radix) – 즉 주어진 스위치 ASIC에 연결할 수 있는 포트의 개수 –는 저지연성과 높은 대역폭만큼 중요해졌습니다.
이상적으로는 이 모든 것을 제공하는 메가스위치가 있을 것이며, 그 ASIC 소켓은 12인치 실리콘 웨이퍼 절반 다발 크기일 것입니다. 하지만 그러한 거대한 스위치는 자체적인 문제점을 야기할 수 있으며, 이것이 우리가 컴퓨팅과 스토리지를 분해하듯이 네트워크도 여전히 분해하고 있는 이유입니다.
그럼에도 불구하고, 이 세 가지 다른 벡터 – 라딕스, 지연성, 대역폭 –의 균형을 맞추는 것이 스위치 칩 설계자들에게 주어진 임무이며, Marvell에 의해 2021년 8월 인수된 하이퍼스케일 이더넷 칩 스타트업 Innovium은 2015년 설립된 이후 지연성 및 대역폭의 장벽을 밀어붙여 왔고, 2년 후는 은밀한 모드(stealth mode)를 벗어났습니다. 그리고 곧 샘플링을 시작할 새로운 Teralynx T100과 함께 Marvell의 스위치 ASIC 팀은 한계까지 성능을 끌어올리고 있습니다. 이를 통해 Marvell은 하이퍼스케일 업체와 클라우드 빌더들이 Teralynx 칩과 스위치를 사용하는 범위를 넓힐 가능성이 높으며, 심지어 확장(scale out) 및 축소(scale up) 네트워크를 위해 높은 대역폭, 높은 라딕스, 낮은 지연성의 이더넷을 찾는 AI 모델 구축 업체들에게도 관심을 받을 수 있습니다.
Teralynx 칩은 2020년 코로나바이러스 팬데믹이 발생한 이후로 큰 성장을 거두었습니다. 이전에 독립적이었던 Innovium은 2020년에 Teralynx 7 및 8 칩을 혼합하여 1백만 개 이상의 400 Gb/sec 이더넷 포트를 출하했으며, 2년 후 Marvell은 Teralynx ASIC을 양산에 투입했고, 이 ASIC들은 12.8 Tb/sec에서 51.2 Tb/sec에 이르는 총 대역폭을 가집니다.
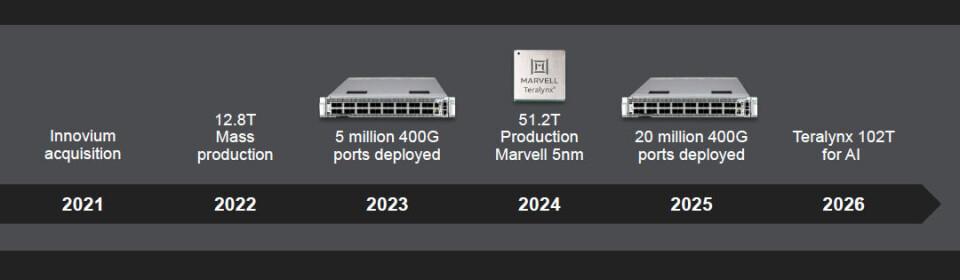
2023년까지 Marvell은 5백만 개 이상의 400 Gb/sec 포트를 출하했으며, 이는 약 30만 대가 넘는 스위치에 해당합니다. 작년에는 Taiwan Semiconductor Manufacturing Co.의 5 나노미터 공정을 사용하여 2024년에 출시된 51.2 Tb/sec Teralynx 10 ASIC 덕분에 2천만 개 이상의 400 Gb/sec 포트를 판매했으며, 이는 약 125만 대의 스위치에 해당합니다.
이번 Teralynx T100을 통해 Marvell Network Switching Division의 총괄 매니저인 Rishi Chugh는 The Next Platform과의 인터뷰에서 이 제품이 한계를 최대한으로 밀어붙이고 있으며, 리티클(reticle) 한계에 도전하는 모놀리식 스위치 ASIC이며 TSMC의 3 나노미터 공정, 아마도 N3E 세련화 변형일 것이라고 전했습니다.
최근에는 스위치 ASIC의 다이샷을 얻는 경우가 매우 드물지만, Chugh는 T100에 대한 다이샷을 확보할 수 있었습니다:
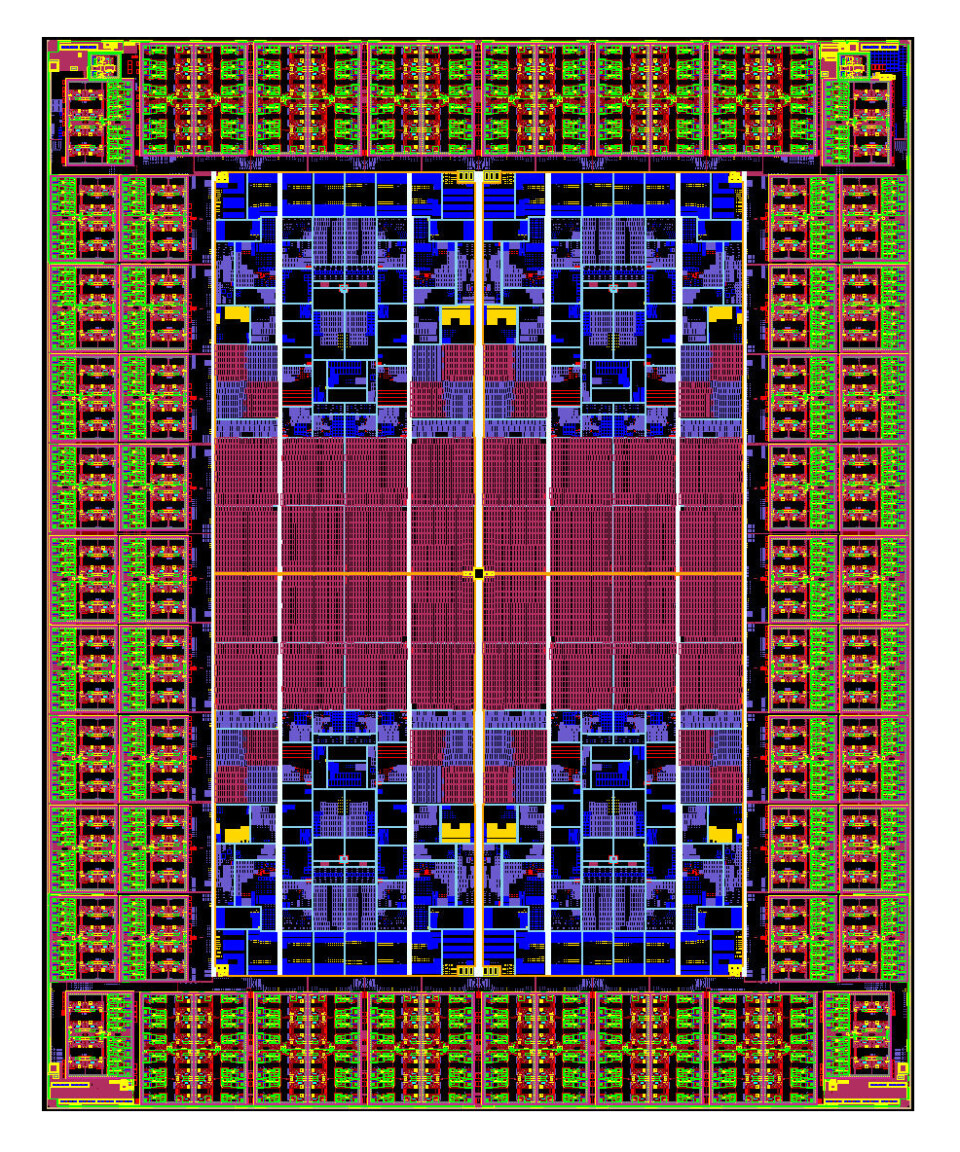
꽤 멋지지 않습니까?
총 집계 대역폭 100.4 Tb/sec을 달성하고 224 Gb/sec SerDes(신호 전송 오버헤드를 제외하면 200 Gb/sec으로 낮아짐)를 사용하여, T100에는 패킷 처리 엔진과 SRAM 캐시에 512개의 SerDes가 둘러싸여 있습니다. 빨간색 영역이 SRAM이며, 명확하게 네 개의 패킷 처리 엔진 블록이 있습니다.
저는 76개의 SerDes 블록을 세었습니다. 왼쪽과 오른쪽에 각각 18개, 그리고 위아래에 각각 18개와 각 모서리에 4개가 있습니다. 만약 각 블록이 4개의 SerDes라면 총 608개의 SerDes가 되며, 이 블록들의 수율(yield)을 84%로 가정하면 작동하는 SerDes는 512개가 됩니다.
Chugh에 따르면 모놀리식 다이를 유지하고 SerDes를 칩렛(chiplet)으로 분할하지 않음으로써 T100은 전력 소비가 25% 낮습니다. 물론 상당히 새로운 N3 공정에서 큰 모놀리식 칩을 사용할 때 수율 문제가 있습니다. 이것이 실제 칩의 SerDes 개수가 사양서에 명시된 것보다 19% 더 많은 이유입니다. 하지만 성능과 낮은 전력을 원한다면, 더 비싼 칩을 만들어야 합니다.
명확히 말해 이 AI 시대에는 돈이 아직 제한 요소가 아닙니다... 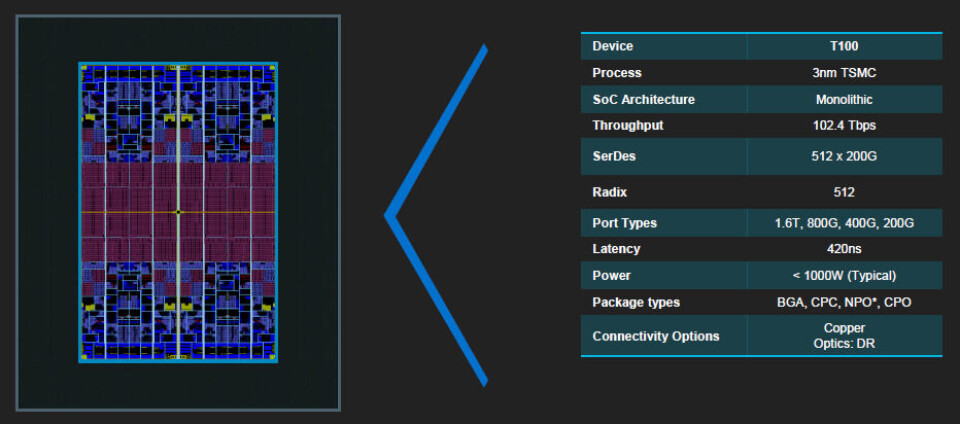
T100 칩의 일반적인 전력 소비량은 1,000와트 미만이며, 특히 포트 간 호핑 지연 시간(port to port hop latency)이 단지 420나노초에 불과합니다. 이는 InfiniBand가 동일한 포트 속도에서 달성할 수 있는 수준인 약 130나노초만큼 낮은 것은 아니지만, Marvell은 추가적인 엔지니어링을 통해 지연 시간을 중간 300나노초 범위까지 낮추기를 기대하고 있습니다. 이 정도의 낮은 지연 시간 덕분에 T100은 AI 가속기용 ESUN 스케일 업 메모리 공유 프로토콜(ESUN scale up memory sharing protocol)을 지원할 수 있게 되며, 이는 전 세계 XPU의 Nvidia NVLink 프로토콜 및 NVSwitch 메모리 패브릭의 대안이 될 것입니다.
T100은 또한 Ultra Ethernet Consortium 프로토콜도 지원하며, 특히 수만 개에서 수십만 개의 XPU와 스케일 아웃 네트워크(scale out networks)가 원활하게 작동하도록 만드는 적응형 라우팅 기능(adaptive routing functions)을 갖추고 있습니다. 그리고 Teralynx 7 및 Teralynx 10 칩과 마찬가지로, Microsoft가 원래 개발한 오픈 소스 SONiC Linux 기반 네트워크 운영체제(network operating system)는 물론, Innovium이 애초에 목표했던 초기 고객인 하이퍼스케일러(hyperscalers)와 클라우드 빌더들이 만든 자체 NOS도 실행할 수 있습니다.
보시다시피, 이 512개의 작동하는 SerDes를 여러 가지 방식으로 결합할 수 있습니다. SerDes 하나가 포트 하나를 구동한다면, 200Gb/sec로 작동하는 512개 포트를 얻을 수 있습니다. 400Gb/sec에서 256개 포트, 800Gb/sec에서 128개 포트, 그리고 1.6Tb/sec에서 64개 포트를 구현할 수 있습니다. 이는 여전히 Nvidia가 NVSwitch로 주도하는 대역폭에는 미치지 못하지만, NVSwitch 역시 낮은 radix를 가지고 있어 결국 연결(chaining)해야 합니다.
아마도 Marvell에게 가장 중요한 것은 Teralynx T100이 다양한 종류의 배선 옵션과 함께 제공된다는 점일 것입니다. 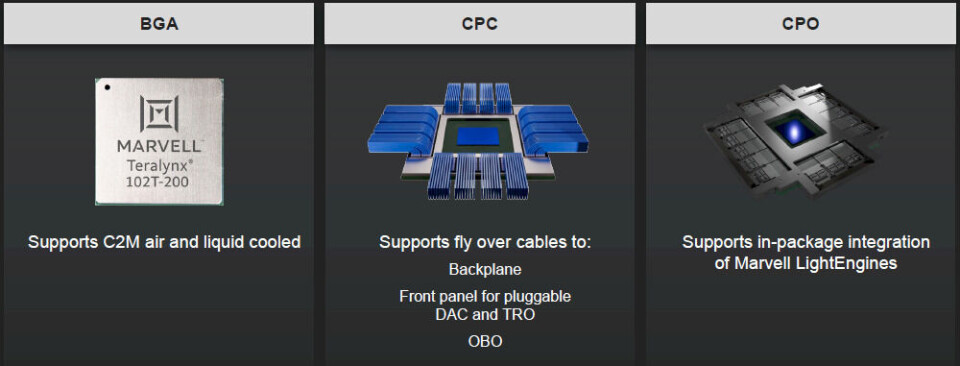
만약 단순히 일반적인 BGA 패키징의 칩을 원한다면, 다음과 같은 스위치를 얻게 됩니다: 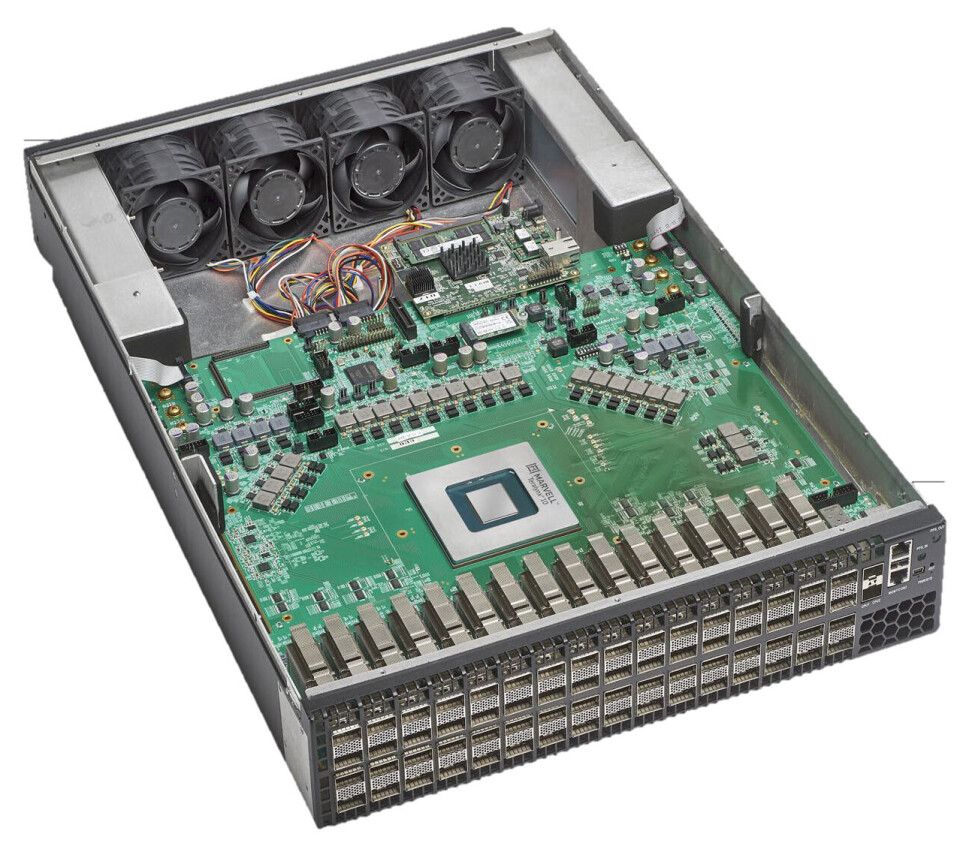
두 BGA 레퍼런스 플랫폼은 3U 폼팩터에서 1.6 Tb/sec로 작동하는 64포트를 제공하는 것을 목표로 합니다. 첫 번째 버전은 Open Compute Project의 Open Rack v3 폼팩터를 지원하며, 이는 버스바 전원 공급을 지원하고 21인치 너비의 폼팩터를 가집니다. 이 장치는 Meta Platforms가 T100 스위치 ASIC를 사용하고 있음을 강력하게 시사합니다. BGA 레퍼런스 플랫폼에는 또한 일반 AC 전원을 사용하는 19인치 너비의 일반적인 3U 폼팩터도 포함됩니다. 이 두 가지 BGA 레퍼런스 스위치는 2026년 4분기에 샘플링을 시작할 예정입니다.
코패키지 광학(CPO)까지 완전히 나아갈 준비가 되지 않은 분들을 위해, 코패키지 구리(CPC) 변형이 있으며 이에 대한 두 가지 레퍼런스 플랫폼이 있습니다:
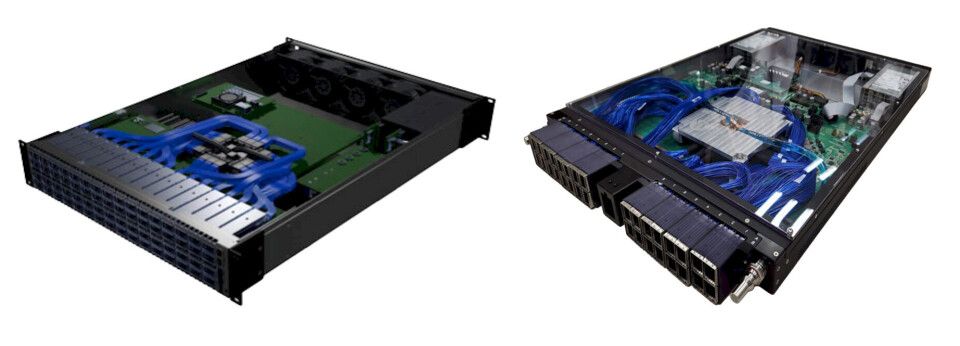
왼쪽에 있는 것은 64개의 OSFP 포트를 지원하고 1.6 Tb/sec로 작동하며 F-OSFP 포트로 CPC를 갖는 2U 스위치입니다. 오른쪽에 있는 것은 24포트만 가진 것으로 보이는 1U 스위치입니다.
SerDes에서 직접 신호를 구동할 수 있는 NPO 버전도 있으며, 이는 표시되지 않았고, 물론 이 경로로 가기를 원하는 사람들을 위한 적절한 CPO 버전도 있습니다:
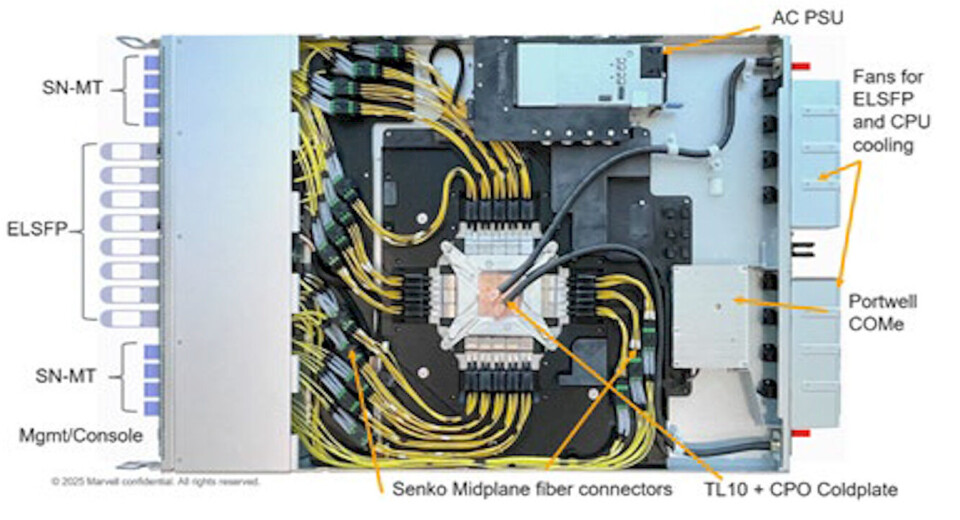
T100 레퍼런스 플랫폼의 CPO 변형 역시 Orv3 디자인이며 DC 버스바 디자인을 가지고 있지만 AC 전원 공급 장치 옵션도 갖추고 있습니다. 이 플랫폼은 X86 또는 Arm CPU를 지원하는 Compute on Module Express (COMe) 제어 평면을 가지고 있습니다. 이 초기 CPO 디자인은 공랭식과 액체 냉각을 혼합하여 사용하지만, T100이 CPO 옵션과 함께 주로 액체 냉각될 것으로 예상됩니다.
T100 기반 스위치는 다음과 같은 자본 지출(capex) 및 운영 비용(opex) 총 소유 비용(TCO) 절감 혜택을 제공할 것으로 예상됩니다:
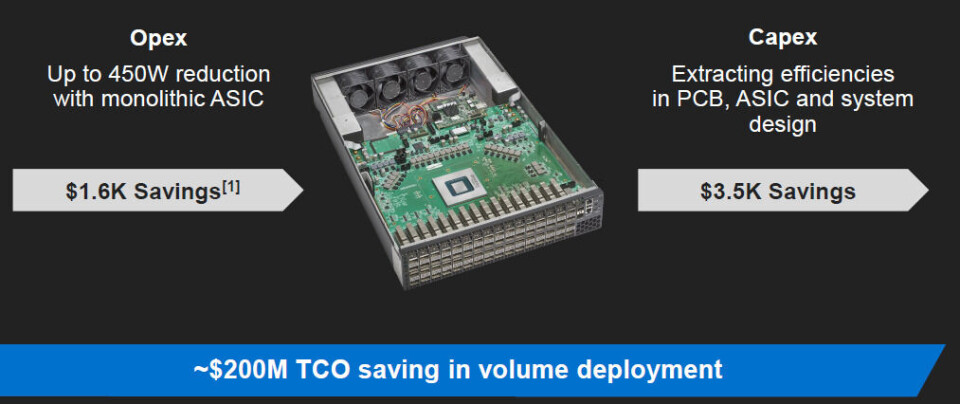
볼륨 배포가 무엇을 의미하는지는 명확하지 않지만, 위에서 언급된 2억 달러의 TCO 절감을 얻기 위해서는 수만 개의 스위치가 필요할 가능성이 높습니다. 이러한 규모는 GenAI 시대에는 큰 문제가 아닙니다.
Marvell은 T100의 변형을 기반으로 하는 ESUN 스위치를 2027년 하반기에 출시할 것으로 예상하며, 시장에서는 Microsoft와 Meta Platforms가 ESUN의 주요 지지자가 될 것이라는 소문이 돌고 있습니다. 또한 Marvell은 2027년 상반기에 UALink 스위치도 계획하고 있습니다.
AI 자동 생성 콘텐츠
본 콘텐츠는 The Next Platform의 원문을 AI가 자동으로 요약·번역·분석한 것입니다. 원 저작권은 원저작자에게 있으며, 정확한 내용은 반드시 원문을 확인해 주세요.
원문 바로가기