llm-wiki
License: MIT
Release
Stars
Top Language
Last Commit
Karpathy's LLM Wiki를 Claude Code로 구축했습니다. 2계층 캐시 아키텍처 (L1/L2). Logseq 및 Obsidian을 지원합니다.
graph TB
    subgraph "Every Session — Auto-loaded"
        L1[L1: Claude Memory]
...
이것은 무엇인가?
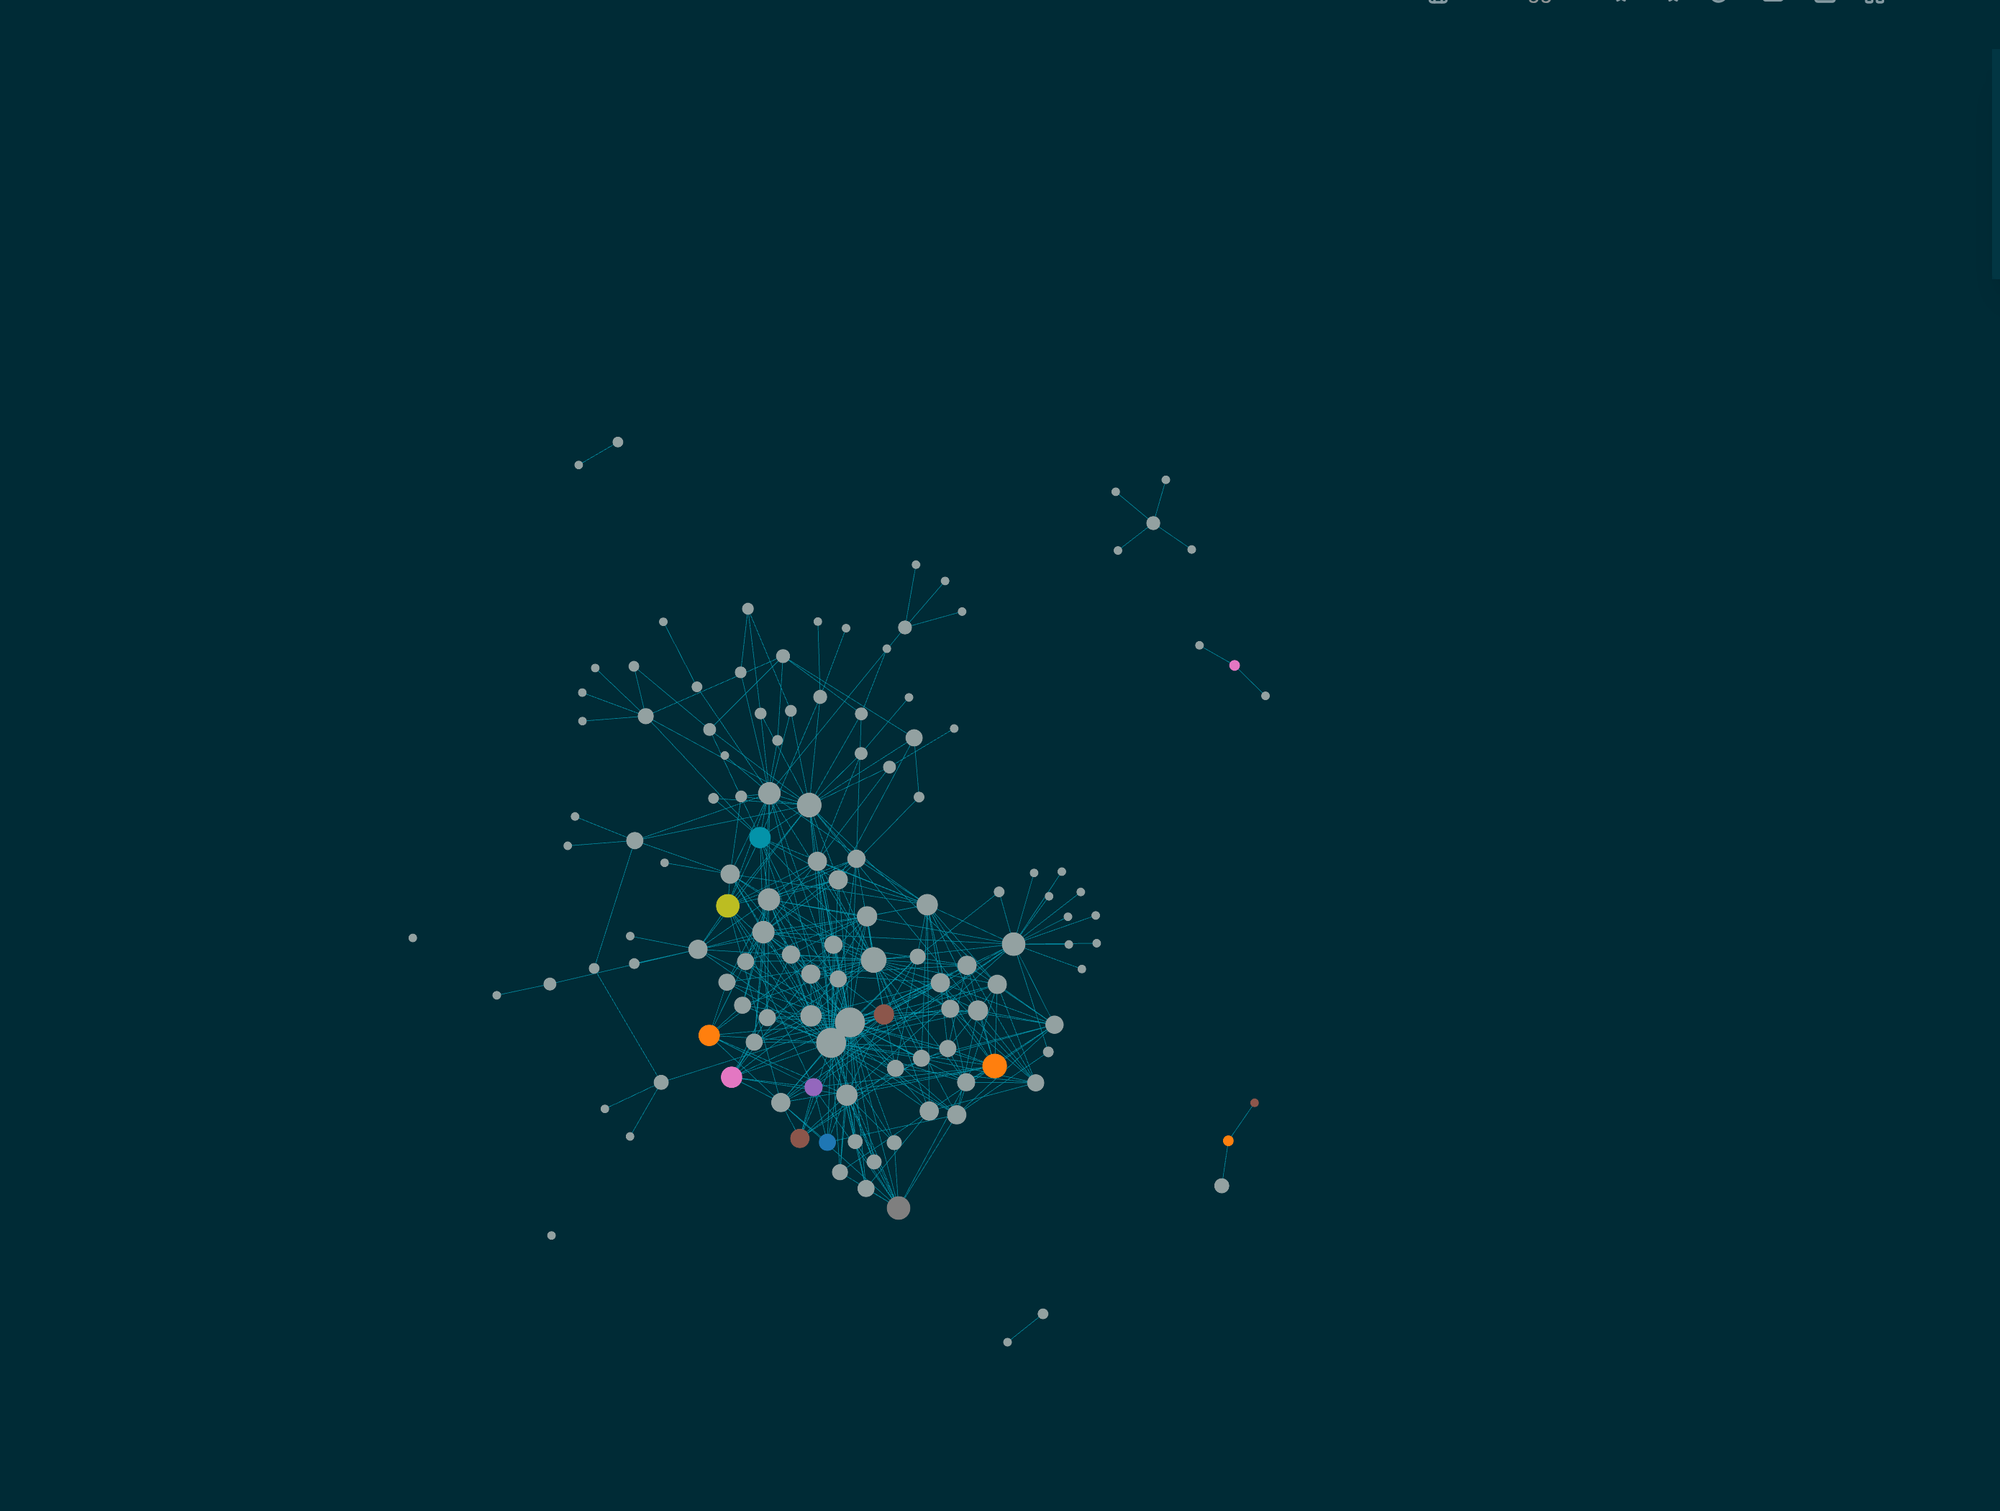
Wiki graph view after setup
몇 번의 데이터 주입(ingest) 후의 위키 — Logseq의 그래프 뷰에 연결된 지식 페이지들.
2026년 4월, Andrej Karpathy는 "LLM Wiki"라는 이름의 gist를 게시했으며, 이는 며칠 만에 5,000개 이상의 스타를 받았습니다. 아이디어는 다음과 같습니다: LLM이 사용자를 위해 구조화되고 상호 참조되는 위키를 유지하도록 하는 것입니다. 원시 소스(raw sources)를 공급하면, LLM이 사실을 추출하고 이를 연결하며 모든 것을 일관되게 유지합니다. 이 위키는 오래된 노트들의 무덤 대신 지속적이고 복리적인 아티팩트가 됩니다.
모두가 이 개념을 좋아했지만, 거의 아무도 구현하지 않았습니다. 해당 gist는 실제 도구, 파일 및 워크플로우와 어떻게 연결할지(how)를 설명하는 것이 아니라 무엇을 구축해야 하는지(what)를 설명합니다. llm-wiki가 바로 그 구현체입니다. 이는 LLM의 두뇌로 Claude Code를 사용하고, 위키 UI로는 Logseq 또는 Obsidian 중 하나를 사용하며, Karpathy의 gist에서 언급되지 않은 핵심 통찰력인 2계층 캐시 아키텍처(two-layer cache architecture)를 활용합니다.
왜 이것을 사용해야 하는가?
- 5분 만에 설정 완료. 플러그인을 설치하고
/llm-wiki setup을 실행하면 스키마(schema), 네임스페이스(namespaces), Git 추적 기능이 갖춰집니다. 수동 디자인 작업이 필요 없습니다.
- Claude가 위키 관리자가 됩니다.
/llm-wiki ingest를 사용하면 단일 소스로부터 교차 참조를 포함하여 5~15개의 페이지를 업데이트합니다.
- L1/L2 아키텍처. 메모리 내 자동 로드 규칙(L1)과 위키의 심층 지식(L2)을 결합했습니다. 다른 도구에는 이 기능이 없습니다.
- 내장 품질 검사 기능.
/llm-wiki lint를 사용하면 고아 페이지(orphan pages), 오래된 콘텐츠(stale content), 깨진 참조(broken refs), 자격 증명 유출(credential leaks)을 찾아냅니다.
- Logseq + Obsidian. 이미 사용하고 있는 것을 이용하세요. 도구를 전환할 필요가 없습니다.
빠른 시작 (Quick Start)
Claude Code 플러그인으로 사용하기 (권장)
claude plugin marketplace add MehmetGoekce/llm-wiki
claude plugin install llm-wiki@mehmetgoekce
Claude Code 2.1.275 버전 이상에서는 세션 내 한 줄로 동일한 작업을 수행할 수 있습니다:
/plugin install llm-wiki --marketplace MehmetGoekce/llm-wiki
Claude Code는 위키 루트(Wiki root) 값 하나를 요청합니다. 이는 사용자의 Logseq 그래프 또는 Obsidian 볼트입니다. 해당 디렉토리는 비어 있거나 아직 존재하지 않을 수 있습니다. 그런 다음, 어떤 프로젝트에서든 다음 명령을 실행합니다:
/llm-wiki setup
/llm-wiki ingest "첫 번째 소스"
/llm-wiki query "X에 대해 무엇을 알고 있나요?"
...
/llm-wiki setup은 어떤 도구를 사용하고 싶은지, 그리고 어떤 네임스페이스를 원하는지 물어본 후 스키마(Schema), 대시보드(Dashboard), 허브 페이지(hub pages), 접근 로그(Access-Log) 및 llm-wiki.yml 파일을 생성합니다. 위키는 빈 상태에서 시작하여 인제스트(ingest)할 때마다 밀도가 높아집니다. 새로운 릴리스는 플러그인을 통해 사용자에게 전달되므로 복사할 필요가 없습니다.
Claude Code 2.1.296 버전으로 테스트되었습니다.
플러그인 없이 사용하기
저장소(repository)를 클론하고 해당 스킬을 사용할 프로젝트에 복사합니다:
git clone https://github.com/MehmetGoekce/llm-wiki.git ~/llm-wiki
mkdir -p ~/myproject/.claude/commands
cp ~/llm-wiki/SKILL.md ~/myproject/.claude/commands/wiki.md
복사된 파일에서 두 개의 플레이스홀더를 절대 경로로 대체해야 합니다:
${user_config.wiki_path} ("Wiki root:" 라인): 사용자의 Logseq 그래프 또는 Obsidian 볼트${CLAUDE_PLUGIN_ROOT} (설정 워크플로우): 클론된 폴더, 따라서 setup이 templates/를 찾을 수 있도록 합니다.
리눅스에서 실행 (macOS의 경우, sed -i 대신 sed -i ''를 사용하세요):
sed -i -e 's|\\$user_config.wiki_path}|/home/you/notes/wiki|g' \
       -e 's|\\$CLAUDE_PLUGIN_ROOT}|/home/you/llm-wiki|g' \
       ~/myproject/.claude/commands/wiki.md
그런 다음 해당 프로젝트에서 /wiki setup을 실행합니다. 복사본은 /wiki <명령어>로 호출되며, 복사한 버전에 머무르고, 클론이 원래 위치에 있어야 합니다. 플러그인이 권장되는 경로입니다.
이 README의 나머지 부분은 /llm-wiki <명령어>를 작성합니다. 복사된 스킬을 사용하는 경우, /wiki <명령어>를 입력하세요.
복사된 스킬에서 플러그인으로 이동하기
플러그인을 설치하고, 기존 위키 디렉토리를 위키 루트로 지정한 다음, 프로젝트에서 복사된 .claude/commands/wiki.md 파일을 삭제합니다. 위키 자체는 변경할 필요가 없습니다.
v1.6.0 버전에서 넘어오는 경우
플러그인의 명령어가 두 번째 부분을 잃었습니다: /llm-wiki:wiki ingest는 이제 /llm-wiki ingest이며, /llm-wiki:setup은 이제 /llm-wiki setup입니다. 플러그인을 업데이트하고 새 이름을 사용하세요.
L1/L2 아키텍처
이 부분은 Karpathy의 요약본(gist)에 포함되지 않은 내용이며, 가장 중요한 설계 결정으로 판명되었습니다.
위키를 구축하기 시작할 때 본능적으로 모든 것을 한곳에 넣으려는 경향이 있습니다. 그것은 잘못된 것입니다.
| Layer | 내용 | 크기 | 로딩 방식 | 포함하는 정보 |
|---|
| L1 | Claude Code Memory | ~10-20 files | 세션마다 자동 로드됨 (Auto-loaded every session) | 규칙, 주의사항(gotchas), 정체성, 자격 증명 (Rules, gotchas, identity, credentials) |
| L2 | Wiki (Logseq/Obsidian) | ~50-200 pages | /llm-wiki query를 통한 온디맨드 접근 (On-demand via /llm-wiki query) | 프로젝트, 워크플로우, 연구 자료, 심층 지식 (Projects, workflows, research, deep knowledge) |
graph TB
    subgraph "Every Session — Auto-loaded"
        L1[L1: Claude Memory]
...
라우팅 규칙은 간단합니다: 이 지식 없이는 LLM이 실수를 저지르는 것이 위험하거나 창피할 정도인가요? 그렇다면 L1에 포함되어야 합니다. 그 실수가 단지 불편하기만 한가요? 그렇다면 L2에 포함됩니다.
자격 증명(Credentials)은 특별한 경우입니다. 위키는 일반적으로 git 추적 대상이므로, 자격 증명은 반드시 L1에 존재해야 합니다. L1 메모리 디렉토리는 git에서 제외되어 있어, 이곳만이 비밀 정보를 보관할 수 있는 유일하게 안전한 장소입니다.
전체 심층 분석(deep-dive) 내용은 docs/l1-l2-architecture.md를 참고하세요.
명령어 (Commands)
| 명령어 | 설명 |
|---|
/llm-wiki ingest <source> | 소스(URL, 파일, 텍스트)를 처리하여 위키 페이지 5~15개를 업데이트합니다. |
| ... | |
수집 흐름 (Ingest Flow)
수집(Ingest)은 핵심 작업입니다. /llm-wiki ingest "deployed v2.0 to production"을 실행하면 다음과 같은 과정이 진행됩니다:
graph LR
    SRC[Source<br/>URL / File / Text] --> A[Phase 1<br/>분석 및 추출 (Analyze & Extract)]
    A --> B[Phase 2<br/>위키 스캔<br/>영향받는 페이지 찾기]
...
단계 1 -- 분석 및 추출(Analyze & Extract). Claude는 소스를 읽고 개체명(entities), 사실(facts), 관계(relationships), 날짜 등을 추출합니다. 각 정보를 도메인별(비즈니스, 기술, 콘텐츠 등)로 분류하고, L1(빠른 규칙)에 속하는지 또는 L2(심층 지식)에 속하는지를 확인합니다.
단계 2 -- 위키 스캔(Scan Wiki). Claude는 스키마를 읽은 후, 새로운 정보가 어떤 기존 페이지에 영향을 미치는지 찾기 위해 기존 페이지들을 스캔합니다. 만약 이미 개체명 페이지를 가지고 있는 도구에 대해 언급한다면, 해당 페이지도 업데이트해야 한다는 것을 알고 있습니다.
Phase 3 -- 페이지 업데이트(Update Pages). 새 페이지는 스키마에서 요구되는 모든 속성을 가져옵니다. 기존 페이지에는 새로운 사실들이 추가되며; 만약 특정 사실이 명시된 상태(상태, 마감일, 결정 등)를 대체할 경우, 해당 블록은 재작성되고 이전 문구는 접힌 History 섹션으로 이동합니다. 아무것도 삭제되지 않으며, 현재 상태는 최상단에 유지됩니다. 목표: 인제스트당 5~15개 페이지 터치.
Phase 4 -- 품질 게이트(Quality Gate). 커밋하기 전에 다음 사항을 확인합니다: 모든 페이지가 필수 속성을 가지고 있는가? 모든 페이지가 최소한 하나의 교차 참조를 가지고 있는가? 내용에 자격 증명 패턴이 존재하는가?
Phase 5 -- 보고서(Report). 생성된 페이지, 업데이트된 페이지, 추가된 교차 참조 및 발생한 경고 사항의 요약.
쿼리(Query)
쿼리는 메모리에 접근하기 전 CPU가 주소를 해결하는 방식과 같이 2단계로 이루어집니다. 1단계 (라우팅): Claude는 후보 네임스페이스의 허브 ### Index 페이지만 읽습니다. 이 인덱스는 저렴한 라우팅 목록([[페이지]] -- 설명 #태그)이며, 설명에 따라 가장 관련성이 높은 3개 페이지를 선택합니다. 이것이 바로 위키의 페이지 테이블입니다. 2단계 (읽기): 해당 전체 페이지들만 열어 출처 명시(source attribution)와 함께 답변을 합성합니다. 모든 페이지에 대한 전체 텍스트 grep 검색은 라우팅이 아무것도 찾지 못했을 때만 사용되는 **L3 폴백(fallback)**입니다. 각 전체 페이지 읽기는 접근 전용 로그(append-only Access-Log)에 해당 페이지가 선택된 이유(일치하는 인덱스 설명 또는 grep 용어)와 함께 기록됩니다. 따라서 이 로그는 무엇이 로드되었는지뿐만 아니라 왜 로드되었는지도 기록하며, prune 프로세스에 정보를 제공합니다. 쿼리가 공백을 발견하면 새 페이지를 생성할 것을 제안합니다.
Prune
Prune은 위키가 성장함에 따라 라우팅을 정확하게 유지하는 제거(eviction) 계층입니다. 이는 Access-Log를 읽고, 콜드 페이지(cold pages)(N개월 동안 읽히지 않은 페이지, 기본값 6)를 찾아 라이브 인덱스에서 제거합니다. 라우팅 경로는 허브 ### Index에서 ### Archive로 이동하며, 해당 페이지는 archived::로 표시됩니다. 이것은 **삭제가 아닌 강등(demotion)**입니다: 파일은 제자리에 유지되며, 모든 들어오는 [[링크]]는 유효하게 남아 있고, 페이지는 여전히 L3 grep 폴백(fallback)에 의해 발견될 수 있습니다 (다시 조회되면 자동으로 재승격됨). 결정적으로, Prune은 파일을 이름 변경하거나 이동시키지 않습니다. 위키 도구는 페이지 이름으로 링크하기 때문에, 이동은 모든 백링크를 끊게 됩니다. 스케줄에 따라 실행하십시오 (이 명령어는 자체 스케줄링을 하지 않습니다).
--l1은 L1의 대응 기능입니다. 접근 빈도는 오래된(stale) L1 규칙을 찾을 수 없습니다. 모든 L1 파일은 세션마다 로드되기 때문에, 오래된 규칙은 결코 콜드해 보이지 않습니다. 대신 에이전트가 구식 가정에 자신 있게 행동하는 형태로 나타납니다. 따라서 L1 파일은 주장 클래스(claim class)를 가집니다: 시스템의 현재 상태(경로, 플래그, 버전, 특이점 등)에 대한 주장은 asserts-current-behavior: true를 사용하고, 결정을 내리거나 선호도와 같이 절대 오래되지 않는 것은 false를 사용합니다. 행동 주장(Behavior claims)은 verified 날짜를 가집니다. /llm-wiki prune --l1은 분류되지 않은 파일을 분류하고 (시스템이 제안하고 사용자가 확인), 기한이 된 주장들을 읽기 전용 로컬 증거와 비교하며, 사용자에게 재검증하거나 규칙을 L2로 강등하여 기록으로 남기거나 삭제할 수 있게 합니다. 이 기능은 세션 중간에 오래된 규칙이 행동을 정당화하려 할 때 경고하지 않습니다. Claude Code가 L1을 로드하기 때문에 해당 후크(hook)가 없으며, 이는 로드맵에 있습니다.
Lint
린트(Lint)는 자동 건강 검사 기능입니다. 이 기능은 모든 위키 페이지를 스캔하여 13가지 규칙을 확인합니다: 고아 페이지(orphan pages, 들어오는 링크가 없음), 오래된 콘텐츠(stale content, 마지막 업데이트가 90일 이상 지났으나 여전히 높은 신뢰도로 표시됨), 필수 속성 누락, 깨진 참조(broken references), 허브 완전성(hub completeness), 인덱스 표류(index drift) (라우팅 라인이 없는 활성 페이지 또는 페이지가 없는 라우팅 라인), 라이브 인덱스 내 아카이브된 콘텐츠(archived-in-live-index) (등급이 낮아진 페이지임에도 여전히 라우팅되는 경우), 빈 페이지, 약한 교차 참조(weak cross-referencing), 자격 증명 패턴(credential patterns), L1/L2 중복, 만료 예정인 L1 주장(due L1 claims) (검증 날짜가 누락되었거나 l1_verify_days보다 오래된 행동 주장의 경우), 그리고 블록 비대화(block bloat) (산문이 600자를 초과하여 커지거나 변경 로그로 사용된 updated:: 값의 경우). --fix 플래그와 함께 실행하면 Claude가 가능한 범위 내에서 자동 복구하며, 여기에는 누락된 라우팅 라인을 허브 인덱스에 백필(backfilling)하는 것도 포함됩니다.
스키마 (The Schema)
스키마는 사용자님과 LLM 간의 계약입니다. 스키마가 없으면 LLM은 일관성 없는 페이지를 생성합니다. 어떤 것은 status: active를 사용하고, 다른 것은 state:: running을 사용하며, 또 다른 것은 상태 필드 자체가 아예 없을 수 있습니다. 스키마가 있으면 모든 페이지가 동일한 구조를 따르게 되며, 자동화된 품질 검사가 가능해집니다.
스키마는 다음을 정의합니다:
- 8개 네임스페이스 (Business, Tech, Content, Projects, People, Learning, Reference, Careers)
- 필수 속성을 가진 5가지 페이지 유형 (Entity, Project, Knowledge, Feedback, Hub)
- 자동 건강 검사를 위한 린트 규칙(Lint rules)
- 시스템이 새로운 지식을 어디로 라우팅해야 하는지 알 수 있도록 하는 L1/L2 경계(boundary)
전체 스키마 참조는 docs/schema-reference.md를 참고하세요.
Logseq 대 Obsidian
두 위키 앱 모두 지원됩니다. 선호도에 따라 선택하시면 됩니다:
| Logseq | Obsidian |
|---|
| 속성(Properties) | property:: value (인라인) | YAML 프론트매터 |
| ... | | |
| Logseq는 LLM이 글을 작성할 때 특히 빛을 발합니다. 아웃라이너 형식 덕분에 모든 블록이 독립적으로 주소 지정 가능하므로, 새로운 콘텐츠를 추가해도 기존 구조가 방해받지 않습니다. | | |