<div align="center">
<img src="https://raw.githubusercontent.com/LazyAGI/LazyLLM/main/docs/assets/LazyLLM-logo.png" width="100%"/>
</div>
LazyLLM: 다중 에이전트(Multi-agent) LLM 애플리케이션 구축을 위한 로우코드 개발 도구.
中文 | EN
CI
License
GitHub star chart
LazyLLM이란 무엇인가?
LazyLLM은 다중 에이전트(multi-agent) 대규모 언어 모델(LLM) 애플리케이션을 구축하기 위한 로우코드 개발 도구입니다. 이 도구는 개발자가 매우 낮은 비용으로 복잡한 AI 애플리케이션을 만들 수 있도록 돕고, 지속적인 반복 최적화가 가능하게 합니다. LazyLLM은 편리한 애플리케이션 빌드 워크플로우를 제공하며, 애플리케이션 개발 과정의 다양한 단계에 필요한 수많은 표준 프로세스와 도구를 제공합니다.<br>
LazyLLM 기반의 AI 애플리케이션 개발 과정은 프로토타입 구축 -> 데이터 피드백 -> 반복적 최적화 순서를 따릅니다. 이는 LazyLLM을 사용하여 프로토타입 애플리케이션을 빠르게 구축한 다음, 작업별 데이터(task-specific data)를 이용해 문제 사례(bad cases)를 분석하고, 이후 애플리케이션의 중요 단계에서 알고리즘을 반복하거나 모델을 미세 조정하여 전체적인 애플리케이션 성능을 점진적으로 개선할 수 있음을 의미합니다.<br>
LazyLLM은 민첩성(agility)과 효율성(efficiency)의 통합에 중점을 둡니다. 개발자는 알고리즘을 효율적으로 반복하고, 그 결과를 산업 생산에 적용하여 다중 사용자 지원, 내결함성(fault tolerance), 높은 동시성을 지원할 수 있습니다.
사용자 문서 (User Documentation): https://docs.lazyllm.ai/ <br>
아래 QR 코드를 WeChat으로 스캔하여 그룹 채팅방에 참여하거나(왼쪽) 비디오를 시청하여 더 많은 정보를 얻으세요(오른쪽)<br>
<p align="center">
<img src="https://github.com/user-attachments/assets/8ad8fd14-b218-48b3-80a4-7334b2a32c5a" width=250/>
<img src="https://github.com/user-attachments/assets/7a042a97-1339-459e-a451-4bcd6cf64c12" width=250/>
</p>
주요 기능 (Features)
편리한 AI 애플리케이션 조립 과정: 대규모 모델에 익숙하지 않아도, 내장된 데이터 흐름(data flow) 및 기능 모듈을 사용하여 레고 블록 맞추기처럼 여러 에이전트를 사용하는 AI 애플리케이션을 쉽게 조립할 수 있습니다.
복잡한 애플리케이션의 원클릭 배포: 단일 클릭으로 모든 모듈을 배포하는 기능을 제공합니다. 특히 POC(Proof of Concept) 단계에서 LazyLLM은 경량 게이트웨이 메커니즘을 통해 다중 에이전트 애플리케이션의 배포 과정을 간소화하여, 각 서브모듈 서비스(예: LLM, 임베딩(Embedding) 등)를 순차적으로 시작하고 URL을 구성해야 하는 문제를 해결함으로써 전체 프로세스를 더욱 원활하고 효율적으로 만듭니다. 애플리케이션 출시 단계에서는 LazyLLM이 단일 클릭으로 이미지를 패키징할 수 있는 기능을 제공하여 Kubernetes의 게이트웨이, 로드 밸런싱(load balancing), 장애 허용성(fault tolerance) 기능 활용을 용이하게 합니다.
크로스 플랫폼 호환성: 코드를 수정하지 않고 단일 클릭으로 다양한 IaaS 플랫폼을 전환할 수 있으며, 베어메탈 서버(bare-metal servers), 개발 머신, Slurm 클러스터, 퍼블릭 클라우드 등과 호환됩니다. 이를 통해 개발된 애플리케이션을 다른 IaaS 플랫폼으로 원활하게 마이그레이션 할 수 있어 코드 수정 작업량을 크게 줄여줍니다.
다양한 기술 선택에 대한 통합 사용자 경험: 다양한 서비스 제공업체의 온라인 모델과 로컬에 배포된 모델 모두에 대해 통합 사용자 경험을 제공하여, 개발자가 실험을 위해 모델을 자유롭게 전환하고 업그레이드할 수 있도록 합니다. 또한 주류 추론 프레임워크(inference frameworks), 파인튜닝 프레임워크, 관계형 데이터베이스(relational databases), 벡터 데이터베이스(vector databases), 문서 데이터베이스(document databases)에 대한 사용자 경험도 통합합니다.
효율적인 모델 미세 조정(Efficient Model Fine-Tuning): 애플리케이션 내에서 모델 미세 조정을 지원하여 애플리케이션 성능을 지속적으로 개선할 수 있습니다. 미세 조정 시나리오를 기반으로 최적의 미세 조정 프레임워크와 모델 분할 전략을 자동으로 선택합니다. 이는 모델 반복(iteration) 관리를 단순화할 뿐만 아니라, 알고리즘 연구원들이 지루한 엔지니어링 작업 처리 없이 알고리즘 및 데이터 반복에 더 집중할 수 있도록 합니다.<br><br>## LazyLLM으로 무엇을 만들 수 있나요<br><br>LazyLLM은 일반적인 인공지능 애플리케이션을 구축하는 데 사용될 수 있습니다. 몇 가지 예시를 소개합니다.<br><br>### 3.1 챗봇(ChatBots)<br><br>이것은 간단한 챗봇의 예시입니다.<br><br>```python
환경 변수 설정: LAZYLLM_OPENAI_API_KEY=xx
또는 config 파일(~/.lazyllm/config.json)을 만들고 openai_api_key=xx를 추가할 수 있습니다
import lazyllm
...
<br><br>로컬에 배포된 모델을 사용하려면, 최소한 하나의 추론 프레임워크(lightllm 또는 vllm)가 설치되어 있는지 확인하고 다음 코드를 사용하십시오.<br><br>python
import lazyllm
인터넷 연결이 되어 있으면 모델이 자동으로 다운로드됩니다.
chat = lazyllm.TrainableModule('internlm2-chat-7b')
...
<br><br>`lazyllm`을 `pip`으로 설치하고 Python 환경의 `bin` 디렉터리가 `$PATH`에 포함되어 있는지 확인했다면, `lazyllm run chatbot`을 실행하여 빠르게 챗봇을 시작할 수 있습니다. 로컬 모델을 사용하려면 `--model` 매개변수를 사용하여 모델 이름을 지정해야 합니다. 예를 들어, `lazyllm run chatbot --model=internlm2-chat-7b`를 사용하여 로컬 모델 기반의 챗봇을 시작할 수 있습니다.<br><br>**다중 모달리티(multimodality) 및 의도 인식(intent recognition) 기능이 포함된 고급 봇 예시입니다.**<br><br><br><details><summary>프롬프트 및 임포트 확인 클릭</summary><br>python
from lazyllm import TrainableModule, WebModule, deploy, pipeline
from lazyllm.tools import IntentClassifier
...
</details><br>python
base = TrainableModule('internlm2-chat-7b')
with IntentClassifier(base) as ic:
ic.case['Chat', base]
...
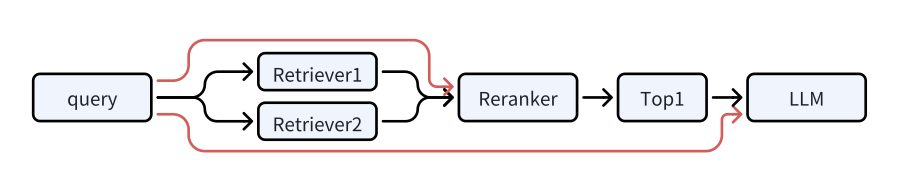
### 3.2 검색 증강 생성 (Retrieval-Augmented Generation)
<details>
<summary>임포트 및 프롬프트 보기</summary>
```python
import os
import lazyllm
...
</details>
이것은 온라인 배포 예시입니다:
documents = Document(dataset_path="your data path", embed=lazyllm.OnlineEmbeddingModule(), manager=False)
documents.create_node_group(name="sentences", transform=SentenceSplitter, chunk_size=1024, chunk_overlap=100)
with pipeline() as ppl:
...
로컬 배포의 예시는 다음과 같습니다:
documents = Document(dataset_path='/file/to/yourpath', embed=lazyllm.TrainableModule('bge-large-zh-v1.5'))
documents.create_node_group(name="sentences", transform=SentenceSplitter, chunk_size=1024, chunk_overlap=100)

...
만약 lazyllm을 pip으로 설치하고 Python 환경의 bin 디렉터리가 $PATH에 포함되도록 했다면, lazyllm run rag --documents=/file/to/yourpath를 실행하여 검색 증강 봇(retrieval-augmented bot)을 빠르게 시작할 수 있습니다. 로컬 모델을 사용하려면 --model 매개변수에 모델 이름을 지정해야 합니다. 예를 들어, lazyllm run rag --documents=/file/to/yourpath --model=internlm2-chat-7b를 사용하여 로컬 모델 기반의 검색 증강 봇을 시작할 수 있습니다.
3.3 추가 예시
더 많은 예시는 공식 문서 사용 사례(Usage Examples)를 참조하십시오.
LazyLLM으로 무엇을 할 수 있나요?
- 애플리케이션 구축 (Application Building): 파이프라인(pipeline), 병렬(parallel), 분기(diverter), if, switch, loop와 같은 워크플로우를 정의합니다. 개발자는 모든 함수 및 모듈을 기반으로 다중 에이전트 AI 애플리케이션을 빠르게 구축할 수 있습니다. 조립된 다중 에이전트 애플리케이션에 대한 원클릭 배포(one-click deployment)를 지원하며, 부분적 또는 전체 업데이트도 지원합니다.
- 플랫폼 독립성 (Platform-independent): 다양한 컴퓨팅 플랫폼에서 일관된 사용자 경험을 제공합니다. 현재 bare metal, Slurm, SenseCore 등 여러 플랫폼과 호환됩니다.
- 대규모 모델의 파인튜닝 및 추론 지원:
- 오프라인(로컬) 모델 서비스:
- 파인튜닝 프레임워크 지원: collie, peft
- 추론 프레임워크 지원: lightllm, vllm
- 사용자 시나리오에 따라 가장 적합한 프레임워크 및 모델 매개변수(예: micro-bs, tp, zero 등)를 자동으로 선택하는 기능 지원.
- 온라인 서비스:
- 파인튜닝 서비스 지원: GPT, SenseNova, Tongyi Qianwen
- 추론 서비스 지원: GPT, SenseNova, Kimi, Zhipu, Tongyi Qianwen
- 임베딩 추론 서비스 지원: OpenAI, SenseNova, GLM, Tongyi Qianwen
- 개발자가 로컬 서비스와 온라인 서비스를 균일하게 사용할 수 있도록 지원합니다.
- 공통 RAG (검색 증강 생성) 컴포넌트 지원: 문서(Document), 파서(Parser), 리트리버(Retriever), 리랭커(Reranker) 등 공통 RAG 구성 요소를 지원합니다.
- 기본 웹 인터페이스 지원: 채팅 인터페이스나 문서 관리 인터페이스와 같은 기본적인 웹을 지원합니다.
설치 (Installation)
pip 설치 (권장)
lazyllm과 필요한 의존성만 설치하려면 다음 명령어를 사용할 수 있습니다:
lazyllm과 모든 의존성을 설치하려면 다음 명령어를 사용할 수 있습니다:
pip3 install lazyllm
lazyllm install full
소스에서 설치 (Installation from source)
git clone [email protected]:LazyAGI/LazyLLM.git
cd LazyLLM
pip install -r requirements.txt
Windows 또는 macOS에 설치하기
Windows 또는 macOS에서 설치하려면 튜토리얼을 참조하십시오.
디자인 철학
LazyLLM의 디자인 철학은 프로덕션 환경에서 대규모 모델(large models)이 가지는 현재의 한계에 대한 깊은 이해에서 비롯되었습니다. 저희는 현 단계에서 대규모 모델이 모든 실제 문제를 엔드투엔드(end-to-end)로 완벽하게 해결할 수는 없다는 것을 인식합니다. 따라서 LazyLLM 기반 AI 애플리케이션 개발 과정은 “신속한 프로토타이핑, 시나리오별 데이터를 사용한 엣지 케이스 분석, 알고리즘 실험, 그리고 전반적인 애플리케이션 성능 향상을 위한 핵심 측면의 모델 미세 조정(model fine-tuning)”을 강조합니다. LazyLLM은 이 과정에 수반되는 번거로운 엔지니어링 작업을 처리하며, 사용자가 알고리즘적 효과를 높이고 뛰어난 AI 애플리케이션을 만드는 데 집중할 수 있도록 편리한 인터페이스를 제공합니다.<br>
LazyLLM의 목표는 알고리즘 연구원과 개발자들을 복잡한 엔지니어링 구현으로부터 해방시켜, 그들이 가장 잘하는 것, 즉 알고리즘과 데이터, 그리고 실제 문제 해결에만 집중할 수 있도록 하는 것입니다. 초보자이든 숙련된 전문가이든, LazyLLM이 도움을 드릴 수 있기를 바랍니다. 초보 개발자의 경우, LazyLLM은 AI 애플리케이션 개발 과정을 철저하게 단순화합니다. 더 이상 다양한 IaaS 플랫폼에서 작업을 스케줄링하는 방법, API 서비스 구축의 세부 사항 이해, 미세 조정 시 프레임워크 선택 또는 모델 분할, 혹은 웹 개발 지식 습득에 대해 걱정할 필요가 없습니다. 사전 구축된 컴포넌트와 간단한 통합 작업만으로 초보 개발자도 프로덕션 가치를 지닌 도구를 쉽게 만들 수 있습니다. 반면 숙련된 전문가에게는 LazyLLM이 높은 수준의 유연성을 제공합니다. 각 모듈은 사용자 정의 및 확장을 지원하여, 사용자가 자신만의 알고리즘과 최첨단(state-of-the-art) 프로덕션 도구를 원활하게 통합하여 더욱 강력한 애플리케이션을 구축할 수 있도록 합니다.
의존적인 보조 도구(auxiliary tools)의 구현 세부 사항에 매몰되는 것을 방지하기 위해, LazyLLM은 유사한 모듈 전반에 걸쳐 일관된 사용자 경험을 제공하도록 노력합니다. 예를 들어, 우리는 온라인 모델(예: ChatGPT, SenseNova, Kimi, ChatGLM 등)과 로컬 모델 모두에 균일한 사용 방법을 제공하는 일련의 프롬프트 규칙(Prompt rules)을 수립했습니다. 이러한 일관성은 애플리케이션에서 로컬 모델과 온라인 모델 간을 쉽고 유연하게 전환할 수 있도록 해줍니다.


