2023년에 우리는 ChatGPT에 이어 생성형 AI(Generative AI)에 대한 폭발적인 관심을 목격했습니다. 스타트업부터 대기업까지 모든 회사들이 (여전히) 자신들의 GenAI 전략을 수립하려고 노력하고 있습니다.
"우리 제품에 어떻게 GenAI를 통합할 수 있을까요? 어떤 레퍼런스 아키텍처를 따라야 할까요? 우리 사용 사례에 가장 적합한 모델은 무엇일까요? 어떤 기술 스택을 사용해야 할까요? 우리의 LLM 애플리케이션을 어떻게 테스트할 수 있을까요?"
이것들은 회사들이 스스로에게 던지는 질문들입니다. 이러한 불확실성의 시기에 모두가 다른 사람들이 무엇을 하고 있는지 알고 싶어 합니다. 지금까지 이 문제를 밝히려는 몇 가지 시도가 있었지만, 생태계 내에서 LangChain이 가진 독특한 위치 덕분에 저희는 팀들이 LLM으로 실제로 어떻게 구축하고 있는지에 대해 실질적인 빛을 비출 수 있다고 생각합니다.
이를 위해 저희는 LangSmith의 익명화된 메타데이터를 활용했습니다. LangSmith는 프로토타입에서 프로덕션으로 쉽게 전환할 수 있도록 설계된 저희의 클라우드 플랫폼입니다. 이 플랫폼은 트레이싱(tracing), 회귀 테스트(regression testing), 평가(evaluation) 등의 기능을 제공합니다. 아직 비공개 베타 단계에 있지만, 매일 대기 목록에 있는 사람들에게 기회를 주고 있으니 여기에서 가입해 주시고, 엔터프라이즈 액세스나 지원에 관심이 있다면 연락 주시기 바랍니다.
이를 통해 우리는 사람들이 무엇을 구축하고 있는지, 그것들을 어떻게 구축하는지, 그리고 그 애플리케이션들을 어떻게 테스트하는지에 대한 질문에 답할 수 있습니다. 모든 통계는 2023년 7월 2일부터 2023년 12월 11일까지의 데이터를 기반으로 합니다.
사람들이 무엇을 만들고 있는가?
여기서는 사람들이 흔히 구축하는 몇 가지 사례를 살펴보겠습니다.
LangSmith는 LangChain과 원활하게 통합되지만, LangChain 생태계 외부에서도 쉽게 사용할 수 있습니다. 저희는 LangSmith 사용량 중 약 15%가 LangChain을 사용하지 않는 사용자들로부터 나온다는 것을 확인했습니다. 저희는 위에서 언급된 모든 구성 요소에 대한 온보딩 경험이 사용자가 LangChain을 사용하든 아니든 동일하게 잘 작동하도록 많은 노력을 기울였습니다.
검색(Retrieval)은 데이터와 LLM을 결합하는 지배적인 방식으로 부상했습니다. LangChain은 60개 이상의 벡터스토어(비정형 데이터를 인덱싱하는 가장 일반적인 방법)와의 통합 기능을 제공합니다. 또한 LangChain은 다양한 고급 검색 전략을 제공합니다. 복잡한 질의 중 42%가 검색과 관련되어 있다는 것을 확인했는데, 이는 검색의 중요성과 LangChain이 이를 얼마나 쉽게 만들었는지를 동시에 보여줍니다.
마지막으로, 복잡한 질의 중 약 17%가 에이전트(agent)의 일부라는 것을 확인했습니다. 에이전트는 LLM이 어떤 단계를 밟을지 결정하도록 하는 것으로, 시스템이 복잡한 질의나 예외 사례를 더 잘 처리할 수 있게 합니다. 하지만 여전히 매우 신뢰성이 높거나 성능이 뛰어나지는 않기 때문에, 아마도 우리가 더 많이 보지 못하는 이유일 것입니다.
LCEL 사용법 (LCEL Usage)
지난 몇 달 동안 LangChain에 추가된 큰 기능 중 하나는 LangChain Expression Language (줄여서 LCEL)입니다. 이것은 구성 요소를 쉽게 조합할 수 있는 방법으로, 복잡하고 맞춤화된 체인(chain)을 만드는 데 완벽합니다. 이 전체 생성형 AI(GenAI) 여정의 초기 단계이며, 모두가 LLM을 자신들에게 어떻게 작동하게 할지 알아내려고 노력하고 있습니다. 여기에는 많은 실험과 사용자 정의 작업이 수반됩니다. LCEL은 이를 쉽게 만들며—저희가 더 많은 기능을 추가하고 문서를 개선함에 따라 지난 몇 달 동안 그 사용량이 급격히 증가하는 것을 확인했습니다.
가장 많이 사용된 LLM 제공업체 (Most Used LLM Providers)
이 모든 것의 새로운 기술은 LLM입니다. 그렇다면 사람들이 어떤 LLM 제공업체를 사용하고 있을까요?
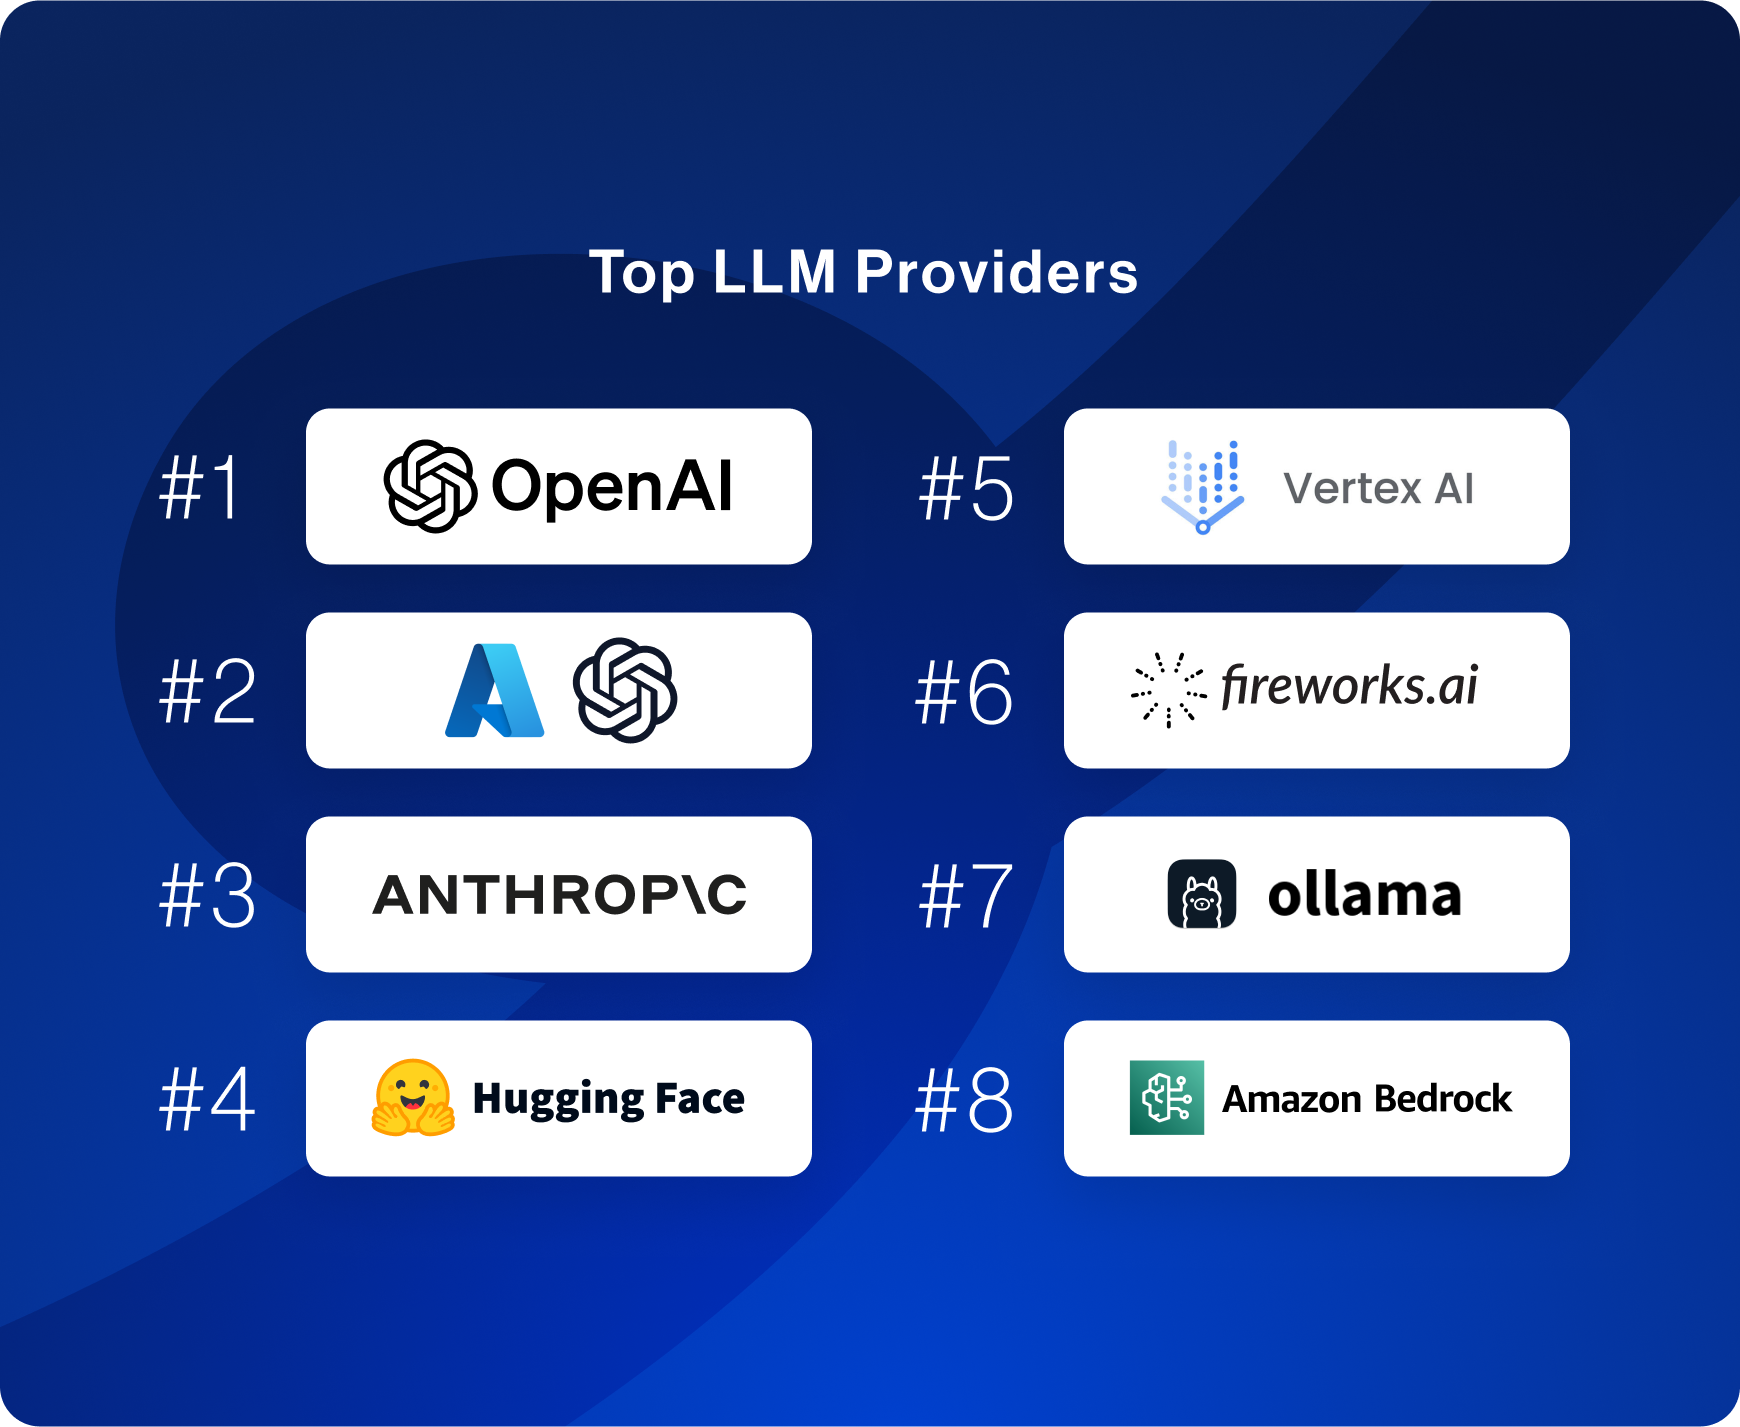
놀랍지 않게도, OpenAI가 선두에 있으며 그 뒤를 AzureOpenAI가 바짝 쫓고 있습니다. OpenAI는 2023년 최고의 LLM 제공업체로 부상했으며, Azure(더 많은 엔터프라이즈 보증을 갖춘)가 그 모멘텀을 잘 이어받았습니다.
독점 모델을 제공하는 다른 호스팅 서비스로는 Anthropic (3위), Vertex AI (4위), Amazon Bedrock (8위) 등이 있습니다.
오픈 소스 모델 측면에서는 Hugging Face (4위), Fireworks AI (6위), Ollama (7위)가 사용자들이 해당 모델과 상호 작용하는 주요 방식임을 알 수 있습니다.
참고로, 이 순위는 특정 제공업체를 사용한 사용자 수를 기반으로 합니다.
가장 많이 사용된 OSS 모델 제공업체 (Most Used OSS Model Providers)
최근에는 오픈 소스 모델(open source models)에 많은 관심이 쏠리고 있으며, 더 많은 제공업체들이 점점 더 저렴한 비용으로 이를 호스팅하기 위해 경쟁하고 있습니다. 그렇다면 개발자들은 이러한 오픈 소스 모델에 정확히 어떻게 접근하고 있을까요?
사람들은 주로 로컬 환경에서 실행하는 것으로 나타났으며, Hugging Face, LlamaCpp, Ollama, GPT4All과 같은 옵션들이 높은 순위를 차지했습니다.
OSS 모델에 API 액세스를 제공하는 제공업체 중에서는 Fireworks AI가 선두를 달리고 있으며, 그 뒤를 Replicate, Together, Anyscale이 잇고 있습니다.
참고로 이 순위는 특정 제공업체를 사용한 사용자 수에 기반합니다.
가장 많이 사용된 Vectorstore
이전에 언급했듯이, 검색(retrieval)은 LLM 애플리케이션의 거대한 부분을 차지합니다. Vectorstores는 관련 컨텍스트를 검색하는 주요 방법으로 부상하고 있습니다. LangChain에는 60개 이상의 vectorstore 통합 기능이 있는데, 사람들이 가장 많이 사용하는 것은 무엇일까요?
로컬 vectorstore가 가장 많이 사용되는 것으로 나타났으며, Chroma, FAISS, Qdrant, DocArray가 모두 상위 5위에 올랐습니다. 이 순위는 특정 vectorstore를 사용한 사용자 수에 기반하므로, 이런 방식으로 계산한다면 로컬의 무료 vectorstore가 가장 많이 사용되는 것이 당연합니다.
호스팅된 서비스 중에서는 Pinecone이 상위 5위권에서 유일하게 호스팅된 vectorstore로서 선두를 달리고 있습니다. Weaviate가 그 뒤를 이어, 현재 벡터 네이티브(vector-native) 데이터베이스가 벡터 기능을 추가하는 데이터베이스보다 더 많이 사용되고 있음을 보여줍니다.
벡터 기능을 추가한 데이터베이스 중에서는 Postgres (PGVector), Supabase, Neo4j, Redis, Azure Search, Astra DB가 선두를 차지하고 있습니다.
참고로 이 순위는 특정 제공업체를 사용한 사용자 수에 기반합니다.
가장 많이 사용된 임베딩(Embeddings)
vectorstore를 사용하려면 텍스트 조각에 대한 임베딩을 계산해야 합니다. 그렇다면 개발자들은 이것을 어떻게 하고 있을까요?
LLM과 유사하게 OpenAI가 여전히 지배적이지만, 그 이후로는 더 많은 다양성을 목격할 수 있습니다. 오픈 소스 제공업체들이 더 많이 사용되고 있으며, Hugging Face가 2위로 가장 많이 사용되었고, GPT4All과 Ollama 역시 상위 8개에 포함되었습니다. 호스팅된 측면에서는 Vertex AI가 AzureOpenAI를 능가하며, Cohere와 Amazon Bedrock도 뒤처지지 않고 있습니다.
최고 수준의 검색 전략 (Top Advanced Retrieval Strategies)
단순히 임베딩(embeddings) 간 코사인 유사도(cosine similarity)만 계산하는 것만으로는 검색(retrieval)에서 한계가 있습니다. 많은 사람들이 고급 검색 전략에 의존하고 있으며, 이 중 상당수는 저희가 LangChain에 구현하고 문서화한 내용입니다.
그럼에도 불구하고, 우리가 보는 가장 일반적인 검색 전략은 내장된 것이 아니라 커스텀(custom) 전략인 경우가 많습니다. 이는 다음을 시사합니다:
- LangChain에서 커스텀 검색 전략을 구현하기 쉽다는 점
- 최고의 성능을 달성하려면 커스텀 로직을 구현해야 할 필요성
그 외에도 더 익숙한 이름들이 등장합니다:
- Self Query: 사용자 질문에서 메타데이터 필터(metadata filters)를 추출하는 기능
- Hybrid Search: 주로 Supabase나 Pinecone과 같은 제공업체별 통합을 통해 이루어지는 검색 방식
- Contextual Compression: 기본 검색 결과에 대한 후처리(postprocessing)
- Multi Query: 단일 쿼리를 여러 개로 변환한 다음, 모든 쿼리에 대해 결과를 검색하는 방식
- TimeWeighted VectorStore: 최근 문서에 더 높은 가중치를 부여하는 저장소
사람들은 어떻게 테스트하고 있나요?
평가(Evaluation) 및 테스트는 개발자들이 LLM 애플리케이션을 구축할 때 직면하는 가장 큰 문제점 중 하나로 부상했으며, LangSmith는 이를 수행하는 최고의 방법 중 하나로 자리매김했습니다.
대부분의 사용자가 자신들의 LLM 앱을 평가하기 위한 몇 가지 지표(metrics)를 수립할 수 있다는 것을 알게 되었습니다. 테스트 실행의 83%에 어떤 형태의 피드백이 관련되어 있습니다. 피드백이 있는 실행 건수 중 평균적으로는 2.3가지의 다른 유형의 피드백을 사용하고 있는데, 이는 개발자들이 전적으로 의존할 단일 지표를 찾기 어렵고, 대신 여러 가지 다른 지표를 사용하여 평가하고 있음을 시사합니다.
로그된 피드백을 보면, 대다수의 사용자가 출력을 평가하기 위해 LLM(Large Language Model)을 사용합니다. 일부에서는 이에 대해 우려와 주저함을 표했지만, 우리는 이 접근 방식에 매우 긍정적이며 실제로 이것이 가장 지배적인 테스트 방식으로 자리 잡았다고 보고 있습니다. 또 다른 주목할 만한 데이터 포인트는 평가자 중 거의 40%가 커스텀 평가자(custom evaluators)라는 점입니다. 이는 우리가 관찰했듯이, 평가가 작업하는 애플리케이션에 매우 특화되어 있어 모든 상황에 적용되는 범용적인 평가 도구가 없다는 사실과 일치합니다.
사람들은 무엇을 테스트하고 있는가?
대부분의 사람들이 여전히 주로 애플리케이션의 정확성(toxicity, prompt leakage 또는 기타 가드레일 등과는 대조적으로)에 관심을 기울이고 있음을 알 수 있습니다. 또한 평가 기법으로서 '정확히 일치하는 매칭(Exact Matching)' 사용률이 낮다는 점에서, 정확성을 판단하는 것이 종종 매우 복잡하다는 것을 알 수 있습니다(출력을 있는 그대로 비교할 수는 없습니다!).
결론
LLM 앱 개발의 첫 실질적인 해가 막을 내리면서, 많은 팀들로부터 프로토타입에서 프로덕션으로 격차를 좁히고 싶다는 이야기를 듣게 되었습니다. 이러한 사용 통계를 공유하는 것이 사람들이 무엇을 만들고 있는지, 그것들을 어떻게 만들고 있는지, 그리고 그것들을 어떻게 테스트하고 있는지에 대해 약간의 빛을 비추는 데 도움이 되기를 바랍니다.
LangSmith가 팀들이 LangChain을 사용하든 안 하든 관계없이 애플리케이션을 프로토타입에서 프로덕션으로 가져오는 지배적인 방식으로 부상하고 있습니다. 엔터프라이즈 액세스나 지원에 관심이 있으시면, 여기로 문의하거나 가입해 주십시오.