
LangChain과 NVIDIA가 발표하는 NemoClaw 딥 에이전트 청사진
요약
NVIDIA와 LangChain이 NemoClaw Deep Agents 청사진을 발표하며, 엔터프라이즈 환경에 적합한 개방형 에이전트 시스템 구축 방안을 제시했습니다. 이 청사진은 Nemotron 3 Ultra 모델, LangChain Deep Agents Code, NVIDIA OpenShell 런타임을 통합하여 안전하고 제어 가능한 에이전트 배포 경로를 제공합니다.
핵심 포인트
- Nemotron 3 Ultra와 LangChain Deep Agents의 결합으로 높은 성능과 낮은 추론 비용을 달성했습니다.
- 에이전트 시스템 전체(모델, 하네스, 평가, 런타임)를 조정하여 최적화하는 것이 중요합니다.
- NVIDIA OpenShell은 정책 기반의 격리된 에이전트 실행 환경을 제공하여 거버넌스를 강화합니다.
- 개방형 스택을 통해 기업이 자체 도메인 지식을 반영한 독점적인 IP를 구축하고 통제할 수 있습니다.
프로덕션 환경의 에이전트를 구축할 때, 모델 선택은 에이전트 성능을 향상시키는 여러 요소 중 하나일 뿐입니다. 팀들은 또한 에이전트가 사용할 수 있는 도구, 에이전트가 볼 수 있는 컨텍스트, 평가 방법, 실행 위치, 그리고 각 액션에 적용되는 정책 등 모델 주변의 시스템 전체를 제어해야 합니다.
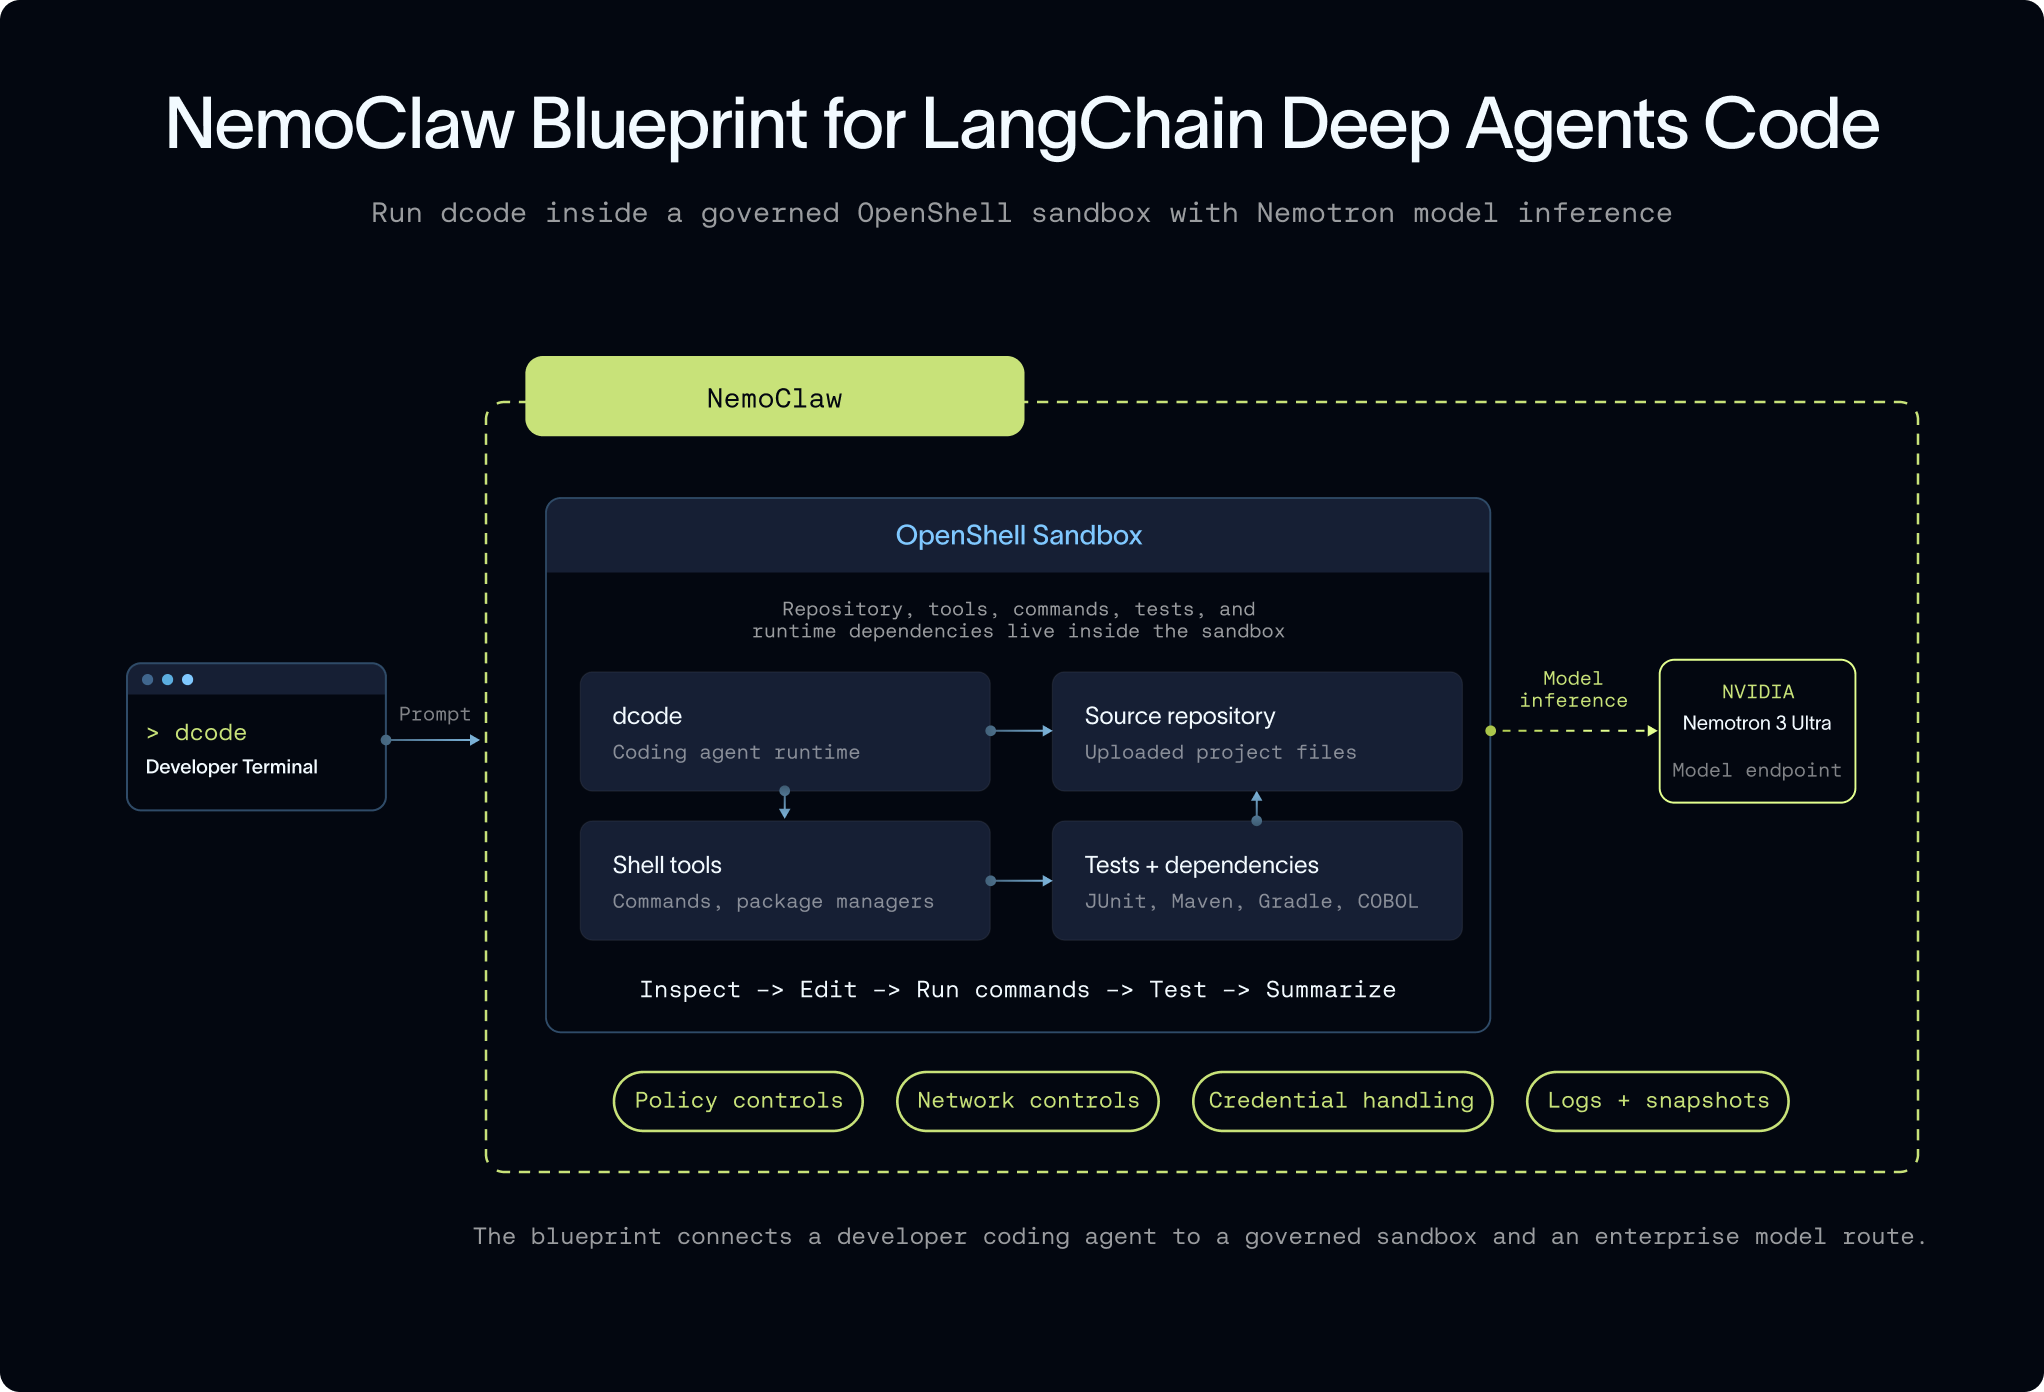
오늘 저희는 엔터프라이즈가 개방적이고 거버넌스(governed)가 적용된 에이전트 시스템을 구축할 수 있도록 NVIDIA와 함께 개발한 NemoClaw for LangChain Deep Agents 청사진을 발표합니다. 이 청사진은 LangChain Deep Agents Code, NVIDIA Nemotron 3 Ultra, 그리고 NVIDIA OpenShell 런타임을 통합하여 팀들이 자체 워크로드에 맞춰 에이전트를 조정하고(tune), 안전하게 실행하며, 품질, 비용, 속도 측면에서 최적화할 수 있도록 합니다.
저희의 평가(evals) 결과에 따르면, 튜닝된 LangChain Deep Agents를 활용한 Nemotron 3 Ultra는 훨씬 낮은 추론 비용으로 고급 에이전트 성능을 제공합니다. 핵심 시사점은 모델, 하네스(harness), 평가(evals), 그리고 런타임이 함께 조정될 때 에이전트 성능이 향상된다는 것입니다.
엔터프라이즈 워크로드를 위한 개방형 에이전트 스택
엔터프라이즈가 에이전트를 프로덕션 환경으로 가져가면서, 모델 주변에 구축하는 시스템 자체가 가치 있는 지적 재산(IP)이 됩니다. 에이전트 메모리, 워크플로우, 추적 기록(traces), 평가 데이터셋, 하네스 구성, 그리고 튜닝 데이터는 모두 회사의 고유한 도메인 전문성을 반영합니다. 이것은 회사가 경쟁하는 방식을 형성할 수 있는 독점적인 지식이지만, 폐쇄형 생태계에서는 팀들이 이를 완전히 통제하지 못합니다. 그들은 이 작업을 소유하고(own), 시간이 지남에 따라 개선하며, 조직이 요구하는 제어 장치로 에이전트를 실행할 방법을 필요로 합니다.
NemoClaw for Deep Agents 청사진은 팀들에게 전체 에이전트 스택에 대한 통제권을 제공합니다.
오픈 모델 레이어. Nemotron 3 Ultra는 팀들에게 실행하고, 맞춤 설정하며, 엔터프라이즈 워크로드를 위해 최적화할 수 있는 오픈 모델을 제공합니다.튜닝된 에이전트 하네스. LangChain Deep Agents Code (dcode)는 계획(planning), 도구 사용(tool use), 메모리, 작업 실행 등을 포함하는 장기 실행 에이전트를 위한 하네스 레이어를 제공합니다. 이 청사진에는 Nemotron 3 Ultra에 맞춰 튜닝된 Deep Agents 하네스 프로파일이 포함됩니다.거버넌스가 적용된 런타임. NVIDIA OpenShell은 도구, 시스템 및 데이터와 에이전트가 상호 작용하는 방식에 대한 정책을 갖춘 격리(sandboxed) 에이전트 실행을 위한 안전한 런타임을 제공합니다. 이 레이어들이 결합되어 팀들이 측정하고, 거버넌스를 적용하며, 프로덕션 환경에서 개선할 수 있는 에이전트를 구축하고 배포하는 경로를 제공합니다.
비용을 10배 절감하면서 벤치마크 최고 성능 달성하기
LangChain의 에이전트 평가(agent eval) 스위트에서, LangChain Deep Agents로 평가된 NVIDIA Nemotron 3 Ultra는 $4.48의 비용으로 0.86의 종합 점수를 달성했습니다. 그다음 근접한 성능을 보이는 모델은 $43.48의 비용이 들었으며, 이는 Nemotron 3 Ultra가 이 벤치마크에서 약 10배 낮은 추론(inference) 비용임을 의미합니다.
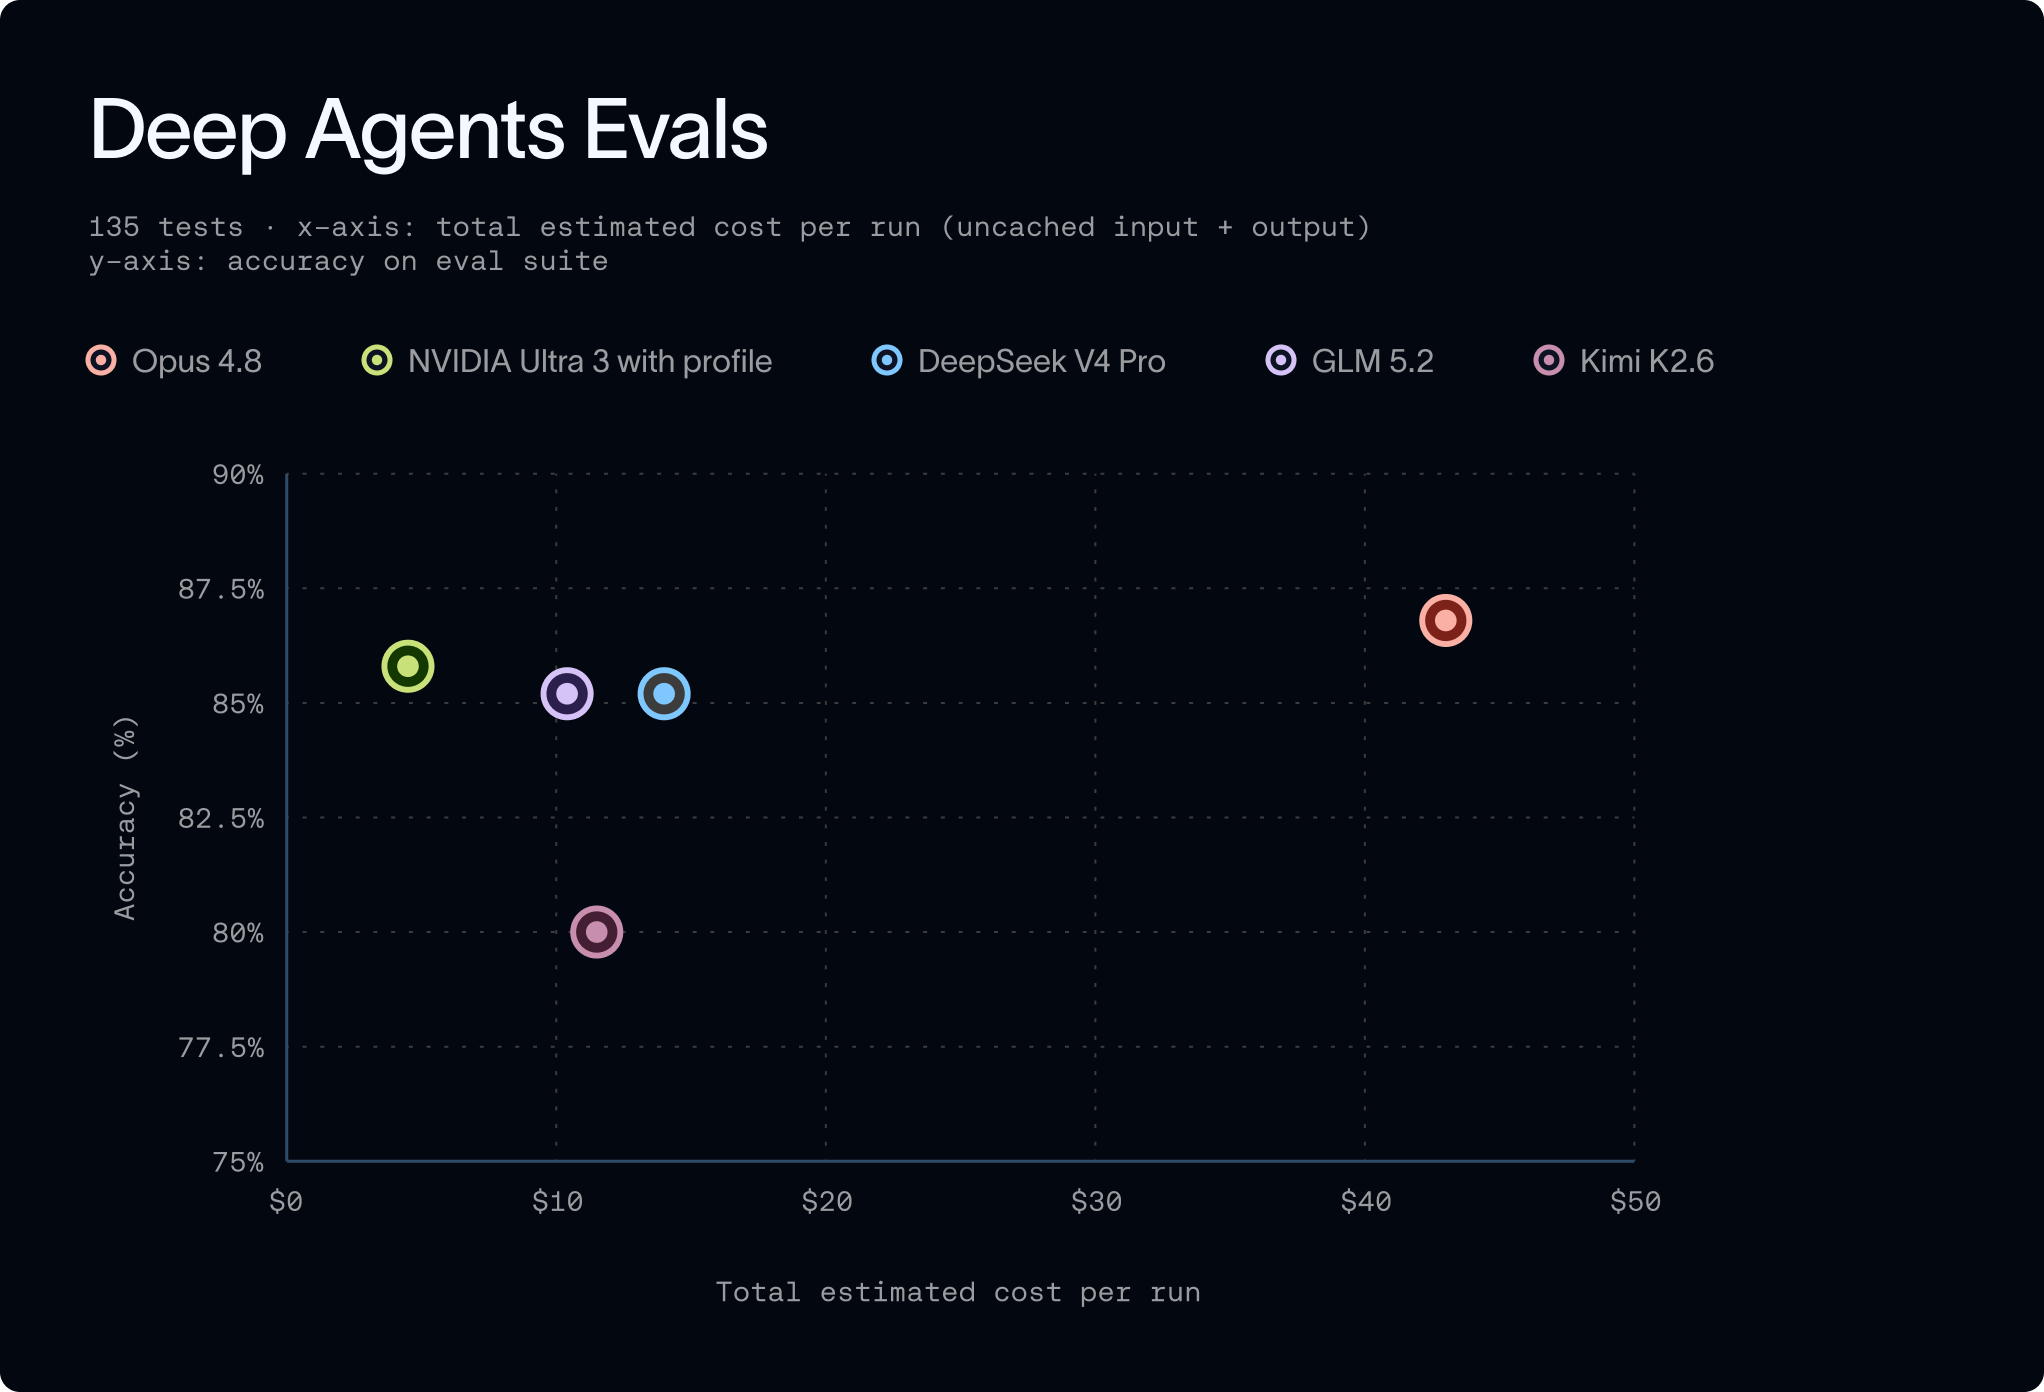
이러한 결과를 얻기 위해, 우리는 에이전트가 도구를 사용하는 방식, 컨텍스트를 관리하는 방식, 중간 단계를 평가하는 방식을 조정했습니다. 목표는 Nemotron 3 Ultra의 강점과 장기 실행 에이전트 작업에서 나타나는 일반적인 패턴을 중심으로 하네스를 적응시키는 것이었습니다.
엔터프라이즈 팀들에게 이것은 전체 에이전트 시스템이 그들의 특정 워크로드 요구 사항에 맞춰 최적화될 수 있음을 의미합니다. 팀들은 모델 가중치를 미세 조정(fine tune)하고, 하네스를 맞춤 설정하며, 평가를 실행하고, 품질, 비용, 지연 시간(latency), 거버넌스 요구 사항을 기반으로 런타임을 제어할 수 있습니다. 이는 기업들이 에이전트의 핵심 지능을 소유하고 시간이 지남에 따라 시스템이 언제, 어떻게, 왜 변경될지 결정하는 방법을 제공합니다.
추론 비용 절감이 더 나은 에이전트로 이어지는 이유
추론 비용 절감은 오픈 모델을 사용하는 가장 큰 이점 중 하나입니다. 이는 최종 사용자에게 서비스 비용을 줄여줄 뿐만 아니라, 팀들이 에이전트를 구축하고 개선하는 방식 자체를 변화시킵니다.
Evals는 팀들이 에이전트 개발 수명 주기(lifecycle) 전반에 걸쳐 실행할 때 가장 효과적입니다. 배포 전에, 팀들은 프롬프트, 하네스(harness), 도구(tools), 모델, 데이터의 변경 사항을 테스트해야 합니다. 배포 후에는 실제 동작을 모니터링하고, 필요한 수정 사항을 만들고, 회귀(regression)가 다시 발생하지 않도록 테스트를 생성해야 합니다.
각 반복 작업이 비용이 많이 들 때, 팀들은 더 적은 에vals를 실행하고, 더 적은 변형(variants)을 비교하며, 운영 비용이 너무 높기 때문에 전문화된 에이전트를 피하게 됩니다.
비용 효율적인 오픈 스택은 다음 작업을 실용적으로 만듭니다:
- 배포 전과 프로덕션 환경에서 더 큰 에vals 스위트(eval suites) 실행
- 더 많은 모델, 하네스, 도구 변형 비교
- 특정 도메인을 위한 전문화된 에이전트 평가
주어진 워크로드에 가장 적합한 시스템은 품질, 비용, 속도, 거버넌스를 함께 최적화합니다. 예를 들어, 실시간 고객 지원 에이전트의 지연 시간(latency) 요구 사항은 백그라운드에서 동시 작업을 실행하는 코딩 에이전트와 매우 다르게 보입니다.
“슈퍼 에이전트가 도착했습니다. NVIDIA Nemotron과 같은 오픈 모델, LangChain 하네스, NVIDIA OpenShell 런타임, 그리고 기업 자체의 데이터만 있다면, 모든 기업은 자사의 비즈니스를 이해하고, 자사 도구를 사용하며, 지식을 행동으로 전환하는 맞춤형 에이전트를 구축할 수 있습니다. AI의 미래는 만능(one-size-fits-all)적이지 않을 것입니다. 기업들은 자체적인 독점 데이터, 노하우, 워크플로우에 의해 형성된 AI 클라우드 서비스를 사용하고 자신만의 AI를 구축하며, 운영하는 모든 곳에서 안전하고 보안적으로 실행할 것입니다.” – Jensen Huang, NVIDIA 창립자 겸 CEO
에코시스템 지원
이번 발표는 EY가 소프트웨어 스택을 중심으로 구현 실무(implementation practice)를 구축하고 있으며, Baseten, Fireworks, Nebius, Crusoe, DeepInfra, Together AI 등 AI 인프라 및 엔터프라이즈 에코시스템 전반의 파트너들의 지원을 받고 있습니다. 이 파트너들은 기업들이 Nemotron 모델을 프로덕션 환경에서 서비스하고 비즈니스 중요 애플리케이션을 위한 청사진을 조정하는 데 도움을 줍니다.
“규제 산업의 EY 고객들은 에이전트형 AI를 고립된 파일럿 단계에서 벗어나 프로덕션 환경으로 옮길 준비가 되어 있으며, 종종 거버넌스(governance), 보안(security), 그리고 규제 기관이나 이사회에 통제력을 입증하는 능력에 의해 제약받습니다. 오픈 에이전트 아키텍처는 기업들에게 에이전트가 어떻게 작동하는지에 대한 투명성, 데이터와 추론(inference)이 어디에서 실행될지에 대한 통제권, 그리고 폐쇄적인 스택에 전념하지 않고 자체 조건으로 배포할 자유를 제공하기 때문에 중요합니다. LangChain 기술을 통합한 NVIDIA NemoClaw 청사진을 제공함으로써, EY 팀은 고객들이 감사 가능성(auditability)과 위험 측면에서 기업 표준을 충족하는 항상 작동하는 에이전트를 위한 안전하고 격리된 기반을 갖출 수 있도록 돕습니다.” – Geoff Vickrey, 글로벌 최고 상업 책임자(Global Chief Commercial Officer), NVIDIA, EY
“프로덕션 에이전트는 대규모로 빠르고, 안정적이며, 비용 효율적인 추론 능력을 필요로 합니다. 저희는 Baseten에서 NVIDIA Nemotron 모델을 최적화하여 NVIDIA 하드웨어에서 높은 처리량(throughput)과 낮은 지연 시간(latency)을 제공함으로써, 팀들이 인프라를 직접 운영하지 않고도 강력한 가격-성능(price-performance)을 얻도록 했습니다. LangChain의 NemoClaw 청사진을 통해 Nemotron을 제공하는 것은 기업들에게 이러한 워크로드가 요구하는 성능과 경제성을 갖춘 오픈 에이전트 모델을 프로덕션에서 실행할 수 있는 명확한 경로를 제공합니다.” – Philip Kiely, 개발자 관계 책임자(Head of Developer Relations), Baseten.
“에이전트형 워크로드는 작업당 많은 모델 호출을 수행하므로, 추론 속도와 비용은 에이전트가 프로덕션에서 실행 가능한지 여부를 직접적으로 결정합니다. Fireworks는 높은 볼륨의 에이전트 시스템이 요구하는 처리량과 가격-성능으로 NVIDIA Nemotron 모델에 서비스를 제공하며, 이러한 워크로드가 의존하는 도구 호출(tool calling) 및 추론 패턴에 맞춰 조정되었습니다. LangChain의 NemoClaw 청사진을 통해 Nemotron을 제공함으로써 기업들에게는 자신 있게 확장할 수 있는 효율적이고 오픈된 기반을 제공합니다.” – Lin Qiao, 최고 경영자 겸 공동 설립자(CEO and Cofounder), Fireworks AI.
“기업용 AI의 다음 과제는 복잡한 에이전트 워크로드(agentic workloads)를 프로덕션 규모에서 경제적으로 구동하는 것입니다. Nebius는 바로 그 도전을 위해 구축되었습니다. 당사의 AI 네이티브 클라우드는 고객에게 고성능 추론(inference)과 비용 효율적인 확장에 최적화된 전용 인프라를 제공합니다. LangChain을 통해 NVIDIA Nemotron 모델을 NemoClaw 청사진으로 제공함으로써, 저희는 조직들이 오픈 에이전트 AI를 비즈니스 전반에 걸쳐 배포하고 확장하는 것을 더 쉽게 만들고 있습니다.” – Roman Chernin, 최고 사업 책임자(CBO), Nebius
사용 가능 여부 (Availability)
NemoClaw for LangChain 딥 에이전트 청사진은 오늘부터 사용할 수 있습니다.
더 깊은 기술적 세부 정보는 다음을 참고하세요:
AI 자동 생성 콘텐츠
본 콘텐츠는 LangChain Blog의 원문을 AI가 자동으로 요약·번역·분석한 것입니다. 원 저작권은 원저작자에게 있으며, 정확한 내용은 반드시 원문을 확인해 주세요.
원문 바로가기