
Irodori-TTS v4.1의 참조 음성에 전처리(Preprocess)를 적용했을 때, 짧은 읽기 앞뒤로 소리가 발생함
요약
Irodori-TTS v4.1을 사용하여 짧은 단어를 읽게 할 때, 참조 음성에 전처리(Preprocess)를 적용하면 목소리 앞뒤로 BGM 같은 소리가 발생하는 문제가 확인되었습니다. 이 현상은 특히 무음 채우기, 음량 맞추기 등의 전처리가 원인으로 지목되었으며, 현재는 전처리 없이 단순히 자른 참조 음성을 사용하는 것이 안전하다고 결론지었습니다.
핵심 포인트
- 참조 음성 전처리는 짧은 읽기에서 BGM 같은 소리 발생의 주원인입니다.
- 전처리 과정(무음 채우기, 음량 맞추기 등)이 결과 악화의 핵심 원인으로 밝혀졌습니다.
- 현재로서는 참조 음성을 자르기만 하고 전처리를 거치지 않는 것이 안전합니다.
이전 편에서 발음의 좋음을 확인했던 Irodori-TTS v4.1-Small에 '清水寺'와 같은 단어만 읽게 했을 때, 목소리 앞뒤로 BGM 같은 소리가 났습니다. 원인을 참조 음성의 조건으로 좁혀 분석한 결과, 참조 음성에 적용했던 전처리(무음 구간을 채우고 음량을 맞추는 작업)가 주된 원인으로 밝혀졌습니다.
결론
- 참조 음성에 전처리를 적용하자, 짧은 입력 8 문 × seed 2의 총 16개에서 모두 목소리 앞에 소리가 발생했습니다. 전처리 후 길이를 12.87초로 하든, 15.54초로 하든, 두 번 연결하여 25.74초로 하든 결과는 동일합니다.
- 같은 녹음을 잘라낸 참조 음성으로는 25.69초, 15초의 총 32개에서 소리가 발생하지 않았습니다. 전처리 후와 같은 12.87초로 자른 참조에서는 16개 중 'こんにちは。'와 '京都へようこそ。' 두 개의 경우에만 소리가 나오고 있습니다.
- 전처리는 무음 채우기(silenceremove) → 음량 맞추기(loudnorm) → 끝에 0.5초의 무음을 추가하는 3단계로 이루어지며, 중간에 샘플 레이트가 192kHz로 올라갑니다. 어떤 단계가 영향을 미치는지 아직 구분하지 못했습니다.
- 전처리를 적용하지 않은 다른 10초 길이의 참조 음성에서도 16개 모두에서 소리가 발생했습니다. 그 이유는 알 수 없습니다.
- 소리가 발생한 조건에서는 Irodori가 예측하는 출력 길이도 짧아졌습니다. 같은 단어임에도 불구하고 0.8~1.4초씩 짧고, 목소리 앞뒤의 여백이 채워져 있습니다.
- 현재로서는 Irodori에 전달할 참조 음성은 이 전처리 과정을 거치지 않고 자르는 것만 하는 것이 안전합니다. 참조 음성의 전처리가 결과 악화의 원인이 된 것은 09-13의 Fish Audio denoise를 이어 두 번째 사례입니다.
계기
다른 TTS가 'しみずでら', 'くえんじ'와 같이 잘못 읽었던 清水寺(키요미즈데라)와 鹿苑寺(로쿠온지)를 Irodori에 단어와 문으로 읽게 했습니다 (6문 × seed 3의 총 18개). 이전 편과 같은 방법으로 가타카나로 표기하자, 단어만 있는 6개 중 4개가 'キミヨスデラ', 'ロクオンシ。'처럼 무너졌습니다.
그런데 귀로 들으니 18개 모두 발음은 정확했고, 무너진 것은 표기한 쪽이었습니다. 단어만 있는 음성에서는 목소리 앞뒤로 BGM 같은 소리가 나고 있었으며, 표기는 그것에 영향을 받은 것처럼 보였습니다. 清水寺의 3개는 끝부분 0.4초의 음량이 -12.4~-15.5 dB로, 목소리와 비슷한 크기입니다.
이때 전달했던 참조 음성은 이전 편과 같은 자신의 목소리 10초(R10)였습니다. 이전 편의 목소리 유사도 비교에 사용했던 26초 녹음(R26)으로 짧은 입력을 읽게 하자 소리는 사라졌습니다. 여기서부터 참조 음성의 조건을 하나씩 바꾸어 시도했습니다.
시도한 조건
R26에서 만든 6가지의 참조와 R10을 비교했습니다.
| 조건 | 참조 | 길이 | 전처리 |
|---|---|---|---|
| R10 | 이전 편의 10초 참조 | 10.16초 | 없음 |
| ... | |||
| 전처리는 TTS의 참조 음성에 흔히 적용되는 것으로, 09-13 기사에서도 모든 조건에 공통적으로 적용했습니다. |
- 시작 15초(F는 18초)로 자르기
- -40 dB보다 조용한 구간을, 시작은 0.2초, 중간은 0.3초를 초과하는 만큼 채우기
- 음량을 -18 LUFS로 맞추기. 샘플 레이트를 지정하지 않았으므로 출력은 192kHz가 됩니다.
- 끝에 0.5초의 무음을 추가하기
조건은 순차적으로 늘려갔습니다. C에서 소리가 발생했을 때, 저는 '15초로 자른 후 무음 채우기를 거쳐 12초대로 줄었으니 너무 짧지 않을까'라고 생각했습니다. 그래서 같은 C를 두 번 연결하여 길이가 두 배가 된 것이 D이고, 내용이 있는 길이로 비교하기 위해 전처리 없이 C와 같은 12.87초로 자른 것이 E이며, 전처리 후에도 15초 이상 남도록 길게 자른 것이 F입니다.
읽게 한 문장은 'はい', 'ありがとう', '金閣寺', '嵐山', '伏見稲荷大社'의 5개 단어와 'こんにちは。', '京都へようこそ。', '次は嵐山です。'의 3개 문장으로, 각각 seed 1과 2를 사용하여 총 2개씩 생성했습니다. 조건별로 총 16개가 되었습니다.
결과
목소리 앞에 소리가 나는지 여부를 출력 시작 0.2초의 음량으로 확인했습니다. A와 B는 모두 32개에서 -78 dB대 이하로 거의 무음이므로, -60 dB보다 크면 뭔가 나고 있다는 기준으로 삼았습니다.
| 조건 | 후처리 | 시작 0.2초가 -60 dB보다 큰 본수 | 시작 0.2초 범위 (dB) |
|---|---|---|---|
| R10 | 없음 | 16 / 16 | -10.9〜-42.0 |
| ... | |||
| 후처리를 적용한 C, D, F는 48개 모두 소리가 나왔습니다. 길이로 설명할 수 있는지 살펴보자면, 15초 이상 내용이 있는 F에서도 소리가 났고, C와 같은 12.87초의 E에서는 단어 10개와 '다음은 아라시야마입니다.' 2개를 합쳐 총 12개가 -78.7〜-80.8 dB로 무음 상태를 유지했습니다. 결과가 길이보다는 후처리 유무에 따라 일관되게 나타났습니다. |
E의 예외는 '안녕하세요.'와 '교토에 오신 것을 환영합니다.' 4개에서 발생했으며, 3개는 -16.0〜-33.5 dB였고, '교토에 오신 것을 환영합니다.'의 seed 2는 -56.5 dB였습니다.
'금각사' seed 2의 스펙트로그램을 나란히 놓으면 차이가 눈에 보입니다. 각 구간은 해당 음성의 최대값을 기준으로 한 진하기입니다.
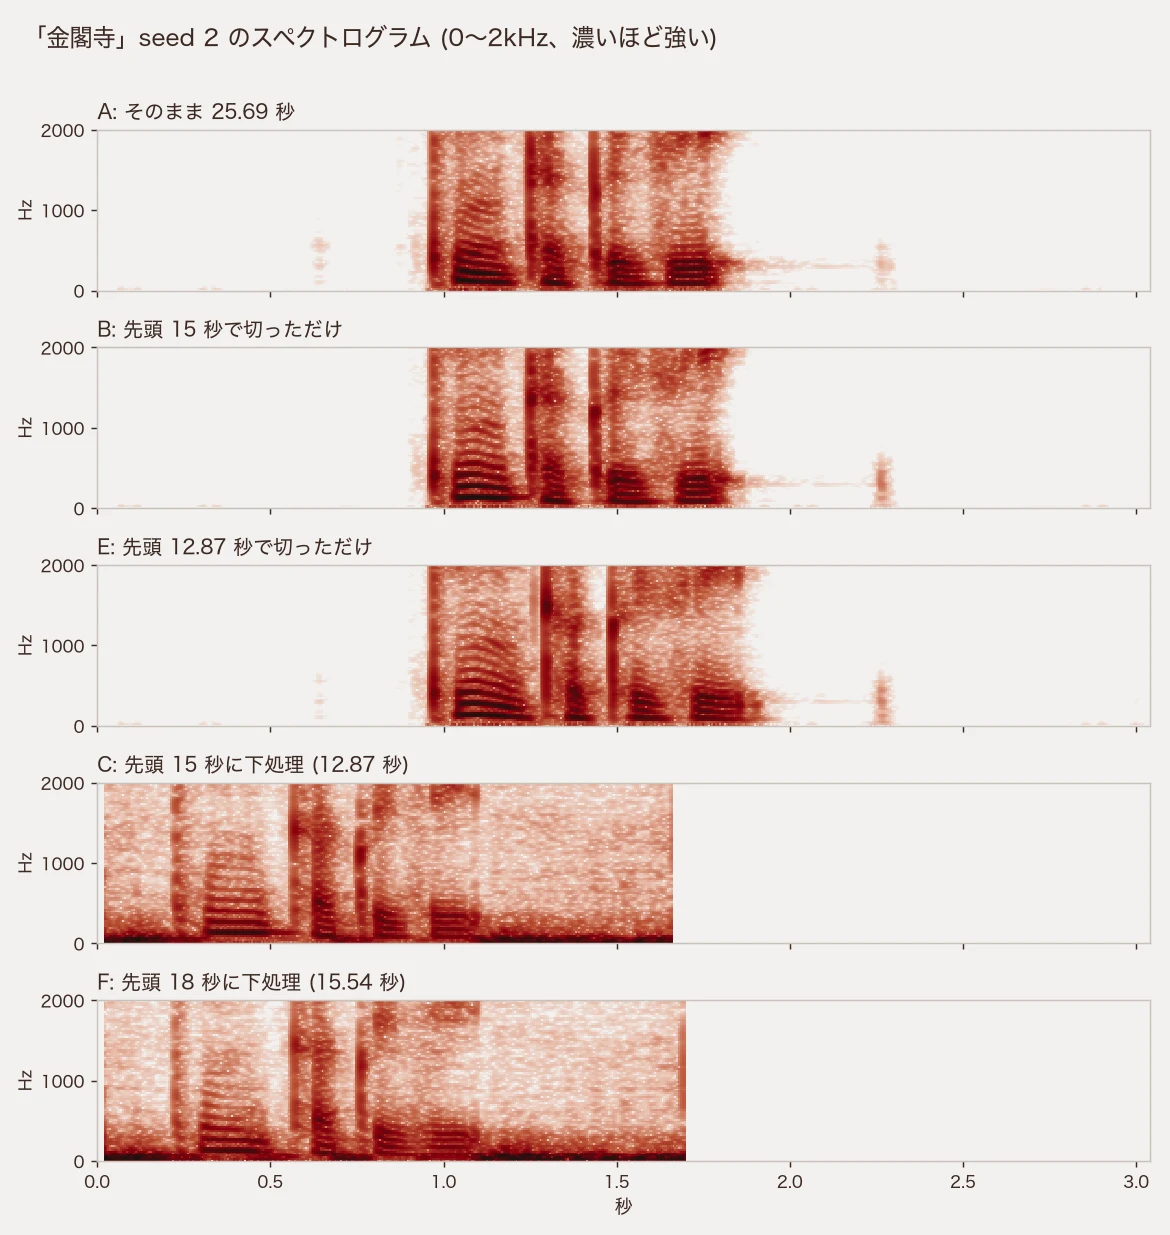
A, B, E는 소리가 없는 구간이 거의 흰색이고, C, F는 낮은 대역의 짙은 띠가 소리 앞부터 뒤까지 이어져 있습니다. 귀로 들었던 'BGM 같은 소리'가 이 띠입니다.
출력 길이도 나뉘었습니다. Irodori는 문장과 참조 음성으로부터 출력 길이를 예측하고 (inference_runtime.py), 소리가 난 R10, C, D, F는 동일한 문장에서 1.36〜2.80초였고, 소리가 안 난 A, B, E는 2.36〜3.80초였습니다. 단어만으로 구성된 5개 단어에서는 0.8〜1.4초의 차이가 있었으며, 소리가 나는 조건에서는 음성 앞뒤 여백이 거의 없습니다.
청취 비교
참고로 Zenn에서는 음성의 인라인 재생이 불가능하므로, 음성은 링크된 곳(별도 탭)에서 재생됩니다. 인라인으로 청취하고 싶으시면 블로그 버전을 이용해 주세요.
그림과 같은 '금각사' seed 2를 A, B, E (후처리 없음), C, F (후처리 있음) 순서로 배치합니다.
A (R26 그대로):
B (시작 15초에서 자른 것만):
E (시작 12.87초에서 자른 것만):
C (시작 15초에 후처리):
F
생성은 RunPod의 RTX 4090에서 Irodori-TTS commit 89f9d8f, fp32로 진행했으며, 스텝 수와 CFG는 체크포인트 기본값을 사용했고, 참조(reference)의 전사본은 전달하지 않았습니다. 이전 편과 동일한 설정입니다.
- 조건별로 8문 × seed 2의 총 16개 분량입니다. seed를 늘렸을 때의 비율은 측정하지 않았습니다.
- 소리가 발생했는지 여부는 시작 후 0.2초 동안의 음량이 -60 dB를 초과했는지를 기준으로 판단했습니다. 끝 부분은 문장 발화가 끝나는 지점이라 판단에 사용하지 않았습니다. 귀로 확인한 것은 일부 오디오만 그렇습니다.
- 참조 녹음은 R10과 R26, 총 2개입니다. 둘 다 제 목소리입니다. R26는 mp3에서 복원한 녹음입니다.
- 첫 번째 분량의 전사본은 gpt-4o-transcribe를 사용한 가타카나 전사본이며, 이전 편과 동일한 방식입니다.
생성 및 참조 생성/측정 코드와 130개 분량의 수치는 blog-examples에 있습니다. 참조를 만드는 방법은 make_refs.sh에, 09-24에 기고한 R26에서 같은 방식으로 만들 수 있도록 배치해 두었습니다.
참고
논의(Discussion)

AI 자동 생성 콘텐츠
본 콘텐츠는 Zenn AI의 원문을 AI가 자동으로 요약·번역·분석한 것입니다. 원 저작권은 원저작자에게 있으며, 정확한 내용은 반드시 원문을 확인해 주세요.
원문 바로가기