
IonQ: 오류 정정 디코딩을 지배하는 단 하나의 CPU
요약
양자 컴퓨팅에서 오류 정정 및 디코딩은 핵심 병목 현상입니다. 이 과정은 물리적 큐비트의 잡음으로부터 데이터를 보호하고, 발생한 오류 신호(증후군)를 분석하여 특정 오류를 결정하는 역할을 합니다. IonQ는 단일 표준 CPU를 사용하여 복잡한 디코더를 개발함으로써 양자 컴퓨터가 중단 없이 실시간으로 작동할 수 있게 했습니다.
핵심 포인트
- 오류 정정 및 디코딩은 양자 컴퓨팅의 핵심 병목 현상이다.
- 디코딩 과정은 고전 알고리즘에 크게 의존하며 계산 복잡도가 높다.
- Nvidia CUDA-Q, Google AlphaQubit 등 AI/GPU 가속화가 활용되고 있다.
- IonQ는 단일 CPU로 실시간 디코더를 개발하여 양자 컴퓨터의 연속 작동을 가능하게 했다.
컴퓨팅
IonQ: 오류 정정 디코딩을 지배하는 단 하나의 CPU
결함 허용(fault-tolerant)적이고 확장 가능한 양자 컴퓨팅에 도달하기 위해 진행되는 모든 작업 – 시스템 아키텍처, 소프트웨어 및 알고리즘 개발, 고전-양자 하이브리드 환경 워크플로우 매핑 등 – 에서 핵심 병목 현상은 여전히 오류 감지 및 정정입니다. 이것이 없으면 양자 시스템은 실용적인 사용에 너무 불안정하고 너무 많은 오류를 생성하여 남아 있을 것입니다.
이 분야에서는 진전이 이루어지고 있으며, 논리 큐비트(logical qubits)가 중심 역할을 하며, 수많은 잡음이 있는 물리적 큐비트(noisy physical qubits)로 구성되어 양자 시스템의 신뢰할 수 있는 빌딩 블록 역할을 합니다. 그렇다고 해도, 오류 정정의 또 다른 중요한 부분은 디코딩(decoding)입니다. 이는 오류 정정 중에 생성된 오류 신호 – 또는 증후군(syndromes) – 을 분석하여 시스템에 영향을 미치는 특정 오류를 결정하는 과정입니다.
양자 컴퓨터는 큐비트를 파괴하지 않고 직접 측정할 수 없습니다. 큐비트는 매우 취약하며 주변 잡음 – 예를 들어 빛, 진동 및 다른 큐비트 – 에 의해 쉽게 깨져 양자적 특성과 담고 있는 데이터를 잃을 수 있습니다. 대신, 이들은 주변 데이터 포인트를 측정하여 오류가 발생했음을 나타내는 증후군을 생성하고 정보를 디코더(decoders)에게 넘깁니다.
중립 원자를 사용하여 큐비트를 구축하는 양자 컴퓨팅 회사 QuEra의 과학자들에 따르면, “디코딩에서 핵심적인 과제는 특히 양자 시스템의 크기가 커짐에 따라 관련된 계산 복잡성을 관리하는 것입니다.”라고 합니다. “효율적인 디코더는 속도와 정확도의 균형을 맞추어, 복잡한 오류 패턴을 올바르게 해석할 수 있는 능력을 희생하지 않으면서 실시간 성능을 보장해야 합니다.”
디코딩은 고전 컴퓨팅 알고리즘에 크게 의존하는 과정이며 역사적으로 많은 처리 능력을 소비해 왔는데, 이는 양자 시스템과 큐비트의 수가 증가함에 따라 늘어납니다. 또한 사용되는 표면 코드(surface code)나 색상 코드(color codes)와 같은 특정 오류 정정 코드에 맞춰 조정되어야 합니다.
발전이 이루어지고 있습니다. Nvidia의 CUDA-Q 플랫폼과 같은 GPU 가속화가 활용되고 있으며, AI 사용도 증가하고 있습니다. 최근 사례로는 IBM이 대규모 언어 모델(LLM) 프레임워크를 사용하여 수천 개의 코드 변형을 분류함으로써 특정 환경에 맞는 올바른 코드를 결정하는 것이 있습니다. Google은 2년 전 디코딩 및 오류 수정에 트랜스포머 기반 신경망을 사용하는 AlphaQubit을 개발했으며, 올해는 양자 컴퓨터가 수집한 인코딩 정보를 AI 시스템을 통해 처리하고 발견된 오류로부터 학습하여 시스템을 조정할 수 있는 AI 기반 강화학습(RL) 기술을 상세히 공개했습니다. 이는 운영자가 오류를 발견했을 때 보정 작업을 위해 멈출 필요 없이 초전도 양자 컴퓨터를 장기간 실행할 수 있음을 의미합니다.
이번 주, 트랩드-이온 모달리티(trapped-ion modality) 기반의 양자 시스템을 구축하는 IonQ의 과학자들이 단일 표준 CPU를 사용하여 복잡한 작업을 실시간으로 처리할 수 있는 디코더를 개발했으며, 이를 백그라운드에서 실행하여 양자 컴퓨터가 계속 작동하도록 할 수 있다고 밝혔습니다. 이는 Google의 강화학습 방식과 유사합니다.
과학자들은 arXiv에 게재된 연구 논문에서 “수백 개의 논리 큐비트에 대해 수백만 번의 연산을 수행할 수 있는 장치인 MegaQuOp 양자 컴퓨터의 실현은 양자 컴퓨팅 커뮤니티의 주요 이정표를 나타내며 과학적 탐험을 위한 새로운 도구를 제공할 것입니다”라고 작성했습니다. “하지만, 수백만 개의 논리 연산으로 구성된 양자 계산 전반에 걸쳐 수백 개의 논리 큐비트를 실시간으로 디코딩하는 것은 여전히 주요 과제로 남아 있습니다.”
IonQ 경영진은 이 연구가 양자 컴퓨터의 논리 큐비트 수가 증가하더라도 조직이 클래식 하드웨어를 지수적으로 확장할 필요는 없다는 것을 보여준다고 말했습니다. 그들은 단일 CPU로 구동되는 클래식 컴퓨터에서 오류 디코딩을 실행하는 것이, 이번 달 초에 소개한 Superion 시스템의 256개 물리 큐비트를 훨씬 뛰어넘는 로드맵(아래)의 핵심이라고 덧붙였습니다.
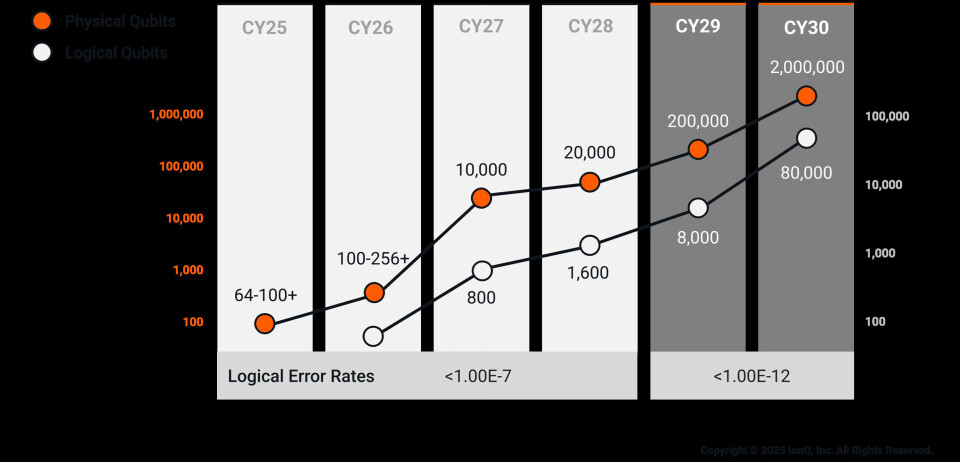
이 공급업체는 이번 주 플로리다 국제 대학교가 Superion 시스템을 구매한다고 발표했습니다(아래). 이 시스템은 2027년 말에 학교 캠퍼스 내 전문 시설에 설치될 예정입니다.
논문에서 과학자들은 오류 허용 시스템에서 범용 양자 컴퓨팅에 필요한 환경을 생성하는 서브시스템인 메모리 블록과 매직 팩토리 전반에 걸쳐 최대 408개의 논리 큐비트를 시뮬레이션한 벤치마크 회로를 만들었다고 작성했습니다. 이 회로는 메가QuOp 규모에서 3,150만 개 이상의 개별 양자 연산을 실행했으며, 스트레치 시간은 0.02%에 불과하게 도입했습니다.
본질적으로 과학자들에 따르면 전체 양자 계산에 추가된 지연 시간이 매우 적었습니다.
그들은 또한 표면 코드(surface code)의 속도와 처리량 가속화에 대한 다른 연구 노력들을 언급했는데, 이 코드는 물리 큐비트의 2차원 사각형 격자에 단일 논리 큐비트를 인코딩하여 양자 정보를 보호하는 오류 정정 코드입니다. 또한, 초전도 양자 시스템에 필요한 지연 시간에 도달하기 위해 소프트웨어와 하드웨어(GPU, ASIC, FPGA, TPU 포함)를 통해 양자 저밀도 패리티 검사(LDPC) 메모리 디코더를 개발하고 있습니다.
IonQ 과학자들은 자신들의 디코딩 시스템이 68개의 LDPC 메모리 블록과 11,680개의 물리적 큐비트를 사용하여 생성된 20개의 매직 스테이트 팩토리로 구성되어 있다고 언급했습니다. 이 시스템은 빔 검색 디코더(beam search decoder)를 중심으로 구축된 이중 슬라이딩-윈도우 디코더(dual sliding-window decoder)에 기반합니다. 이는 각 단계에서 가장 유망한 오류 경로의 고정된 개수, 즉 '빔 폭(beam width)'을 보장함으로써 LDPC 디코딩을 위한 오류 정정 알고리즘입니다. 이 과정은 실시간으로 검출기 오류 모델(DEMs: detector error models)을 생성하며, 단일 CPU에서 여러 디코더 인스턴스가 동시에 실행될 수 있도록 하는 메모리 최적화를 포함합니다.
DEMs는 게이트 오류나 노이즈가 오류 정정 회로 내의 특정 오류 검출기에 어떻게 영향을 미치는지 매핑하는 수학적 설명입니다.
CPU 전용 프로세스의 핵심은 IonQ의 트랩드-아이온 양자 시스템을 위한 워킹 캣 아키텍처(Walking Cat architecture)이며, 이 아키텍처는 공급업체가 지난 4월 상세 청사진으로 발표했습니다. 이 아키텍처에는 컴파일러, 오류 정정 프로토콜, 마이크로아키텍처, 전체 시뮬레이션, 그리고 빠른 디코더가 포함되어 있으며, 모두 LDPC 오류 정정 코드에 기반합니다. 이 아키텍처의 근간은 '캣 팩토리(cat factory)'인데, 이는 캣 상태(cat states) – 즉, 동시에 여러 개의 개별 상태의 중첩(superpositions of distinct states) –를 생성하며, 이러한 캣 상태는 시스템 전체에 분산되어 논리 연산을 수행합니다.
과학자들은 이 아키텍처의 단순성을 언급하며, “논리 계산은 qLDPC 메모리 블록을 병합하거나 변형시키거나 그 신드롬 추출 회로를 변경할 필요가 없다”고 적었습니다.
대신, 그들은 “캣 기반 측정(cat-based measurements)이 그렇지 않으면 규칙적인 신드롬 추출 스트림에 삽입되며, 대규모 클래스의 클리포드 연산(Clifford operations: Pauli 연산자 – X, Y, Z –를 다른 Pauli 연산자로 변환하는 양자 게이트)은 소프트웨어 프레임 추적을 통해 처리되어, 온라인 DEM 생성부터 디코딩까지 전체 고전적 디코딩 파이프라인이 단일 상용 CPU의 12개 코어만을 사용하여 MegaQuOp 규모에서 실현 가능하게 만든다”고 적었습니다.
AI 자동 생성 콘텐츠
본 콘텐츠는 The Next Platform의 원문을 AI가 자동으로 요약·번역·분석한 것입니다. 원 저작권은 원저작자에게 있으며, 정확한 내용은 반드시 원문을 확인해 주세요.
원문 바로가기