
harness 엔지니어링을 통한 딥 에이전트 개선
요약
본 기사는 에이전트의 성능을 향상시키는 '하네스 엔지니어링' 접근 방식을 소개합니다. 하네스는 시스템 프롬프트, 도구, 미들웨어 등 모델 주변에 구축되는 도구들을 의미하며, 이를 조정하여 에이전트가 작업을 수행하는 전반적인 과정을 최적화할 수 있습니다. 이 방법을 통해 코딩 에이전트의 성능을 크게 개선한 사례를 제시합니다.
핵심 포인트
- 하네스 엔지니어링은 모델 주변에 도구를 구축해 성능, 효율성 등을 최적화하는 시스템 접근 방식입니다.
- 주요 조정 요소는 시스템 프롬프트, 사용되는 도구(Tools), 그리고 미들웨어(Middleware) 세 가지입니다.
- LangChain의 트레이스를 활용하여 에이전트의 실패 모드를 분석하고 개선 루프를 만드는 것이 중요합니다.
- 하네스만 조정함으로써 코딩 에이전트의 벤치마크 점수를 크게 향상시킬 수 있습니다.
요약: 우리의 코딩 에이전트는 터미널 벤치 2.0(Terminal Bench 2.0)에서 상위 30위권에서 상위 5위권으로 올라갔습니다. 우리는 하네스만 변경했습니다. 여기 저희의 하네스 엔지니어링 접근 방식입니다 (티저: 자체 검증 및 추적 기능이 큰 도움이 되었습니다).
하네스 엔지니어링의 목표
하네스의 목표는 모델의 본질적으로 들쭉날쭉한 지능을 우리가 중요하게 생각하는 작업에 맞게 다듬는 것입니다. **하네스 엔지니어링(Harness Engineering)**은 시스템과 관련이 있습니다. 즉, 에이전트가 작업을 수행할 때의 성능, 토큰 효율성, 지연 시간(latency) 등 목표를 최적화하기 위해 모델 주변에 도구(tooling)를 구축하는 것입니다. 설계 결정에는 시스템 프롬프트(system prompt), 도구 선택, 실행 흐름 등이 포함됩니다.
하지만 에이전트를 개선하려면 하네스를 어떻게 변경해야 할까요?
LangChain에서는 트레이스(Traces)를 사용하여 대규모로 에이전트의 실패 모드를 이해합니다. 오늘날 모델들은 대부분 블랙박스이며, 내부 메커니즘을 해석하기 어렵습니다. 하지만 우리는 텍스트 공간에서 입력과 출력을 볼 수 있고, 이를 개선 루프에 활용할 수 있습니다.
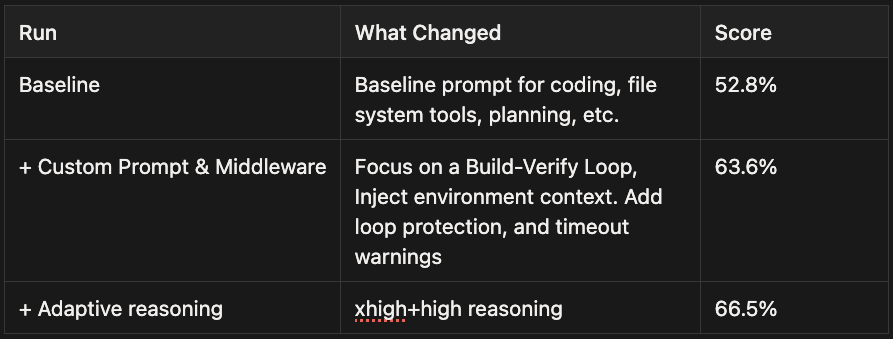
저희는 간단한 레시피를 사용하여 deepagents-cli(우리의 코딩 에이전트)의 점수를 반복적으로 개선했습니다. Terminal Bench 2.0에서 52.8점에서 13.7점을 더하여 66.5점으로 올렸습니다. 우리는 하네스만 조정하고 모델은 gpt-5.2-codex로 고정했습니다.

실험 설정 및 하네스의 조절 가능한 요소들 (The Knobs on a Harness)
우리는 에이전트 코딩을 평가하는 현재 표준 벤치마크인 Terminal Bench 2.0을 사용했습니다. 이 벤치마크는 머신러닝, 디버깅, 생물학 등 다양한 도메인에 걸쳐 89개의 작업을 포함하고 있습니다. 우리는 Harbor를 사용하여 실행을 오케스트레이션(orchestrate)합니다. 이는 샌드박스(Daytona)를 구동하고, 우리의 에이전트 루프와 상호작용하며, 검증 및 점수 계산을 수행합니다.
모든 에이전트 액션은 LangSmith에 저장됩니다. 여기에는 지연 시간, 토큰 수, 비용과 같은 메트릭도 포함됩니다.
우리가 조정할 수 있는 조절 가능한 요소들 (The Knobs we can Turn)
에이전트 하네스에는 많은 조절 가능한 요소들이 있습니다: 시스템 프롬프트, 도구, 후크/미들웨어(hooks/middleware), 스킬, 서브 에이전트 위임(sub-agent delegation), 메모리 시스템 등. 우리는 의도적으로 최적화 공간을 압축하고 세 가지에 집중했습니다: 시스템 프롬프트(System Prompt), 도구(Tools), 그리고 미들웨어(Middleware) (모델 및 도구 호출 주변의 후크를 일컫는 저희 용어입니다).
우리는 기본 프롬프트와 표준 도구+미들웨어를 사용했습니다. 이 조합은 GPT-5.2-Codex에서 52.8%의 점수를 기록했습니다. 준수한 점수이며, 오늘 리더보드 상위 30위권 밖에 위치하지만, 개선할 여지가 있습니다.
Trace Analyzer Skill (추적 분석 스킬)
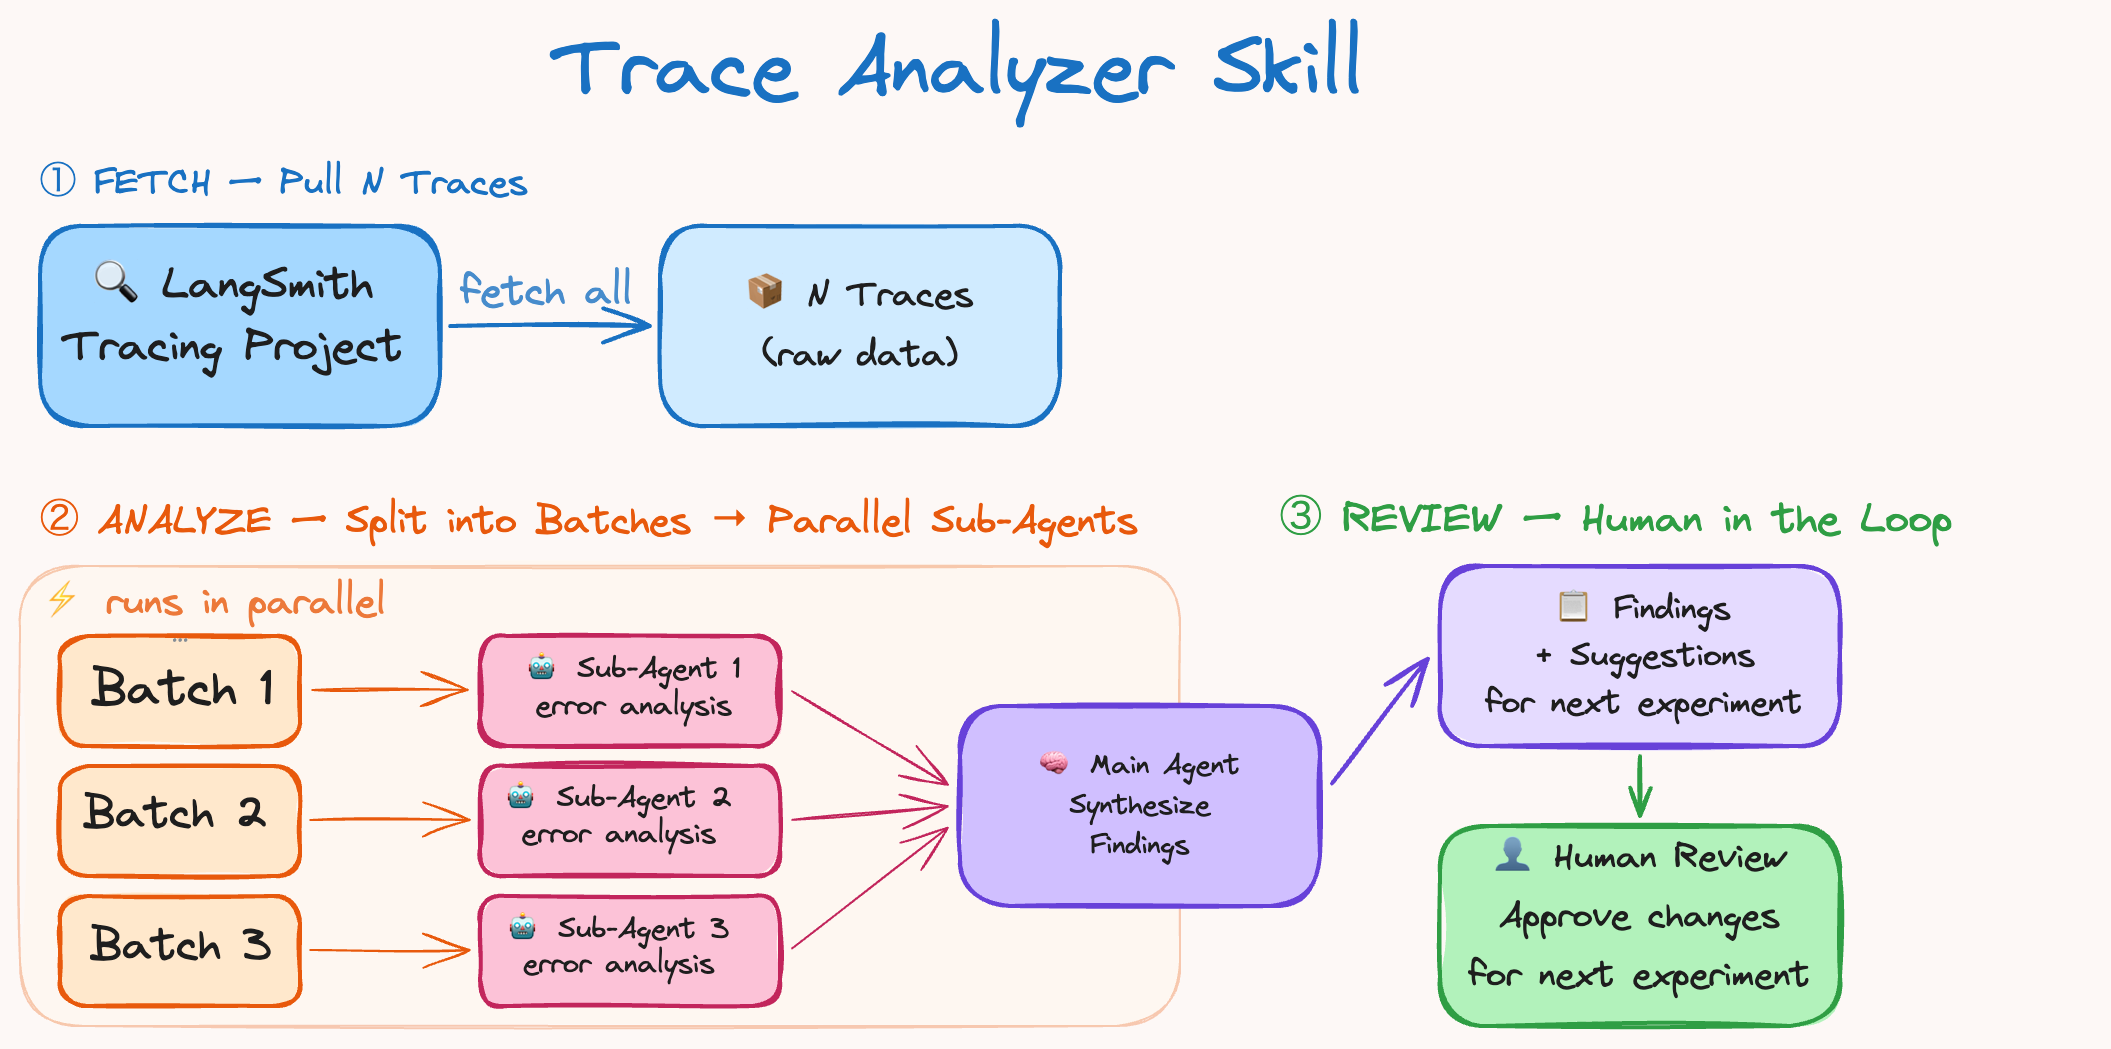
우리는 추적 분석이 반복 가능하기를 원했기 때문에 이를 에이전트 스킬로 만들었습니다. 이것은 실행 전반에 걸친 오류를 분석하고 하네스(harness)를 개선하는 레시피 역할을 합니다. 과정은 다음과 같습니다:
- LangSmith에서 실험 추적을 가져옵니다.
- 병렬 오류 분석 에이전트를 생성합니다 → 메인 에이전트가 발견 사항과 제안을 종합합니다.
- 피드백을 취합하고 하네스에 목표 지향적인 변경을 가합니다.
이는 이전 실행에서 발생한 실수에 초점을 맞추는 부스팅(boosting)과 유사하게 작동합니다. 인간은 3단계(필수 사항은 아니지만)에서 제안된 변경 사항을 검증하고 논의하는 데 매우 도움이 될 수 있습니다. 특정 작업에 과적합(overfit)되는 변경 사항은 일반화(generalization)에 해로울 수 있으며, 다른 작업에서 회귀(regression)를 초래할 수 있습니다.
자동화된 추적 분석은 몇 시간의 시간을 절약해 주었고 실험을 빠르게 시도하는 것을 용이하게 했습니다. 곧 이 스킬을 공개할 예정이며, 현재는 전반적인 프롬프트 최적화를 위해 테스트하고 있습니다.
실제로 에이전트 성능을 개선한 요소들
자동화된 추적 분석 덕분에 에이전트가 어디서 잘못 작동하는지 디버깅할 수 있었습니다. 문제점에는 추론 오류, 작업 지침 미준수, 테스트 및 검증 누락, 시간 부족 등이 포함되었습니다. 아래 섹션에서 이러한 개선 사항에 대해 더 자세히 설명하겠습니다.
빌드 및 자체 검증 (Build & Self-Verify)
오늘날의 모델들은 예외적인 자체 개선 기계입니다.
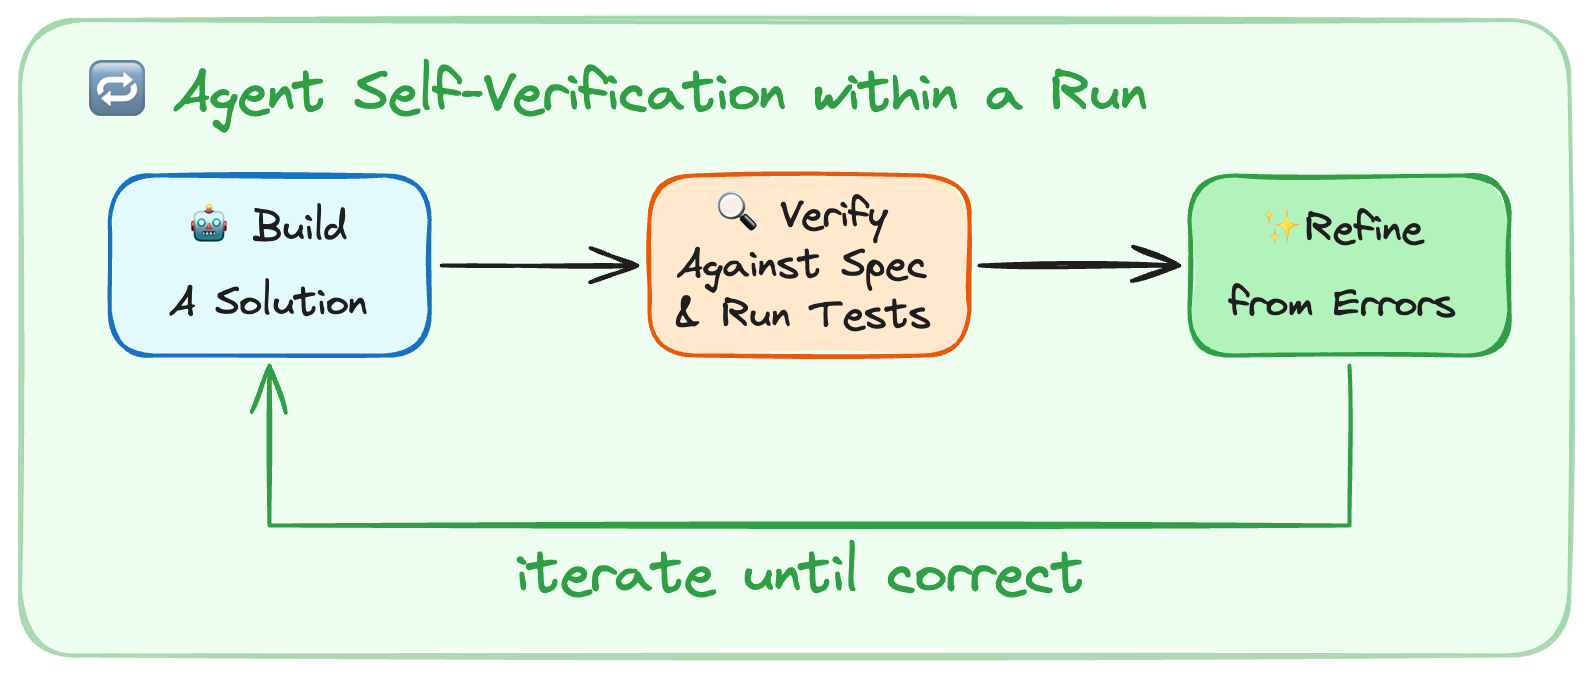
자체 검증(Self-verification)은 에이전트가 실행 과정 중 피드백을 통해 스스로를 개선할 수 있도록 합니다. 하지만, 이 **빌드-검증 루프(build-verify loop)**에 진입하려는 자연스러운 경향성은 없습니다.
가장 흔한 실패 패턴은 에이전트가 솔루션을 작성하고, 자신의 코드를 다시 읽어보고, 괜찮아 보이는지 확인한 후 멈추는 것이었습니다. 테스트는 자율적인 에이전트 코딩의 핵심 부분입니다. 이는 전반적인 정확성을 테스트하는 데 도움을 줄 뿐만 아니라, 에이전트가 반대 방향으로 언덕 오르기(hill-climb)를 할 수 있는 신호도 제공합니다.
문제 해결에 접근하는 방법에 대한 지침을 시스템 프롬프트에 추가했습니다.
계획 및 탐색 (Planning & Discovery): 작업을 읽고, 코드베이스를 스캔하며, 작업 사양과 솔루션을 검증하는 방법을 기반으로 초기 계획을 수립합니다. 구축 (Build): 검증을 염두에 두고 계획을 구현합니다. 테스트가 존재하지 않으면 테스트를 작성하고, 행복한 경로(happy paths)와 엣지 케이스(edge cases) 모두를 테스트합니다. 검증 (Verify): 테스트를 실행하고, 전체 출력을 읽은 후, 요청된 내용과 비교합니다 (자신의 코드와 비교하는 것이 아님). 수정 (Fix): 오류를 분석하고, 원래 사양으로 돌아가 문제를 수정합니다.
저희는 모든 반복(iteration)에서 변경 사항을 구동하는 테스트에 정말 중점을 둡니다. 프롬프팅과 더불어 결정론적 컨텍스트 주입(deterministic context injection)이 에이전트가 자신의 작업을 검증하는 데 도움이 된다는 것을 발견했습니다. 저희는 에이전트가 종료하기 전에 가로채서 (intercepts) Task 사양에 따라 검증 패스를 실행하도록 상기시키는 PreCompletionChecklistMiddleware를 사용합니다. 이는 훅(hook)을 사용하여 에이전트가 종료 시에도 계속 실행하도록 강제하는 Ralph Wiggum Loop와 유사하며, 저희는 이를 검증에 사용합니다.
에이전트에게 환경에 대한 컨텍스트 제공하기
harness 엔지니어링의 일부는 컨텍스트 엔지니어링을 위한 좋은 전달 메커니즘(delivery mechanism)을 구축하는 것입니다. Terminal Bench 작업에는 디렉토리 구조, 내장 도구(built-in tooling), 그리고 엄격한 시간 제한이 포함됩니다.
디렉토리 컨텍스트 및 도구 (Directory Context & Tooling): LocalContextMiddleware는 에이전트 시작 시 실행되어 cwd와 다른 부모+자식 디렉토리를 매핑합니다. 저희는 Python과 같은 도구를 찾기 위해 bash 명령을 실행합니다.
설치 과정(installations). Context discovery 및 검색은 오류가 발생하기 쉬우므로, 컨텍스트 주입(injecting context)을 통해 이러한 오류 표면적(error surface)을 줄이고 에이전트가 환경에 안착하는 데 도움을 줍니다. 테스트 가능한 코드 작성 학습: 에이전트는 자신의 코드가 테스트 가능해야 한다는 것을 알지 못합니다. 우리는 프롬프팅을 추가하여 그들의 작업이 커밋된 코드와 유사하게 프로그램적 테스트(programatic tests)를 통해 측정될 것이라고 알려줍니다. 예를 들어, 파일 경로를 언급하는 태스크 사양(Task specs)은 해결책이 자동 채점 단계에서 작동하도록 정확히 따라야 합니다. 엣지 케이스(edge-cases)에 초점을 맞추는 프롬프팅은 에이전트가 '행복한 경로'(happy path) 사례만 확인하는 것을 방지하는 데 도움이 됩니다. 모델이 테스트 표준을 준수하도록 강제하는 것은 시간이 지남에 따라 발생하는 '느슨함 축적(slop buildup)'을 피하기 위한 강력한 전략입니다. 시간 예산 책정(Time Budgeting): 우리는 시간 예산 경고를 주입하여 에이전트가 작업을 완료하고 검증 단계로 전환하도록 유도합니다. 에이전트는 시간 추정에 매우 취약하므로, 이 휴리스틱(heuristic)은 이 환경에서 도움이 됩니다. 실제 코딩에는 엄격한 시간 제한이 없는 경우가 많지만, 제약 조건에 대한 지식을 추가하지 않으면 에이전트가 시간 범위 내에서 작동하지 않을 것입니다.
에이전트가 자신의 환경, 제약 조건 및 평가 기준에 대해 더 많이 알수록, 그들은 작업을 자율적으로 자체 지시(self-direct)할 수 있게 됩니다.
하네스 엔지니어의 목적: 에이전트가 작업을 자율적으로 완료할 수 있도록 컨텍스트를 준비하고 제공하는 것입니다.
계획을 되돌아보고 재고하도록 장려하기
에이전트는 일단 계획을 세우면 근시안적(myopic)일 수 있으며, 이는 동일한 실패한 접근 방식에 작은 변형을 가하여 '둠 루프'(doom loops)를 초래합니다 (일부 추적에서 10회 이상).
우리는 LoopDetectionMiddleware를 사용하는데, 이것은 도구 호출 후크(tool call hooks)를 통해 파일별 편집 횟수를 추적합니다. 이 미들웨어는 동일한 파일에 N번의 편집이 발생한 후 “…접근 방식을 재고해 보는 것을 고려하십시오”와 같은 컨텍스트를 추가합니다. 이는 에이전트가 둠 루프에서 회복하는 데 도움이 될 수 있지만, 모델이 그것이 옳다고 생각하면 여전히 같은 경로를 따라갈 수 있습니다.
참고 사항. 이것은 오늘날 인식되는 모델 문제에 대한 엔지니어링 휴리스틱입니다. 모델이 개선됨에 따라 이러한 가드레일은 필요하지 않을 가능성이 높지만, 오늘은 에이전트가 정확하고 자율적으로 실행되도록 돕습니다.
추론(Reasoning)에 얼마나 많은 컴퓨팅 파워를 할당할지 선택하기
추론 모델은 몇 시간 동안 자율적으로 실행될 수 있으므로, 모든 하위 작업에 얼마나 많은 컴퓨팅 파워를 사용할지 결정해야 합니다. 각 작업에 최대 추론 예산(max reasoning budget)을 사용할 수 있지만, 대부분의 작업은 추론 컴퓨팅 지출 최적화로부터 이점을 얻을 수 있습니다.
터미널 벤치(Terminal Bench) 타임아웃 제한은 트레이드오프를 만듭니다. 더 많은 추론은 에이전트가 각 단계를 평가하는 데 도움이 되지만, 2배 이상의 토큰/시간을 소모할 수 있습니다. gpt-5.2-codex는 low, medium, high, 그리고 xhigh의 4가지 추론 모드를 가지고 있습니다.
우리는 추론이 문제 전체를 완전히 이해하는 계획(planning)에 도움이 된다는 것을 발견했으며, 일부 터미널 벤치 작업은 매우 어렵습니다. 좋은 계획은 작동하는 솔루션에 더 빨리 도달하도록 돕습니다.
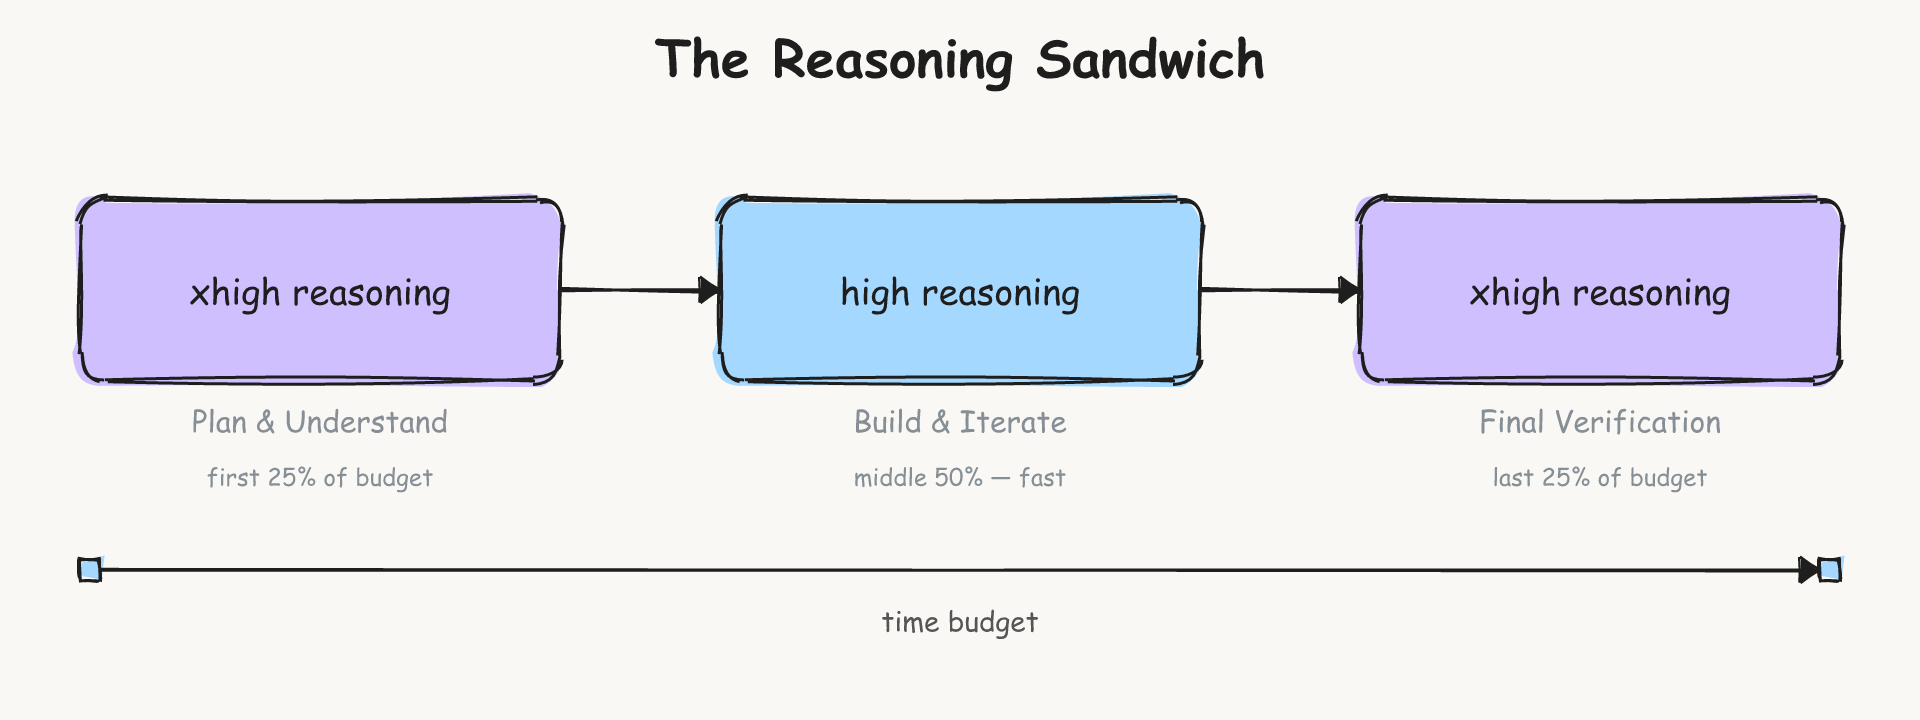
후기 단계 검증(Later stage verification) 또한 실수를 포착하고 솔루션을 제출하는 데 더 많은 추론으로부터 이점을 얻습니다. 휴리스틱으로서, 우리는 기준선으로 xhigh-high-xhigh의 “추론 샌드위치(reasoning sandwich)”를 선택했습니다.
계획 및 검증에 더 많은 추론 컴퓨팅 파워 할당하기
xhigh만으로 실행했을 때는 에이전트 타임아웃 때문에 53.9%로 낮은 점수를 기록했지만, high에서는 63.6%를 달성했습니다. 추론 예산 분할에 따른 시험 실행 간에 큰 차이가 없었기 때문에, 우리는 점수를 66.5%까지 끌어올린 우리의 접근 방식을 유지했습니다.
모델의 자연스러운 접근 방식은 **적응형 추론(Adaptive Reasoning)**이며, 이는 Claude와 Gemini 모델에서 볼 수 있는데, 모델이 추론에 얼마나 많은 컴퓨팅 파워를 사용할지 결정합니다.
다중 모델 하네스(multi-model harness)에서는 추론 예산을 균형 있게 사용하는 것이 계획을 위해 대규모 모델을 사용하고 구현을 위해 더 작은 모델로 작업을 넘기는 방식으로 나타날 수 있습니다.
에이전트 하네스 구축을 위한 실질적인 시사점
에이전트의 설계 공간은 큽니다. 다음은 우리의 실험과 전반적인 deepagents 구축에서 나온 몇 가지 일반 원칙입니다.
에이전트를 위한 컨텍스트 엔지니어링(Context Engineering)을 수행합니다. 오늘날 에이전트에게는 여전히 컨텍스트 조립 자체가 어렵습니다. 특히 새로운 환경에서는 더욱 그렇습니다. 디렉토리 구조, 사용 가능한 도구, 코딩 모범 사례, 문제 해결 전략과 같은 컨텍스트를 모델에 온보딩하는 것은 검색 오류 표면적(error surface)을 줄이고 계획 단계에서 발생할 수 있는 불필요한 오류를 방지하는 데 도움이 됩니다.에이전트가 자신의 작업을 자체 검증하도록 돕습니다. 모델은 자신이 생각하는 첫 번째 그럴듯한 해결책에 편향되는 경향이 있습니다. 테스트를 실행하고 해결책을 개선하도록 에이전트를 적극적으로 프롬프트하여 자신의 작업을 검증하게 하십시오. 이는 인간의 개입(human in the loop)이 없는 자율 코딩 시스템에서 특히 중요합니다.추적(Tracing)을 피드백 신호로 사용합니다. 추적은 에이전트가 스스로 평가하고 디버깅할 수 있게 합니다. 디버깅 도구와 추론 과정을 함께 처리하는 것이 중요합니다 (예: 모델이 특정 도구나 무언가를 수행하는 방법에 대한 지침이 부족하여 잘못된 경로로 진행되는 경우).단기적으로 나쁜 패턴을 감지하고 수정합니다. 오늘날의 모델들은 완벽하지 않습니다. 하네스 디자이너의 역할은 현재의 단점을 우회하면서도 미래에 더 똑똑한 모델을 계획하는 것입니다. 맹목적인 재시도나 작업 검증 누락이 좋은 예입니다. 이러한 가드레일(guardrails)은 시간이 지남에 따라 거의 사라지겠지만, 오늘날 견고한 에이전트 애플리케이션을 구축하기 위해서는 실험할 수 있는 유용한 도구들입니다.모델에 맞게 하네스를 조정합니다. The Codex와 Claude 프롬프팅 가이드는 모델마다 다른 프롬프트가 필요하다는 것을 보여줍니다. 이전 버전의 하네스로 테스트를 실행한 Claude Opus 4.6은 59.6%를 기록했는데, 이는 경쟁적이었지만 우리가 Claude와 동일한 개선 루프(Improvement Loop)를 실행하지 않았기 때문에 Codex보다 낮은 점수였습니다. 좋은 컨텍스트 준비나 검증에 중점을 두는 것과 같은 많은 원칙들이 일반화되지만, 작업 전반에 걸쳐 에이전트 성능을 극대화하려면 해당 작업을 위해 하네스 반복(harness iterations)을 몇 번 실행하는 것이 도움이 됩니다.
harness 설계에는 더 많은 개방형 연구가 필요합니다. 흥미로운 방향으로는 멀티모달 시스템(Codex, Gemini, Claude의 결합), 에이전트가 작업을 자율적으로 개선할 수 있도록 하는 지속적 학습을 위한 메모리 프리미티브, 그리고 모델 전반에 걸친 harness 변화 측정 등이 있습니다.
에이전트를 개선하는 외부 루프(outer loop)를 위해, 우리는 트레이스(traces)를 더 효율적으로 마이닝하기 위한 RLM과 같은 방법을 살펴보고 있습니다. 저희는 harness 개선 작업을 계속하고 연구 결과를 공개적으로 공유할 예정입니다.
커뮤니티와 공유하기 위해 저희가 Traces 데이터셋을 만들었습니다.
Deep Agents는 오픈 소스이며, Python 및 Javascript로 구현되었습니다.
더 많은 언덕 오르기(hill climbing)와 개방형 연구를 위해.
AI 자동 생성 콘텐츠
본 콘텐츠는 LangChain Blog의 원문을 AI가 자동으로 요약·번역·분석한 것입니다. 원 저작권은 원저작자에게 있으며, 정확한 내용은 반드시 원문을 확인해 주세요.
원문 바로가기