
Harness 내에서 모델 라우터 구축 방법
요약
본 글은 코딩 에이전트의 운영 비용 절감을 위해 효과적인 모델 라우터 구축 방법을 안내합니다. Open SWE를 예시로, 작업 유형별 트레이스 분석을 통해 LLM 분류기를 활용하여 요청을 레이블링하고, 이를 기반으로 저비용/고효율 모델 사용 전략을 수립했습니다.
핵심 포인트
- 모델 라우팅은 코딩 작업당 비용을 64% 절감하며 품질 변화가 적습니다.
- 라우터는 범용 게이트웨이보다 특정 도메인(harness) 내부에 있어야 합니다.
- 효과적인 설계는 관측 가능성(observability)과 평가(evals)에 기반해야 합니다.
핵심 요약
모든 작업에 최첨단 지능이 필요하지는 않습니다. 실험 결과, 모델 라우팅은 코딩 작업당 중앙값을 기준선 대비 64% 절감했으며, 품질에는 눈에 띄는 변화가 없었습니다.
효과적인 모델 라우터는 범용 게이트웨이가 아닌 harness 내부에 있어야 합니다. 올바른 모델을 선택하려면 harness가 이미 구성하는 도메인 및 작업 컨텍스트가 필요하며, 게이트웨이는 일반적으로 이를 갖추지 못합니다.
효과적인 라우터 설계는 관측 가능성(observability)과 평가(evals)에 뿌리를 두고 있습니다. 에이전트의 작업 공간 이해, 모델 성능 연구, 그리고 명확한 성공 기준을 요구합니다.
최첨단 LLM은 여전히 비용이 많이 듭니다. 에이전트가 보편화되고 대규모로 운영됨에 따라 이는 비용적으로 부담스러울 수 있습니다. 다행히도 대부분의 에이전트는 모든 작업에 최첨단 수준의 지능을 필요로 하지는 않습니다. Model labs에서도 이렇게 말합니다: Anthropic의 모델 선택 가이드에서는
최근 LangChain에서 월별 코딩 에이전트 지출 비용이 급격히 증가하는 고통을 느꼈습니다. 고객들로부터도 같은 우려를 들었기에, 저희는 오픈 소스 코딩 에이전트인 Open SWE를 위한 효과적인 모델 라우터(model router) 구축에 착수했습니다. 이전에는 항상 최고 수준의 프론티어 모델(frontier model)을 사용하던 기준 대비, 이 라우터를 적용하자 품질 변화가 측정되지 않았음에도 불구하고 스레드당 중간 비용(median cost per thread)을 64% 절감할 수 있었습니다. 본 게시물에서는 저희가 라우터를 어떻게 구축했는지, 무엇을 배웠는지, 그리고 여러분이 에이전트에 모델 라우팅을 구축하는 방법을 시작할 수 있도록 안내합니다.
1단계: 작업 이해하기
저희의 테스트 베드는 Open SWE였으며, 엔지니어들은 Slack과 웹 UI를 통해 이 도구를 사용하여 저희 코드베이스에 대한 질문을 하거나 코드 변경을 요청했습니다. 라우터를 구축하기 전에, 개발자들이 Open SWE를 어떤 종류의 작업에 사용하는지 이해해야 했습니다. 저희는 LangSmith 트레이스에서 스레드 수준 데이터를 추출했습니다. 여기에는 들어오는 요청 유형과 각 스레드의 비용 및 턴 수(복잡도의 근사 측정치)가 포함되었습니다. 이 탐색은 Open SWE 트레이스 위에 직접 구축된 작은 인터페이스를 사용하여 LangSmith Custom Apps에서 진행했습니다.
저희는 일주일간의 상호작용 스레드를 확보하여 LLM 분류기(LLM classifier)를 사용해 각각에 작업 유형을 레이블링했습니다. LangSmith Insights에서도 트레이스 전반에 걸쳐 이러한 종류의 그룹화를 수행할 수 있습니다. 코드 변경이 가장 지배적이었습니다: 새로운 기능(22%)과 버그 수정(17%)이 두 가지 가장 큰 그룹이었고, 테스트 또는 no-op 실행(16%)이 그 뒤를 이었습니다. 카테고리는 각 스레드의 제목 및 메타데이터를 기반으로 한 휴리스틱스입니다.
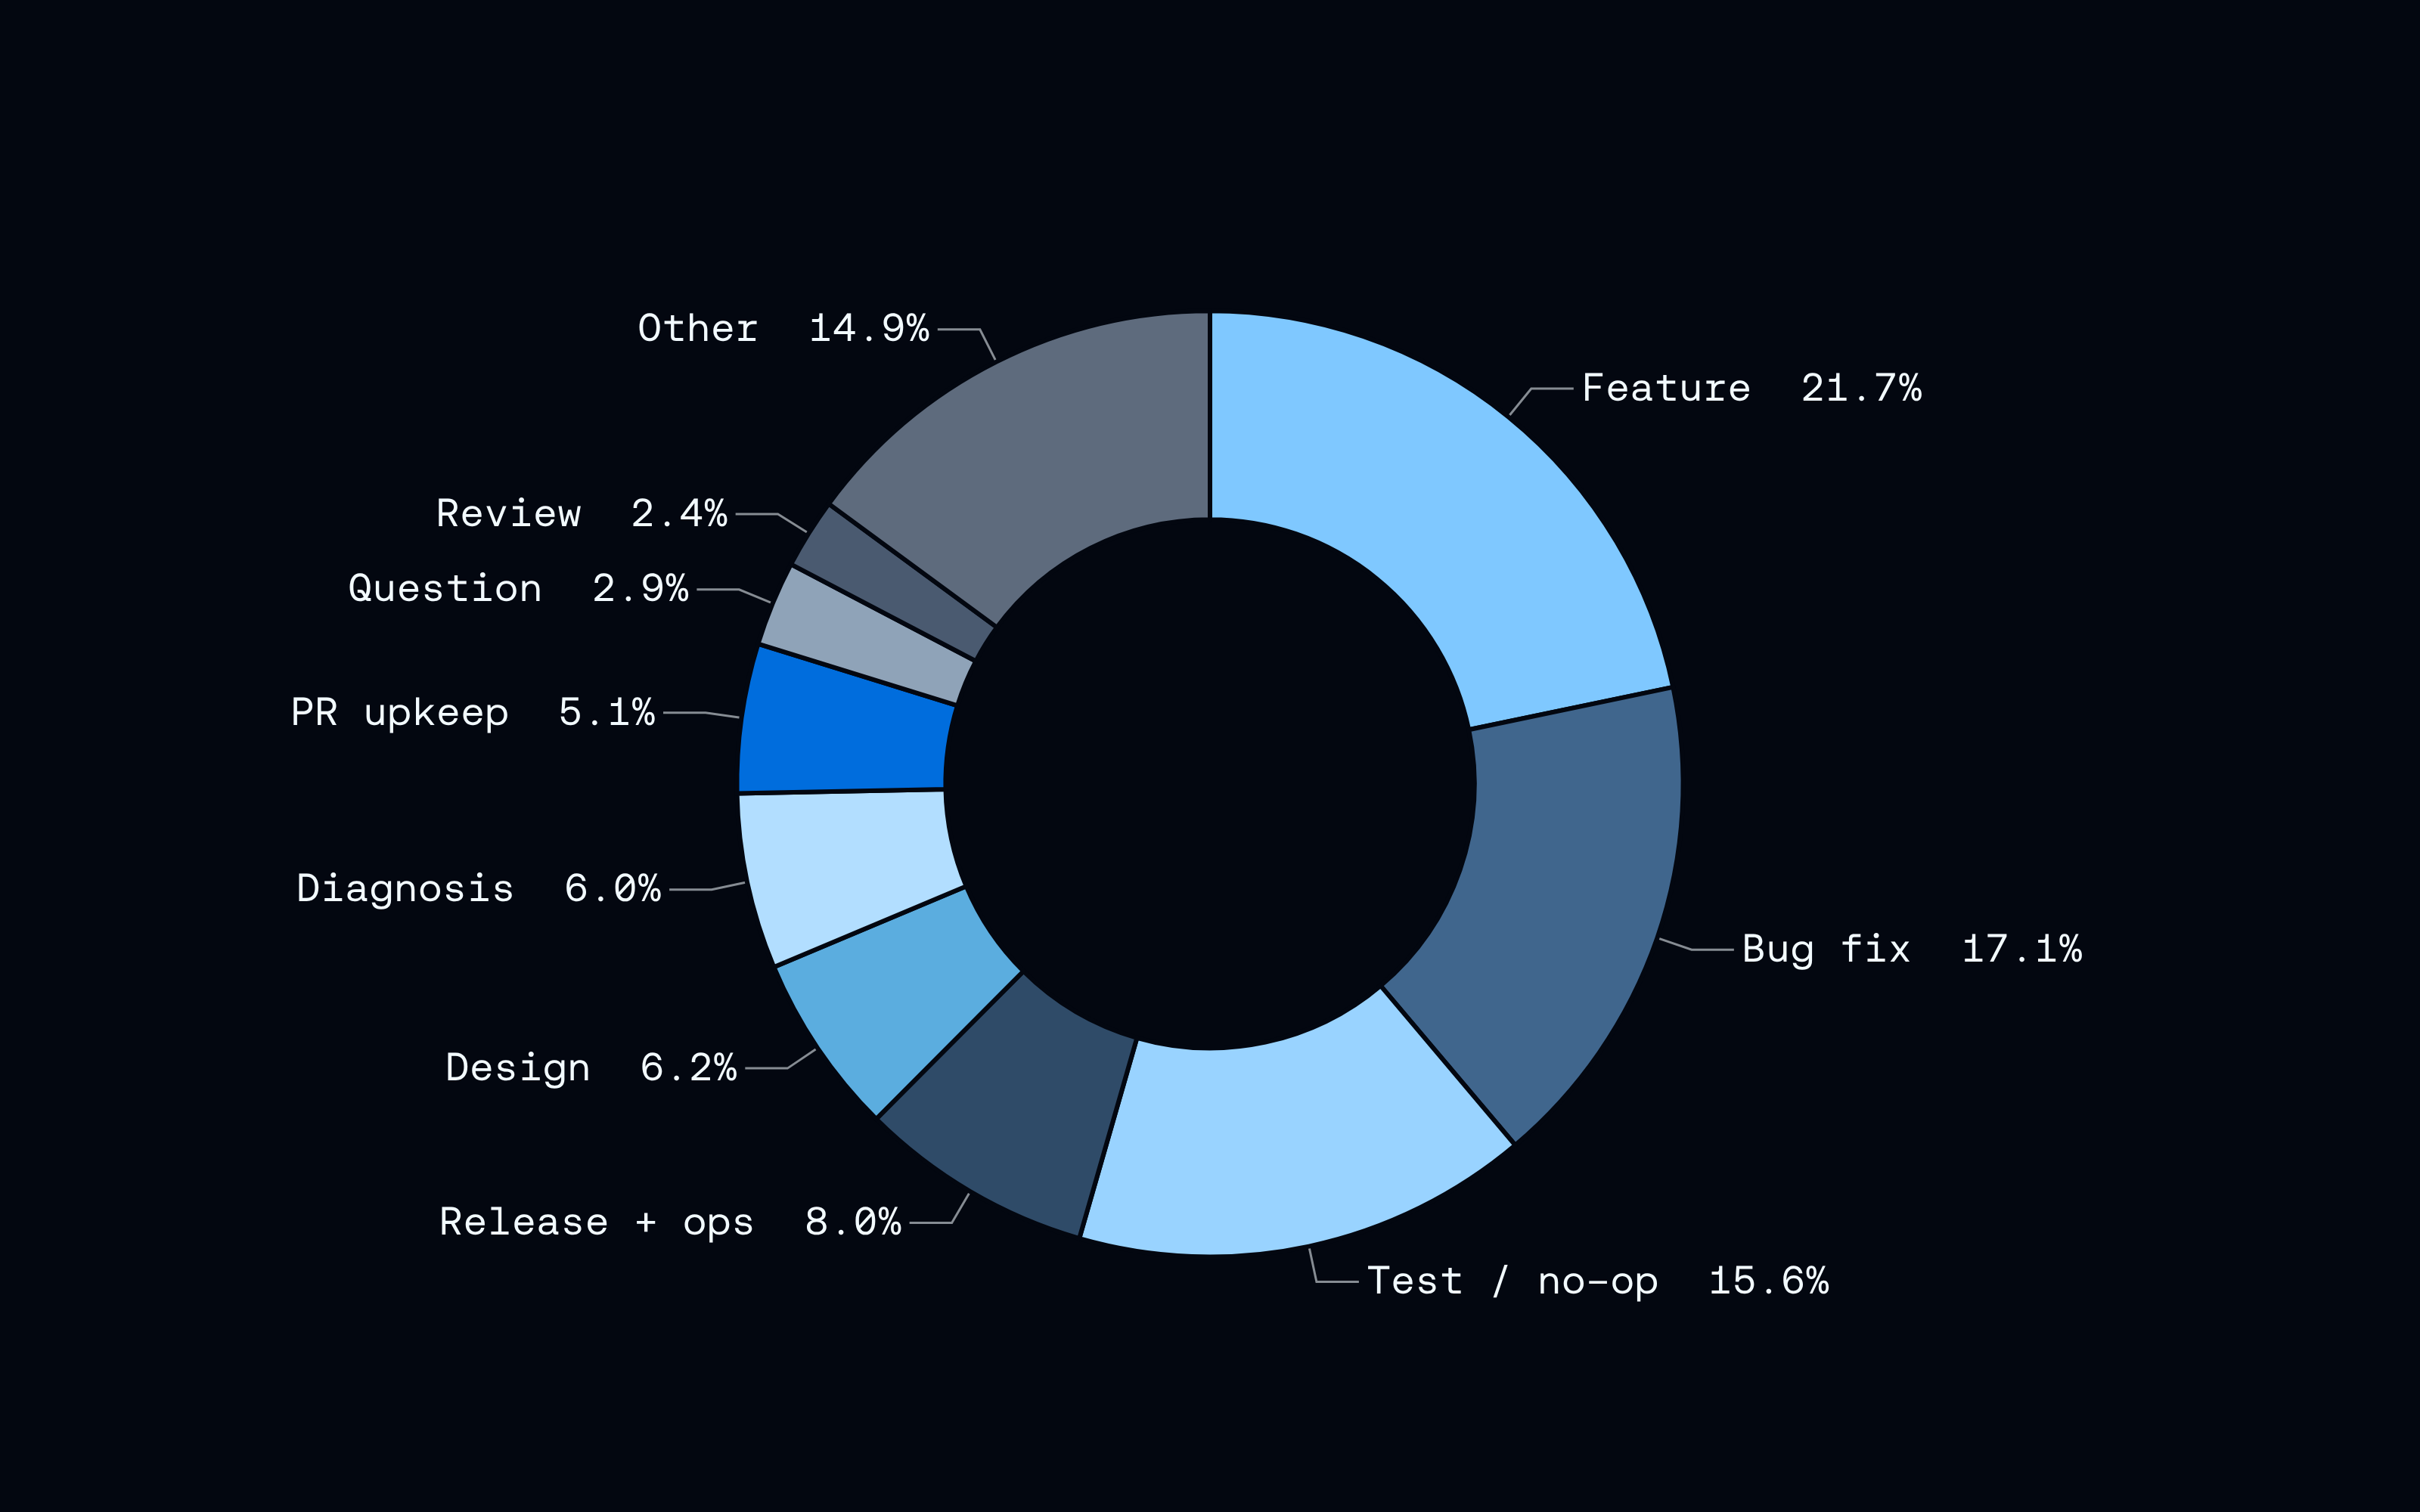
또한 작업 유형에 따라 에이전트 트레이스의 특성이 어떻게 다른지 조사했습니다. 저희는 기능 작업(feature work) 조사와 관련된 스레드가 더 길고, 비용과 중간 턴 수가 더 높다는 것을 발견했습니다. 테스트 및 출시 절차와 관련된 스레드는 비교적 짧고 저렴한 경향을 보였습니다.
‘복잡성(complexity)’을 판단하기 위해 총 비용(total cost)과 호출 횟수(invocation)를 모두 신호로 사용했습니다. 비용은 더 큰 작업이 더 많은 토큰을 사용하므로 복잡성을 비교적 직접적으로 추적하는 반면, 호출 횟수는 높은 수치가 더 어려운 작업을 의미할 수도 있고, 작업을 완료하기 위해 후속 조치(follow-ups)가 필요했던 모델을 의미할 수도 있어 더욱 미묘합니다.
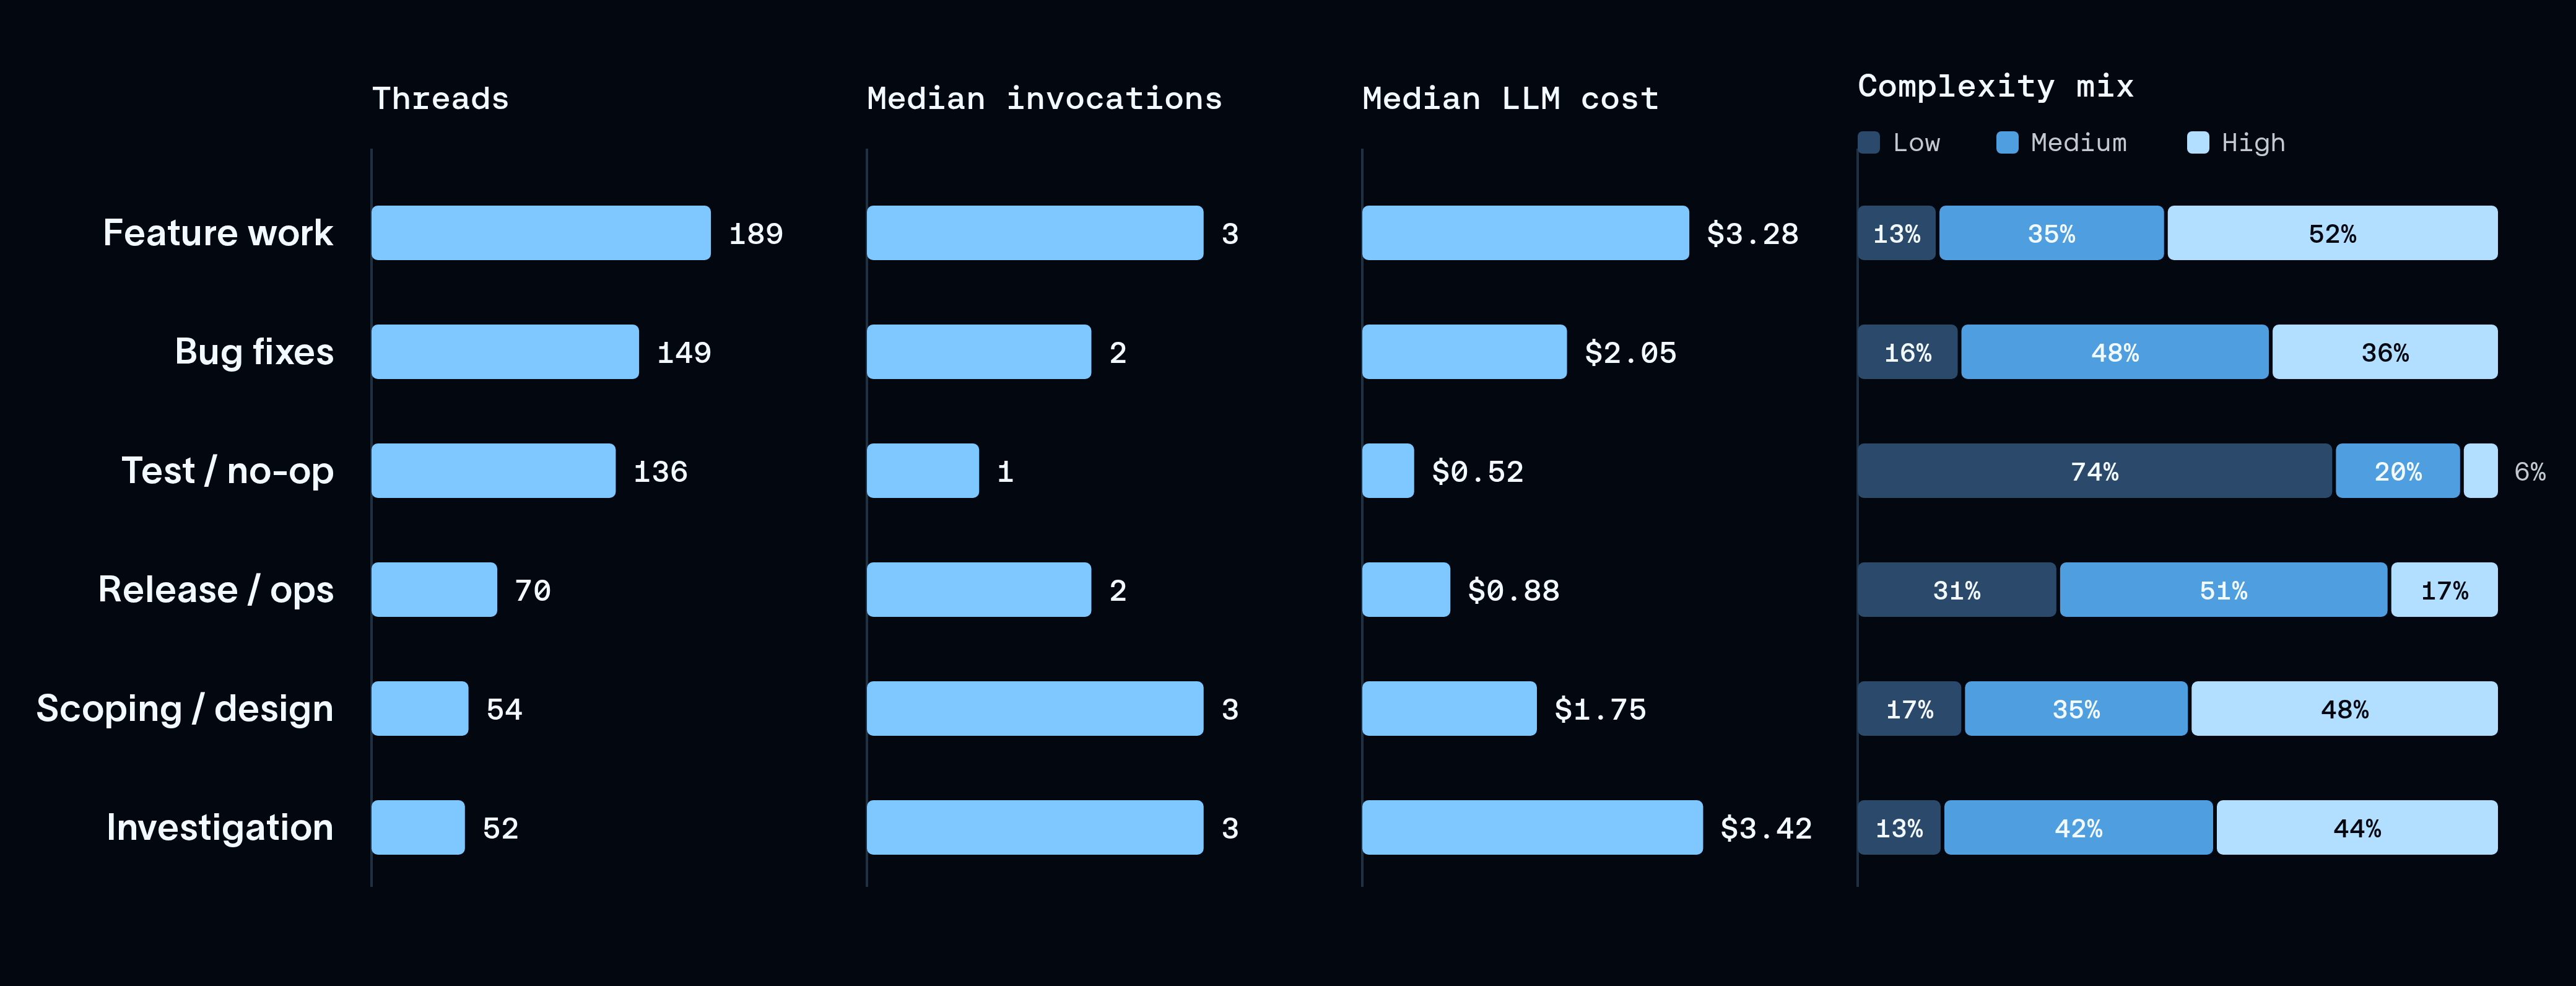
데이터를 수집하던 시점에 모든 Open SWE 스레드는 최고 수준의 프론티어 모델(frontier model)을 통해 라우팅되고 있었습니다. 위 데이터는 Open SWE가 처리한 많은 작업들이 복잡성의 범위로 볼 때, 반드시 프론티어 지능을 필요로 하지는 않았을 수 있음을 시사합니다.
이러한 작업 복잡성의 변화는 우리가 테스트할 가치가 있는 가설을 제공했습니다. 즉, 라우터가 초기 요청으로부터 작업의 유형과 난이도를 추론하여, 결과 품질 저하 없이 더 저렴하거나 빠른 모델로 전송할 수 있다는 것입니다.
2단계: 모델 이해하기
Artificial Analysis Intelligence Index는 공통된 일련의 작업을 통해 모델을 점수화하고 작업당 비용을 보고합니다. 따라서 모든 모델을 지능 대 비용이라는 하나의 곡선에 플롯할 수 있습니다. 파레토 프론티어(Pareto frontier)는 가장 저렴하면서도 가장 똑똑한 모델들의 집합입니다.
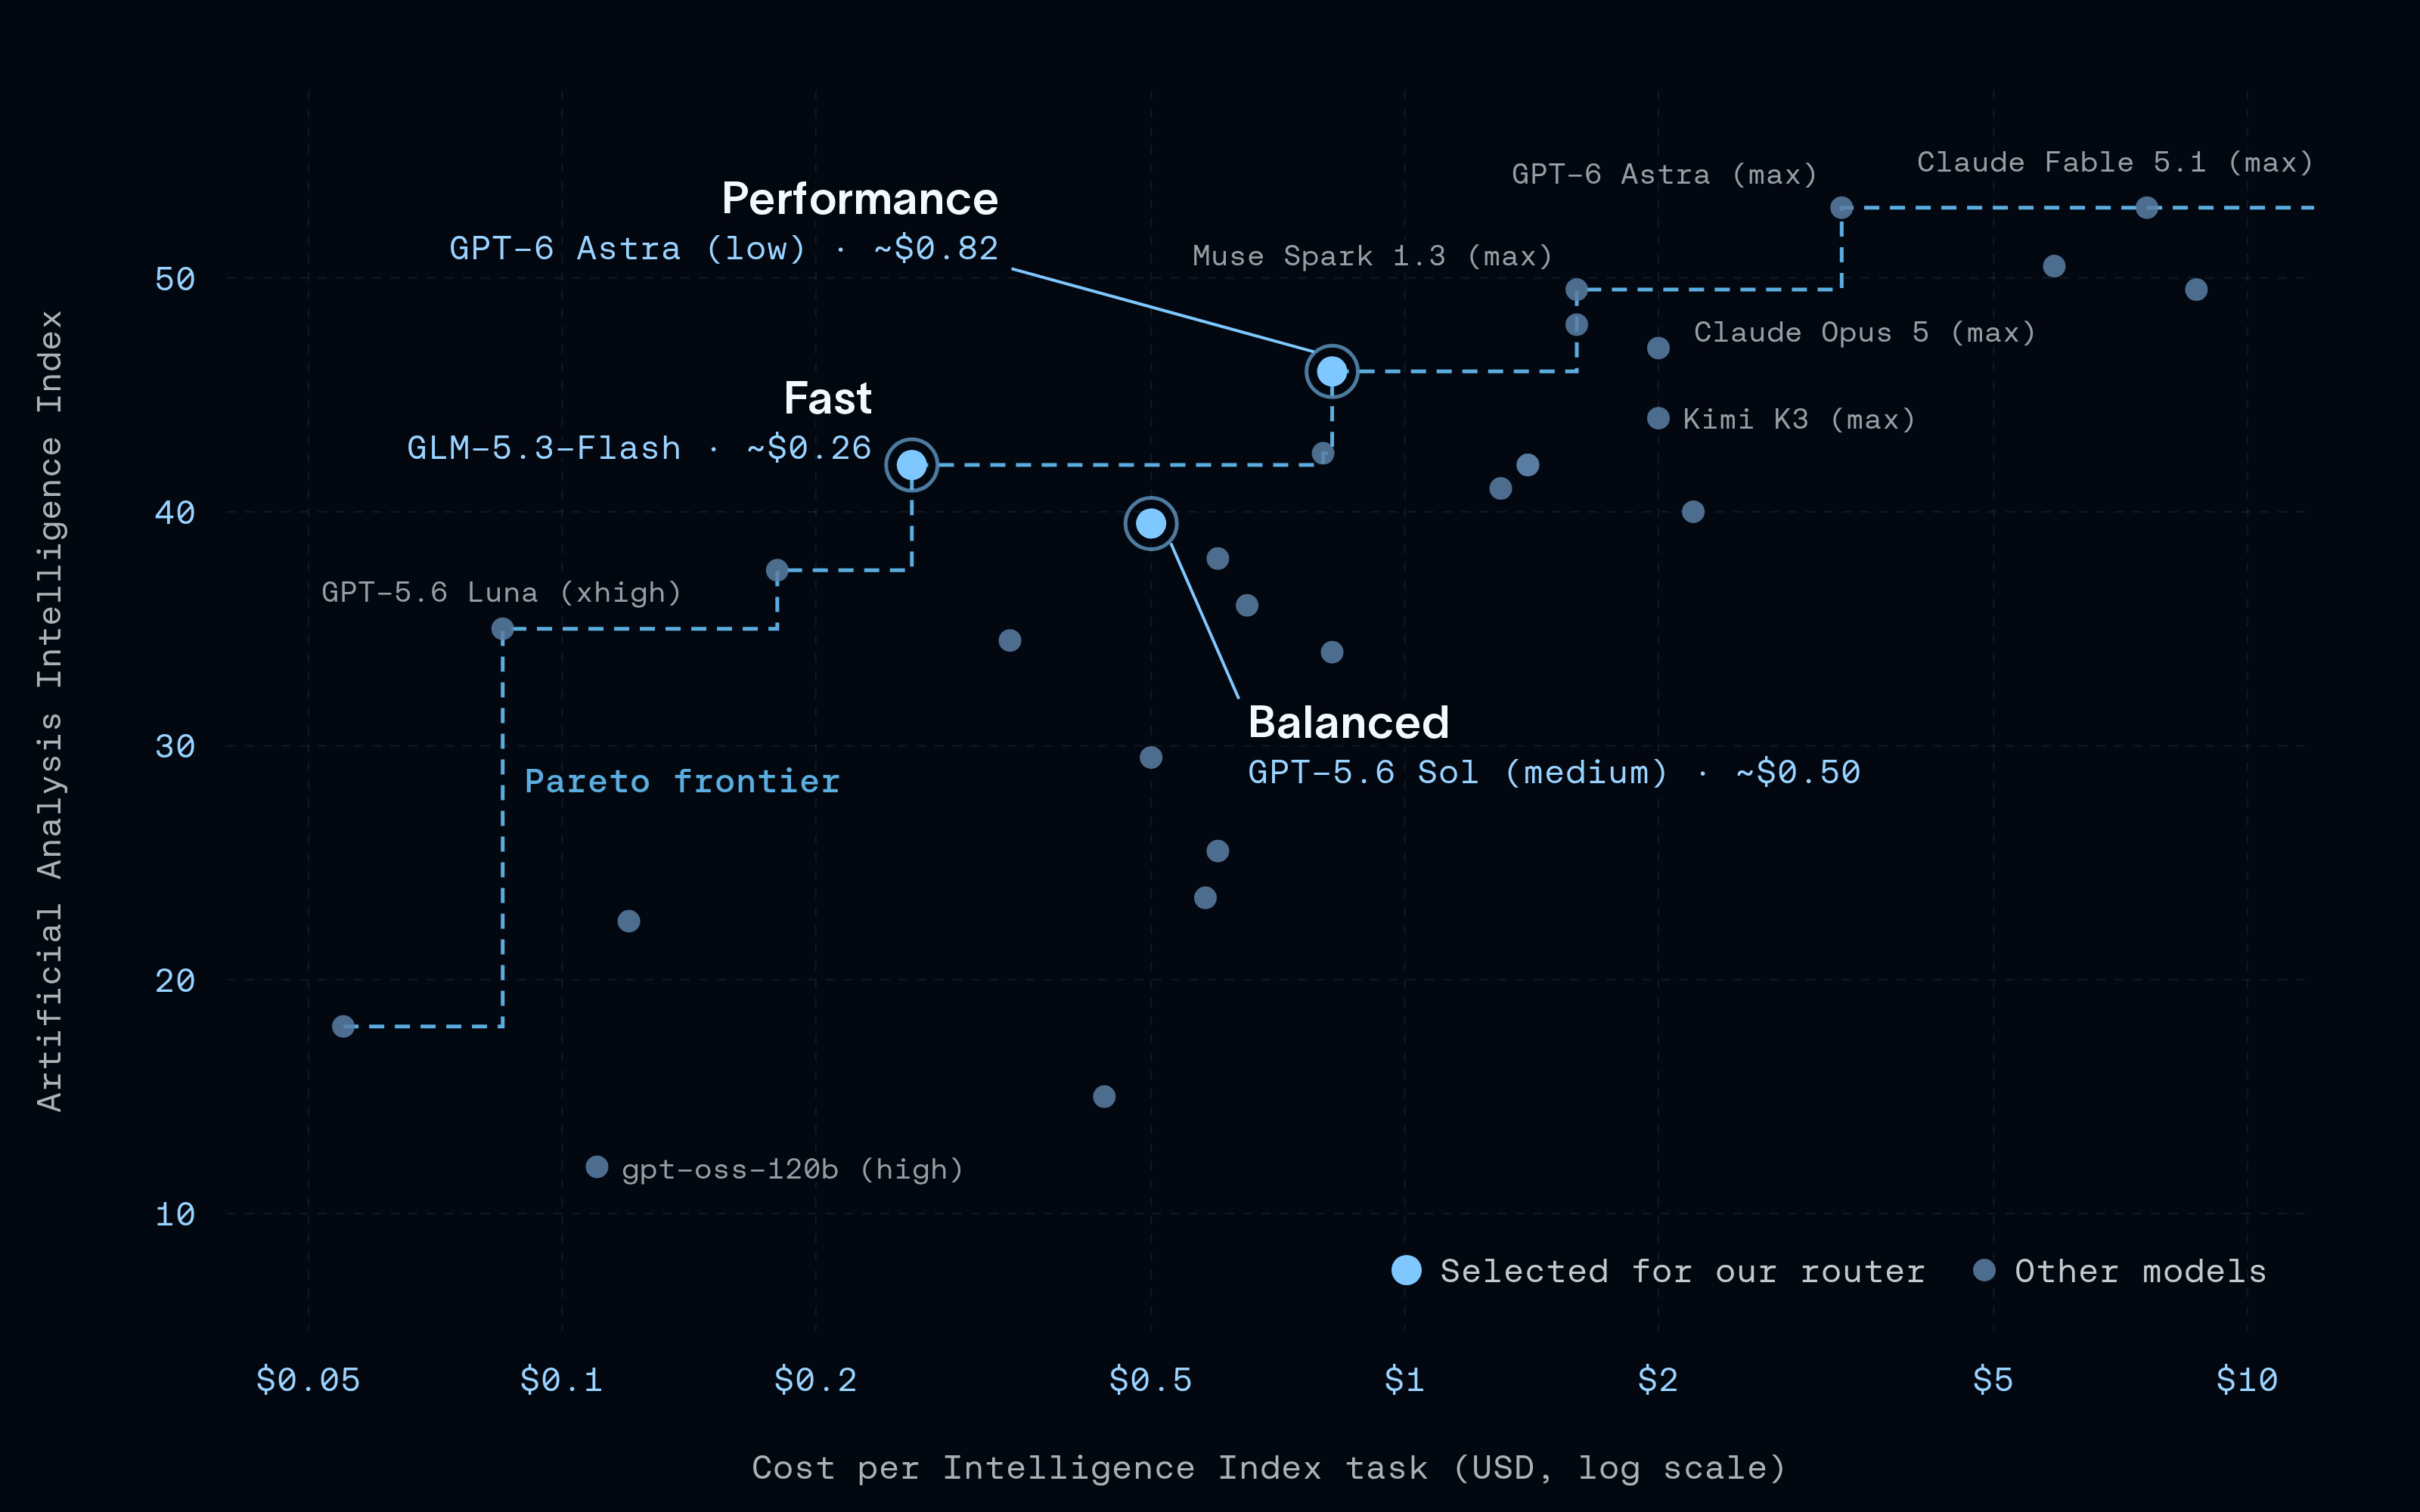
우리는 비용, 속도, 지능의 균형이 다른 세 가지 모델을 곡선을 따라 선택했습니다:
빠름(Fast): GLM-5.3-Flash (xhigh)
균형(Balanced): GPT-5.6 Sol (medium)
성능(Performance): GPT-6 Astra (low)
우리는 서로 다른 제공업체의 모델을 선택했으며, 빠른 등급은 오픈 모델입니다. GLM-5.3-Flash는 폐쇄형 모델 옆에 파레토 프론티어에 위치하며, 이는 오픈 모델이 임계점을 넘었다는 또 하나의 신호입니다. LangChain은 모델 비종속적(model agnostic)이며, 제공업체 전반에서 동일하게 작동하는 범용 모델 인터페이스를 가지고 있어, 더 나은 모델이 출시되면 라우터에서 한 줄의 변경만으로 교체가 가능합니다.
3단계: Harness에 라우터 구축하기
작업 혼합(task mix)이 매핑되고 세 가지 계층(tier)이 선택되면, 들어오는 각 요청을 읽고 이를 성공적으로 처리할 수 있는 가장 저렴한 계층에 전송하도록 작업을 모델과 연결해야 합니다. LangChain에서 이러한 결정은 미들웨어(middleware)에 자연스럽게 통합될 수 있으며, 이는 에이전트가 호출하는 모델을 다른 어떤 것도 변경하지 않고 교체할 수 있게 해줍니다 (동적 모델 선택 참조).
Open SWE의 라우터는 스레드의 첫 번째 사용자 메시지를 기반으로 작동합니다. 이 라우터는 세 부분으로 구성되어 있습니다:
기본 프롬프트(base prompt): 분류기에게 임무를 알려줍니다: 작업을 완료할 가능성이 가장 높은 가장 저렴한 모델을 선택하는 것입니다.계층별 기준(Criteria per tier): 각 계층이 담당해야 할 작업에 대한 짧고 평이한 언어 설명입니다.분류기 모델(A classifier model): 요청을 읽고 기준과 프롬프트에 따라 계층을 선택합니다.
일반적인 벤치마크는 단지 시작점일 뿐입니다. 각 계층의 기준은 두 가지 출처에서 작성해야 합니다: 자체 작업 분석, 그리고 각 제공업체가 자사의 모델이 가장 잘하는 것이 무엇인지 설명하는 내용입니다. 우리는 단계 1의 작업 분해와 GPT-5.6 Sol, GPT-6 Astra, GLM-5.3-Flash에 대한 제공업체 가이드를 결합하여 기본 프롬프트와 각 계층의 기준을 작성했습니다.
이러한 기준은 Open SWE의 작업 세트를 위해 작성되었기 때문에 라우터는 Open SWE가 처리하는 작업과 깊게 연결되어 있습니다. 그래서 이는 하네스(harness)에 속해야 하며, 하네스는 일반적인 게이트웨이가 갖지 못하는 에이전트의 작업별 컨텍스트(프롬프트, 도구 및 도메인 지식)를 이미 가지고 있기 때문입니다.
우리의 첫 번째 버전은 사용자 요청으로 프롬프트를 받은 구조화된 출력을 가진 LLM을 사용했습니다. 분류기는 이제 새로 출시된 결정 모델인 Jev에서 실행되며, 이로 인해 분류 속도가 거의 50배 빨라졌습니다. Jev를 이용한 하네스 구축에서 이를 확인해 보세요.
라우터는 각 스레드의 시작 시점에 한 번 모델을 선택하며, 그 모델은 전체 스레드에 사용됩니다. 자연스러운 반론은 다음과 같습니다: 만약 스레드가 진행 중에 주제나 복잡도가 변경되면 어떻게 될까요? 이 단순한 라우터 설계에서는 다루지 않았지만, 아래 “다음 단계(what’s next)” 섹션에서 도중에 이루어지는 라우팅을 다룹니다.
4단계: 작업 결과 추적
라우터의 가치는 비용 절감에 있지만, 품질이 저하되지 않는다는 전제가 붙습니다. 라우터는 두 가지를 정확하게 처리해야 합니다. 첫째, 선택된 모델이 작업을 완료할 수 있어야 하며, 둘째, 그중 가장 저렴하고 빠른 모델이어야 합니다. 이는 작업 결과를 추적하는 방법이 필요하다는 것을 의미합니다. 이를 수행하는 방법은 두 가지가 있습니다:
- 오프라인 평가 (Offline evals): 라우터가 고정된 데이터셋을 대상으로 실행되므로, 버전을 안전하고 반복적으로 비교할 수 있습니다. 문제는 이 데이터셋입니다. 실제 트래픽과 유사해야 하며 사용자가 중요하게 생각하는 지표로 채점되어야 합니다. 코딩 에이전트의 경우, 이는 PR(Pull Request) 품질 및 검토 용이성을 의미하는데, 이를 오프라인에서 평가하기는 어렵습니다.
- A/B 테스트 (A/B test): 라이브 스레드를 라우터와 단일 모델 기준선(single-model baseline) 간에 분할하고, 모든 스레드에 대해 측정 가능한 성공 지표로 비교합니다. 실제 트래픽은 자연스럽게 대표적인 데이터셋이지만, 단점은 사용자가 잠재적으로 최적이 아닌 라우터의 영향을 받는다는 것입니다.
저희는 두 가지 결과 신호(outcome signals)를 사용하여 A/B 테스트를 진행했습니다:
병합된 PR (Merged PRs): Open SWE는 이제 열리는 모든 PR과 그것이 병합되었는지 닫혔는지를 기록합니다. 스레드당 병합된 PR 비율이 주요 성공 지표가 되었습니다.
사용자 피드백 (User feedback): 저희는 Open SWE에 좋아요(thumbs up)와 싫어요(thumbs down) 기능을 추가하여, PR을 생성하지 않는 질문을 포함한 모든 스레드를 사용자가 평가할 수 있게 했습니다. 각 평가는 해당 스레드의 LangSmith 트레이스에 대한 피드백으로 기록됩니다.
저희는 이 두 가지를 모두 LangSmith Custom App에서 추적했습니다. 병합된 PR이 더 강력한 신호였습니다. 피드백은 적었습니다. 왜냐하면 소수의 스레드만 평가되었기 때문이지만, 여기서 첫 번째 테스트 아래 인용된 것과 같은 라우팅 실수를 알게 되었습니다.
실험 (The experiment)
저희의 첫 A/B 테스트는 라우터를 항상 가장 강력한 모델을 사용하는 방식과 비교했습니다. 전체 973개 스레드 중 절반은 라우터를 거쳤고, 나머지 절반은 항상 GPT-6 Astra를 사용했습니다.
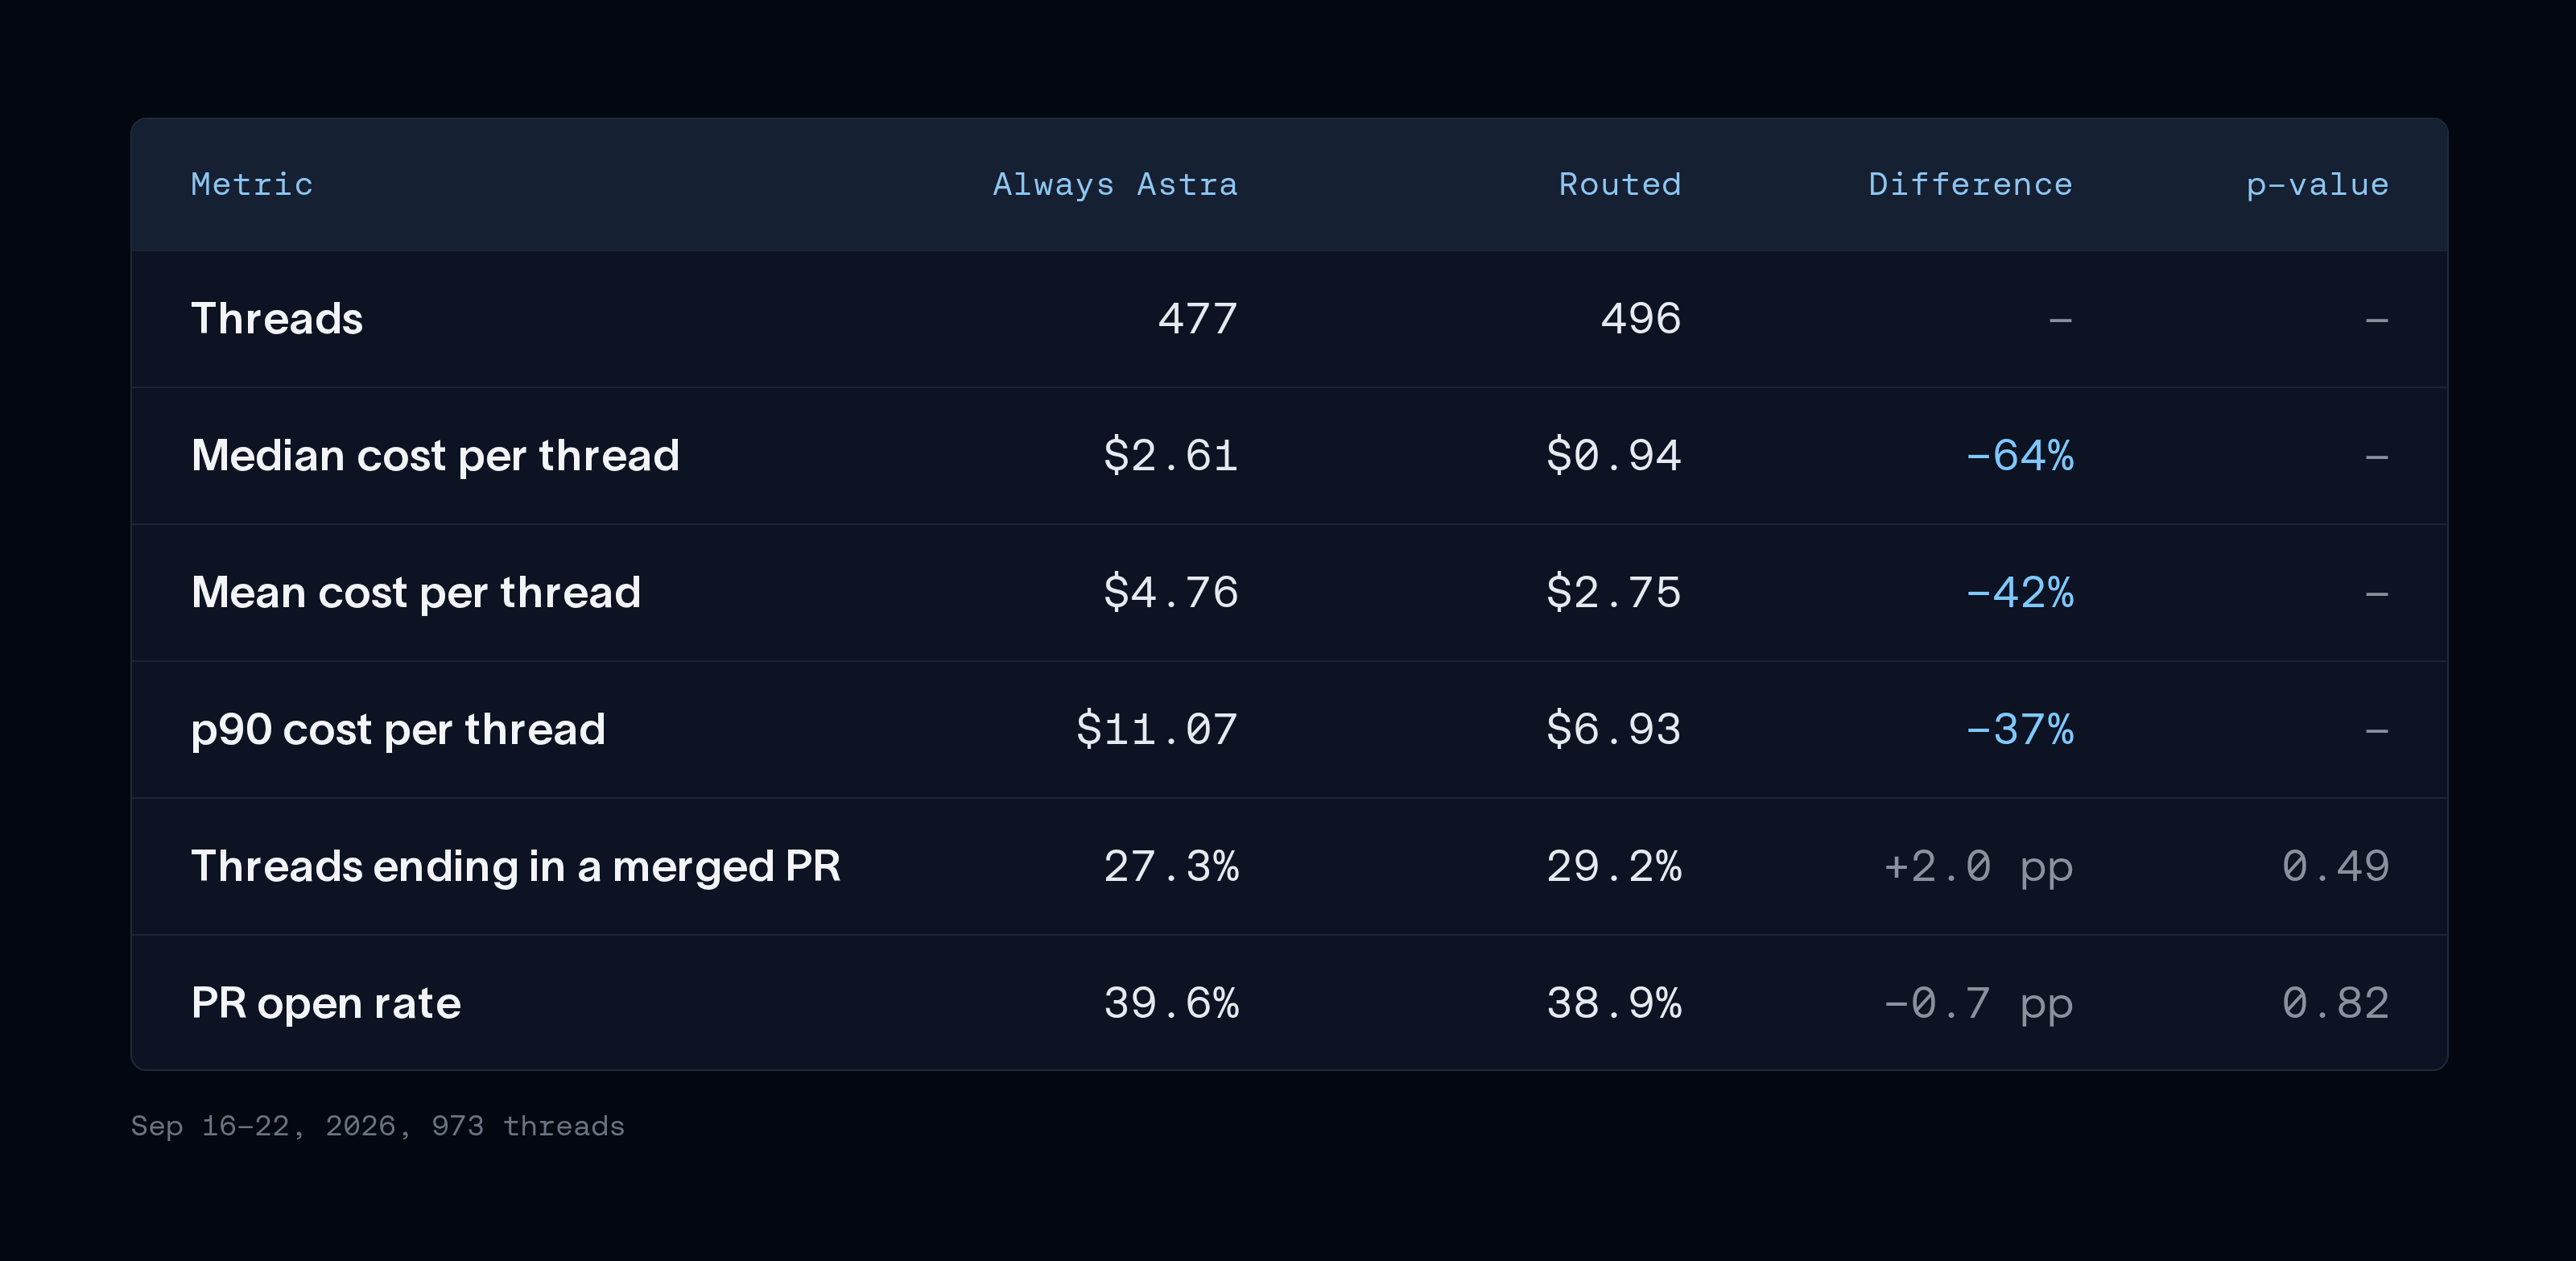
품질에는 측정 가능한 변화가 없었습니다. 라우터가 적용된 스레드의 29.2%가 병합된 PR로 끝난 것에 비해, 대조군(control)은 27.3%였습니다 (p = 0.49). PR 개설률 역시 평탄했습니다 (38.9% 대 39.6%, p = 0.82).
모델 라우팅을 통한 AI 요청 비용 절감 효과 분석
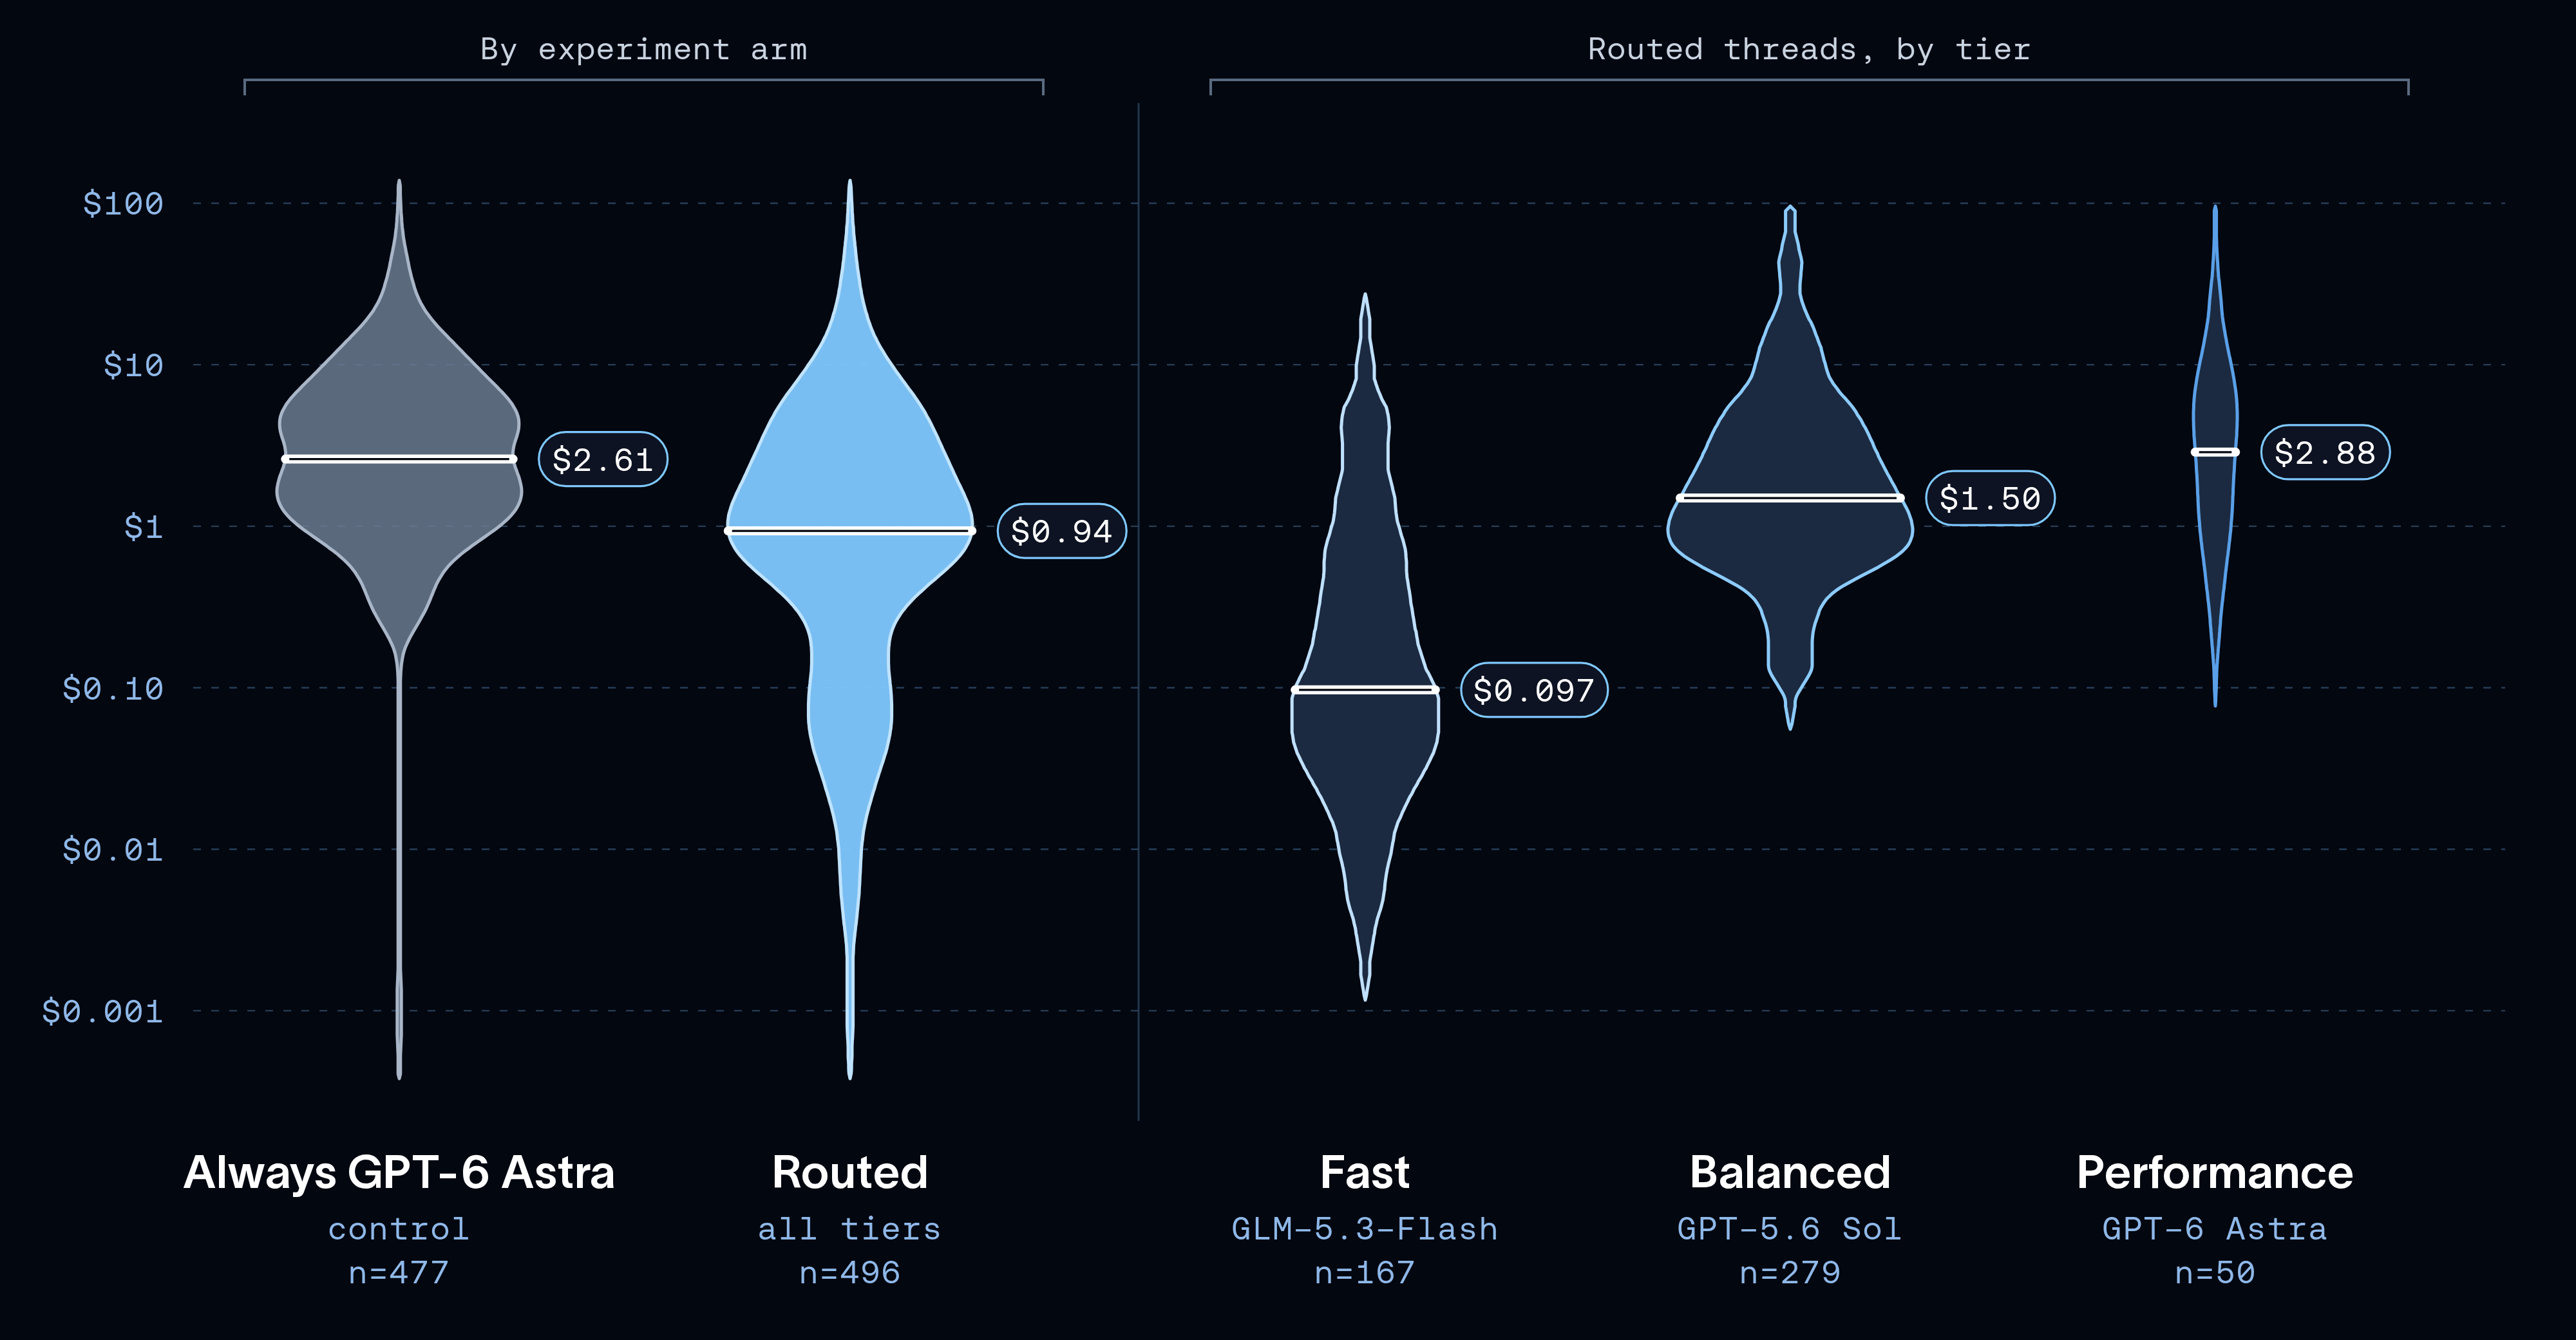
비용이 크게 하락했습니다. 중앙값(median) 처리 스레드 비용은 대조군(control)의 $2.61 대비 $0.94로 64% 감소했습니다. 평균(mean)은 42% 하락했고 p90 역시 37% 하락했기 때문에, 절감액이 단순히 몇몇 저렴한 이상치 때문만은 아니었습니다.
대부분의 요청은 가장 강력한 모델을 필요로 하지 않았습니다. 라우팅된 스레드 중 56%가 '균형(balanced)' 모델에, 34%가 '빠른(fast)' 모델에 사용되었으며, '성능(performance)' 모델에는 단지 10%만 사용되었습니다. 등급별 스레드 비용 격차는 매우 커서 중앙값은 빠른 모델에서 $0.097, 균형 모델에서 $1.50, 성능 모델에서 $2.88을 기록하며 30배의 차이를 보였습니다.
사용자 피드백도 같은 방향을 가리켰습니다. 간단한 요청이 GPT-6 Astra로 실행되었을 때, 엔지니어들은 "이 쿼리에 비해 상당히 비싸다(pretty expensive for this query)" 또는 "이 요청은 성능 모델로 라우팅되어서는 안 되었다(this request should not have been routed to the performance model.)"와 같은 코멘트를 직접 언급하며 과도한 지출을 지적했습니다.
💡 이 결과는 대조군 자체가 가장 비싼 모델이었기 때문에 놀랍지 않습니다. 하지만 이는 많은 에이전트들이 혜택을 볼 수 있는 변화입니다. 즉, 많은 에이전트들이 품질에 지나치게 의존하여 결국 과도하게 비용을 지출하는 경향이 있기 때문입니다. 특히 다양한 작업을 수행하는 에이전트의 경우, 라우팅 기능을 통해 비용을 낮출 수 있습니다.
또한 우리는 이 라우터(router)를 반대되는 대조군과 비교 테스트했습니다. 즉, 스레드의 절반은 라우터를 거치고 나머지 절반은 항상 빠른 모델을 사용하도록 했습니다. 이 테스트는 통계적으로 의미 있는 결과를 도출하기 전에 하루 만에 종료되었습니다. 엔지니어들은 '빠른 모델만 사용하는 그룹(fast-only arm)'에서 거의 즉시 문제점을 지적했으며, 낮은 출력 품질 때문에 생산성을 저해했습니다.
다음 단계 (What's next)
이러한 모델 라우터 구현은 최적의 라우터를 구축하기 위한 기반을 제공하는 개념 증명(proof of concept)입니다. 개선할 수 있는 몇 가지 영역은 다음과 같습니다:
DeepSWE나 다른 코딩 벤치마크에서 라우터를 벤치마킹하여, 프로덕션 트래픽에 대한 A/B 테스트에만 의존하는 대신 통제된 기준선(controlled baseline)을 기반으로 라우팅 결정을 평가할 수 있습니다.서브 에이전트용 모델 선택. 현재 서브 에이전트는 라우터와 독립적으로 자체 모델을 선택합니다. 서브 에이전트를 위한 라우팅도, 특히 장시간 실행되는 작업의 경우, 비용을 더욱 절감할 수 있습니다.스레드 중간 재라우팅. 새로운 메시지가 이전 메시지와 충분히 다를 때(예: 질문이 버그 수정으로 바뀌는 경우), 모델 변경이 효과적일 수 있습니다. 여기서 발생하는 비용은 프롬프트 캐시입니다. 모델을 전환하면 캐시가 사라지므로, 새 모델은 스레드를 전체 비용으로 다시 읽어야 합니다. TTL(Time To Live)이 짧아(예: 5분) 인간의 차례 사이에 캐시가 만료되는 경우가 많기 때문에 비동기 에이전트의 경우 이 비용은 종종 무시할 수 있습니다.추적 기록에서 사용자 감정 분석과 같은 더 많은 신호로 라우팅 기준 정교화: 사용자가 좌절하는 스레드를 찾아내어, 해당 작업에 더 강력한 모델이 필요했음을 의미할 수 있습니다.## 시작하기**당신 자신의 에이전트에 라우팅을 추가한다면, 다음부터 시작하면 됩니다:
AI 자동 생성 콘텐츠
본 콘텐츠는 LangChain Blog의 원문을 AI가 자동으로 요약·번역·분석한 것입니다. 원 저작권은 원저작자에게 있으며, 정확한 내용은 반드시 원문을 확인해 주세요.
원문 바로가기