Google이 더 광범위한 AI 추론 작업을 위해 TPU 가속기를 재가동하다
때로는 새로운 칩이 필요할 때도 있고, 때로는 가지고 있는 칩들을 현재의 워크로드에 더 잘 맞게 구성하는 새로운 방법이 필요할 때도 있습니다. 구글 역시 자사의 클라우드 서비스와 어쩌면 자체 데이터센터에서 사용할 수 있는 소수의 직접 고객들에게까지, Google의 자체 개발 컴퓨팅 엔진을 기반으로 한 두 가지 새로운 TPU 가속기를 내년에 출시할 예정입니다.
구체적으로 말하자면, 올해 4월에 처음 공개된 “Sunfish” TPU 8t와 “Zebrafish” TPU 8i라는 두 가지 새로운 변형의 가속기가 있습니다. TPU 8t는 Broadcom의 칩 관리 부서의 요청으로 제작되었으며 현재 Google 데이터센터에 도입될 것으로 예상됩니다. 반면, TPU 8i는 MediaTek이 관리하고 있으며, 올해 초 일부 지연을 겪었습니다. 이것이 지금 Google로 출하되는지 여부는 불분명합니다. 이 Sunfish 및 Zebrafish 시스템의 수정된 버전들은 2027년 중 어느 시점에 설치될 것으로 예상되며, 우리는 낙관적으로 이를 2027년 1분기(Q1 2027)에 시작하여 향후 1년 반 동안 점진적으로 진행되어 전 세계 여러 Google Cloud 리전에서 기기가 사용 가능해질 것이라고 예측하고 있습니다. 이러한 증설에는 시간이 걸립니다.
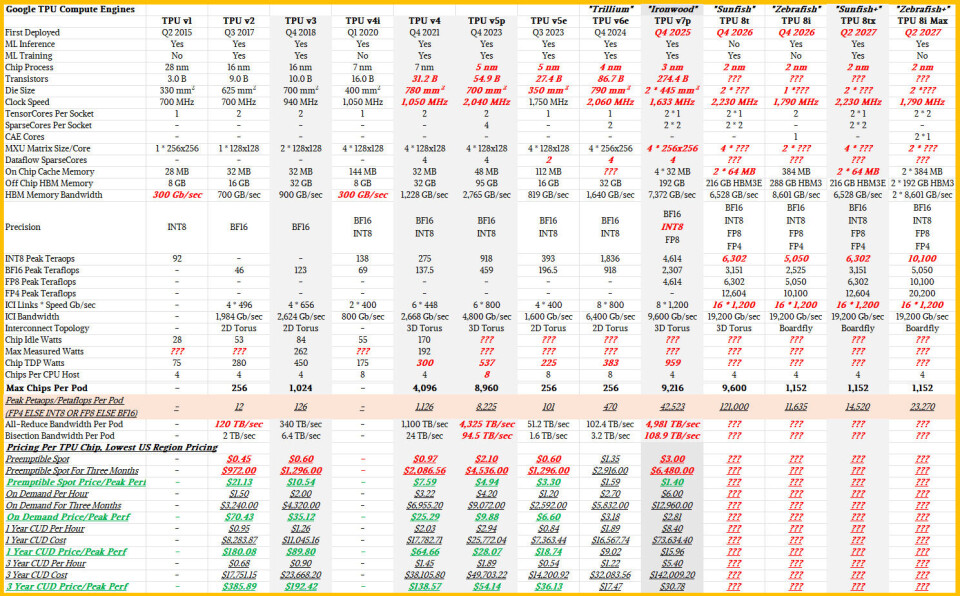
예를 들어, 지난 4월 Sunfish와 Zebrafish 발표 사이의 기간 동안, Google은 이전 세대 모델인 “Ironwood” TPU v7p 가속기를 출시했습니다. 이 가속기는 회사 내부 사용을 위해 2025년 4분기(Q4 2025)에 처음 배포되었으며, 이후 Iowa의 US-Central1 리전과 London 외곽의 Europe-West2 리전에 Google Cloud를 통해 가격이 책정되었습니다. 아래 제가 준비한 TPU 표에는 이 업데이트된 가격이 포함되어 있습니다. 충분한 여분의 Ironwood 용량이 확보되어 Google이 클라우드에서 임대할 수 있게 되기까지는 약 1년이 걸렸습니다.
새로운 Sunfish 및 Zebrafish 시스템에 대해 자세히 살펴보겠습니다.
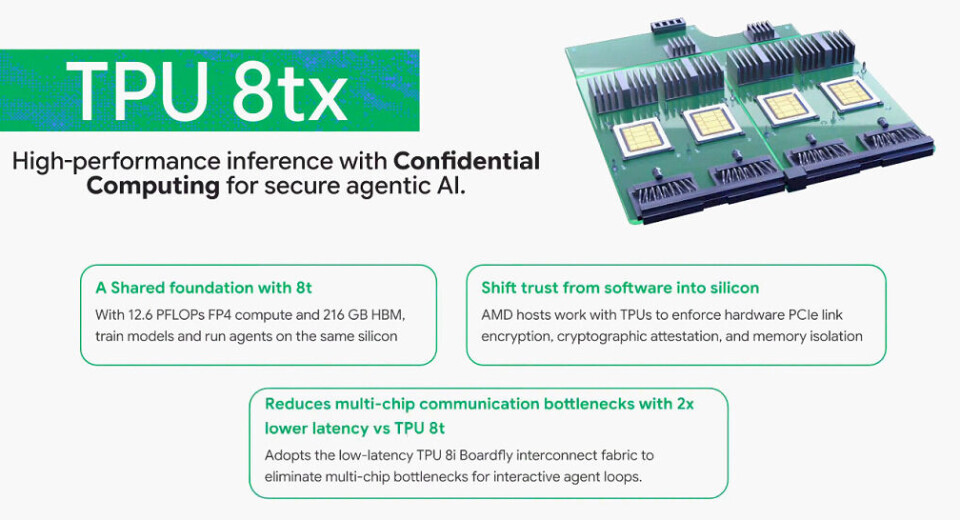
TPU 8t는 AI 학습 워크로드(AI training workloads)를 실행하도록 명시적으로 설계되었으며, 공유 일관 메모리 공간(shared coherent memory space)에 걸쳐 9,600개의 가속기를 지원하는 Google의 3D 토러스 인터커넥트(3D torus interconnect)를 지원합니다. 이는 FP4 정밀도에서 놀라운 121 exaflops의 성능을 제공합니다. 각 Sunfish 8i 장치는 여섯 개의 스택에 걸쳐 216 GB의 HBM3E 메모리를 갖추고 있습니다. 이는 AI 분야에서 단연코 가장 큰 공유 메모리 컴퓨팅 발자국(shared memory computing footprint)이며, Google이 Gemini 프론티어 모델을 학습시키기 위해 Broadcom과 파트너 칩 공장인 Taiwan Semiconductor Manufacturing Co로부터 가능한 한 많은 TPU 8t 가속기를 확보하기를 원한다는 것은 분명합니다.
새로운 TPU 머신에 대해 논의하는 컨퍼런스 콜에서 Google의 AI 및 컴퓨팅 인프라 부문 부사장 겸 총괄 매니저인 Mark Lohmeyer는 이 머신들이 9,600개 유닛의 포드(pods)로 구성되며, 이를 결합하여 1백만 개 이상의 TPU 8t 장치 클러스터를 생성한다고 말했습니다. 그리고 이러한 클러스터가 실제로 개발이 다소 지연되어 회사에 어느 정도 부담을 주었던 Gemini 4 Carbon 프론티어 모델을 학습시키는 데 사용되었다고 밝혔습니다. DeepMind 부문에서 개발된 Gemini 4 Carbon은 10월 28일에 발표되었습니다. Carbon 모델은 Gemini 4 Argon보다 몇 주 후에 제공되었으며, 전반적으로 더 우수합니다. Google Cloud를 통한 API 액세스의 경우, 두 모델 모두 입력 토큰당 $2, 출력 토큰당 $10의 '도입 가격(introductory price)'을 가지며, 캐시된 입력 토큰은 입력 토큰 가격 대비 95% 할인됩니다.
TPU 8tx는 추론 워크로드(inference workloads)에 초점을 맞춘 TPU 8t의 특수 변형체입니다(유휴 시간 동안에도 여전히 학습을 수행할 수 있음). 이 모델은 두 가지 주요 변경 사항이 있습니다. 첫 번째는 TPU 8t의 3D 토러스 인터커넥트(interconnect)가 보드플라이(boardfly, dragonfly의 변형체) 인터커넥트로 교체되었다는 것입니다. 이는 구글이 개발한 것으로, 추론 워크로드에 더 적합하도록 설계되었으며, 특히 여러 추론 스트림이 동시에 실행되는 복잡한 에이전트 워크로드(agentic workloads)에 최적화되었습니다. 따라서 포드 크기는 9,600개의 가속기에서 1,152개로 감소합니다. 패브릭의 직경이 8.3배 작아졌기 때문에 네트워크가 더 평평해지며, 보드플라이 토폴로지(boardfly topology)를 기반으로 하는 이 작은 시스템(여전히 독점적인 인터칩 인터커넥트(Inter Chip Interconnect), 즉 ICI를 사용함)의 평균 지연 시간은 3D 토러스 토폴로지의 절반 정도입니다.
TPU 8tx의 또 다른 변경 사항은 구글이 자체 개발한 Axion Arm 서버 CPU를 제거하고 이름 없는 AMD Epyc 프로세서로 교체한다는 것입니다. 이러한 전환은 AMD 프로세서가 온보드 루트 오브 트러스트(root of trust)와 암호화 가속기(encryption accelerators)를 가지고 있기 때문입니다. 이를 통해 TPU 8tx 아이언(iron)에서 실행되는 워크로드는 사용되는 지점까지 암호화 상태를 유지할 수 있으며, TPU 처리가 완료된 후에는 다시 재암호화됩니다. 구글은 이것이 맞춤형 Arm Epyc 부품이라고 시사했지만, 실제로는 코어 개수나 클럭 속도에 관한 것일 수 있습니다. 이는 현재의 “Turin” Epyc 9005이거나 곧 출시될 “Venice” Epyc 9006 프로세서일 수 있습니다. 구글은 자체 암호화 및 보안 프로세서를 보유하고 있는데, 왜 이 기능이 이미 TPU 아키텍처와 Axion 프로세서에 내장되어 있지 않은지 의문입니다. 저는 TPU 9 제품군과 차세대 Axion CPU에서는 그렇게 될 것이라고 예상하며, 따라서 이는 AMD에게 단기적인 승리가 될 수 있습니다.
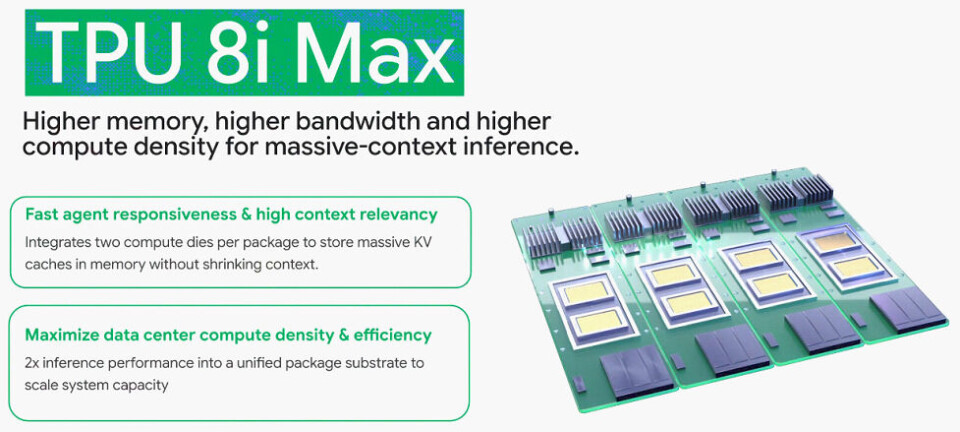
TPU 8i Max를 통해 Google은 더 큰 컨텍스트(context) AI 추론 워크로드에 초점을 맞추고 있으며, 이를 처리하기 위해 소켓당 Zebrafish 가속기 복합체 수를 두 배로 늘리고 있습니다. 하지만, 소켓당 HBM 메모리 용량 증가는 4월에 발표된 오리지널 TPU 8i와 비교했을 때 단지 33% 증가에 그쳤습니다.
더 정확히 말하자면, 칩 레벨에서 오리지널 Zebrafish 8i 칩은 총 용량 288GB와 집계 대역폭(aggregate bandwidth) 8.6TB/sec을 가진 HBM3 스택 8개(더 높은 대역폭의 HBM3E가 아님)를 가지고 있었습니다. TPU 8i Max에서는 두 개의 칩이 있지만, 각각은 용량이 192GB에 불과하며 칩당 대역폭은 여전히 8.6TB/sec을 유지합니다. 이는 Zebrafish 칩당 HBM3 스택 개수는 동일하지만, 칩당 용량은 33% 감소했음을 의미합니다. 이는 12개 높이의 HBM3 스택에서 8개 높이의 스택으로 이동했음을 시사합니다. 또한, 소켓당 절대 메모리가 더 높아지더라도 TPU 8i Max는 TPU 8i 대비 컴퓨팅 단위당 HBM 메모리가 적다는 것을 의미합니다. 이는 Google이 HBM3 메모리 할당을 더 많은 TPU 칩에 분산시키고, 추론 모델의 컨텍스트 및 KV 캐시 스토리지를 위해 두 Zebrafish 칩을 긴밀하게 결합하여 더 큰 공유 메모리 영역(shared memory footprint)을 갖도록 만든 것으로 보입니다.
아키텍처의 모든 것은 무언가를 얻기 위해 다른 것을 희생하는 트레이드오프(tradeoff)입니다. 이로 인해 일부 컴퓨팅 자원이 활용되지 못할 수도 있지만, 큰 컨텍스트를 실행하기에 소켓당 메모리가 충분하지 않은 것보다는 덜 나쁜 일입니다. 놀라운 점은 Google이 이를 균형 있게 맞추기 위해 일부 컴퓨팅 자원을 폐기(deprecate)하지 않았다는 것입니다. 혹은 MediaTek과 TSMC가 빈을 뒤져 메모리를 상쇄할 수 있는, 힘(oomph)이 33% 낮은 Zebrafish 칩을 찾아냈다는 것이죠. 정말 대단합니다.
TPU 8i Max 카드를 자세히 살펴보면, 보드 하단의 ICI 포트가 다른 TPU 8 소켓들과는 다르게 보입니다. 이에 대한 설명은 없었습니다.
여기, 우리가 알고 있는 TPU 컴퓨팅 엔진의 모든 피드(feeds), 속도 및 가격을 정리한 거대한 표가 있습니다:
아직 미지수인 것은 Google이 Sunfish 및 Zebrafish TPU를 어떻게 가격 책정할 것인지입니다.
GenAI 시장의 탄력성은 추론(inference) 실행을 위한 토큰 처리 비용이 지속적으로 감소하는 것에 달려 있기 때문에, Google이 훈련(training)에 사용되는 TPU에는 프리미엄을 부과할 것이라고 예상하는 것이 합리적입니다. TPU 8t는 TPU 8i보다 플롭스당 및 HBM 용량당 더 비쌀 가능성이 높으며, TPU 8tx는 TPU 8t와 TPU 8i 대비 시간당 약간의 프리미엄이 붙고, TPU 8i Max는 TPU 8i 대비 시간당 2배 미만의 비용이 들 것으로 보입니다.
마지막으로 한 가지. Google은 간헐적이고 급격한(bursty) 에이전트 기반 AI 워크로드(agentic AI workloads)가 실행되는 동안 HBM 메모리 사용을 극대화하도록 설계된, TPU 위에 구축된 계층적 스토리지 관리 소프트웨어 레이어인 TPU Sync를 만들었습니다.
Lohmeyer는 “이것은 TPU가 실제로는 상당한 비율의 시간을 유휴 상태(idle)로 보내는 경우가 많다는 것을 의미합니다”라고 설명했습니다. “따라서 사용되지 않을 때도 해당 리소스를 묶어두어야 한다면, 특히 이러한 에이전트 기반 워크로드가 실제로 확장되기 시작할 때 엄청난 비효율성을 초래합니다. TPU Sync가 정확히 해결하도록 설계된 것이 바로 이것입니다.”
“작동 방식은 에이전트가 일시 중지될 때 작업 메모리를 TPU 칩에서 이동시키고, 에이전트가 처리를 재개해야 할 때 이를 복원하는 것입니다. 이렇게 함으로써 시스템의 활용률(utilization)을 크게 높일 수 있습니다. 왜냐하면 이러한 가속화된 리소스를 확보할 수 있게 되면 다른 작업에 적용할 수 있기 때문입니다. 따라서 활용률을 상당히 높일 수 있으며, 이는 궁극적으로 트랜잭션당 비용, 에이전트 기반 워크로드 또는 활동당 비용을 낮춥니다. 그러므로 TPU의 핵심 가치 제안(core value prop) 중 하나는 가능한 가장 낮은 비용으로 뛰어난 성능을 구현하는 데 매우 중요합니다.”
TPU Sync가 소프트웨어이기 때문에 Google은 이를 이전 세대 TPU 시스템에도 적용할 수 있으며, 실제로 그렇게 했습니다. 따라서 TPU 5, TPU 6, TPU 7 및 TPU 8입니다. TPU Sync가 클러스터 내 수만 개에서 수백만 개의 TPU에 걸쳐 메모리 이동을 어떻게 오케스트레이션(orchestrate)하는지 전혀 명확하지 않습니다. 제 생각으로는 위의 차트가 데이터가 HBM, 호스트 DRAM(host DRAM), 호스트 플래시(host flash), 외부 플래시 및 디스크 스토리지(disk storage)를 가로질러 앞뒤로 이동해야 하는 방식을 제대로 전달하지 못하지만, 분명히 이것은 수행되어야 합니다. 또한 TPU Sync가 추론 처리량(inference throughput)을 얼마나 향상시키는지도 명확하지 않습니다. 저는 그러한 데이터를 보기를 기대합니다.