<div align="center">
👻 Ghostlink
커스텀 LLM 시스템을 위한 분산 추론 패브릭입니다.
명시적 스케줄링, 하드웨어 인식 배치(hardware-aware placement)를 통해 CPU, GPU 및 NPU 리소스 전반에 걸쳐 워크로드를 라우팅할 수 있는 자체 호스팅 오픈 소스 스택을 제공합니다.
CI
Tests
Security
MSRV
License: MIT
Docs
Version
Rust
Platforms
PRs Welcome
GitHub Stars
Sponsor
Quick Start · Demo · Architecture · API · Docs · Contributing
</div>
Demo
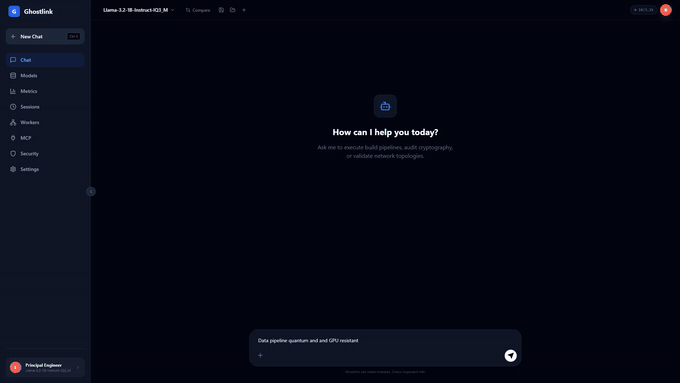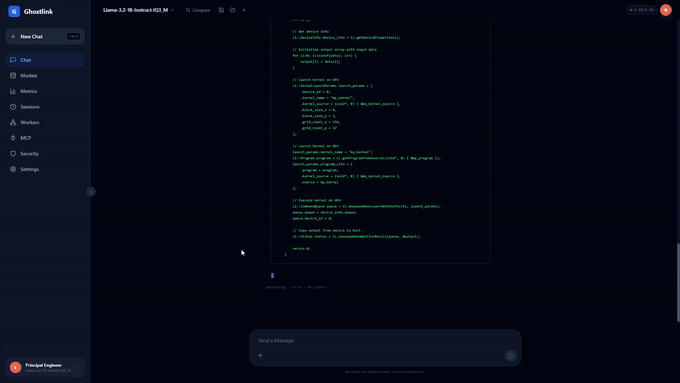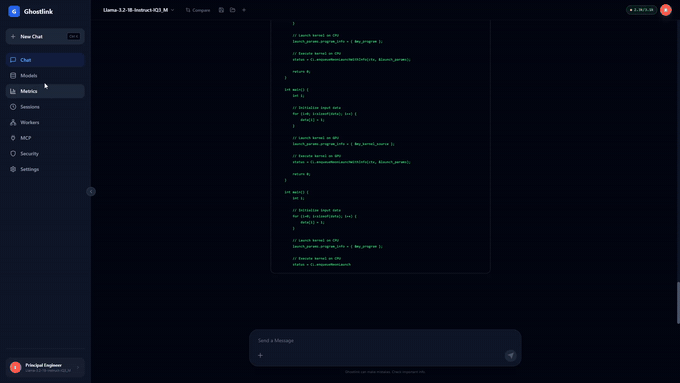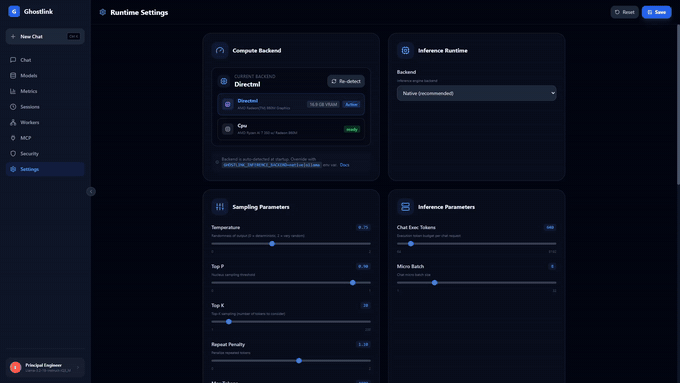
설치 → 모델 로드 → 채팅, Ghostlink Studio의 네이티브 llama.cpp 백엔드를 통해 Llama 3.2 1B(https://huggingface.co/meta-llama/Llama-3.2-1B-Instruct)을 로컬에서 끝단 간(end to end)으로 실행합니다.
Ghostlink Studio walkthrough — loading Llama 3.2 1B and chatting with it
전체 길이 녹화본(오디오 포함)은 로컬 보기용으로 gitignore된 demo/ 폴더에 있습니다 — 푸시된 리포지토리의 일부가 아니므로 여기에는 링크가 없습니다.
Table of Contents
⚠️ [IMG:N] 형식 토큰은 이미지 placeholder 입니다. 번역하지 말고 원래 위치에 그대로 유지하세요.
Ghostlink가 제공하는 것
제품의 핵심 목표: 성공적인 경로만 지원 (Happy Path Only)
LAN 피어(peer)를 검색 → ggml-rpc를 통해 GGUF 모델 가중치를 분할 → OpenAI와 호환되는 /v1/chat/completions 엔드포인트 제공.
- llama.cpp의
ggml-rpc 백엔드를 사용하여 LAN 워커 노드 간 제로 설정(zero-config) 크로스 머신 분산 추론(distributed inference) 지원.
- 혼합된 컴퓨팅 환경(CPU, GPU, NPU) 전반에 걸쳐 하드웨어 인지 배치(Hardware-aware placement) 기능 제공.
- OpenAI와 호환되는
/v1/chat/completions API 서버 제공.
- 연구 구성 요소 (실험적): SPSC 링 버퍼(
flow), TCP/UDS 전송 파이프라인, AF_XDP 커널 바이패스(kernel-bypass)는 실험적인 연구 경로임. 이 연구 구성 요소들로부터 얻은 합성 토큰/초(tok/s) 측정값은 전송 프레이밍 지연 시간만을 반영하며 LLM 토큰 생성 속도로 절대 제시되지 않음.
Ghostlink를 사용해야 하는 이유
LAN의 모든 장치에 Ghostlink를 연결하면, 크기가 정확하게 조정되고 인증되며 관찰 가능한 단일 추론 클러스터가 됩니다. 게다가 YAML 파일도 필요 없고 수동으로 --rpc 플래그를 설정할 필요도 없습니다. 다른 누구도 이종 소비자/프로슈머 하드웨어의 제로-설정 디스커버리(게이밍 GPU + 구형 노트북 + NPU 탑재 울트북 + Mac)와 실제 분산 추론을 결합하지 못했습니다: vLLM은 균질한(homogeneous) 공동 배치 GPU 플릿을 가정하고, Ollama나 LM Studio는 아예 분산시키지 않으며, Kubernetes 기반 서비스는 이를 해결할 수 있지만 클러스터와 운영팀이 필요합니다. 전체 분석 내용은 docs/COMPARISON.md를 참고하시고, 단순히 글로만 설명하는 것이 아니라 실제 두 대의 장치가 연결된 LAN 환경에서 작동하는 벤치마크 결과는 docs/BENCHMARKS.md를 확인해 주세요.
다음과 같은 경우 Ghostlink를 사용하세요:
- 네트워크에 이미 존재하는 혼합 CPU/GPU/NPU 하드웨어 전반에 걸친 제로-설정 클러스터 구성이 필요할 때,
- 오픈 소스 유연성과 벤더 종속성(vendor lock-in) 없이 자체 호스팅 추론 패브릭이 필요할 때,
- 지원 및 엔터프라이즈 배포 서비스가 제공되는 유료 상업적 오퍼링으로 확장 가능한 플랫폼이 필요할 때.
빠른 시작 (Quick Start)
세 개의 명령어, 하나의 런처로 수동적인 서비스 연결 작업 없이 — launch.bat / launch.sh는 누락된 부분을 구성하고, 모든 프로세스를 시작하며, GUI를 열어줍니다.
가장 빠른 방법: 바이너리 설치 (install the binary)
Rust/Node/cmake 툴체인이 필요하지 않습니다. 이 과정은 GitHub Releases에서 미리 빌드된 ghost-link 바이너리를 다운로드하고, 배포판에 게시된 SHA256SUMS와 비교하여 검증한 후, 사용자 쓰기 가능 디렉터리(sudo/admin 권한 불필요)에 설치합니다.
Linux / macOS:
curl -fsSL https://raw.githubusercontent.com/rwilliamspbg-ops/Ghostlink/main/scripts/install.sh | sh
Windows (PowerShell):
irm https://raw.githubusercontent.com/rwilliamspbg-ops/Ghostlink/main/scripts/install.ps1 | iex
다음으로:
ghost-link --help
ghost-link doctor --strict
ghost-link serve 127.0.0.1 8003
두 스크립트 모두 VERSION=v2.4.0 (환경 변수)을 받아 최신 버전 대신 특정 릴리스 버전을 고정할 수 있으며, 설치 디렉터리가 이미 PATH에 포함되어 있지 않은 경우 PATH 안내를 출력합니다. 두 스크립트의 소스는 scripts/install.sh와 scripts/install.ps1에 있습니다. 만약 한 줄 명령어로 모든 것을 믿기보다는 직접 읽어보고 싶다면, 이 파일들을 셸로 파이프하기 전에 먼저 읽어보시는 것이 합리적인 직관입니다.
이것이 제공하지 않는 것: Go의 control-plane 게이트웨이나 내장된 React GUI가 오늘날 독립적인 릴리스 에셋으로 게시되지는 않았습니다. 오직 ghost-link 바이너리, 그 체크섬, 그리고 SBOM만 그렇습니다 (scripts/release_bundle.sh 참조). 한 줄 설치 명령어는 CLI와 OpenAI 호환 API 서버를 제공하지만, 전체 브라우저 GUI를 사용하려면 아래의 빌드-소스(build-from-source) 또는 Docker 경로를 사용하십시오. 릴리스 바이너리 역시 x86_64/amd64 전용입니다. 태그가 지정된 릴리스 설치 프로그램은 x86_64 전용이며 (GitHub Actions 워크플로우 실행에는 arm64 CI 워크플로우 아티팩트가 존재하지만), 두 스크립트는 바이너리가 작동하지 않을 수 있는 비-x86_64 호스트를 조용히 처리하는 대신 감지하고 거부합니다.
소스에서 빌드 (GUI 포함 전체 스택)
브라우저 GUI, 로컬 개발 또는 공개된 릴리스 바이너리가 없는 플랫폼에 필요합니다.
Windows
전제 조건(Prerequisites)
이것들로 시작합니다:
- llama-server (추론, 포트 8080)
- Ghostlink API (채팅 / 모델 / 설정, 포트 8003) — 내부용입니다. GUI가 이 주소로 직접 호출하지는 않습니다.
- Control-plane (Go 게이트웨이: CORS, 요청 로깅, 속도 제한, 스트리밍 안전 프록시, 포트 8000) — GUI는 반드시 이 포트를 사용해야 합니다.
- http://127.0.0.1:5173의 React 프론트엔드가 브라우저에 자동으로 열립니다.
실제로 실행되는지 확인하기 (브라우저 탭이 이미 깨끗하게 로드된 경우 건너뛰기):
curl http://127.0.0.1:8000/health   # control-plane — GUI용 게이트웨이
curl http://127.0.0.1:8003/health   # ghost-link API — 위의 줄과 일치해야 함
두 주소 모두 연결 오류가 아닌, 정상 상태를 담은 JSON 본문을 반환해야 합니다.
http://127.0.0.1:5173을 열고 → Models → 모델 로드 (예: Llama-3.2-1B-Instruct와 같이 작은 모델이 몇 초 만에 로드되며 좋은 첫 확인 방법입니다) → Chat으로 이동합니다.
선택 사항:
# llama-server 대신 Ollama 사용
$env:GHOSTLINK_INFERENCE_BACKEND="ollama"; .
aise.bat

...
chat/models에서 405 에러가 발생하나요? GUI가 잘못된 포트를 가리키고 있기 때문입니다 (예: ghost-link :8003을 직접 사용하거나, llama-server :8080을 사용). 항상 API 기본 주소인 http://127.0.0.1:8000 (control-plane 게이트웨이)를 사용하세요.
**채팅에서 갑자기
Rust/Node/cmake 도구 체인 불필요 — Docker만 있으면 됩니다.
git clone https://github.com/rwilliamspbg-ops/Ghostlink.git
cd Ghostlink
mkdir -p models
...
그런 다음 http://localhost:5173을 열고 → Models → Chat으로 이동합니다. 스택이 정상적으로 작동하는 것을 확인한 후, models/stories15M-q4_0.gguf (및 docker-compose.yml의 llama-server 볼륨 마운트)을 더 큰 GGUF 파일로 교체하세요.
docker-compose.demo.yml은 구형 프로토타입(Python 모델 매니저 + Ollama)이며 더 이상 유지보수되지 않습니다 — 위에 있는 docker-compose.yml을 사용하세요.
하드웨어 감지 및 호환성
Ghostlink는 시작 시 다음 순서로 탐색하여 사용 가능한 가속기(accelerator)를 자동 감지합니다: nvidia-smi (크로스 플랫폼), 그 다음 OS별 폴백(fallback) (Windows WMI / Linux lspci+sysfs / macOS system_profiler), 마지막 수단으로 Vulkan 프로브입니다. 실제로 감지 가능한 항목은 OS별로 다음과 같습니다 (system_profile.rs에 근거):
| 가속기 | Windows | Linux | macOS | 감지 방법 |
|---|
| CUDA (NVIDIA) | ✅ | ✅ | ⚠️¹ | nvidia-smi, CUDA_PATH |
| ... | | | | |
¹ Apple과 NVIDIA 모두 수년 동안 macOS에서의 NVIDIA GPU 지원을 사실상 폐기했습니다 — 프로브는 실행되지만 실제 하드웨어에서 아무것도 찾지 못할 것으로 예상하지 마세요.
² ROCm 감지는 cargo build --features rocm으로 빌드하지 않는 한 완전히 제외됩니다; 이것이 없으면 Linux의 AMD 독립형 GPU는 Vulkan 프로브로 넘어갑니다.
³ 분리형 가속기(discrete accelerator)가 아닌 Apple Neural Engine으로 감지되며, 시스템 메모리를 공유하기 때문에 VRAM/메모리 수치가 보고되지 않습니다.
백엔드 지원(네이티브 llama-server 대 Ollama): 세 OS 모두에서 동일하게 작동합니다 — Ollama는 PATH에 ollama 바이너리만 필요할 뿐이며 (GHOSTLINK_INFERENCE_BACKEND=ollama), 빌드 변경은 필요하지 않습니다.
GPU가 감지되지 않으면 환경 변수를 수동으로 설정하세요:
$env:GHOSTLINK_GPU_NAME="AMD Radeon 860M"
$env:GHOSTLINK_VRAM_GB=8
$env:GHOSTLINK_COMPUTE_CAPABILITY="gpu"
전체 하드웨어 프로브(여러 외부 명령어 실행: Windows의 PowerShell/CIM 쿼리, nvidia-smi 등)가 순차적으로가 아니라 동시에 실행됩니다. 이는 Windows 개발용 머신에서 약 1.4초로 측정되었으며, 이들이 공유 상태 없이 하나씩 실행될 때의 약 4초보다 단축된 수치입니다.
성능
마이크로초(sub-microsecond) 수준의 핵심 원시 요소가 Ghostlink의 전송 및 지연 시간 연구 계층을 구동합니다. 벤치마크는 Intel i7-14700K (Linux/WSL2) 환경에서 RUSTFLAGS="-C target-cpu=native"로 실행되었습니다.
참고: 실제 분산 LLM 추론(/v1/chat/completions)은 llama.cpp의 ggml-rpc 텐서 분할을 사용합니다. 아래에서 벤치마크된 제로 카피(zero-copy) SPSC 링 버퍼와 flow 파이프라인은 전송 및 지연 시간 연구 구성 요소 역할을 하며, /v1/chat/completions는 ghost-link flow 위에서 실행되지 않습니다.
마이크로벤치마크
| 벤치마크 | 지연 시간 (Latency) | 처리량 (Throughput) |
|---|
| 링 버퍼 푸시+팝 (단일 스레드) | 1.94 ns | 516 M ops/s |
| ... | | |
파이프라인 처리량